


図面の注記、配合、品質記録、客先仕様書、原価。社外のクラウドに出したくない、あるいは客先との契約上出せないデータで生成AIを使いたいという相談が、タイの製造業から寄せられています。そこで候補に上がるのが、自社のサーバーやタイ国内の閉域環境でオープンウェイトモデルを動かす「ローカルLLM導入」です。SaaS型の生成AIはすでに一部の部門で使い始めたものの、機密データ用にローカルLLMを立てるべきか、立てるなら何のモデルを、どのGPUで、いくらで、誰が運用するのか。この記事は、その問いに実務の順番で答えます。
この記事の主張は一つです。ローカルLLMの成否は、GPUやモデルの性能ではなく、次の三つを先に決めたかで決まります。①対象業務とデータ区分(何のデータを、なぜ社外に出せないのか。社外に出せる業務はSaaSやAPIに残す)、②評価の物差し(自社の文書と自社の言語の組み合わせで作った評価セットと合格基準)、③運用の持ち主(モデルの更新、脆弱性への対応、ログ、障害時の切り戻しを誰がやるか)。 GPUとモデルは、この三つが決まってから「必要な最小構成」を逆算して選びます。「全部ローカル」も「全部SaaS」も目的ではありません。
API、自社ホスト、ハイブリッドのどの持ち方を選ぶかという判断そのものは、LLM 導入は基盤の持ち方で決まる|API・自社ホスト・ハイブリッドで整理しています。本記事は、自社ホスト(ローカルLLM)を選んだ会社、または有力な候補にした会社が、実際に作るときの設計と発注に絞ります。記事中のモデル工場の人数、削減時間、単価、費用、回収年数は、すべてこの記事のために置いた仮の数字です。業界平均でも調査値でも、ベンダーの価格でもありません。
ローカルLLMの導入が製造業で検討される理由
オープンウェイトモデルの利用が広がっている
業界メディア Techstrong.ai が2026年9月22日に報じた Enterprise Technology Research(ETR)の調査(回答者200、2026年9月実施。回答者の国や地域は記事に記載がありません)では、オープンウェイトモデルが企業のAIトークン利用に占める割合は34%で、1年前の23%から増え、12か月後には41%になる見込みとされています。本番で利用している回答者は42%(7月の調査では31%)、パイロット段階が43%でした。導入基盤は自己管理のクラウドが46%、オンプレミスが42%です。一方で、本番化の障害として「セキュリティ・コンプライアンス審査が終わっていない」が62%、自己ホスティングのコストが50%挙がっています。
同じ調査を解説した Constellation Research の記事(2026年9月26日)は、本番利用者の69%がコスト削減を理由に挙げ、60%がプロプライエタリモデルから一部のワークロードを移したと報告しています。ただし同じ記事は、93%がプロプライエタリモデルの利用も増やしているとしています。オープンウェイトモデルへの移行というより、用途によって使い分ける「併用」が実態と読むのが自然です。
日本企業がいちばん気にするのは情報漏洩
総務省の「令和8年版 情報通信白書」が示した4か国の企業アンケートでは、生成AIの活用で懸念するリスクとして「社内情報の漏洩などのセキュリティリスクがある」を挙げた割合が、日本46.4%、米国36.9%、ドイツ31.7%、中国42.7%でした。日本ではこの項目が最も多く、次いで「出力結果の精度に問題がある」35.3%、「著作権等の権利を侵害する可能性」31.3%と続きます。米国と中国では出力の精度(米国44.3%、中国52.1%)が、ドイツでは著作権等(44.7%)が最多でした。同じ白書は、リスク対策として日本では「全社的な指針やガイドラインを整備している」が41.1%で最多である一方、他の3か国では導入段階の専門審査や導入後の定期的な評価・検証の割合が日本より高い傾向にあるとしています。
日系の製造業でローカルLLMが検討される背景の一つには、この「漏洩が心配」という感覚があると考えられます。ただし後で見るとおり、ローカルに置けば漏洩のリスクが消えるわけではありません。白書が示す、導入後の評価・検証の取組で日本の割合が他の3か国より低い傾向は、ローカルLLMでもそのまま課題になります。
タイ語のモデルと国内の計算基盤が増えている
タイでは、デジタル経済社会省(MDES)、Big Data Institute(BDI)、高等教育科学研究イノベーション省(MHESI)、NECTEC などが共同開発した国家LLM「ThaiLLM」について、NSTDA が2026年4月1日付の記事で、1,000億トークンを超えるタイ語データで学習した8B(速度重視)と30B(高性能)の2モデルがあり、Playground、API、モデルのダウンロードを無償で提供していると紹介しています。SCB 10X の Typhoon シリーズも、タイ語向けのモデルや OCR、翻訳などを公開しています(同社サイトの記載)。
計算基盤の側では、タイ投資委員会(BOI)が2026年7月8日に計19.9億米ドル(663億バーツ)の投資を承認し、その中に日本のデータセクション社のタイ子会社が2.352億米ドル(78億バーツ)でバンコクとパトゥムタニに高性能GPUサーバー基盤を構築する案件が含まれていると発表しています。2024年12月の報道では、タイ資本の NVIDIA Cloud Partner を掲げる SIAM.AI CLOUD が H100 のGPUクラスターを立ち上げ、データ主権の維持を掲げていました(2026年時点の稼働規模はこの記事の調査では確認していません)。社内に置くだけでなく、タイ国内の閉域クラウドでGPUを借りるという選択肢が現実的になりつつあります。
ローカルLLMとは:オープンウェイト/オンプレミス/タイ国内の閉域クラウドの違い
「ローカルLLM」という言葉は、人によって指す範囲が違います。社内で議論を始める前に、次の3つを分けておくと話がかみ合います。
| 用語 | 何を指すか | データの置き場所 | 運用の主体 |
|---|---|---|---|
| オープンウェイトモデル | 重み(学習済みのパラメータ)が公開され、ダウンロードして自分の環境で動かせるモデル | モデル自体は場所を問わない | 利用者(ライセンス条件の範囲内で) |
| オンプレミス LLM | 自社の工場やデータセンターに置いたGPUサーバーでオープンウェイトモデルを動かす形 | 自社の敷地内 | 自社または保守委託先 |
| タイ国内の閉域クラウド | タイ国内のデータセンターのGPUを専用区画や閉域接続で借り、オープンウェイトモデルを動かす形 | 契約したクラウド事業者の国内設備 | クラウド事業者と自社の分担 |
この記事では、オンプレミスと国内の閉域クラウドの両方を「ローカルLLM」として扱います。共通点は、どのモデルを、どの版で、どのデータに対して動かすかを自社が決め、プロンプトと回答が外部のモデル提供者に渡らないことです。違いは、GPUを買うか借りるか、障害時に誰がハードウェアを直すかにあります。
SaaS統制、APIラッパー、閉域・自社ホストの3構成を、守れる範囲と5年間の総額で比べた整理はセキュア生成AI環境2026|3構成の費用と守れる範囲にあります。ここでは比較は繰り返さず、自社ホストを作る場合の中身に進みます。
最初に決める「ローカルに置く業務」とデータ区分
ローカルLLMの検討で最初に決めるのは、GPUでもモデルでもなく、どの業務をローカルに置くかです。
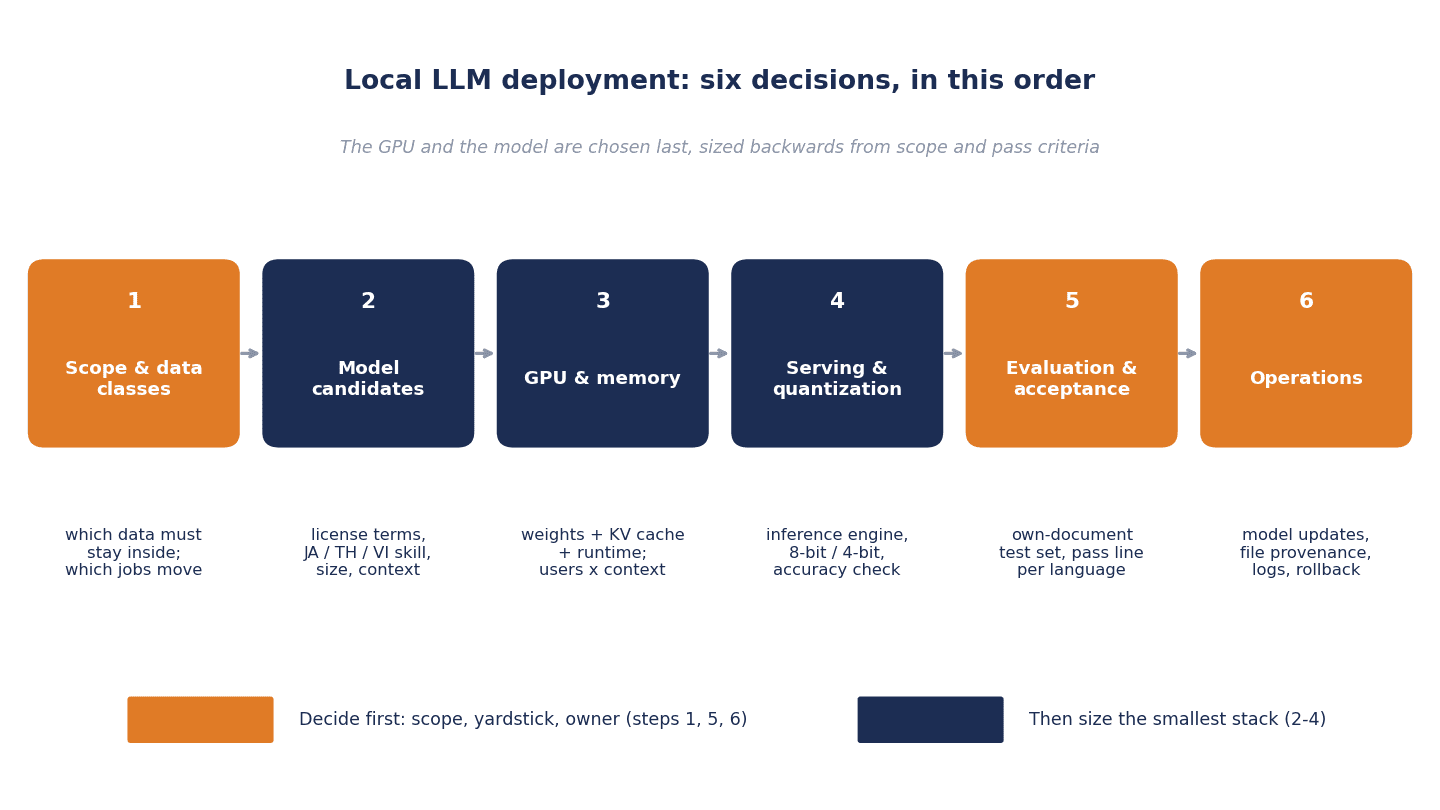
上の図は、ローカルLLMを決める6段の順番です。①対象業務とデータ区分、②モデル候補の選定、③GPUとメモリの見積もり、④推論ソフトと量子化、⑤評価と受入、⑥運用。上の段が決まらないと、下の段は見積もれません。たとえば「全社員が何でも聞けるように」という目標のままでは、同時に何人が、どれだけ長い文書を流し込むかが決まらず、GPUの台数を決められません。
データ区分の例
データの種類ごとに、社外に出せるかと置き場所の例を表にします。社内の情報セキュリティ規程や客先との契約で区分は変わるため、あくまで考え方の例です。
| データの種類 | 社外に出せるか(例) | 置き場所の例 | 理由の例 |
|---|---|---|---|
| 一般的な文章作成、公開情報の要約、翻訳の下書き | 出せる | SaaS/API | 機密を含まない。性能と手軽さを優先できる |
| 社内規程、作業標準、社内の手順書 | 規程による | SaaS(統制あり)またはローカル | 社外秘の扱いかどうかで分かれる |
| 客先の図面、客先仕様書、客先から受けた品質要求 | 契約による(出せないことが多い) | ローカル | 秘密保持契約で第三者のサーバーへの送信が制限されることがある |
| 配合、工程条件、原価、見積の根拠 | 出したくない | ローカル | 自社の競争力そのもの |
| 品質記録、不良の記録、客先クレームの記録 | 出したくない | ローカル | 客先名や不具合の内容を含む |
| 従業員の個人データ(人事、健康、評価) | 原則出さない | ローカル、またはLLMの対象外 | PDPAの対象。越境移転の論点がある |
表の右から2列目を、部門ごとに埋めていきます。ポイントは、ローカルに置く業務を絞ることです。一般的な文章作成までローカルに寄せると、利用者が増えてGPUが足りなくなり、しかも性能面でSaaSに劣ることがあります。機密データを日常的に扱う部門、たとえば設計、品質保証、生産管理、購買から始めるのが現実的です。
「なぜ出せないのか」を一行で書く
区分を決めるときは、「出せない」理由を一行で書いておきます。「客先A社との契約で第三者のサーバーへの保存が禁止されている」「配合は本社の機密区分で社外秘」のように書けると、後でRFPを書くとき、受入試験を設計するとき、監査に説明するときに、そのまま使えます。理由が書けないデータは、実はSaaSで十分かもしれません。生成AIからの情報漏洩対策そのものの要件や受入試験は、生成AI 情報漏洩 対策|タイ工場向けRFP・受入テスト実務で詳しく扱っています。
オープンウェイトモデルの選び方:ライセンス・言語・サイズ・コンテキスト長
対象業務が決まったら、モデルの候補を選びます。以下は、この記事の調査で公式のモデルカードや開発元のページを確認できたものを「候補の例」として並べたもので、推奨ではありません。性能や仕様はいずれも開発元の記載(ベンダー主張)です。
| モデル(開発元) | 規模 | コンテキスト長 | ライセンス・利用条件 | 言語の記載 |
|---|---|---|---|---|
| gpt-oss-20b/120b(OpenAI) | 20b は総21B・アクティブ3.6B、120b は総117B・アクティブ5.1B | Ollama 配布版の記載で 128K | Apache 2.0 | — |
| Qwen3-30B-A3B-Instruct-2507(Qwen/Alibaba) | 総30.5B・活性3.3B | ネイティブ262,144トークン | apache-2.0 | — |
| Llama 4 Scout/Maverick(Meta) | Scout は活性17B・総109B、Maverick は活性17B・総400B | Scout 10M、Maverick 1M トークン | Llama 4 Community License Agreement(月間アクティブユーザー7億超はMetaへの申請が必要) | タイ語・ベトナム語・インドネシア語などを含む12言語。日本語は公式の対応言語一覧に含まれない |
| Gemma 4(Google) | E2B、E4B、12B、26B A4B(MoE)、31B(dense)の5種 | 小型 128K、中型 256K | 商用利用可とされる。モデルの利用条件は公式の利用規約ページ(Gemma terms)で要確認 | — |
| Mistral-Small-3.2-24B-Instruct-2506(Mistral AI) | 24B | — | apache-2.0 | 24言語対応 |
| DeepSeek-V3.2(DeepSeek) | 総685B | — | リポジトリ上は MIT License | — |
| GPT-OSS Swallow 20B/120B(Swallow プロジェクト) | gpt-oss ベース | — | Apache 2.0(商用・研究とも利用可) | 日本語特化 |
| Typhoon2.1-Gemma3-12B(SCB 10X) | 12B(Gemma3 12B ベース) | 128K | Gemma License。利用には OpenTyphoon の利用規約・プライバシー通知への同意が必要 | タイ語・英語 |
| ThaiLLM(MDES、BDI、MHESI、NECTEC など) | 8B と 30B | — | ライセンス名はこの記事の調査では未確認 | タイ語(1,000億トークン超のタイ語データで学習) |
表の「—」は、この記事の調査で確認した範囲に記載がなかった項目です。
ライセンスは「名前」でなく条件で読む
同じ「オープン」でも、条件は違います。Apache 2.0 や MIT と記載されたモデルがある一方で、Llama 4 は独自のコミュニティライセンスで、月間アクティブユーザーが7億を超える製品やサービスではMetaへの申請が必要とされています。Typhoon2.1-Gemma3-12B は Gemma License に加えて OpenTyphoon の利用規約への同意が求められます。Gemma 4 は公式の概要ページに商用利用が可能である旨と、モデルには Gemma 4 の利用規約が適用される旨の記載がありますが、条件の詳細は利用規約のページそのもので確認してください。ThaiLLM はライセンス名をこの記事の調査で確認できていません。採用候補が決まったら、法務部門と一緒に、その時点の利用規約の原文を読むことを前提にしてください。
言語は「対応一覧」と「自社文書での実測」の両方で見る
日本語、タイ語、ベトナム語が混ざる工場では、言語の扱いが選定の分かれ目になります。Llama 4 のモデルカードは、タイ語とベトナム語を含む12言語を対応言語に挙げる一方、日本語は公式の一覧に含まれていません。日本語に特化したものとしては、東京科学大学などの Swallow プロジェクトが GPT-OSS Swallow 20B/120B を公開し(v0.1 は2026年2月20日、MXFP4版は2026年5月28日)、日本関連の知識を問うベンチマーク JamC-QA でベースの gpt-oss より20Bは13.0ポイント、120Bは11.4ポイント改善したとしています(開発元の発表)。タイ語では、前述の ThaiLLM や Typhoon2.1-Gemma3-12B があります。
ただし、対応言語の一覧やベンチマークは、自社の図面の注記や品質記録で使えることを保証しません。タイ語で書かれた作業標準を日本語で要約する、日本語の客先仕様書の要点をタイ語で現場に伝える、といった自社の言語の組み合わせで実測する必要があります。タイ語の業務評価の作り方はタイ語 生成AI|業務評価・RFP・受入試験ガイドで整理しています。
サイズとコンテキスト長
モデルのサイズは、大きいほど精度が期待できる一方で、GPUのメモリと費用が増えます。gpt-oss や Qwen3-30B-A3B、Llama 4 のように「総パラメータ」と「アクティブ(活性)パラメータ」が分かれて書かれているのは、MoE(専門家混合)と呼ばれる構造のモデルです。1回の計算で使うのは一部のパラメータでも、重みは全体をメモリに載せる必要があるため、GPUメモリの見積もりは総パラメータで行います。
コンテキスト長は、一度に読み込める文脈の長さです。表のとおり128Kから10Mトークンまで幅がありますが、長い文脈をそのまま使うほどKVキャッシュのメモリが増えます。この点は次の章で扱います。
LLMのGPU選び方:必要メモリの計算方法
重みのメモリは「パラメータ数×バイト数」
GPUのメモリの見積もりは、まず重みから始めます。NVIDIA の技術ブログ(2023年11月17日)は、重みのメモリを「パラメータ数×1パラメータあたりのバイト数」で求める基本式を示し、例として Llama 2 7B を16ビット(FP16/BF16)で読み込むと約14GBになるとしています。1パラメータあたりのバイト数は、16ビットで2バイト、8ビットで1バイト、4ビットで0.5バイトです。
この式で、モデル規模と精度ごとの重みのメモリを概算すると、次のとおりです(1GB=10億バイトとした概算。重みだけの値)。
| モデル規模 | 16ビット | 8ビット | 4ビット |
|---|---|---|---|
| 8B(80億) | 16 GB | 8 GB | 4 GB |
| 32B(320億) | 64 GB | 32 GB | 16 GB |
| 70B(700億) | 140 GB | 70 GB | 35 GB |
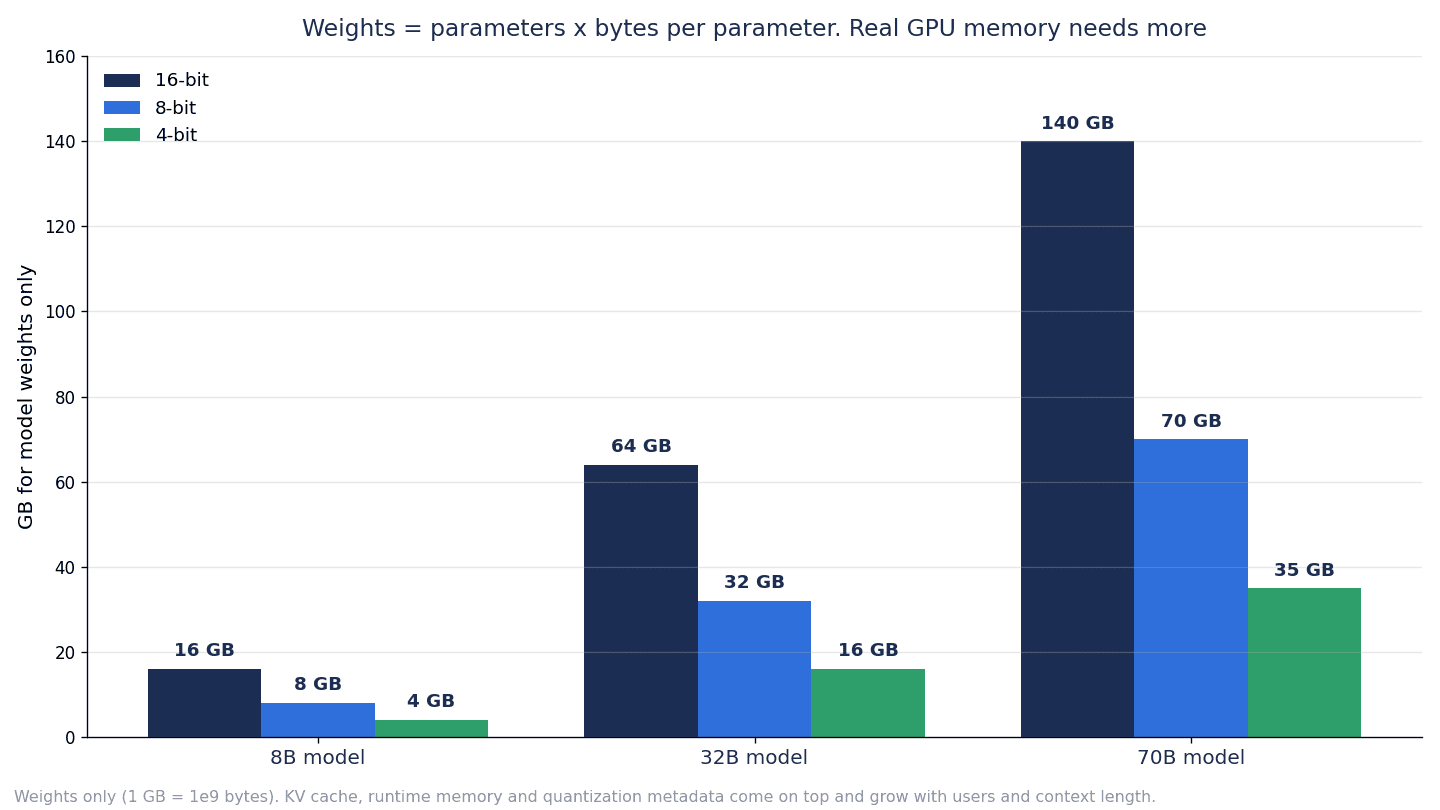
この表はKVキャッシュ、推論ソフトの実行時の領域、量子化の付帯情報を含みません。 実際に必要なGPUメモリは、これより大きくなります。どれだけ大きくなるかは、同時接続数、文脈の長さ、推論ソフトによって変わります。
開発元が公表している値も見ておきます。Google は Gemma 4 について、重みの読み込みだけに必要なメモリの目安を公式の表で示しています(ベンダー主張)。
| Gemma 4 のモデル | BF16 | SFP8 | Q4_0 |
|---|---|---|---|
| 31B | 69.9GB | 34.9GB | 17.5GB |
| 26B A4B | 57.7GB | 28.8GB | 14.4GB |
| 12B | 26.7GB | 13.4GB | 6.7GB |
| E4B | 17.9GB | 8.9GB | 4.5GB |
| E2B | 11.4GB | 5.7GB | 2.9GB |
Google はこの表について、静的なモデル重みの読み込みに必要なメモリだけを示しており、ソフトウェアやコンテキスト窓(KVキャッシュ)に必要な追加のメモリは含まないと注記しています。さらに、メモリの消費はプロンプトと生成される応答の総トークン数に応じて動的に増えるとしています。単純な式で出した値と開発元の表の値はモデルによって一致しないことがあるため、候補が決まったら、開発元の表やモデルカードの値で確かめてください。
他のモデルカードにも目安があります。Mistral-Small-3.2-24B-Instruct-2506 のモデルカードは、bf16 または fp16 でGPU上に約55GBのGPU RAMが必要としています。gpt-oss のモデルカードは、MoEの重みに MXFP4 量子化を適用することで、120b は単一の80GB GPU(例として NVIDIA H100 や AMD MI300X)に収まり、20b は16GBのメモリ内で動作するとしています。Llama 4 Scout は、オンザフライの int4 量子化で単一の H100 GPU に収まるとされています。いずれも開発元の主張で、同時接続数や文脈の長さの条件は別に確認が要ります。
KVキャッシュは同時接続数と文脈の長さで増える
重みの次に効くのが、KVキャッシュです。会話や文書の文脈をGPUのメモリに保持する領域で、前述の NVIDIA の技術ブログは総量を次の式で示しています。
KVキャッシュ=バッチサイズ×系列長×2×層の数×hidden size×FP16のバイト数
同じブログの例では、Llama 2 7B をバッチ1、系列長4096、32層、hidden size 4096、FP16 で動かすと、KVキャッシュは約2GBです。式のとおり、バッチサイズ(同時に処理するリクエスト数)と系列長(文脈の長さ)に比例して増えます。 品質記録や図面の説明をRAGで長く流し込み、複数の人が同時に使う用途では、重みの何割かでは済まないことがあります。
注意点が一つあります。この式は hidden size を使っていますが、GQA(グループ化クエリ注意)を採用したモデルでは、KVキャッシュは KVヘッド数×ヘッド次元で計算します。たとえば前述の Qwen3-30B-A3B-Instruct-2507 は KVヘッドが4のため、この式をそのまま当てはめると過大な見積もりになります。正確な値は、採用するモデルの構成と推論ソフトの実測で確かめてください。
推論ソフトの側でKVキャッシュを減らす設定もあります。Ollama の FAQ によれば、KVキャッシュの量子化設定(OLLAMA_KV_CACHE_TYPE)は既定が f16 で、q8_0 にすると f16 の約半分、q4_0 では約4分の1のメモリになります(開発元の記載)。メモリが減る代わりに精度への影響を確かめる必要がある点は、重みの量子化と同じです。
GPU製品の公式スペック
GPU製品の公式ページに載っているメモリ容量などを並べます。いずれもメーカーの記載で、価格は公式ページに記載がないため、この記事では扱いません。
| 製品(NVIDIA) | GPUメモリ | メモリ帯域 | 最大消費電力 | 備考 |
|---|---|---|---|---|
| L4 | 24GB | 300GB/s | 72W(TDP) | 1スロット、ロープロファイルPCIe |
| L40S | 48GB GDDR6(ECC) | 864GB/s | 350W | デュアルスロット |
| RTX PRO 6000 Blackwell Server Edition | 96GB GDDR7(ECC) | 1597GB/s | 600W(設定可変) | MIGで最大4つの独立インスタンスに分割可能 |
| H200 | 141GB HBM3e | 4.8TB/s | SXM 最大700W、NVL 最大600W(設定可変) | SXM と NVL の2形態 |
| DGX Spark | 128GB LPDDR5x 統合メモリ(OEM経由で64GB構成もあり) | — | — | 推論は最大2000億パラメータ、ファインチューニングは最大700億パラメータのモデルに対応とされる。最大4台連結 |
選び方の順番は、①重みの表で候補モデルと精度の組み合わせを絞る、②同時接続数と文脈の長さからKVキャッシュの余裕を見込む、③それが1枚に収まるか、複数枚に分けるかを決める、です。消費電力と冷却、ラックの空き、電源容量は、工場のサーバー室では見落としやすい制約です。設置場所の条件は、GPUを選ぶ前に設備部門と確認しておきます。
推論ソフトと量子化:何を選ぶと何が変わるか
モデルとGPUの間には、推論ソフト(推論エンジン、サービングソフト)が入ります。何を選ぶかで、同時接続への強さ、対応する量子化形式、動くハードウェアが変わります。以下はいずれも開発元・運営元の記載です。
| 推論ソフト | 位置づけ(開発元の説明) | 主な特徴 | API | 向く場面の例 |
|---|---|---|---|---|
| vLLM | LLM推論・サービングのための高速で使いやすいライブラリ | PagedAttention による KVメモリ管理、連続バッチング、prefix caching。FP8、MXFP4、INT8、INT4、GPTQ/AWQ、GGUF などの量子化に対応 | OpenAI互換API、Anthropic Messages API、gRPC | 複数人が同時に使う社内サーバー |
| SGLang | LLM・マルチモーダルモデル向けの高性能サービングフレームワーク(LMSYS が運営) | RadixAttention、prefix caching、マルチGPU並列。BF16、FP8、NVFP4 などに対応。NVIDIA、AMD、Intel Xeon、Google TPU などをサポート | — | 複数GPUでの本番サービング |
| llama.cpp | 幅広いハードウェア上で最小限のセットアップでLLM推論を可能にすること | 1.5bit〜8bitの整数量子化、GGUF形式。Apple Silicon、CUDA、HIP、Vulkan、CPU に対応 | llama-server が OpenAI互換API を提供 | 小規模な検証、GPUが限られる環境 |
| Ollama | ローカルで動作するモデル実行環境 | 既定で 127.0.0.1:11434 にバインド。モデルごとの同時処理数(OLLAMA_NUM_PARALLEL)の既定値は1。既定のコンテキスト窓は取得時点のFAQの記載で4096トークン | — | 個人や少人数での試行、PoCの初期 |
表の「—」は、この記事の調査で確認した範囲に記載がなかった項目です。
少人数の試行と、部門での本番運用は分けて考える
PoCの初期に Ollama や llama.cpp で手早く試すのは合理的です。ただし、Ollama は既定でローカルホストにだけバインドし、ネットワークに公開するには OLLAMA_HOST の明示的な設定が必要です。モデルごとの同時処理数の既定値も1です。社内サーバーとして部門で共有するなら、同時接続の設定と、認証・アクセス制御を別途設計する必要があります。既定のコンテキスト窓も、取得時点のFAQでは4096トークンと記載されており、長い文書を流し込む用途では設定の確認が必要です(この既定値はバージョンによって変わってきた設定です)。
部門で複数人が同時に使う本番では、vLLM や SGLang のように連続バッチングやKVキャッシュの管理を備えたサービングソフトが候補になります。Qwen3-30B-A3B-Instruct-2507 のモデルカードが推奨サービングとして vLLM 0.8.5以降、SGLang 0.4.6.post1以降を挙げているように、モデルによって推奨される推論ソフトと版が指定されていることがあります。モデルと推論ソフトは組み合わせで選んでください。
量子化はメモリを減らすが、精度は自社で確かめる
量子化は、重みを16ビットから8ビットや4ビットに縮めてメモリを減らす技術です。重みの表で見たとおり、4ビットにすれば16ビットの4分の1になります。ただし、精度がどれだけ落ちるかは、モデル、量子化の方式、業務によって変わります。数字の読み取り、型番や規格値の転記、タイ語の固有名詞のように、少しの劣化が業務上の誤りにつながる用途では、16ビットと量子化版を同じ評価セットで比べることを受入試験に入れます。
対応する量子化の形式は、GPUの世代によっても変わります。vLLM の量子化の互換表では、AWQ は Turing 以降の NVIDIA GPU(Volta は対象外)などで対応、llm-compressor の FP8(W8A8)は Ada・Hopper 世代と AMD GPU で対応とされ、互換表は今後変わりうると注記されています。GPUと量子化形式の組み合わせは、発注前に推論ソフトの最新の互換表で確かめてください。
LLM社内サーバー構築の全体構成:認証・RAG・ログ・監視
ローカルLLMは、GPUサーバーにモデルを載せただけでは業務で使えません。社内サーバーとして構築するときの全体構成は、おおむね次の層に分かれます。
- 利用者の入口:社内のチャット画面、既存の文書管理システムやポータルへの組み込み。シングルサインオンで社員のアカウントと結びつけます。
- 認証とアクセス制御:誰がどの文書を検索できるかを、既存の文書の権限と一致させます。ローカルLLMの大きな落とし穴の一つは、権限のない人が、RAG経由で本来見られない品質記録や原価を読めてしまうことです。
- RAG(社内文書検索):図面の注記、客先仕様書、品質記録、社内規程を検索してLLMに渡す層です。文書の版管理、言語の混在、表や図の扱いが精度を左右します。RAGの構築と評価の全体はRAG 導入 企業が失敗しないための構築・費用・評価実践ガイドで、旧版の文書から回答してしまう問題への対策は工場RAGの文書版管理を導入する方法で扱っています。
- 推論サーバー:前章の推論ソフトとGPU。複数のモデルを用途で使い分けるなら、その切り替えもここで扱います。
- ログと監視:誰が、いつ、何を聞き、どの文書を根拠に何が返ったかの記録。GPUの使用率、応答時間、エラーの監視。ログ自体が機密を含むため、ログの保管場所と閲覧権限も決めます。
- 既存システムとの境界:MESやERPのデータをLLMから参照させる場合は、読み取りだけにするのか、書き込みを許すのか、どの項目までを渡すのかを決めます。工場のMESやERPをAIエージェントへ安全につなぐ設計はMCPサーバー構築|工場のMES・ERPをAIエージェントへ安全につなぐをご覧ください。
構成図を描くときは、「どの層が、どの国の、誰の設備にあるか」を書き込みます。推論サーバーだけを社内に置いても、RAGの検索基盤やログを海外のSaaSに置いていれば、データは社外に出ます。
セキュリティ:ローカルでも消えないリスク
ローカルに置けば、プロンプトと回答が外部のモデル提供者に渡らないという利点はあります。しかし、LLMアプリケーションに固有のリスクの多くは、置き場所に関係なく残ります。OWASP(非営利の標準化コミュニティ)が2025年3月に公開した「OWASP Top 10 for LLM Applications 2025」と、NIST が2024年7月に公表した生成AI向けのリスク整理「NIST AI 600-1」の項目のうち、ローカルLLMで特に意識したいものを整理します。
| リスク(出典の項目) | ローカルLLMで起きること | 対策の例 |
|---|---|---|
| サプライチェーン(OWASP LLM03)、第三者コンポーネントの統合(NIST) | 出所の分からないモデルファイルや改変されたファイルを取り込む | 入手元を開発元の公式リポジトリに限る。safetensors 形式を優先。ハッシュの記録 |
| プロンプトインジェクション(OWASP LLM01) | RAGで読み込んだ文書に仕込まれた指示に、LLMが従ってしまう | 文書の取り込み元を限定。LLMに与える権限を絞る |
| 機密情報の開示(OWASP LLM02) | 権限のない利用者が、RAG経由で他部門の機密文書を読める | 検索時に文書の権限を必ず照合。権限越えの質問を受入試験に入れる |
| 過剰な権限(OWASP LLM06) | LLMがMESやERPに書き込めてしまう | 読み取り専用から始める。書き込みは人の承認を挟む |
| ベクトルと埋め込みの弱点(OWASP LLM08) | 検索用のベクトルデータベースから機密文書の内容が推測される | ベクトルデータベースにも文書と同じアクセス制御をかける |
| 誤情報(OWASP LLM09)、作話(NIST) | もっともらしい誤答をそのまま図面や報告書に転記する | 根拠文書の表示。数値や規格値は原本で確認する運用 |
| 無制限な消費(OWASP LLM10) | 長い文書の大量投入でGPUが占有され、他の利用者が使えなくなる | 利用者ごとの上限、文脈の長さの上限 |
モデルファイルの入手元を確かめる
ローカルLLMに固有の論点が、モデルファイルの安全性です。Hugging Face のドキュメントは、PyTorch の既定の重み形式である pickle には、読み込み時に任意のコードを実行できてしまう危険があると説明しています。対策として、信頼できる組織からの取得、署名付きコミットの確認(ただし署名は安全性ではなく出所を保証するもの)、safetensors などの代替形式を挙げています。safetensors は、pickle と異なり安全にテンソルを保存する形式と説明されています。Hugging Face Hub はアップロードされたファイルにスキャンを実施していますが、「100%確実ではない」「安全の確認は利用者の責任」と明記しています。
社内の運用ルールとしては、どのリポジトリの、どの版のファイルを、誰が承認して取り込んだかを記録することが基本です。モデルを更新するたびに、同じ手順を踏みます。
「ローカルだから安全」と説明しない
経営層や客先に説明するときに、「ローカルだから情報漏洩は起きない」と言い切るのは避けてください。外部のモデル提供者にデータが渡らないことと、社内の権限越えや出力の誤用が起きないことは別の話です。NIST AI 600-1 も、生成AIに固有または増幅されるリスクとして、作話、データプライバシー、情報セキュリティ、第三者コンポーネントの不透明な統合などを挙げています。日本の「AI事業者ガイドライン」は2026年3月に第1.2版が公表され、チェックリストやワークシートも公開されています。社内のリスク評価の枠組みとして参照できます。
タイ・ASEANで進めるときの注意
PDPAの越境移転
タイの個人情報保護法(PDPA)では、第28条と第29条に基づく越境移転に関する個人情報保護委員会(PDPC)の告示2本が2023年12月25日に公布され、2024年3月24日に施行されています。法律事務所の解説によれば、第28条は移転先の国や国際機関が十分な保護水準を持つことを求め、第29条はグループ内の拘束的企業準則(BCR)や標準契約条項などの適切な保護措置による移転を定めています。海外のSaaS型のLLMやAPIに個人データを含むプロンプトを送ることは、この越境移転に該当し得ます。該当するかどうかは、法務部門や外部の専門家に確認してください。ローカルLLMは、個人データを含む業務を国内に留めたい場合の選択肢の一つになります。
AI法の状況
タイでは、電子取引開発機構(ETDA)が2026年7月9日にAI法の草案を公表し、2026年8月14日までパブリックコメントを募集しました。法律事務所の解説によれば、草案はリスクベースの枠組みで、単一の規制当局ではなく分野別の規制当局が要件を定める形とされています。2026年10月10日時点では草案の段階で、閣議の原則承認後、制定と施行までに6〜24か月かかり得るとの見方もあります。
ベトナムでは、AI法が2025年12月に採択され、2026年3月1日に施行されています。ベトナム政府のポータルによれば全35条です。高・中・低の3段階のリスク分類を採り、既存のAIシステムには経過措置(医療・教育・金融は18か月、その他は12か月)があると解説されています。
タイとベトナムの規制動向が自社ホストの判断にどう影響するかは、LLM 導入は基盤の持ち方で決まるで触れています。ここでは、規制の状況が国ごとに違い、変わりつつあることを前提に、ログと評価の記録を残せる構成にしておくことを勧めるにとどめます。
タイ語・ベトナム語の扱い
タイ拠点では、日本語、タイ語、英語が一つの文書に混ざることがよくあります。ベトナム拠点を持つ会社では、ベトナム語も加わります。モデル選定の章で見たとおり、言語の対応状況はモデルによって違います。タイ語に特化したモデル(ThaiLLM、Typhoon)、日本語に特化したモデル(GPT-OSS Swallow)、多言語のモデルを、自社の言語の組み合わせで比べてください。ベトナム語の精度が前処理で崩れる問題は、ベトナム語 生成AIの精度|崩れるのはモデルではなく前処理で扱っています。
費用と効果のモデル試算(仮の数字)
ここからは、試算の「構造」を示すためのモデル計算です。以下の数字は、すべてこの記事のために置いた仮の数字です。業界平均でも、調査会社の数字でも、ベンダーの価格でもありません。 自社の数字に置き換えて使ってください。
モデル工場の前提
タイの日系部品メーカー1拠点を想定します。設計、品質保証、生産管理、購買の120人が、図面の注記、客先仕様書、品質記録、社内規程を対象に、社内文書検索(RAG)と文書の下書き・要約にローカルLLMを使います。通貨はタイバーツ(THB)です。
| 項目 | 仮置きの値 |
|---|---|
| 利用者 U | 120人 |
| 1人あたりの月間削減時間 h | 主ケース 3時間/月 |
| 時間単価 W | 400 THB/時間 |
| 初期費用 I | 2,400,000 THB(GPUサーバーなどのハードウェア 1,500,000+構築 900,000〔認証連携、RAG、ログ、評価セット作成、PoC〕) |
| 年間運用費 L | 780,000 THB/年(電力・設置 120,000+保守・外部支援 360,000+社内運用担当 0.3人×1,000,000=300,000) |
| ハードウェアの使用年数 | 5年と仮定 |
主ケース(h=3時間/月)
| 項目 | 主ケース(h=3時間/月) | 計算 |
|---|---|---|
| 年間の削減時間 | 4,320時間/年 | 120×3×12 |
| 削減時間の金額換算 | 1,728,000 THB/年 | 4,320×400 |
| 年間運用費 | −780,000 THB/年 | 仮置き |
| 年間純効果 | 948,000 THB/年 | 1,728,000−780,000 |
| 単純回収年数 | 約2.5年 | 2,400,000÷948,000=2.53 |
一般式にすると、次のようになります。
年間純効果=576,000×h − 780,000
576,000は、1人あたりの月間削減時間が1時間増えるごとに増える年間の金額換算(120×400×12)です。
削減時間を変えると結果はどう動くか
1人あたりの月間削減時間 h だけを変えてみます。
| h(時間/月) | 削減時間の金額換算 | 年間純効果 | 単純回収年数 |
|---|---|---|---|
| 1 | 576,000 THB | −204,000 THB | 回収しない(年間運用費を賄えない) |
| 2 | 1,152,000 THB | 372,000 THB | 約6.5年(2,400,000÷372,000=6.45)。想定使用年数5年を超える |
| 3 | 1,728,000 THB | 948,000 THB | 約2.5年(2,400,000÷948,000=2.53) |
| 5 | 2,880,000 THB | 2,100,000 THB | 約1.1年(2,400,000÷2,100,000=1.14) |
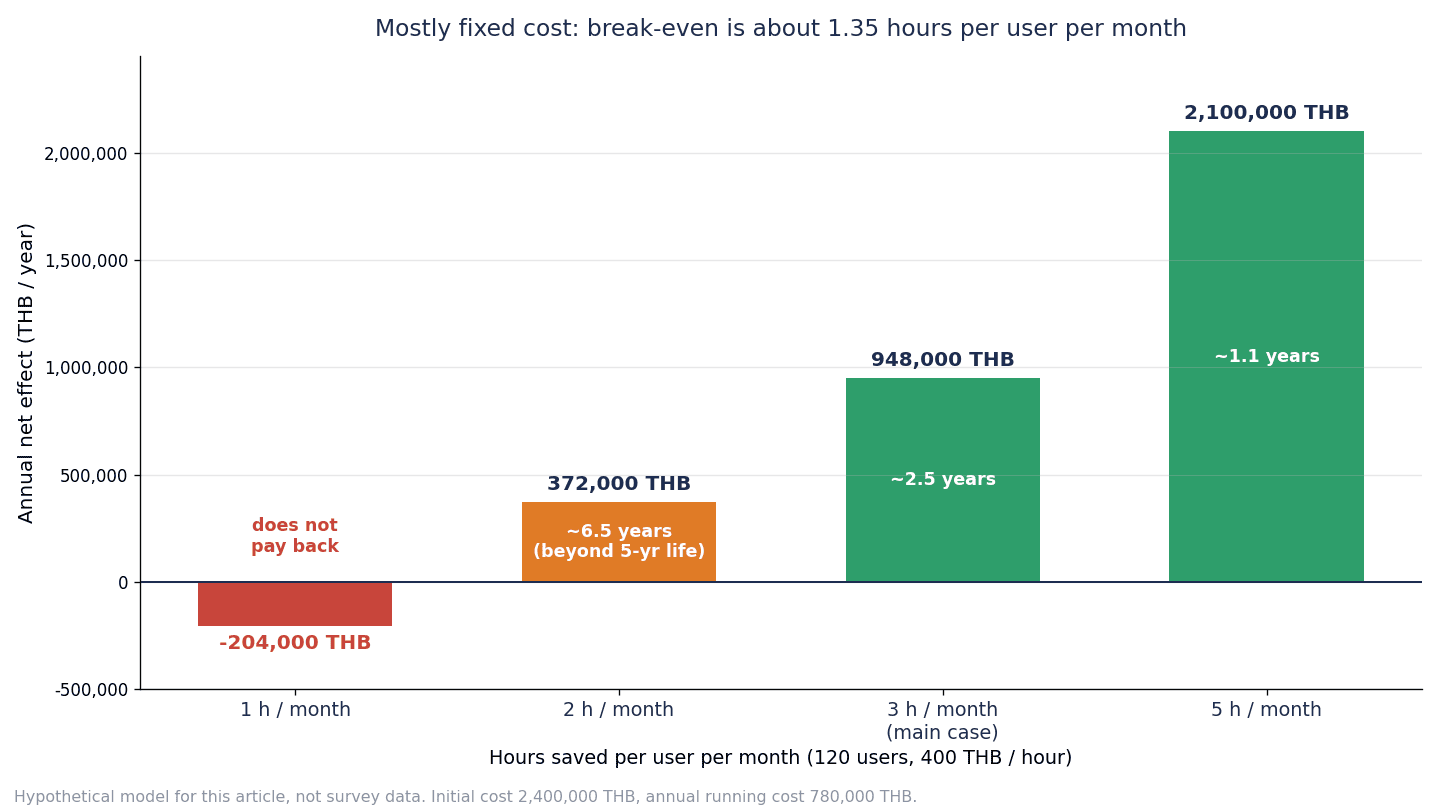
年間純効果が0になる h は、576,000×h=780,000 から h≒1.35時間/月です。これを下回ると、削減時間の金額換算では年間運用費も賄えません。また、ハードウェアの使用年数5年のうちに初期費用を回収するには、年間純効果が480,000 THB(2,400,000÷5)以上必要で、576,000×h≧1,260,000 から h≒2.19時間/月以上が条件になります。h=2時間/月では年間純効果は黒字でも、回収は約6.5年で、想定使用年数の5年を超えます。
つまり、この仮置きの前提では、1人あたり月2時間前後が分かれ目で、月約1.35時間を下回ると年間の費用も賄えません。 費用の大半は、GPUサーバー、保守、運用担当といった固定費です。利用者が少ない、あるいは使う時間が短いと回収しません。
現金の削減と時間の削減は分けて見る
削減時間の金額換算は、浮いた時間を他の仕事に振り向けない限り、現金の削減にはなりません。現金で出ていくのは、初期費用 I と年間運用費 L です。浮いた時間で、客先対応や品質改善、次の開発に手を回せるかどうかが、投資の意味を大きく変えます。
この試算に入れていないもの
次の項目は、条件によって大きく変わるため金額にしていません。
- SaaSやAPIの利用料のうち、ローカルに移した分の削減(既存の契約の有無で変わるため)
- 機密データを社外に出さないことによる、客先の監査や契約面の効果
- 情報漏洩事故の回避
- GPUの更新費用(6年目以降)
これらは別枠で評価してください。生成AIの原価を成果の単位で管理する考え方はAI FinOps導入|生成AI原価を成果単位で管理する実務ガイドで整理しています。
試算から言えること
削減時間 h は、推測で置いてはいけません。PoCで、対象業務の作業時間を導入前と導入後で実測し、その値に置き換えてください。 そのうえで言えるのは、「全社員向け」から始めるのではなく、「機密データを日常的に扱う部門」に絞って始め、PoCで削減時間を実測してから本番のGPU構成を決める、という順番です。
利用者が少ない部門では、まずタイ国内の閉域クラウドのGPUを月単位で借りてPoCを行い、ハードウェアの購入は実測の後に判断するという選択肢もあります。クラウドGPUの料金は事業者や契約条件によって変わるため、見積もりで確認してください。
ローカルLLMのRFPに書く項目
GPUサーバーの調達や、構築・運用の委託でRFP(提案依頼書)を書くときは、次の項目を入れます。「モデルとGPUの型番」だけを書いたRFPでは、提案を比べられません。
| No. | 項目 | 書く内容 |
|---|---|---|
| 1 | 対象業務とデータ区分 | 対象部門、対象業務、ローカルに置くデータとその理由、社外に出せる業務の扱い |
| 2 | 利用規模 | 利用者数、同時接続数の想定、1回に流し込む文書の長さ、ピークの時間帯 |
| 3 | モデル候補とライセンス | 提案するモデルと版、ライセンス・利用規約の条件、言語の対応、差し替えの可否 |
| 4 | GPUとメモリの根拠 | 重み、KVキャッシュ、実行時の領域の内訳、量子化の有無、同時接続時の余裕の算定根拠 |
| 5 | 推論ソフト | 推論ソフトと版、同時接続とキューの設定、量子化形式とGPUの互換性 |
| 6 | 評価と受入基準 | 自社文書で作る評価セットの件数と作り方、言語別の合格基準、量子化前後の比較、応答時間 |
| 7 | 認証とアクセス制御 | シングルサインオン、文書の権限との一致、権限越えの質問への挙動 |
| 8 | ログと監査 | 記録する項目、保管場所と期間、閲覧権限、監査への提出形式 |
| 9 | モデルの入手と更新 | モデルファイルの入手元、形式(safetensors など)、取り込みの承認手順、更新時の再評価 |
| 10 | 運用と障害対応 | 監視項目、障害時の切り戻し手順、GPUの保守と交換、タイでの支援体制、運用の引き継ぎ |
| 11 | 設置条件 | 設置場所(自社サーバー室、国内データセンター、閉域クラウド)、電源容量、冷却、ラック |
| 12 | 費用の内訳 | 初期費用(ハードウェア、構築、評価セット作成、PoC)と年間費用(電力、保守、外部支援)、費用が変わる条件 |
特に4と6は、提案の質を見分ける項目です。メモリの根拠を内訳で出せない提案や、受入基準を「一般的なベンチマークで高得点」とだけ書く提案は、運用に入ってから足りなくなるおそれがあります。
PoCで確認すること:わざと試す5つのケース
PoCでは、うまくいく質問で動くことを確かめるだけでは足りません。意地の悪い条件を渡したときに、誤答を見抜けるか、権限を守るか、応答時間が持つかを確かめます。
| ケース | 何をするか | 確かめること |
|---|---|---|
| ①自社文書での誤答 | 答えが文書にない質問、似た型番や旧版の規格値を含む質問を混ぜる | 「分からない」と答えるか。根拠の文書を正しく示すか |
| ②言語別の精度 | 日本語の文書をタイ語で質問する、タイ語の作業標準を日本語で要約する、など自社の言語の組み合わせで同じ評価セットを回す | 言語の組み合わせごとの合格率。固有名詞と数値の取り違え |
| ③同時接続時の応答時間 | 想定する同時接続数で、長い文書を流し込むリクエストを同時に送る | 応答時間が業務で許容できる範囲か。GPUメモリの不足でエラーにならないか |
| ④権限越えの質問 | 他部門の品質記録や原価を、権限のない利用者のアカウントで聞き出そうとする | 検索の段階で権限が照合され、回答に出てこないか |
| ⑤モデルの差し替え | 量子化版や別のモデルに差し替え、同じ評価セットを回し直す | 合格率がどれだけ変わるか。再評価に何日かかるか |
測るKPI
- 対象業務の作業時間(導入前と導入後の実測。モデル試算の h を置き換える値)
- 評価セットの合格率(言語の組み合わせ別、16ビットと量子化版の別)
- 同時接続時の応答時間
- 権限越えの質問で情報が漏れた件数(0件であること)
- 再評価にかかった工数
⑤のモデルの差し替えは、見落とされがちですが重要です。オープンウェイトモデルは新しい版や別のモデルが公開されることがあり、運用に入ってからモデルを替えたくなる場面は十分に考えられます。そのたびに評価セットを回し直せる仕組みがなければ、古いモデルを使い続けるか、評価なしで替えるかの二択になります。PoCの段階で、再評価の手順と所要時間を確かめておいてください。PoCを終えて本番に移す判断の基準や、検収と運用の引き継ぎの設計はAI PoC終了基準|本番移行・検収・運用引継ぎの設計で扱っています。
よくある質問
ローカルLLMとは?
自社のサーバーやタイ国内の閉域クラウドなど、自社が管理する環境でオープンウェイトモデル(重みが公開され、ダウンロードして動かせるモデル)を動かす形のことです。どのモデルを、どの版で、どのデータに対して動かすかを自社が決め、プロンプトと回答が外部のモデル提供者に渡らない点が、SaaS型の生成AIとの違いです。
ローカルLLMに必要なGPUは?
モデルの規模と精度、同時接続数、文脈の長さで決まります。重みのメモリは「パラメータ数×1パラメータあたりのバイト数」で概算でき、本文の表のとおり、仮に32Bのモデルなら16ビットで64GB、4ビットで16GBが重みだけの目安です。これにKVキャッシュと推論ソフトの実行時の領域が加わります。GPUの製品名から選ぶのではなく、対象業務と同時接続数を決めてから、必要なメモリを逆算してください。
オンプレミスLLMの費用は?
GPUの価格は公式ページに記載がなく、構成と見積もりで大きく変わります。費用の構造としては、初期費用(ハードウェア、構築、評価セット作成、PoC)と年間費用(電力・設置、保守・外部支援、社内の運用担当)に分けて見積もりを取ってください。本文のモデル試算(仮置き)では、費用の大半が固定費のため、1人あたりの月間削減時間が約1.35時間を下回ると年間の費用も賄えず、5年で回収するには約2.19時間以上が必要という結果でした。
ローカルLLMは日本語・タイ語で使える?
モデルによって違います。たとえば Llama 4 のモデルカードはタイ語とベトナム語を対応言語に挙げていますが、日本語は公式の一覧に含まれていません。日本語に特化した GPT-OSS Swallow、タイ語向けの ThaiLLM や Typhoon2.1-Gemma3-12B のようなモデルもあります。ただし、対応一覧やベンチマークは自社の文書での精度を保証しません。自社の言語の組み合わせで作った評価セットで実測してください。
ローカルLLMなら情報漏洩は起きない?
外部のモデル提供者にプロンプトや回答が渡らないという点では有利ですが、漏洩のリスクがなくなるわけではありません。権限のない社員がRAG経由で他部門の機密文書を読めてしまう、出所の分からないモデルファイルを取り込む、ログ自体が機密を含む、といったリスクはローカルでも残ります。文書の権限の照合、モデルファイルの入手元の管理、ログの保管と閲覧権限の設計が必要です。
オープンウェイトモデルの選び方は?
ライセンス・利用規約の条件、自社が使う言語への対応、モデルの規模(GPUのメモリに収まるか)、コンテキスト長の4点で候補を絞り、最後は自社文書の評価セットで比べます。ライセンスは「オープン」という言葉ではなく条件で読み、採用前に利用規約の原文を法務部門と確認してください。
まとめ
ローカルLLM導入は、GPUの型番やモデルのベンチマークを比べることから始めると、高価なサーバーを買ったのに使われない、という結果になりかねません。先に、どの業務をローカルに置くかをデータ区分で決め、社外に出せる業務はSaaSやAPIに残す。次に、自社の文書と自社の言語の組み合わせで評価セットと合格基準を作る。そして、モデルの更新、モデルファイルの入手元の管理、ログ、障害時の切り戻しを誰が担うかを決める。GPUとモデルは、この三つが決まってから、重み、KVキャッシュ、同時接続の余裕を積み上げて、必要な最小構成を逆算します。
モデル試算(仮置き)では、費用の大半が固定費のため、1人あたりの月間削減時間が約1.35時間を下回ると年間の費用も賄えず、5年で回収するには約2.19時間以上が必要でした。だからこそ、機密データを日常的に扱う部門に絞って始め、PoCで削減時間を実測してから本番のGPU構成を決めてください。利用者が少ないうちは、国内の閉域クラウドでGPUを借りて試す道もあります。
TOMAS TECH では、タイの工場の業務に合わせて、社内文書の整備や生成AIの活用、既存システムとのつなぎ込みをお手伝いしています。モデルやGPUが決まっていない段階、たとえば対象業務の絞り込みやデータ区分の整理の段階でもご相談いただけます。お問い合わせはこちらのフォームからどうぞ。
参考情報
- Hugging Face:openai/gpt-oss-120b model card
- Ollama Library:gpt-oss
- Hugging Face:Qwen/Qwen3-30B-A3B-Instruct-2507 model card
- Hugging Face:meta-llama/Llama-4-Scout-17B-16E-Instruct model card
- Google AI for Developers:Gemma models overview
- Hugging Face:deepseek-ai/DeepSeek-V3.2 model card
- Hugging Face:mistralai/Mistral-Small-3.2-24B-Instruct-2506 model card
- Swallow LLM project:GPT-OSS Swallow
- Hugging Face:scb10x/typhoon2.1-gemma3-12b model card
- vLLM documentation
- vLLM documentation:Quantization
- GitHub:ggml-org/llama.cpp
- Ollama Docs:FAQ
- SGLang Documentation
- NVIDIA:L4 Tensor Core GPU
- NVIDIA:L40S GPU
- NVIDIA:H200 Tensor Core GPU
- NVIDIA:RTX PRO 6000 Blackwell Server Edition
- NVIDIA:DGX Spark
- NVIDIA Technical Blog:Mastering LLM Techniques: Inference Optimization(2023年11月17日)
- OWASP GenAI Security Project:OWASP Top 10 for LLM Applications 2025
- NIST:AI 600-1 Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- Hugging Face Hub docs:Pickle Scanning
- Hugging Face docs:Safetensors
- 総務省:令和8年版 情報通信白書 図表Ⅰ-2-1-8(CSV)
- 総務省:令和8年版 情報通信白書 第Ⅰ部第2章
- Techstrong.ai:Open-Weight AI Models Expected to Capture 41% of Enterprise Token Usage(2026年9月22日)
- Constellation Research:Evidence Shows Enterprises Use of Open Weight Models is Mainstream(2026年9月26日)
- Tilleke & Gibbins:Thailand Unveils Regulations for Cross-Border Personal Data Transfer(2024年1月4日)
- Rajah & Tann Asia:Thailand’s Proposed AI Law: Moving Towards a Risk-Based Regulatory Framework(2026年7月28日)
- Baker McKenzie:Vietnam: Artificial Intelligence Law – Foundation and Outlook(2026年2月24日)
- Vietnam Government News:First-ever law on artificial intelligence approved
- NSTDA:ThaiLLM(2026年4月1日)
- BOI:Thailand Approves $1.99 Billion in New Investment, Led by AI and Advanced Electronics(2026年7月8日)
- Kaohoon International:SIAM.AI CLOUD Launches Thailand’s AI Infrastructure(2024年12月4日)
- SCB 10X:OpenTyphoon
- 総務省:AI事業者ガイドライン


