


タイ語 生成AIをタイの工場や現地法人へ導入するとき、比較すべきものはモデル名や日本語デモの見栄えではありません。調達すべきなのは、タイ語の実業務で正しい資料を検索し、数字・日付・否定表現を崩さず、分からないときに止まり、担当者が管理できるという「運用可能性」です。本稿では2026年8月31日時点の一次情報を踏まえ、RFP、タイ語テストセット、RAG評価、90日PoC、受入試験、契約条項までを一つの評価設計にまとめます。
結論:モデル名ではなく、タイ語の運用可能性を調達する
生成AIの提案では、流暢な応答、長いコンテキスト、パラメータ数、公開ベンチマークが並びます。しかし、それだけでは購買担当者の略語を正しく展開できるか、保全日報の否定表現を反転させないか、社内規程の最新版を引用できるかは分かりません。「タイ語対応」と「自社のタイ語業務で合格する」は別の命題です。
調達判断を再現可能にするには、次の五つをRFPの前に買い手側で定義します。
- 対象業務と、AIがしてよいこと・してはいけないこと
- 実際のタイ語に近い評価コーパスと正解データ
- リスク階層ごとの必須合格条件
- 自動評価とタイ語ネイティブ実務者による人手評価
- 本番監視、変更管理、事故対応まで含む契約条件
この順序なら、候補モデルが変わっても同じものさしで再評価できます。逆にモデルを先に決め、あとから用途を探すと、評価項目が製品の得意分野へ引っ張られます。RFPの目的は「最も有名なAI」を選ぶことではなく、自社の責任範囲で運用できる仕組みを選ぶことです。
なぜ日本語・英語で通るデモがタイ語の実務では足りないのか
本社向けのデモは、説明しやすい文書、整った質問、短い会話で行われがちです。一方、タイの現場には、タイ語と英語の部品名が混ざった日報、部署固有の略語、写真OCR由来の文字揺れ、仏暦と西暦、単位の省略、丁寧語と口語の混在があります。元データ自体にも最新版・旧版、承認済み・参考用という状態差があります。
失敗は「不自然なタイ語」だけではありません。例えば、次のような出力は文章が流暢でも業務上は不合格です。
- 「まだ交換していない」を「交換済み」と要約する
- 品番 AB-120 と AB-102 を取り違える
- 3.5 bar を 35 bar と転記する
- 2569年のタイ仏暦を誤って西暦へ変換する
- 旧版の購買規程を最新版として回答する
- 根拠がないのに、承認者名や納期を補完する
- タイ語で質問されたのに英語で答え、現場が使えない
これらは一つの総合点に埋めてはいけません。安全、品質、支払い、人事判断に関わる項目は、平均点が高くても一件の重大誤りで不合格にするゲートが必要です。AI SingaporeのQwen-SEA-LION-v4.5-27B-ITのモデルカードも、評価で要求言語と異なる言語の応答は失敗として扱う考え方を明記しています。これは特定モデルの優劣ではなく、評価手順を先に決める重要性を示す例です。
RFPの前にAdopter・Customizer・Makerを決める
ETDAのGenerative AI Governance Guidelineは、組織での適用形態を複雑性の低い順にAdopter、Customizer、Makerとして整理しています。Adopterは既製サービスを使う形、CustomizerはRAGや追加調整で自社用途へ合わせる形、Makerは基盤モデルを新規に開発する形です。どれが常に優れるという分類ではなく、必要な人材、データ、統制、契約責任が変わるための整理です。
| 判断軸 | Adopter | Customizer | Maker |
|---|---|---|---|
| 主な対象 | 既製の生成AIサービス | RAG、ワークフロー、追加調整 | 基盤モデルの新規開発 |
| 買い手が評価する中心 | 権限、保存、標準機能、運用規約 | 検索、プロンプト、データ連携、変更管理 | 学習データ、モデル開発、計算資源、全工程 |
| タイ語評価 | 実業務入力と出力の適合 | 検索と生成を分離して評価 | 学習から運用まで多層評価 |
| RFPでの重要質問 | 入力データの扱いと管理機能 | どの文書をどう検索し、根拠を示すか | 品質・安全・権利を誰が継続保証するか |
タイの日系企業では、汎用チャットのAdopterと、社内文書を扱うCustomizerが併存することがあります。用途ごとに分類しないと、既製サービスに過剰な個別開発を求めたり、RAG案件を単純なライセンス比較で選んだりします。RFP冒頭に「適用形態」「対象業務」「利用者」「データ範囲」「意思決定への関与」を記載してください。
ETDAが掲げる2026年の方向性も「Driving Trust AI Governance」です。信頼はモデルの宣伝文句ではなく、責任者、評価証跡、利用規則、監視、是正の組み合わせで作ります。したがって、技術仕様書と運用設計書を分離せず、同じRFPの評価対象にします。
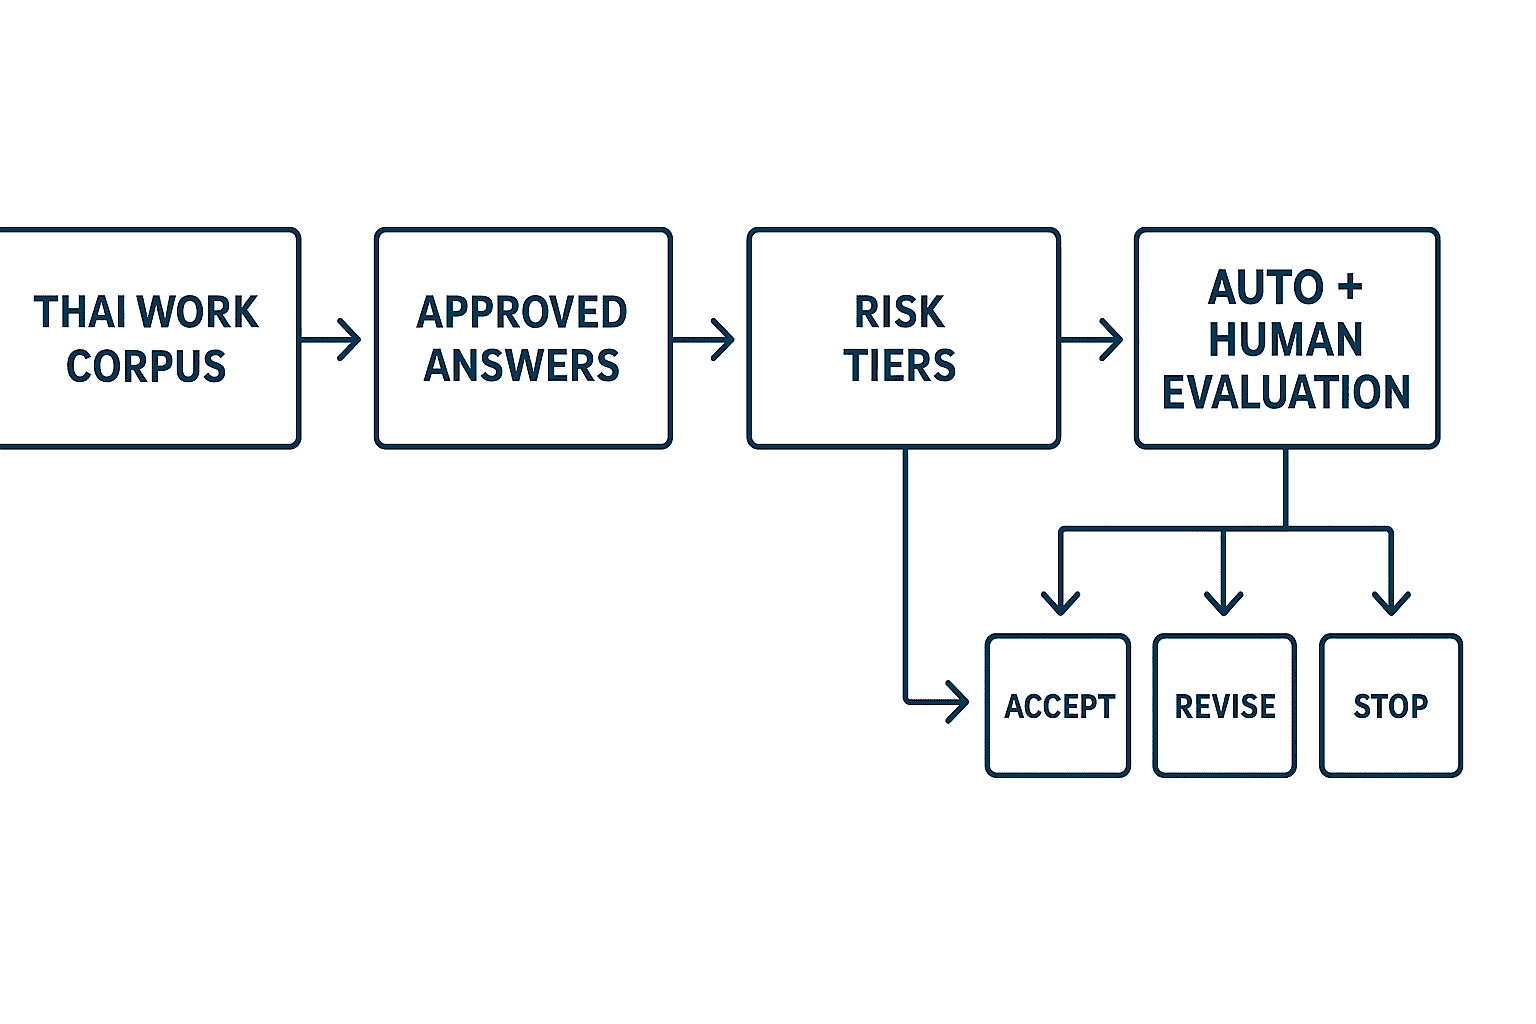
タイ語の実業務コーパスと正解データをつくる
公開ベンチマークは参考、自社の合否判定は自社データで行う
公開データセットは評価設計のヒントになります。例えばSEA-NLIのデータセットカードは合計2,160例を掲げ、内訳をnormal 1,443例、hard 717例としています。ネイティブ話者や言語専門家が関与した設計と限界も記載されています。ただし、公開データは自社の設備名、承認規程、仕入先略称、帳票レイアウトを知りません。公開スコアが高くても、工場の受入試験に合格したことにはなりません。
自社テストセットは、デモ用に書き直した文章ではなく、実際の揺れを残した素材から作ります。ただし個人情報、営業秘密、顧客情報は、評価環境へ入れる前に利用目的、アクセス、マスキング、保管期間を定めます。必要に応じてDPOや法務に確認し、PDPAを含む適用法令への適合は個別に判断してください。
業務別に「入力・正解・禁止・根拠」を持たせる
| 業務 | 入力例 | 正解データ | 主な不合格条件 |
|---|---|---|---|
| 工場日報 | タイ語口語、英語設備名、数値 | 事実、設備、時刻、停止理由 | 否定反転、数値改変、原因の創作 |
| 保全 | 故障履歴、点検標準、部品表 | 対象機、手順、危険表示、版番号 | 未承認手順の提示、部品誤認 |
| 品質 | 不良記録、検査基準、是正報告 | ロット、規格、判定、根拠箇所 | 合否の勝手な変更、根拠欠落 |
| 購買 | 見積、契約、承認規程 | 価格、通貨、納期、承認者条件 | 金額・通貨・取引先の混同 |
| 人事 | 就業規則、申請FAQ | 適用条件、申請先、版番号 | 個別人事判断の断定、個人情報露出 |
一つのテストケースには、質問だけでなく、期待する事実、許容表現、必須引用、禁止事項、リスク階層、評価者、データ版を付けます。「答えは自由記述」だけでは採点者によって判断が揺れます。正解が一つに決まらない相談なら、AIが確認質問を返すこと、担当部署へエスカレーションすることを正解に含めます。
タイ語で壊れやすい要素を意図的に入れる
通常ケースだけを並べると、本番の失敗を先送りします。テストセットには少なくとも次の変種を入れます。
- 固有名詞:人名、タイの工業団地名、仕入先名、設備名、製品名
- 数字:小数点、桁区切り、負数、ゼロ、範囲、単位、通貨
- 日付:西暦、タイ仏暦、期限、相対日付、夜勤の跨日
- 否定:「未実施」「問題なし」「交換不要」「禁止しない」の作用域
- 敬語・口調:上司向け、作業者向け、顧客向け、チャット略記
- 部署略語:製造、品質、保全、購買、人事で意味が異なる略称
- 混在言語:タイ語文中の英語品番、日本語由来の呼称、単位記号
- ノイズ:OCR誤り、余分な改行、表の崩れ、古いテンプレート
「簡単な質問の正答率」だけでなく、意味が近いが結論が逆になる対を作ります。例えば「交換した」と「まだ交換していない」、「承認が必要」と「この条件では承認不要」を同じセットに入れます。正解を作る担当者と最終承認者を分け、業務側が承認したものだけをゴールドデータにします。
タイ語LLMのモデルカードは候補条件であり、能力保証ではない
候補探索ではモデルカードが役立ちます。Typhoon2.1-Gemma3-12Bのカードは、12Bのテキスト専用モデル、主言語がタイ語と英語、コンテキスト長128Kと記載しています。Qwen-SEA-LION-v4.5-27B-ITのカードは、27B、コンテキスト長262K、タイ語を含む東南アジア言語での調整を記載しています。
これらは出版社が示す仕様であり、自社資料での正確性、安全性、応答時間、費用、導入容易性を保証しません。パラメータ数が大きい、コンテキストが長い、タイ語を含むという情報だけで順位をつけないでください。閉じたサービスと自己ホスト型では、監査、保守、アップデート、障害対応の責任も異なります。
候補を絞る段階では、ライセンス、提供地域、データ処理条件、ログ、アクセス制御、API互換性、運用支援を確認します。最終判断は同じ評価セット、同じ検索インデックス、同じ出力条件で行います。再現性のため、モデル版、プロンプト版、検索設定、文書スナップショット、実行日時を記録します。
RFP評価マトリクス:必須ゲートと加点項目を分ける
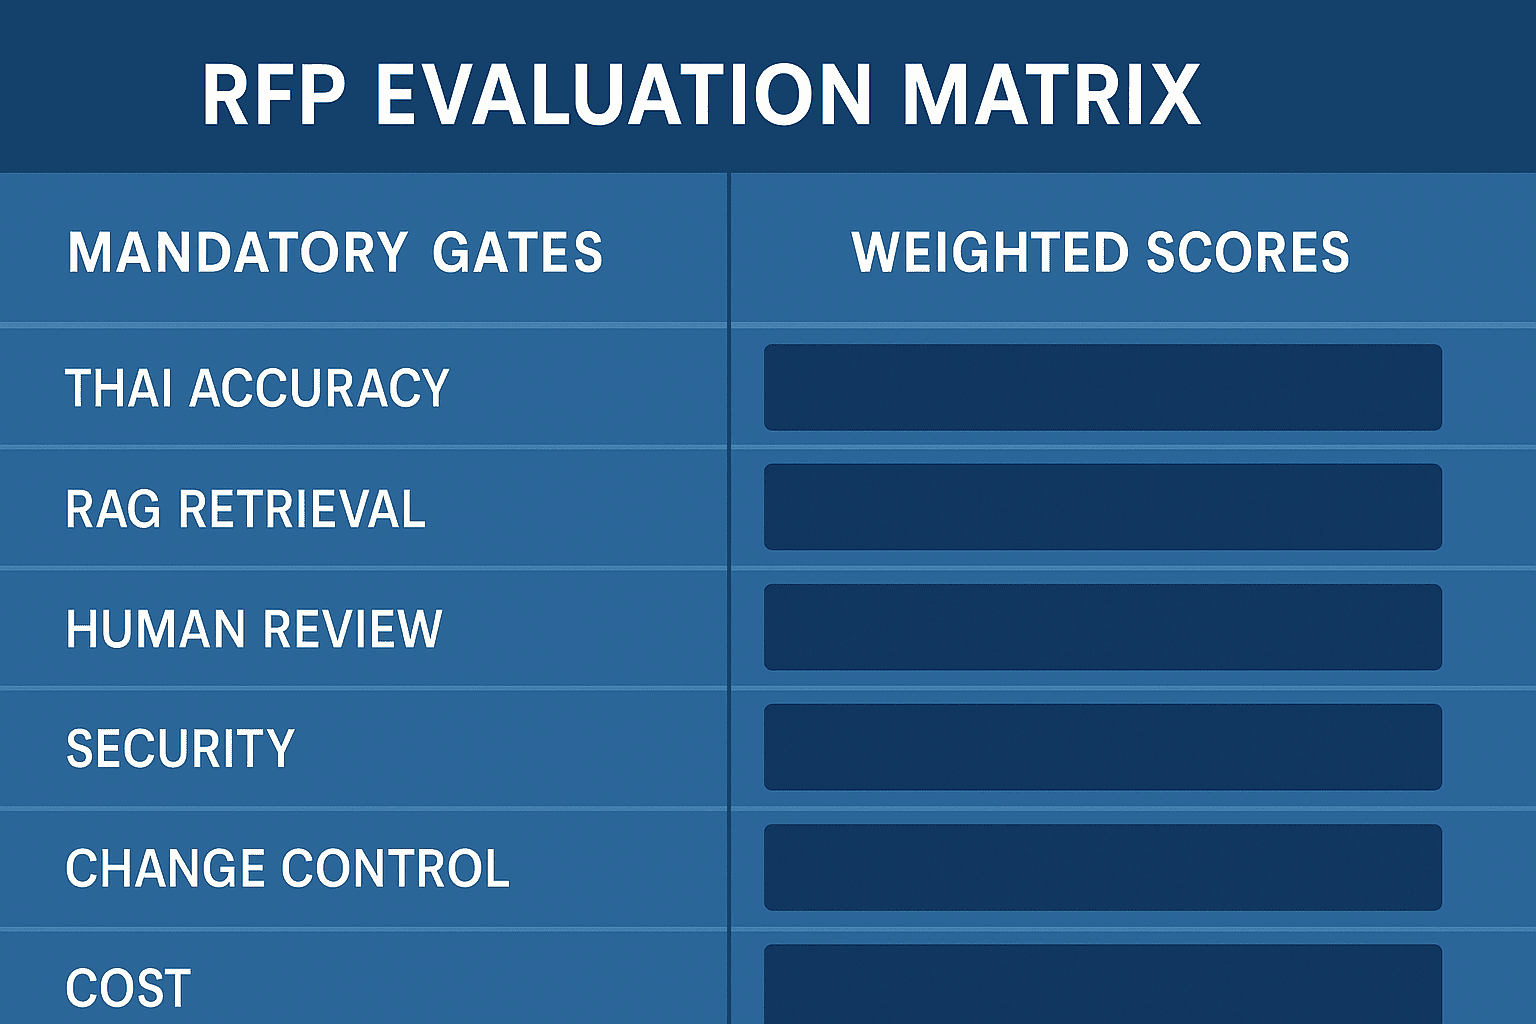
平均点方式だけでは、重大リスクを使い勝手の点で相殺できます。そこで「一件でも違反すれば不合格」の必須ゲートと、候補を比較する加点項目を分けます。次表の重みや基準値はすべてサンプルであり、自社のリスク評価に基づいて設定してください。
| 区分 | 評価項目 | 証拠 | 判定例(自社設定のサンプル) |
|---|---|---|---|
| 必須 | 機密データを許可外へ送らない | 構成、契約、通信ログ | 重大違反0件で合格 |
| 必須 | 安全・品質の禁止事項を守る | adversarial test記録 | 禁止回答0件で合格 |
| 必須 | 根拠不明時に保留・確認できる | 未知質問セット | 創作せず所定動作を行う |
| 必須 | タイ語で要求されたらタイ語で返す | 言語判定ログ | 対象ケース全件で要求言語 |
| 加点 | 事実・数値・日付の正確性 | ゴールドデータ比較 | 例:30点、自社で配点 |
| 加点 | RAGの検索品質 | Recall@k等 | 例:20点、自社で配点 |
| 加点 | タイ語の自然さと業務適合 | ネイティブ実務者評価 | 例:15点、自社で配点 |
| 加点 | 運用・監査・変更管理 | 手順、SLA、証跡 | 例:20点、自社で配点 |
| 加点 | 費用と応答時間 | 負荷試験、見積条件 | 例:15点、自社で配点 |
RFPではベンダーの自己申告だけでなく、証拠の形式を指定します。評価ログ、失敗ケース一覧、データフロー、サブプロセッサー、障害時の連絡、モデル変更通知、復旧手順、利用者教育資料などです。デモでは買い手が用意したブラインドケースを使い、事前に答えを渡しません。
自動評価と人手評価を組み合わせる
自動評価が得意なのは、文字列の一致、JSON形式、品番・数値・日付の抽出、引用ID、応答時間、拒否動作、再現実行です。人手評価が必要なのは、タイ語の自然さ、敬意の度合い、現場で誤解を生む曖昧さ、確認質問の妥当性、業務上の有用性です。
評価フローは次のようにします。
- 入力セットと期待結果を版管理する
- 各候補を固定条件で複数回実行する
- 自動チェックで形式、事実、数値、引用、禁止事項を判定する
- タイ語ネイティブの業務担当者が匿名化された出力を評価する
- 意見が割れたケースを業務オーナーが裁定する
- 失敗を原因別に分類し、修正後に回帰テストする
人手評価者には「好き・嫌い」ではなく尺度を渡します。例えば、意味の正確性、必要情報の充足、曖昧さ、口調、次の行動の明確さを段階評価し、重大誤りには別フラグを付けます。候補名を隠すブラインド評価にすれば、ブランド先入観を減らせます。評価者間の不一致も重要なデータです。人間同士で答えが割れる業務を、AIだけに確定させてはいけません。
RAGは「検索」と「生成」を分けて受入評価する
RAGが誤答したとき、原因は少なくとも三層あります。必要文書を検索できなかった、検索したが順位が低く入力に入らなかった、正しい文書を受け取ったのに生成時に誤った、という違いです。最終回答だけを見ると修正箇所が分かりません。
検索評価
- 正解文書が上位k件に入ったか
- 正しい版、拠点、部署、言語を選んだか
- 表、添付、スキャン文書から必要箇所を取れたか
- タイ語の表記揺れや略語で同じ文書へ到達できたか
- アクセス権のない文書を検索結果に出していないか
Recall@kやMean Reciprocal Rankなどの指標は使えますが、kや合格値は自社で設定します。高リスク業務では「正解文書がなければ回答しない」動作も評価します。
生成評価
- 回答の各重要主張に根拠があるか
- 引用した版番号と有効日が正しいか
- 数字、単位、日付、否定を保持したか
- 複数文書が矛盾するときに矛盾を示したか
- 根拠外の推測を事実のように追加していないか
検索器を固定して生成モデルを比較し、次に生成モデルを固定して検索設定を比較すると、改善の因果が見えます。文書更新後は、インデックス反映時間、削除反映、アクセス権変更も受入試験に入れます。
幻覚・機密・PDPAをリスク階層で運用する
NISTのGenerative AI Profileは、生成AI固有のリスクを既存のAIリスク管理へ組み込むためのプロファイルです。2024年7月26日公開、ソースページ上では2026年4月8日更新と記載されています。NISTの文書はタイ法への適合証明ではありませんが、リスクを特定し、測定し、管理し、継続監視する実務の土台になります。
業務は同じ統制にせず、影響で分けます。
| リスク階層 | 用途例 | AIの権限 | 人の関与 |
|---|---|---|---|
| 低 | 一般文の言い換え、アイデア出し | 下書きのみ | 利用者が通常確認 |
| 中 | 社内FAQ、日報要約、購買情報検索 | 根拠付き提案 | 担当者が承認して使用 |
| 高 | 品質判定、安全手順、人事・支払判断 | 自動確定を禁止 | 有資格・権限者が必ず判断 |
これは分類例です。自社で影響、可逆性、データ機微性、法的効果を評価して階層を設定します。高リスク領域では、AIを検索・下書き支援に限定し、最終判断、設備操作、外部送信を行わせません。
機密対策は「入力しないでください」という教育だけでは不十分です。技術的なアクセス制御、データ分類、DLP、ログ、保存期間、テナント境界、秘密情報のマスキング、出力先制御を組み合わせます。PDPAに関わる個人データは、利用目的、必要性、権限、保存、委託先、越境移転などを自社のDPO・法務と確認します。本稿は法的助言ではありません。
幻覚対策では、回答を短くするだけでなく、根拠表示、信頼できる文書範囲、未知時の拒否、確認質問、担当者への引継ぎをテストします。事故時には入力、出力、参照文書、モデル版、設定、利用者、時刻を追跡できる証跡が必要です。
90日PoCの例:デモではなく受入証拠をつくる
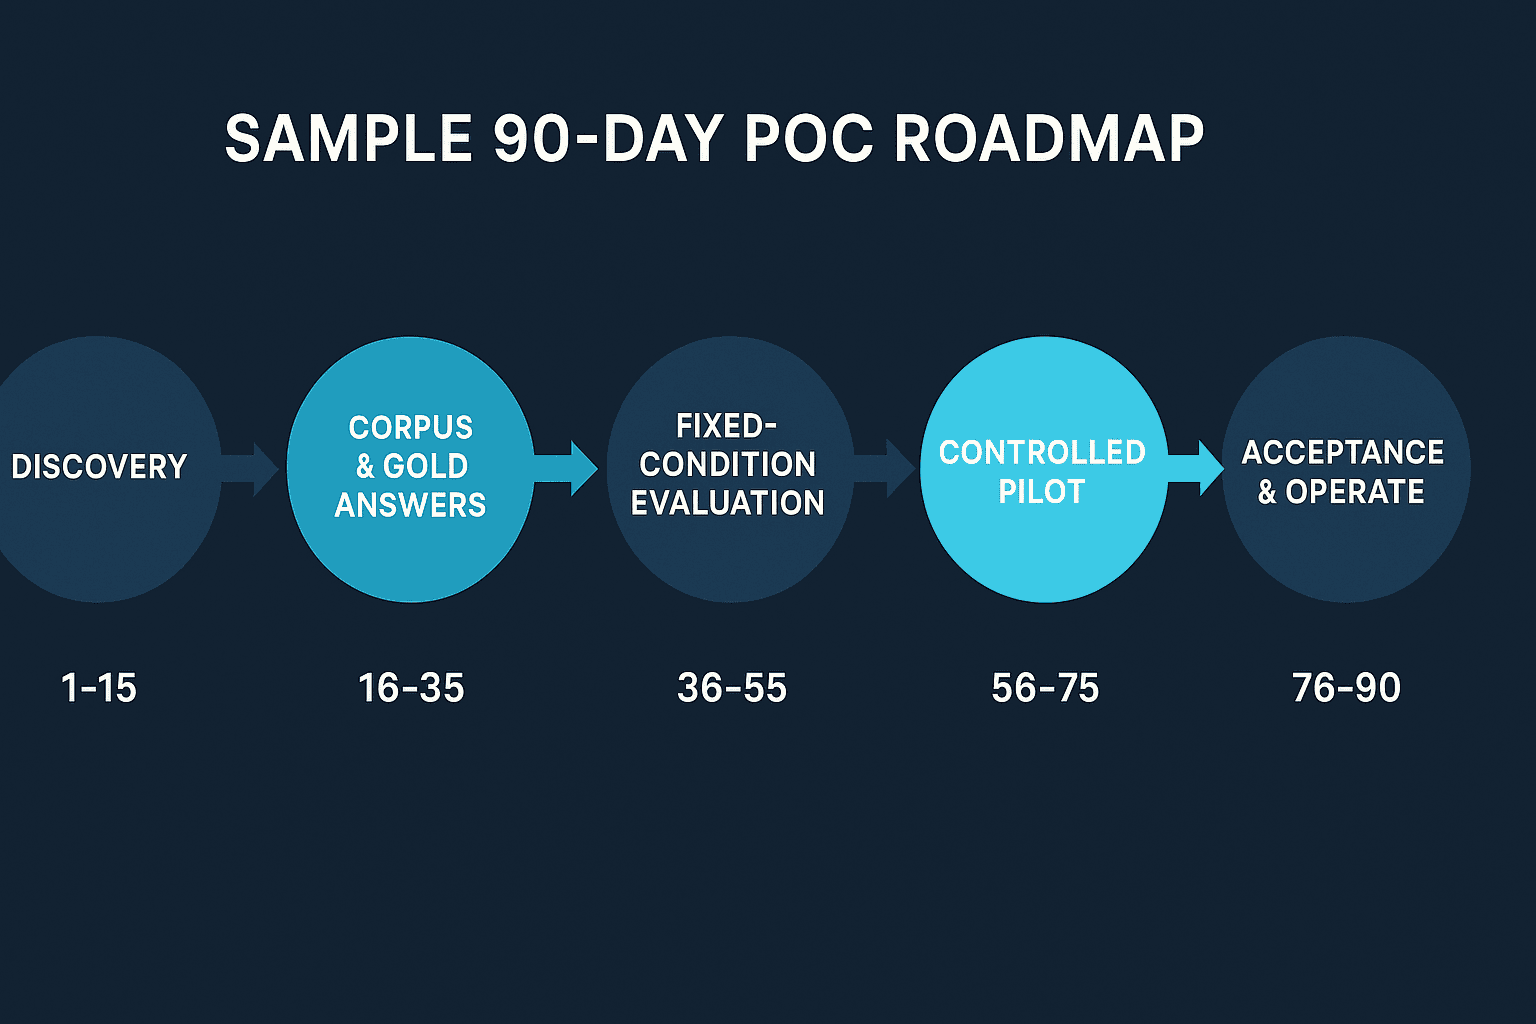
以下はサンプル計画です。90日がすべての企業に最適という意味ではなく、対象業務、データ準備、審査に応じて自社で変更してください。
1〜15日目:業務とリスクを固定する(例)
対象業務を一つか二つに限定し、業務オーナー、IT、セキュリティ、DPO・法務、タイ語評価者を決めます。現行の処理時間、エラー、問い合わせ件数など、PoC前の基準を取ります。AIが自動決定しない範囲、利用できないデータ、停止条件を合意します。
16〜35日目:コーパスと正解データを作る(例)
工場日報、保全、購買、人事などから代表ケースと難しいケースを抽出し、マスキングします。正解、根拠、禁止事項、リスク階層を付けます。文書の版、権限、言語、拠点メタデータも整えます。この工程を外注する場合も、正解の最終承認は業務オーナーが行います。
36〜55日目:候補を同条件で比較する(例)
検索設定、プロンプト、出力形式をそろえてブラインド評価します。必須ゲートで落ちた候補は、総合点が高くても本番候補にしません。失敗ケースをプロンプト、検索、文書、権限、モデル、運用のどこに原因があるか分類します。
56〜75日目:限定利用で運用を試す(例)
少人数のローカルスタッフが実業務に近い環境で使い、全件または自社で定めたサンプルを人が確認します。新しい言い回し、検索できない文書、誤操作、教育上の疑問を記録します。便利さだけでなく、確認時間、差し戻し、停止判断も測ります。
76〜90日目:受入試験と移行判断(例)
凍結した評価セットで最終試験を行い、必須ゲート、加点、残存リスク、運用費用を承認会議へ出します。合格、条件付き合格、再PoC、中止を区別します。条件付き合格なら、対象部署、利用者、データ、期間、解除条件を明文化します。
受入試験で確認すべき項目
受入試験は「動いた」という確認ではなく、契約上の完了条件です。少なくとも次を対象にします。
- 凍結したタイ語テストセットで必須ゲートを満たす
- 正解文書の検索、版管理、引用が設計どおりである
- 数字、日付、否定、固有名詞、略語の重大誤りが許容範囲内である
- 権限外文書を検索・生成・ログ表示しない
- 未知質問、矛盾文書、プロンプトインジェクションに所定動作をする
- モデルまたは設定変更後に回帰試験を実施できる
- 監査ログ、アラート、停止、復旧、問い合わせ窓口が機能する
- タイ語の操作説明と教育資料が用意されている
- 性能、応答時間、同時利用、費用上限を本番条件で確認する
合格値は用途ごとに自社で決めます。安全や品質に直結する禁止回答を、一般FAQの正答率で相殺しないことが重要です。失敗ケースは削除せず、回帰テストへ追加します。
契約条項に入れるべき評価・変更・責任
契約書やSOWでは、製品名と月額だけでなく、運用可能性を維持する条件を定めます。法的文言はタイ法・関係法令に詳しい専門家へ確認してください。
- 対象と除外:対象業務、拠点、言語、利用者、データ、禁止用途
- 受入基準:評価セット、必須ゲート、採点方法、再試験、証拠の保存
- 変更通知:モデル、バージョン、プロンプト、検索、サブプロセッサーの変更
- 回帰試験:変更前後で誰が、いつ、どのセットを実行し、費用を負担するか
- データ条件:入力・出力・ログの保存、学習利用、削除、返却、保管場所
- セキュリティ:アクセス制御、暗号化、脆弱性、事故通知、監査協力
- サービス水準:可用性だけでなく、応答、サポート、重大障害の復旧
- 知的財産:入力資料、設定、評価データ、成果物、第三者権利の扱い
- 終了時対応:データ移行、削除証明、ログ保持、代替運用
- 責任分界:AI提案、人の承認、外部送信、業務判断の責任者
「タイ語対応」という一文では受入条件になりません。対象となるタイ語業務、期待する出力、許容しない誤り、評価手順を別紙にします。モデルが自動更新されるサービスでは、重要変更を検知し、回帰試験で合格するまで高リスク用途を止める権利も検討します。
ローカルスタッフAI教育は受入試験の一部にする
ローカルスタッフ AI教育は、ツールの使い方説明だけでは足りません。何を入力してよいか、どの出力を信用してはいけないか、根拠をどう確認するか、どこへ報告するかを、タイ語の業務例で練習します。
教育は役割別にします。一般利用者はデータ分類、質問の作り方、根拠確認、エスカレーションを学びます。業務管理者は評価結果、アクセス権、失敗分析、利用停止を扱います。IT管理者は設定、ログ、更新、回帰試験を担当します。経営層は残存リスクと対象範囲を承認します。
教育の理解確認には、説明を聞いたかではなく、ケース演習を使います。機密を含む依頼、根拠のない回答、日付が矛盾する回答を見せ、正しい行動を選べるか確認します。タイ語の問い合わせ窓口と、報告しても不利益を受けない運用も必要です。
導入後の定着設計はタイ企業向けAI定着支援で、既製業務ツールの展開はタイでのMicrosoft Copilot導入で詳しく解説しています。本稿の評価設計を、教育と日常運用へつなげてください。
日系企業がタイでAIを選ぶための最終チェックリスト
評価会議では「平均点」ではなく失敗の残り方を見る
候補比較の最終会議では、総合点の順位だけを提示しないでください。必須ゲートの結果、重大誤りの件数、未解決ケース、対象外にした業務、運用で吸収するリスク、契約で移転するリスクを一枚にまとめます。同じ点数でも、軽微な文体差が多い候補と、数は少ないが否定や金額を誤る候補では意味が違います。
失敗一覧には、再現入力、期待結果、実際の結果、参照文書、原因仮説、暫定対策、恒久対策、責任者を付けます。「プロンプトを改善する」で閉じず、文書の版管理、権限メタデータ、検索分割、UIの警告、人の承認といった対策候補を比較します。対策後に同じケースだけを再実行すると過学習した修正を見逃すため、周辺ケースを含む回帰セットで確認します。
経営判断には、導入効果の期待値と残存リスクを同じ表に載せます。効果は処理時間だけでなく、検索時間、確認時間、差し戻し、教育、監査対応も含めます。金額や削減率を置く場合は、公開統計から借りず、自社のPoC実測を「自社測定」と明記して使います。PoCのデータが足りなければ、数字を作るのではなく、条件付き承認や追加計測を選びます。
本番移行の判断は、合格か不合格の二択に限りません。対象部署を限定する、機密区分を限定する、回答を下書きに限定する、一定期間は全件確認する、モデル更新を止める、といった条件付き移行が可能です。ただし条件には解除基準と期限を設定し、暫定統制が永続化しないようにします。逆に、禁止回答が解消しない、証跡が取れない、変更通知が得られない場合は、便利なデモであっても中止判断を明確にします。
また、採用しなかった候補の結果も保存します。将来の価格改定、モデル更新、提供地域の変更で再評価が必要になったとき、同じ基準で差分を確認できるためです。評価データそのものが機密を含む場合は、候補ベンダーへの共有範囲、保管場所、削除期限を定めます。評価資産を管理対象にすることで、次回の選定をデモ頼みへ戻さず、継続的な調達能力として社内に残せます。
- 日本語・英語デモとは別に、タイ語の実業務セットがある
- 正解データはタイの業務オーナーが承認している
- 固有名詞、数字、日付、否定、敬語、部署略語を試している
- RAGの検索評価と生成評価を分けている
- 必須ゲートと加点項目を分けている
- モデルカードの仕様を能力保証として扱っていない
- 不明時の拒否、確認質問、担当者引継ぎを評価している
- 機密、個人データ、権限、ログ、保存期間を設計している
- モデルや検索設定の変更後に回帰試験できる
- タイ語の教育、問い合わせ、事故報告の手順がある
- 受入条件と変更管理が契約・SOWに入っている
- 本番移行後の品質、費用、利用範囲を定期的に見直す
まとめ
タイ語 生成AIの調達で重要なのは、公開スペックやデモの流暢さから勝者を決めることではありません。タイ語の実業務コーパス、承認済みの正解、リスク階層ごとの合否、自動評価と人手評価、RAGの検索・生成分離、変更後の回帰試験を揃え、運用可能性を証拠で買うことです。モデル名は変わりますが、自社の評価資産と受入基準は次の候補にも使えます。
タイ語のテストセット設計、RFP評価表、限定PoCの範囲決めからでもご相談いただけます。TOMAS TECHは、タイの現場業務と日本本社の管理要件をつなぎ、モデル選定前の評価設計から本番運用まで整理します。お問い合わせはこちら。
FAQ
タイ 生成AI 活用はどの業務から評価すべきですか?
正解を確認でき、誤りの影響を限定できる業務から始めます。例えば社内文書検索や下書き支援は候補になります。ただし企業ごとにデータ機微性と業務影響が異なるため、頻度だけでなく、可逆性、正解の有無、人が確認できるかで選びます。品質判定や支払判断を最初から自動化するのは避け、支援用途として範囲を限定します。
日系企業 タイ AIのRFPでは何を必須条件にすべきですか?
対象業務、タイ語評価セット、禁止用途、データ処理、アクセス権、根拠表示、未知時の動作、監査ログ、変更通知、回帰試験、受入条件を必須にします。「タイ語対応」や総合正答率だけでは不十分です。高リスク項目は平均点から分離した必須ゲートにします。
タイ語 LLM 評価は公開ベンチマークだけで十分ですか?
十分ではありません。公開ベンチマークは候補探索や設計の参考になりますが、自社の設備名、帳票、略語、規程、アクセス権を反映しません。公開データに加え、匿名化・権限管理した実業務ケースと、業務オーナーが承認した正解データで受入試験を行います。
ローカルスタッフ AI教育では何を教えるべきですか?
プロンプトの書き方だけでなく、入力可能なデータ、根拠確認、数字・日付・否定の確認、AIに決めさせない事項、誤り発見時の停止と報告を教えます。タイ語の実例でケース演習を行い、正しい行動が取れることを受入条件に含めると運用へつながります。
どのタイ語生成AIモデルが最も高性能ですか?
公開情報だけで一律の優劣は断定できません。用途、文書、リスク、応答時間、運用方式によって適切な候補は変わります。同じ自社テストセットと条件で比較し、必須ゲート、運用品質、費用、変更管理を含めて判断してください。モデルカードの数値は候補条件であり、能力保証ではありません。


