


はじめに:工場のエネルギー異常検知AI導入で先に決める3つのこと
工場のエネルギー異常検知AI導入を考えるタイの日系工場では、次のような状況が珍しくないと考えます。電力監視の画面はある。15分ごとの値も取れている。それでも、グラフを見て「今日の使用量は多いのか、少ないのか」を判断できない。生産量や外気温で使用量が大きく動くため、単純な閾値を置くと誤報ばかりになり、やがて誰もアラートを見なくなる。
2026年は、電力の「量」を見直す理由が重なった年でもあります。The Nationの2026年7月23日の報道によると、エネルギー規制委員会(ERC)は2026年9〜12月請求分のFtを16.23サタン/kWhと承認し、平均料金は3.95バーツ/kWh(VAT別)で据え置かれました。同紙の2026年8月12日の報道では、9月請求分の平均は公共照明の費用を料金から外したことで約3.89バーツ/kWh(VAT別)になるとされています。ただし、この引き下げは「一般の利用者」の料金として報じられており、産業用への適用や10月以降の扱いは記事に書かれていません。同じくThe Nationの2026年7月1日の報道によると、2026年1〜3月のタイ全体の電力消費は51,127 GWhで前年同期比4.9%増、うち産業用は2.2%増で全体の42.3%を占めました。
もう一つの変化は、クラウドの汎用「異常検知API」の終了です。AWSの公式ページによると、Amazon Lookout for Equipmentは2026年10月7日にサポートが終了しました。Microsoft Learnによると、Azure AI Anomaly Detectorは2026年10月1日に廃止されています。これらの上に監視の仕組みを作っていた場合、作り直しが必要になります。
では、AIを入れればエネルギーのムダは自動で見つかるのでしょうか。本記事では、工場のエネルギー異常検知にAIを入れるとき、先に決めるのはアルゴリズムの名前ではなく、次の3つだと考えます。
- 何と比べて異常とするか:使用量そのものではなく、生産量・品種・外気温などの関連変数から求めた「期待消費量(ベースライン)」との差で見る。
- モデルの当てはまりの基準とアラートの出し方を分ける:モデルがよく当たることと、アラートが役に立つことは別の設計項目。アラートには、人が原因を確かめる担当と期限を付ける。
- 見直しと持ち出しを契約で決める:ベースラインを見直す条件、説明変数、データとモデルの持ち出し方法をRFP(提案依頼書)に書き、PoCとFAT/SAT(工場出荷試験・現地受入試験)で確かめる。
以下、この3点の根拠を、米国エネルギー省(DOE)のISO 50001ガイド、ASHRAE Guideline 14を引用する資料、公開ベンチマーク、主要製品の公開資料、タイの制度の順に確かめ、最後にRFPと受入試験の項目に落とします。
エネルギー異常検知AIとは何か:見つけたいのは「故障」より「ムダ」
エネルギー異常検知AIは、電力・エア・蒸気・ガスなどの使用量を継続的に見て、「いつもと違う使い方」を知らせる仕組みです。本記事で主に扱うのは、設備の故障予兆というより、日々の運転の中に紛れ込むエネルギーのムダです。たとえば、休日や昼休みに止め忘れた設備、生産が終わっても下がらない待機電力、夜間も減らないエアの消費、空調や冷却水の設定のずれなどです。
設備の故障予兆を見る異常検知は、振動・温度・電流波形など設備ごとの信号を使い、「壊れる前に止める」ことが目的です。これに対してエネルギーの異常検知は、工場や設備群の使用量を「生産や気温から見て妥当な量」と比べ、「余計に使っている時間帯と場所」を探すことが目的です。同じ「異常検知AI」という言葉でも、使うデータ、判定の基準、アラートを受ける人が違います。
工場の異常検知AIを、どの領域から着手するかという全体像は異常検知AI 2026|5領域のどこから着手するかを判定するで整理しています。本記事はそのうちエネルギー領域の実装各論です。計測点の選び方や見える化の費用など、異常検知の前提となる仕組みはエネルギー監視システムの費用と導入手順をご覧ください。
研究の世界でも、この「何を異常と呼ぶか」は簡単ではありません。Himeurらのレビュー(Applied Energy、2021年)は、AIによる建物エネルギー消費の異常検知を広く整理した上で、未解決の課題として「異常な電力消費の厳密な定義がない」こと、注釈付きのデータセットや統一された評価指標がないことを挙げています。このレビューの主な対象は住宅のサブメーターやスマートセンサーですが、工場でも事情は同じだと考えます。だからこそ、異常の定義を導入側が先に決める必要があります。
一方、工場を対象にした研究もあります。Mendiaらの論文(Expert Systems、2024年2月)は、工場の「正常な生産とエネルギーのふるまい」を教師なしで、人が理解できる形で特徴づけ、エネルギー消費と生産を同時に監視して異常や非効率を検出し、ライン・工程・機械のレベルで原因を特定するツールを報告しています。自動車部品メーカーGESTAMPのデータで評価し、比較した教師なし・半教師ありの手法より良い結果だったとしています。性能の数値はアブストラクトに示されていないため、本記事では数値を引用しません。注目したいのは、エネルギーと生産を一緒に見て、原因を人が理解できる形で示すという設計の方向です。
なぜ「使用量そのもの」では異常が分からないのか:EnPIの正規化
使用量のグラフだけを見て判断できないのは、使用量が「ムダ」だけでなく「生産の忙しさ」や「暑さ」でも動くからです。生産量が多い日に使用量が増えるのは当然で、それを異常と呼ぶと誤報になります。逆に、生産が少ないのに使用量があまり下がらない日こそ、ムダが隠れている可能性があります。
ISO 50001:2018は、エネルギーパフォーマンス指標(EnPI)とエネルギーベースライン(EnB)で改善を追う枠組みです。ISO 50001:2018に対応する米DOEの「50001 Ready Navigator」(ローレンス・バークレー国立研究所が公開)のガイドによると、EnPIは「単一の指標」「比率(原単位)」「1つ以上の関連変数を考慮した数値モデル」の形をとります。そして、関連変数がある場合は、エネルギー消費量そのものはEnPIにできず、EnPIを正規化すべきだとしています。関連変数が「有意に影響する」かどうかの判定基準は、組織が決めるとされています。
ここでいう正規化とは、生産量や外気温などの条件の違いをそろえた上で比べることです。原単位(kWh/個など)は最も簡単な正規化ですが、待機電力のように生産量と関係なく発生する部分があると、生産が少ない日ほど原単位が悪く見えるという癖があります。複数の関連変数を入れた回帰モデルは、この癖を補うための方法の一つです。
ISO 50001でのEnPIとEnBの位置づけや、見える化から投資回収までの流れはISO50001エネルギー管理2026で解説しています。なお、EnPIとEnBの設定・使用・維持の手引きとしてISO 50006:2023(第2版、2023年5月)があり、ISO 50001の有無にかかわらず使えるとされています。ただし本記事では、その条文の具体的な統計基準は確認していないため扱いません。
本記事の線引きも書いておきます。省エネ施策を実施した後に「いくら減ったか」を測定・検証して受け入れるのは、M&V(Measurement and Verification)の仕事です。ISO 50015:2014はその一般原則と手引きを示す規格で、IPMVPなどのプロトコルと組み合わせて使えるとされています。施策の削減額をM&Vで受け入れる方法は工場の省エネ対策|計測・ベースラインから90日PoCまでに譲ります。本記事は、施策の前後ではなく、日々の運転の中でムダや異常を見つける話です。使う道具(ベースライン、回帰、正規化)は共通ですが、目的と判定の頻度が違います。
ベースライン(期待消費量)モデルの作り方
エネルギー異常検知の中心は、「この条件なら、これくらい使うはず」という期待消費量を出すモデルです。実測値と期待消費量の差が大きく、しかもその差が統計的にありえる範囲を超えたときに、異常の候補とします。
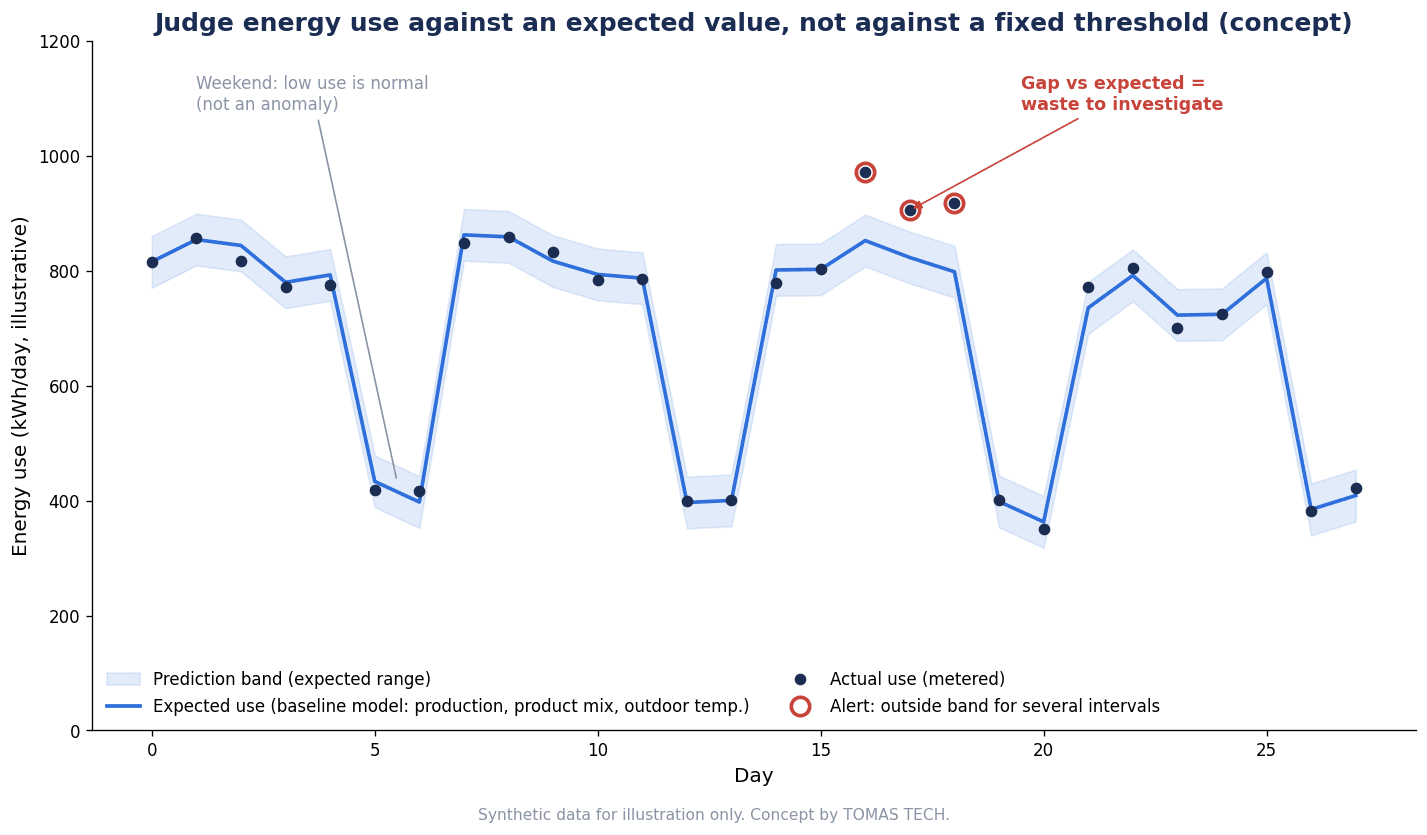
回帰から機械学習まで
最も基本的な形は、生産量と外気温を説明変数にした線形回帰です。そこに品種の構成、稼働シフト、曜日、休日の区分などを加えていきます。関係が線形でない場合や、変数どうしが複雑に絡む場合は、決定木系の手法やニューラルネットなどの機械学習を使うこともあります。
MDPIのAlgorithms誌に掲載された、ISO 50001のEnPIと計算モデルに関する系統的レビューは、5,442件から2,691件をスクリーニングし、283件を詳しく分析しています。それによると、研究の流れは従来の指標や正規化ベースラインから、回帰分析・機械学習・深層学習によるモデル化へ移っています。知的な手法は「動的なベースライン」や「異常な消費パターンの早期検知」を可能にする一方、データ品質、モデルの解釈性、方法論の標準化が課題だとされています。結論は、知的な手法はEnPIを置き換えるのではなく変革するべき、というものです。
本記事では、アルゴリズムの新しさよりも、現場の人が「なぜ期待値がこの値なのか」を説明できることを優先するのがよいと考えます。アラートを受けた担当者が、期待値の根拠となった生産量や気温を見て「確かに今日は少ないはずだ」と納得できなければ、現場確認につながらないからです。
説明変数の選び方
説明変数の候補は、生産量(個数・重量・ストローク数など)、品種や製品構成、稼働時間やシフト、外気温(必要なら湿度)、休日・計画停止の区分などです。選ぶときは次の点を確かめます。
- 使用量を実際に動かしている変数か。現場の感覚と、データ上の関係の両方で確かめる。
- 使用量と同じ期間・同じ粒度で取れるか。BPA(米ボンネビル電力局)の回帰ガイドも、説明変数と目的変数は同じ期間で測るべきだとしています。
- 誰がどのシステムから、いつまでに渡すか。生産量がMESやERPにあり、日次でしか確定しない場合は、異常の判定も日次になる。
ベースライン期間は運転条件の全範囲をカバーする
BPAの「Regression for M&V: Reference Guide」(第3版、2024年5月)は、ベースライン期間のデータが運転条件の全範囲を「カバー」すべきだとしています。天候に影響される場合は12か月または24か月が一般的で、10月から4月だけのデータでは真夏の条件をカバーせず、範囲外の予測になると説明しています。生産環境では「生産の一貫性」が保たれた期間を選ぶ必要がある、とも述べています。
タイの工場で冷房やチラーの負荷が大きい場合、暑季と雨季、乾季を含む期間がないと、季節が変わったとたんに期待値が外れて誤報が増えると考えます。立ち上げを急ぐ場合は、短い期間で作ったモデルを「暫定」と明記し、季節が一巡したところで作り直す前提にしておくのが現実的です。
15分値と自己相関
タイの大口需要家の料金は、後で述べるように15分平均の需要電力で決まります。収集する粒度を15分にそろえておくと、料金とつき合わせやすくなると考えます。15分値の収集を信頼できる形にする方法は電力量計 データ収集|15分値を信頼できるRFPと受入設計で解説しています。
ただし、細かい粒度には統計上の注意があります。BPAのガイドは、高頻度のデータほど節減量の不確かさを小さくしやすい一方で、時間値やそれより細かいデータでは自己相関(前後の値が似ていること)が統計計算をゆがめるため、追加の手当てが必要だとしています。同ガイドによると、ASHRAE Guideline 14のAnnex Dは、自己相関係数ρが0.5未満なら自己相関を無視できるとしています。異常の判定に15分値を使う場合、期待値は15分単位で出しつつ、統計の評価は日次や時間単位でも確かめる、といった二段構えが考えられます。
モデルの当てはまりの目安:ASHRAE Guideline 14をどう読むか
ベースラインモデルが「どれくらい当たっているか」には、M&Vの分野で使われてきた統計的な目安があります。代表的なのがCV(RMSE)(予測誤差の大きさを平均値で割った値)と、NMBE(予測の偏り)です。
| 指標・目安 | 内容 | 出典と条件 |
|---|---|---|
| CV(RMSE):最大20% | 報告期間のデータが12か月未満の場合の、エネルギー使用量の回帰ベースラインの上限 | ASHRAE Guideline 14-2014(EVOのM&V Focus記事、2022年10月が引用) |
| CV(RMSE):最大25% | 12〜60か月のデータで節減量を計算する場合のエネルギー使用量の上限 | 同上 |
| CV(RMSE):期待節減率の半分未満 | 線形回帰についてEVOが推奨。IPMVPは各メーターのCV(RMSE)を期待節減率の50%未満とする | 同上の記事 |
| 偏り(net determination bias error):0.005%未満 | この条件を満たせばエネルギーモデルを受け入れる | ASHRAE Guideline 14-2014(BPAガイドが引用) |
| R²:0.75超 | 月次の請求データを使う場合の経験則 | BPAガイド(経験則であり規格の要求ではない) |
| 自己相関係数ρ:0.5未満 | 自己相関を無視できる | ASHRAE Guideline 14 Annex D(BPAガイドが引用) |
この表を読むときに、3つの注意があります。
第一に、ここに挙げたCV(RMSE)の20%・25%は、回帰ベースラインの当てはまりの目安です。ASHRAE Guideline 14-2014の文言を、EVO(Efficiency Valuation Organization)の寄稿記事が引用したものです。ASHRAEの原文は有料のため、本記事では原文を確認していません。また、BPAのガイドによると最新版はASHRAE Guideline 14-2023で、2023年版で数値が変わったかどうかは確認できていません。
第二に、これはAI異常検知の合格基準ではありません。M&Vの目的は、一定期間の節減量を正しく推定することです。異常検知の目的は、個々の時間帯の大きなずれを見つけることです。モデル全体のCV(RMSE)が小さくても、アラートが多すぎたり、肝心の異常を見逃したりすることはありえます。逆に、モデルの当てはまりが目安を満たさない場合(たとえばCV(RMSE)が目安の値を上回る場合)は、説明変数が足りないか、データに問題がある可能性があり、アラートを出す前にそちらを直すのが先だと考えます。
第三に、EVOの記事の著者は、専門家の多くはR²よりCV(RMSE)を重視すると述べています。R²は使用量の変動が大きいと高く出やすいため、R²だけで「よく当たるモデル」と判断しないことが大切です。
RFPでは、ベンダーに「どの期間のデータで、どの指標を、どの単位(15分・時間・日)で報告するか」を出させ、その値を自社で確かめられる形にしておくことを勧めます。
データの準備と品質:異常を正常として学ばせない
ベースラインモデルの質は、学習に使うデータの質で決まります。BPAのガイドは、データのクリーニングについて次の手順を示しています。
- 外れ値:原因を調べ、設備故障、異常な休業、計器の不具合など真に異常なものは、記録した上で除外する。
- 非定常事象:改修、拡張、設備の追加・撤去、稼働スケジュールの変更などは調整する。
- 欠測:大きな欠損は原因や代替データ(近隣の気象観測所など)を探す。少数の欠測は前後の平均などで補完し、多い場合は回帰モデルで補間する。
- 重複:インターバルデータは重複しやすいので、重複を取り除く。
同ガイドは、クリーニングはベースライン期間と報告期間の両方で行うべきだとしています。異常検知に当てはめると、過去のデータに含まれていたエア漏れの期間や、止め忘れの夜を除かずに学習させると、モデルはそれを「正常」として覚えてしまうと考えます。LEAD1.0の論文も、Kaggleの上位参加者が除外した外れ値の注釈は不完全だったと記しています。過去の異常を拾い出す作業は、地味ですが省けません。
IPMVPを運営するEVOは、定常調整(定常的に変化すると予想される要因に対して、回帰などで条件をそろえること)と、非定常調整(変化しないと想定していた要因が、省エネ措置以外の理由でエネルギー使用に影響した場合の調整)を区別しています。生産量や気温の変化はモデルが吸収する「定常」、ラインの増設や設備の撤去はモデルの外で記録する「非定常」と分けておくと、後で述べるベースラインの見直しが整理しやすくなります。
データ辞書、時刻同期、欠測の扱いをどう計画するかはエネルギーマネジメントシステム|ISO/DIS 50012データ計画実務で詳しく扱っています。センサーや通信の欠測を受入基準に組み込む方法は工場センサーデータ欠測対策の導入をご覧ください。異常検知の場合、欠測そのものもアラートの対象にするかどうかを決めておく必要があります。メーターが止まって使用量がゼロになったのを「大幅な省エネ」と誤認しないためです。
アラートの設計:当てはまりとは別に決める
モデルができたら、次はアラートの出し方です。ここが本記事の背骨の2点目です。モデルの当てはまりの基準と、アラートの条件は別の設計項目として決めます。
予測区間で「ありえる範囲」を決める
BPAのガイドによると、予測区間(prediction interval)は「1つの観測値が入るはずの範囲」で、平均値の信頼区間より広くなります。個々の時間帯の実測値が期待値からどれだけ離れたら異常とみなすかは、この予測区間で考えるのが自然だと考えます。予測区間を外れたからといって必ず異常とは限りませんが、「モデルの誤差では説明しにくいずれ」の候補にはなります。
継続時間・金額・優先度を組み合わせる
1回の15分値が予測区間を外れただけで通知すると、アラートは増えすぎます。実務では、次のような条件を組み合わせることが考えられます。
| 設計項目 | 決めること | 考え方(本記事の見解) |
|---|---|---|
| ずれの大きさ | 予測区間の外か、期待値との差がどれだけか | モデルの誤差では説明しにくいずれだけを候補にする |
| 継続時間 | 何回連続、何時間続いたら通知するか | 一瞬の外れより、続くずれのほうがムダの可能性が高い |
| 金額・量への換算 | ずれをkWhや金額で示すか | 現場が優先順位を付けやすくなる。単価は契約と請求書から自社で設定する |
| 優先度 | 緊急・当日・週次の区分 | 小さく続くずれは週次の確認にまとめる |
| 通知先 | 誰に、どの経路で知らせるか | 設備・エリアごとに担当を決め、PREにも集約する |
| 確認期限 | いつまでに原因を確かめるか | 期限のないアラートは見られなくなる |
| 抑制条件 | 計画停止・試運転・設備更新中は止めるか | 分かっている事象で鳴らさない |
金額に換算する場合、単価は自社の契約区分と実際の請求書から設定してください。報道されている平均料金は一般向けの平均値であり、自社の料金そのものではありません。
アラート疲れを「件数を測る」ことで防ぐ
プロセス制御の分野には、アラームマネジメントの規格としてISA-18.2やEEMUA 191があり、運転員1人が受けるアラームの件数に目安を設けるという考え方が、複数の二次資料で紹介されています。これは運転員向けのアラームの目安であり、エネルギー異常のアラートの基準ではありません。それでも、「アラートの件数を設計し、実際の件数を測り、多すぎれば条件を見直す」という考え方は、そのまま借りられると考えます。
公開ベンチマークの論文も、ラベル付きデータがないため教師なし手法が広く使われ、誤検知が多くなることを課題に挙げています。ABBはエネルギー管理に関するニュース記事で、設備の経年で効率が変わるため、手動のアラート閾値は更新し続ける必要があると説明しています。閾値を人手で置くにせよ、AIに期待範囲を作らせるにせよ、アラートの件数と中身を毎週見直す仕組みが要ります。
人が原因を確かめる担当と期限を付ける
エネルギー異常のアラートは、それだけでは「ムダの候補」です。現場に行って、何が起きていたかを確かめて初めて、ムダか、正当な理由のある使用か、計測の問題かが分かります。本記事では、アラートには必ず「確認する担当」と「確認の期限」を付け、確認の結果を記録する運用を勧めます。担当が決まっていないアラートは、どれほど精度が高くても成果につながらないと考えます。
公開ベンチマークから分かること:当たりは多いが見逃しも多い
エネルギーの異常検知で、既製のAI手法はどのくらい使えるのでしょうか。公開のベンチマークとして、LEAD1.0(Gulati & Arjunan、arXiv 2203.17256、2022年3月30日)があります。条件を先に確認します。
- 対象は商業ビル(非住宅ビル)の電力メーター1,413本、2016年の1年分の時間値で、工場のデータではない。
- ASHRAE Great Energy Predictor III(Kaggle、2019年)のデータに、点異常と連続(集団)異常を人手で付与した(約100人時)。異常は12,060,910点中199,640点(欠測は数に含めない)。
- 評価は「24時間の区間が異常か否か」。手法はPyODの教師なしの既製8手法。指標はPrecision(適合率:異常と判定したうち本当に異常だった割合)、Recall(再現率:本当の異常のうち拾えた割合)、F1(両者の調和平均)。
結果は次のとおりです(論文の表1)。
| 手法 | F1 | Precision | Recall |
|---|---|---|---|
| KNN | 0.431 | 0.902 | 0.284 |
| LOF | 0.426 | 0.900 | 0.281 |
| CBLOF | 0.425 | 0.900 | 0.277 |
| Feature Bagging | 0.424 | 0.899 | 0.279 |
| MCD | 0.422 | 0.901 | 0.276 |
| OCSVM | 0.421 | 0.899 | 0.276 |
| Isolation Forest | 0.413 | 0.895 | 0.270 |
| HBOS | 0.397 | 0.896 | 0.258 |
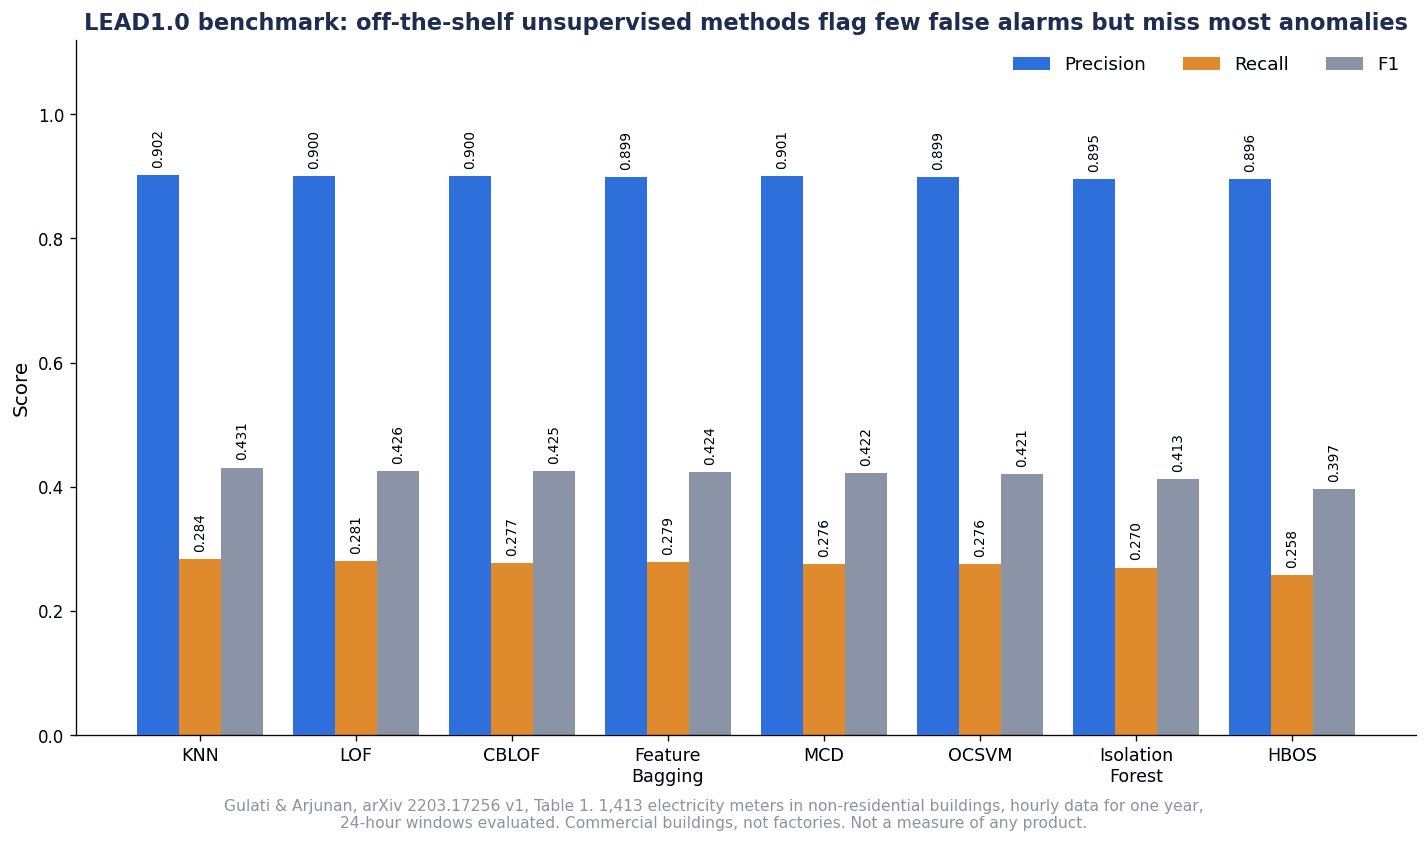
この条件の下では、8手法ともPrecisionは0.895〜0.902と高い一方で、Recallは0.258〜0.284にとどまり、F1は最も高いKNNでも0.431でした。つまり、「異常と判定した区間はおおむね当たっているが、人が付けた異常の多くを拾えていない」という結果です。著者自身も、これは限定的なベンチマークだと断っています。
この結果から本記事が引き出すのは、次の2点です。
第一に、一つの数字でAIを評価しないことです。「精度が高い」と言われても、それがPrecisionなのか、Recallなのか、F1なのかで意味がまったく違います。PrecisionとF1を取り違えると、評価を大きく誤ります。
第二に、既製の教師なし手法をそのまま当てるだけでは、見逃しが多くなりうることです。LEAD1.0の後にも、同じデータを使ってGANやクラスタ別のモデルを試した研究がありますが、対象のビル数、評価の単位、教師あり・なしの条件がそれぞれ違うため、値を横に並べて比べることはできません。工場で使う場合は、生産量や品種などの工場固有の説明変数を入れたベースラインと、人による確認の運用を組み合わせることが前提になると考えます。
商業ビルの時間値と、工場の15分値では、使用量の動き方がまったく違います。この表の値を工場で期待できる値として読まないでください。自社のデータで、自社が知っている過去の事象を使って確かめるのが、次の章以降で述べるPoCの役割です。
主要製品はどう説明しているか
エネルギーの期待値やアラートに関する機能を、主要な製品の公開資料がどう説明しているかを、社名のアルファベット順に整理します。優劣の比較や推奨ではなく、「どういう仕組みとして説明されているか」を見るための表です。公開価格は、いずれも確認できませんでした。
| 会社・製品(出典) | 同社の説明による主な機能 | 確認上の注意 |
|---|---|---|
| ABB(エネルギー管理のAI/MLに関するニュース記事) | 同社の説明では、AI異常検知は履歴から期待されるエネルギー消費の範囲を生成し、新しいデータが入るたびに再学習する | 検索結果の抜粋で確認。製品名・公開日は未確認 |
| 三菱電機 EcoAdviser(公式製品ページ) | 同社の説明では、「機能限定版」(管理)と「AI診断版」(分析・診断・検証・監視)の2種類。独自AIで「省エネ重点5視点」(設備の立上・立下の時間ロス、ユーティリティの時間ロス、原単位、生産ロス時間割合)からエネルギーロスを自動抽出。曜日・立上時刻・生産数などの要因を自動判定。エネルギーロスの自動監視はAI監視と目標値による固定監視 | AI監視には過去30日程度のデータが必要。ダッシュボードの監視パネルは10計測点・1日1回更新 |
| Schneider Electric EcoStruxure Power Monitoring Expert(製品ヘルプ) | 同社の説明では、設備・工程のモデルを作り、モデルに基づく期待消費量、実測値、両者の差(delta)を表示する。原単位のトレンドには、生産量・温度などの正規化データをETL・OPC・CSVで取り込む | ヘルプ本文は取得できず、検索結果の抜粋で確認 |
| Siemens SIMATIC Energy Manager PRO / Energy Analytics(第三者監査の証明書付属書) | 付属書によると、EnPIの設定、依存関係分析・回帰分析、早期警報のための閾値設定、関連変数・静的要因の決定、改善措置の管理が確認されている | AIによる異常検知機能そのものの公式説明は確認できなかった |
表に補足します。三菱電機の公式ページによると、EcoAdviserは電気・水・エアー・ガス・重油を一元管理し、原単位を管理できます。診断では、改善効果の目安を金額で表示し、ユーザーの評価を次回以降に反映すると説明されています。Schneider Electricの関連アプリ(Energy Modeling & Verification)は、外気温・在室・生産性などのドライバーを考慮したベースラインと比べて消費を分析すると説明されています。Siemensの証明書の付属書によると、証明書の対象コンポーネントはISO 50001の6.4(EnPI)、6.5(EnB)などの要求事項の遵守を支援し、SIMATIC Energy Manager PROとEnergy AnalyticsはISO 50006の4.2.4ほかの要求事項の遵守を支援するとされています。
表から見えるのは、各社の説明に共通する骨格です。関連変数(ドライバー)を取り込み、期待値を作り、実測値との差を見せ、閾値や期待範囲で知らせる。名前が「AI」でも「回帰」でも、本記事の背骨①で述べた「期待消費量との差で見る」という考え方は同じだと考えます。違いが出るのは、どの変数をどの頻度で取り込めるか、期待値の根拠をどこまで見せるか、再学習をどう制御できるかです。これらは各社の資料だけでは判断できないため、RFPとPoCで確かめます。現地でのサポート体制や画面の言語も、各社に個別に確かめてください。
終了したクラウドの異常検知サービス
ここに挙げなかったものとして、2026年に終了したクラウドサービスがあります。これらは現在の選択肢ではなく、「サービスが終了するとどうなるか」の事例として紹介します。
AWSの公式ページによると、Amazon Lookout for Equipmentは2026年10月7日にサポートが終了し、それ以降はコンソールとリソースにアクセスできなくなりました。ユーザーガイドの文書履歴によると、2024年10月17日から新規顧客の受付を停止していました。
Microsoft Learnによると、Azure AI Anomaly Detectorは2023年9月20日以降は新しいリソースを作成できなくなり、2026年10月1日に廃止されました。移行先としては、オープンソースのmicrosoft/anomaly-detectorを統合したMicrosoft Fabric、またはオープンソース版が案内されています。
どちらも、新規受付の停止から終了まで、年単位の期間がありました。それでも、監視の仕組みをこうしたサービスの上に作っていた工場は、モデルと学習データ、アラートの条件をどこかに移す作業を迫られます。本記事の背骨③で「サービス終了時のデータとモデルの持ち出し」をRFPに書くよう勧めるのは、このためです。
ベースラインの見直し(再学習)の条件と記録
ベースラインは一度作れば終わりではありません。設備が更新されれば、使用量の水準そのものが変わります。ここが背骨の3点目の前半です。
DOEのガイドによると、EnBは次のときに見直します。①EnPIが組織のエネルギーパフォーマンスを正確に反映しなくなったとき、②静的要因、工程、運転パターン、エネルギーシステムに大きな変化があったとき、③あらかじめ定めた方法に従うとき。そして、EnBの変更・更新の記録は保持しなければならないとしています。
工場の例に置き換えると、次のような場面が見直しのきっかけになります。
- 高効率のコンプレッサーやチラーへの更新、照明のLED化などの省エネ施策
- ラインの増設や撤去、建屋の拡張
- 品種構成の大きな変化(エネルギー多消費の品種が増えた、減ったなど)
- シフト体制や休日カレンダーの変更
- 計測点の追加や、メーター・CTの交換
一方、ABBは、AIが新しいデータが入るたびに再学習してベースラインを追従させる方式を説明しています。自動で追従すれば、設備の経年変化にも合わせやすくなります。ただし、ゆっくり進むムダ(少しずつ増えるエア漏れや、熱交換器の汚れなど)まで「新しい正常」として取り込んでしまうおそれもあると考えます。これは出典で確かめた主張ではなく本記事の推論ですが、だからこそ「いつ、何をきっかけに、誰の承認で再学習したか」を記録に残すことが重要です。
本記事では、再学習を次の2つに分けて決めることを勧めます。
- 定期的な再学習:季節の一巡ごとなど、あらかじめ決めた周期で行う。DOEのガイドの③「あらかじめ定めた方法」にあたる。
- 事象による見直し:上に挙げた変化があったときに行う。②にあたる。
どちらの場合も、再学習の前後でモデルの当てはまり(前章の指標)を比べ、変更の理由と承認者を記録します。省エネ施策の効果をM&Vで評価している最中に、異常検知のベースラインを勝手に動かすと、削減額の評価と矛盾が出るおそれがあります。両者を同じチームで管理するか、少なくとも変更を共有する仕組みにしておくのが安全だと考えます。
原因確認の流れ:アラートから対策と記録まで
アラートを成果につなげるのは、原因確認の流れです。本記事では、次の6段階で整理します。
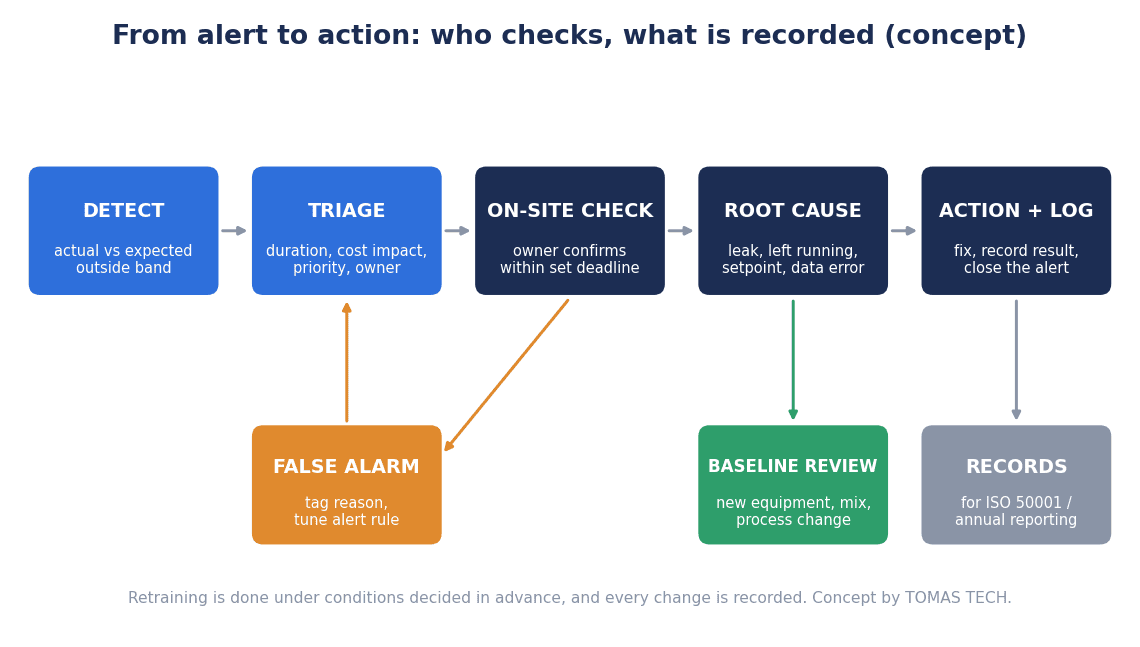
- 検知(DETECT):期待値との差が、決めた条件(予測区間、継続時間など)を超える。
- 振り分け(TRIAGE):計画停止や試運転など分かっている事象か、計測の不具合(欠測・ゼロ値・重複)か、本当に運転の異常かを、画面上で一次判断する。
- 現場確認(ON-SITE CHECK):担当者が期限までに現場で確かめる。
- 原因の分類(ROOT CAUSE):止め忘れ、設定のずれ、漏れ、設備の劣化、生産データの誤り、モデルの誤りなどに分類する。
- 対策(ACTION):その場で直せるものは直し、設備投資が必要なものは改善案件として登録する。
- 記録と再学習の判断(LOG / RETRAIN?):結果を記録し、ベースラインの見直しが必要かを判断する。
原因の確認先は、アラートが出た系統によって変わります。たとえば、夜間や休日にエア系統の使用量が下がらない場合は、エア漏れやコンプレッサーの台数制御が確認先になります。台数制御の見直しは工場コンプレッサー運転最適化AI導入で扱っています。外気温の割に空調・冷却系統の使用量が多い場合は、チラーの運転状態が確認先になります。チラーの計測点や監視の考え方は工場チラー監視システムの導入ガイドをご覧ください。
この流れで大切なのは、4の「原因の分類」に「モデルの誤り」と「生産データの誤り」を必ず入れておくことです。異常検知を運用すると、アラートの一定部分は、ムダではなく、生産量の入力漏れや、モデルが知らない運転条件によるものになると考えます。それを記録しておけば、説明変数の追加やデータ連携の改善につなげられます。逆に記録しなければ、同じ誤報が繰り返され、現場の信頼を失います。
記録は、少なくとも「アラートの日時と系統」「期待値と実測値の差」「確認者と確認日」「原因の分類」「対策と完了日」「再学習の要否」を残すことを勧めます。後で述べるように、タイの指定工場ではPREが設備の効率を定期的に監視する役割を負っており、この記録はその活動の裏付けにもなると考えます。
タイ固有の論点:指定工場・15分デマンド・Ft
指定工場の基準とPREの義務
タイのエネルギー保全促進法(ENCON Act)では、一定規模以上の工場が「指定工場」として扱われます。エネルギー効率促進部(DEDE)の発表資料(2023年2月28日付)によると、指定工場のグループ1は、電力計の契約容量が1,000〜3,000 kW、変圧器が1,175〜3,530 kVA、または年間のエネルギー消費が20〜60 TJのもの、グループ2はそれを超えるものです。電力計1,000 kW未満、変圧器1,175 kVA未満、年間20 TJ未満は、指定工場ではない(SME)区分とされています。
同じ資料によると、指定工場はエネルギー管理者(PRE:Person Responsible for Energy)を任命します。グループ1は1名以上(C-PRE)、グループ2は2名以上で、うち1名はシニアPRE(S-PRE)です。規則に沿ってエネルギー管理システムを運用し、エネルギー監査人が監査・認証した年次報告を、毎年3月中にDEDEへ提出します。PREの職務には、機械・設備の効率を定期的に維持・監視すること、省エネ措置に沿って改善すること、所有者のエネルギー管理システムの運用を補佐することなどが含まれます。
エネルギー異常検知のアラートを誰が受けるかを考えるとき、PREは自然な受け皿の一つだと考えます。ただし、PRE一人にすべてのアラートを集めると、現場確認が回りません。PREには集計と傾向の確認を、個々の現場確認は各エリアの設備担当に、という分担が現実的です。
料金は15分平均の需要で決まる
PEAの料金表(英語・非公式訳、2023年5月版)によると、大口の区分(Schedule 4 Large General Service)は、15分間の平均需要電力の最大値が1,000 kW以上、または直近3か月の平均使用量が月25万kWhを超える事業者・工場などです。中口(Schedule 3)は30 kW以上1,000 kW未満とされています。需要電力の料金が15分値の最大で決まるため、異常検知も15分値を最小の粒度にしておくと、料金とつき合わせやすいと考えます。なお、料金表の単価は2023年版の値で、その後の改定が反映されていないため、本記事では引用しません。最大需要を抑える制御の考え方はデマンドコントロール2026で解説しています。
Ftと料金は報道値をそのまま確かめる
冒頭で触れたとおり、2026年9〜12月請求分のFtは16.23サタン/kWh、平均料金は3.95バーツ/kWh(VAT別)で据え置かれたと報じられています。9月請求分の約3.89バーツは一般の利用者向けとして報じられたもので、産業用や10月以降への適用は確認できていません。異常のずれを金額に換算する場合は、報道の平均値ではなく、自社の契約区分と請求書の実績を使ってください。単価が動く中でも、kWhの「量」のずれを期待値との差で見ておけば、料金の変動とムダの発生を分けて把握できると考えます。
補助・優遇は個別に確認が必要
省エネ設備への補助や、BOIの投資優遇については、本記事の調査では、エネルギー監視や異常検知のソフトウェアが対象になると確認できた資料はありませんでした。制度は改定されることもあるため、利用を検討する場合はDEDEやBOIに最新の条件を確認する必要があります。
RFPに書く項目
ここまでの論点を、RFPの項目に落とします。背骨の3点目の後半です。エネルギー監視全般のRFPとFAT/SATの組み立て方はタイ エネルギー監視 RFP|FAT/SAT検収実務で解説しています。ここでは、異常検知に固有の項目を中心に挙げます。
| 項目 | RFPに書く内容 | 確かめる理由 |
|---|---|---|
| 対象範囲と計測点 | 対象の建屋・ライン・ユーティリティ系統、計測点の一覧、電力以外(エア・蒸気・ガス・水)を含むか | 異常の原因を系統まで絞れるかが決まる |
| 粒度 | 収集の粒度(15分など)、期待値を出す粒度、アラートを判定する粒度 | 料金の考え方と統計の扱いをそろえる |
| 説明変数 | 生産量・品種・稼働時間・外気温・休日区分など、取り込む変数と取込元(MES・ERP・気象データ)、取込頻度 | 期待消費量の根拠になる |
| ベースライン期間と見直し条件 | 学習に使う期間、運転条件のカバー範囲、定期の再学習の周期、事象による見直しの条件、承認の手順 | EnBの見直しと記録の保持に対応する |
| 当てはまりの報告 | CV(RMSE)・偏り・R²などの指標、算出の期間と単位、報告の頻度 | モデルの状態を自社で確かめる |
| データのクリーニング | 外れ値・非定常事象・欠測・重複の扱い、除外した期間の記録 | 異常を正常として学ばせない |
| アラートの条件と通知先 | 予測区間・継続時間・金額換算・優先度・抑制条件、通知の経路と宛先、条件を変更できる人 | アラートの件数と中身を管理する |
| 確認担当とワークフロー | 確認の担当と期限、原因分類のリスト、対策と完了の記録、件数の月次集計 | 人が原因を確かめる運用を仕組みにする |
| 期待値の説明 | アラートごとに、期待値の根拠となった変数の値を表示できるか | 現場が納得して確認に動ける |
| データ・モデルの所有と持ち出し | 計測データ・学習済みモデル・モデルの設定と説明変数の定義・アラートと確認の履歴の所有者、契約終了時やサービス終了時の出力形式と期限 | クラウドサービスの終了に備える |
| 保存期間 | 生データ・期待値・アラート・確認記録の保存期間 | 年次報告や過去の比較に使う |
| 費用の内訳 | 初期構築、計測機器、ライセンス、クラウド利用、再学習・保守、追加の計測点ごとの費用 | 運用段階の費用を見落とさない |
特に注意したいのは「データ・モデルの所有と持ち出し」です。前の章で見たように、クラウドの異常検知サービスは終了することがあります。学習済みモデルそのものを他の環境で動かせるとは限りませんが、少なくとも、説明変数の定義、学習に使ったデータと期間、除外した期間、アラートの条件、確認の履歴があれば、別の仕組みで作り直すことができます。これらを、契約上、自社のものとして受け取れる形にしておくことを勧めます。
PoCと受入試験(FAT/SAT)の設計
RFPで要件を決めたら、PoCと受入試験で確かめます。ここでも「合格ラインは自社で決める」が原則です。FAT/SATで異常検知の合否を数値で定めた公的な基準は、本記事の調査では見つかりませんでした。以下は考え方の例です。
過去データでの検証
最初のPoCは、過去のデータで行うのが効率的です。季節を含む期間のデータでモデルを作り、別の期間に当てはめて、アラートがどこで出るかを見ます。このとき、自社がすでに知っている過去の事象を必ず含めます。たとえば、エア漏れが見つかって修理した時期、空調の設定を誤っていた時期、ラインを止め忘れた休日などです。これらが検知されるか(見逃しはないか)、それ以外の時期にどれだけアラートが出るか(誤報はどれだけか)を、件数で記録します。
LEAD1.0の結果が示すように、PrecisionとRecallは別々に動きます。PoCでは、「アラートのうち、確認して意味があったもの」と「知っている事象のうち、拾えたもの」を両方数えることを勧めます。どちらを重く見るかは、確認にかけられる人手と、見逃したときの損失で決まります。合格ラインはPoCを始める前に決め、終わってから都合よく動かさないことが大切です。設備の異常検知PoCの進め方は異常検知 設備PoCの進め方|タイ工場90日受入基準も参考になります。
運用を含めた試験
性能だけでなく、運用の流れも試験の対象にします。FATでは、説明変数の取込、期待値の計算、アラートの条件の設定と変更、通知、確認記録の入力、データとモデルの出力が、仕様どおりに動くかを確かめます。SATでは、実際の計測点とつないだ状態で、時刻のずれや欠測があったときの振る舞い、計画停止中の抑制、確認担当への通知が期限どおりに届くかを確かめます。
さらに、試験の中で一度、ベースラインの見直しを実際に行ってみることを勧めます。見直しの前後で当てはまりの指標がどう変わったか、変更の理由と承認者が記録されたかを確かめておけば、本番で設備を更新したときに慌てずに済みます。同じく、契約で決めた形式でデータとモデルを出力できるかも、受入の段階で一度確かめておくのが安全です。
よくある質問
エネルギー異常検知にAIは必要?閾値ではだめ?
生産量や外気温で使用量が大きく動かない設備なら、固定の閾値でも役に立つ場合があります。ただし、DOEのガイドが示すように、関連変数がある場合は使用量そのものでは評価できず、正規化が必要です。ABBも、設備の経年で手動の閾値は更新し続ける必要があると説明しています。AIか回帰かという名前より、関連変数を入れた期待値と比べているかどうかが大切だと考えます。
ベースラインはどのくらいの期間のデータで作る?
BPAのガイドによると、天候に影響される場合は12か月または24か月が一般的で、運転条件の全範囲をカバーする必要があります。生産環境では、生産の一貫性が保たれた期間を選びます。短い期間で始める場合は暫定のモデルとし、季節が一巡したところで作り直す前提にしておくことを勧めます。なお、三菱電機はEcoAdviserのAI監視について、過去30日程度のデータが必要と説明しています。必要な期間は製品と目的によって違うため、RFPで確かめます。
EnPIの正規化とは?
生産量や外気温などの関連変数の違いをそろえた上で、エネルギーパフォーマンスを比べることです。DOEのガイドによると、EnPIは単一の指標、比率(原単位)、関連変数を考慮した数値モデルの形をとり、関連変数がある場合は正規化すべきだとされています。異常検知のベースラインは、この正規化の考え方を日々の監視に使うものだと言えます。
誤報が多いときはどうする?
まず、アラートの件数と確認結果を記録し、原因を分類します。誤報の原因が生産データの入力漏れなのか、モデルが知らない運転条件なのか、計測の不具合なのかで、直す場所が違います。説明変数を足す、計画停止中の抑制条件を加える、継続時間の条件を見直す、といった対策が考えられます。条件を変えた場合は、変更の理由と日付を記録しておきます。
クラウドサービスが終了したらどうなる?
Amazon Lookout for Equipmentは2026年10月7日にサポートが終了し、Azure AI Anomaly Detectorは2026年10月1日に廃止されました。終了後はそのサービスの上でモデルを動かせなくなります。説明変数の定義、学習データと期間、アラートの条件、確認の履歴を自社で持っていれば、別の仕組みで作り直せます。RFPで、これらの所有と出力の形式を決めておくことを勧めます。
まとめ
- 工場のエネルギー異常検知にAIを入れるとき、先に決めるのはアルゴリズムの名前ではなく3つのことです。①何と比べて異常とするか、②モデルの当てはまりの基準とアラートの出し方を分けて人が原因を確かめる運用にすること、③見直しの条件とデータ・モデルの持ち出しをRFPに書き、PoCとFAT/SATで確かめることです。
- DOEのガイドによると、関連変数がある場合はエネルギー消費量そのものをEnPIにできず、正規化が必要です。期待消費量(ベースライン)との差で見ることが出発点です。
- ASHRAE Guideline 14-2014の回帰ベースラインの目安(EVOの記事の引用で、CV(RMSE)は報告期間のデータが12か月未満なら20%、12〜60か月なら25%)は、モデルの当てはまりの目安であって、アラートの合格基準ではありません。
- 商業ビル1,413メーター・1年分の時間値で教師なしの既製8手法を評価したLEAD1.0では、Precisionは0.895〜0.902と高い一方、Recallは0.258〜0.284でした。一つの数字でAIを評価せず、見逃しと誤報を別々に数えます。
- ベースラインの見直しは、条件を決めて記録します。クラウドの異常検知サービスは2026年に相次いで終了しており、データとモデルの持ち出しを契約で決めておくことが重要です。
計測データの棚卸しや、どの変数でベースラインを作れるかを検討する段階でも、TOMAS TECHにご相談いただけます。お問い合わせはこちらからどうぞ。
参考情報
- DEDE「Thailand’s Energy Efficiency」2023年2月28日(NEDO掲載、PDF) https://www.nedo.go.jp/content/100959493.pdf
- The Nation「Power tariff held at 3.95 baht through year-end」2026年7月23日 https://www.nationthailand.com/news/general/40068945
- The Nation「Thailand cuts September power tariff, caps first 200 units at 3 baht」2026年8月12日 https://www.nationthailand.com/news/general/40069705
- The Nation「Thailand’s energy consumption rises 2.1% on 2.8% GDP growth」2026年7月1日 https://www.nationthailand.com/business/economy/40068117
- PEA「Electricity Tariffs」2023年5月版(英語・非公式訳、PDF) https://www.pea.co.th/sites/default/files/documents/tariff/EN_Electricity_Tariffs_May_2023.pdf
- ISO「ISO 50001:2018」 https://www.iso.org/standard/69426.html
- U.S. DOE 50001 Ready Navigator「Task 11: Energy Performance Indicators and Energy Baselines」 https://navigator.lbl.gov/guidance/task/11
- DIN Media「DIN ISO 50006」 https://www.dinmedia.de/de/norm/din-iso-50006/384067911
- ISO「ISO 50015:2014」 https://www.iso.org/standard/60043.html
- EVO M&V Focus Issue #10、John Avina「Relaxing CV(RMSE) requirements for Option C M&V regressions」2022年10月 https://evo-world.org/en/m-v-community/mv-focus/903-m-v-focus-issue-no-10/1338-relaxing-cv-rmse-requirements-for-option-c-m-v-regressions
- Bonneville Power Administration「Regression for M&V: Reference Guide」Version 3.0、2024年5月(PDF) https://www.bpa.gov/-/media/Aep/energy-efficiency/measurement-verification/3-bpa-mv-regression-reference-guide.pdf
- EVO「NRA / NRE」IPMVP委員会ページ https://evo-world.org/en/about-en/organization/ipmvp-committee/nra-nre
- Schneider Electric「EcoStruxure Power Monitoring Expert 2023」Use Model Report https://product-help.schneider-electric.com/EcoStruxure/Power-Monitoring-Expert-2023/content/6_operating/webapps/reports/energyanalysis/usemodel_report.htm
- Schneider Electric「EcoStruxure Power Monitoring Expert 2023」Create Model Report https://product-help.schneider-electric.com/EcoStruxure/Power-Monitoring-Expert-2023/content/6_operating/webapps/reports/energyanalysis/createmodel_report.htm
- Siemens「SIMATIC Energy Manager PRO / Energy Analytics」証明書付属書(PDF) https://assets.new.siemens.com/siemens/assets/api/uuid:90799adf-4e2c-42fa-885c-082bc7cabe74/certificate-no–c-09-2020-21250307.pdf
- AWS「Amazon Lookout for Equipment」 https://aws.amazon.com/lookout-for-equipment/
- AWS「Amazon Lookout for Equipment」ユーザーガイド文書履歴 https://docs.aws.amazon.com/lookout-for-equipment/latest/ug/doc-history.html
- Microsoft Learn「Azure AI Anomaly Detector」概要ページ https://learn.microsoft.com/en-us/azure/ai-services/anomaly-detector/overview
- ABB「Celebrating Earth Day with AI/ML energy management innovation」 https://new.abb.com/news/detail/124636/celebrating-earth-day-with-aiml-energy-management-innovation
- 三菱電機「省エネ支援アプリケーション EcoAdviser」 https://www.mitsubishielectric.co.jp/fa/products/software/ems/eap/index.html
- Gulati, Arjunan「LEAD1.0」arXiv 2203.17256、2022年3月30日 https://arxiv.org/abs/2203.17256
- Himeur ほか(建物エネルギー消費のAI異常検知のレビュー)arXiv 2010.04560、Applied Energy Vol.287、2021年 https://arxiv.org/abs/2010.04560
- Iturralde Carrera ほか「Intelligent Computational Modeling of ISO 50001 Energy Performance Indicators for Sustainable Energy Management Systems: A Systematic Review」(DOI 10.3390/a19070533) https://www.citedrive.com/en/discovery/intelligent-computational-modeling-of-iso-50001-energy-performance-indicators-for-sustainable-energy-management-systems-a-systematic-review/
- Mendia, Gil-Lopez, Grau, Del Ser「A novel approach for the detection of anomalous energy consumption patterns in industrial cyber-physical systems」Expert Systems 41(2)、2024年2月 https://dsp.tecnalia.com/items/f7c96e3b-ba08-4afd-9af0-19f4e6074604/full
- Emerson「Alarm Management by the Numbers」(PDF) https://d1-live.emerson.com/documents/automation/article-alarm-management-by-numbers-deltav-en-38292.pdf


