


輸出書類 AI-OCR 導入を検討するとき、最初に決めたいのは「何枚読めるか」ではなく、どの値を、どの書類・業務データと照合し、誰が承認して次工程へ渡すかです。Commercial Invoice(以下、インボイス)とPacking List(以下、パッキングリスト)は、同じ出荷を異なる視点で表します。片方の文字をデータ化できても、品目・数量・荷姿の対応が曖昧なら、転記の時間は減っても確認の手間は残ります。本稿では、タイからの輸出を含む製造業の実務を想定し、対象範囲、データ設計、照合ルール、人による承認、ERP連携、RFPとFAT・SATの作り方を順に整理します。税関申告や原産地判定の自動化は対象外とし、必要な専門判断は担当者に残す設計です。
輸出書類のAI-OCRは「入力」と「照合」を分けて考える
AI-OCRは画像やPDF上の文字を読み取り、項目と明細を構造化する手段です。たとえばインボイス番号、発行日、売主、買主、通貨、品目、数量、単価、金額を抽出できます。AWS Textractの請求書解析はヘッダー相当の項目と明細行を分けて返し、フィールドごとの位置や信頼度も保持します。MicrosoftのDocument Intelligenceも請求書の項目と明細を構造化して返します。ただし、各製品の標準「invoice」モデルが、自社の輸出インボイスや独自のパッキングリストをそのまま完全に読めるという意味ではありません。まず実サンプルで検証する必要があります。AWS公式資料・Microsoft公式資料
照合は抽出の次の工程です。書類内の合計と明細を突き合わせ、さらにインボイスとパッキングリスト、ERPの出荷指示や受注情報を比較します。抽出結果が高い信頼度でも、原本にある値そのものが誤っていれば、OCRだけでは発見できません。逆に信頼度が低くても正しい値を読めていることがあります。信頼度は「確認する順番」を決める材料であり、業務上の正しさを保証する値ではありません。GoogleのDocument AIの評価資料も、信頼度しきい値を上げると一般にprecisionとrecallのトレードオフが生じることを説明しています。Google公式資料
導入範囲は三層に分けると明確です。第一層は書類受領・分類・読み取り。第二層は項目正規化・書類間照合・例外抽出。第三層は人の承認後にERPや出荷管理へ反映する工程です。第一層のデモだけで採否を決めると、運用で詰まりやすい第二・第三層の工数が見えません。RFPでは、三層それぞれの入出力、責任者、失敗時の扱いを示して見積もりを求めます。書類業務全体を俯瞰する際は、既存のバックオフィスAI-OCR解説も参考になります。本稿はそのうち輸出書類の照合と承認に絞ります。
インボイスとパッキングリストで何を読むか
インボイスは取引・金額の見方、パッキングリストは実際の梱包と数量の見方を提供します。UN/CEFACTはCross Industry InvoiceとCross Industry Packing Listを別々の標準として公開しており、WCOもインボイスやパッキングリストに含まれるデータ要素と国境を越えるデータの整合に言及しています。これらは自社の項目辞書を作る際の参照点になります。ただし、書類の実際の記載と照合項目は取引・国・顧客・運送方法で変わるため、標準をそのまま全件の必須項目にしないことが大切です。UN/CEFACT標準一覧・WCOデータモデル
初期の項目辞書は「原本にある文字列」「正規化した値」「照合先」「責任部署」の4列で作ります。インボイスなら文書番号、発行日、売主・買主、出荷先、注文参照番号、通貨、明細の品番・品名・数量・単位・単価・金額、合計などが候補です。パッキングリストなら文書番号、対応するインボイス番号または注文番号、品番・品名、梱包単位、箱番号、箱数、各箱の数量、総数量、正味重量・総重量、寸法などを候補にします。すべてを一度にOCR対象にする必要はありません。誤入力が後工程に響く項目と、転記時間が長い項目から優先します。
| 分類 | 最初に確認する値 | 比較先 | 不一致時の扱い |
|---|---|---|---|
| 書類の結び付き | インボイス番号、注文・出荷参照番号 | パッキングリスト、ERP出荷指示 | 同一出荷か人が確認 |
| 品目 | 品番、顧客品番、品名 | ERP品目マスタ、両書類 | 品番を優先し別名は辞書で解決 |
| 数量 | 行数量、合計数量、箱内数量 | 両書類、出荷実績 | 単位を揃えて差を表示 |
| 金額 | 単価、行金額、通貨、合計 | インボイス内、ERP取引 | 丸め・値引き条件を確認 |
| 荷姿 | 箱番号、箱数、重量、寸法 | パッキングリスト、物流データ | 対象範囲と計測時点を確認 |
インボイスとパッキングリストを単純な1対1表で比較してはいけません。インボイスの1品目が複数箱に分かれることも、1箱に複数品目が入ることもあります。キーは出荷ID・品番・ロット・梱包階層などから業務に合う組み合わせを決め、箱明細を品目単位へ集計して照合します。品名だけのあいまい一致を主キーにすると、似た型番や表記ゆれを誤って結び付ける危険があります。結び付かなかった行は推測で埋めず、例外として残します。
「どちらが正本か」を項目ごとに定義する
同じ項目でも、ERP、インボイス、パッキングリストのどれを正本とするかは異なります。品番・注文数量の基準はERPで管理していても、出荷時の箱数は梱包実績が正しいかもしれません。通貨や単価は承認済み取引条件を基準にし、パッキングリストにはそもそも載せない運用もあります。システムが「最も新しいファイル」を正本にする設計は避け、項目単位で優先順位と変更権限を定義します。
その定義には版管理も含めます。輸出前にインボイスの数量や荷姿が訂正された場合、旧版と新版が同じメールスレッドや共有フォルダに残ります。OCRは両方を読めてしまうため、文書番号・改訂番号・受領日時・承認状態・ハッシュ値などを使って同一出荷の版を管理します。版情報が無い書類は、担当者に確認を促すのが安全です。AIに「最終版らしいもの」を推測させて後続に書き込む運用は避けます。
インボイス・パッキングリストOCRの処理フロー
実務フローは、受領→文書分類→前処理→抽出→正規化→照合→例外確認→承認→連携→監査記録、の順に設計します。各工程で入力、出力、再処理方法を明示すると、現場で「エラーが出た後に誰が何をするか」が分かります。
1. 受領・文書分類
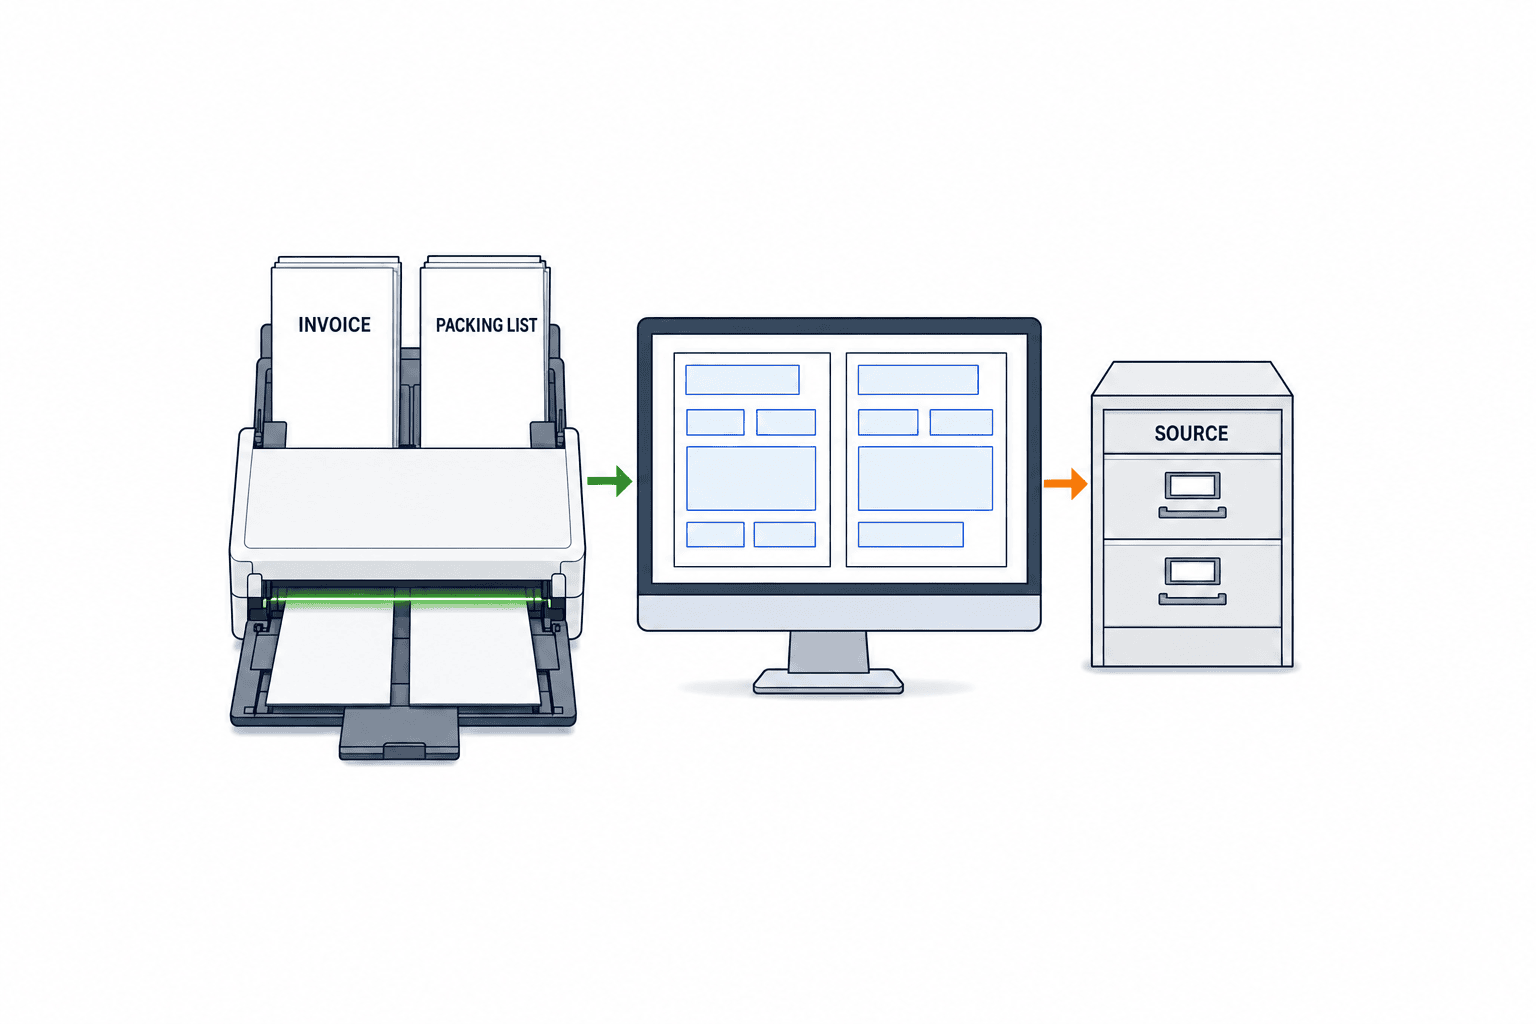
メール添付、取引先ポータル、共有フォルダ、スキャンなど、入口を列挙します。複数ファイルをまとめたPDF、ページ順が逆のPDF、写真、パスワード付きファイルなどは例外条件です。書類分類は「インボイス」「パッキングリスト」「その他」「判定不能」に分け、判定不能を自動でインボイス扱いにしません。原本は出所、受領時刻、ファイル名、処理IDとともに保管し、後で抽出結果から原本へ戻れるようにします。
2. 画像・PDFの前処理と抽出
斜行、低解像度、影、折れ、手書き追記、複数言語、複雑な表は読取品質に影響します。デジタルPDFのテキスト層が使える場合と、画像OCRが必要な場合を分けます。モデル選定では、輸出書類特有の見出し、表の続き、改ページ、複数通貨表記、署名・注記の混在を実サンプルで評価します。標準モデルを使うか、カスタムモデルを作るかは、学習・保守の工数も含めて判断します。
抽出時は値だけでなく、ページ番号と画面上の位置、原文、信頼度を残します。確認画面では担当者が数値をクリックすると該当箇所が強調されると、照合の時間を短縮できます。文字列「1,000」を数値1000へ変換した場合も、原文を消さずに残します。後から変換規則を調べられるよう、モデル・プロンプト・ルールのバージョンを処理IDへ紐付けます。
3. 正規化とマスタ照会
OCR出力をそのままERPに入れる前に、日付形式、桁区切り、小数点、通貨コード、数量単位、重量単位、品番の大文字・小文字、全角・半角、顧客固有の略称を正規化します。たとえば「PCS」「pieces」「ชิ้น」を同じ数量単位に寄せることはできますが、セット品を単品へ換算するなら換算係数の根拠が必要です。通貨記号「$」だけでは通貨コードを確定しない、品名の近似だけで品番を確定しない、といった保留条件も明記します。
品目マスタ照会は、完全一致、承認済み別名、候補提示の順に分けます。候補提示を自動確定に昇格させる条件は別途検証します。頻出する表記揺れは辞書へ登録し、登録者・承認者・適用開始日を記録します。OCRのモデル精度を上げるだけでなく、書類テンプレートやマスタを改善した方が効果的な場合もあります。
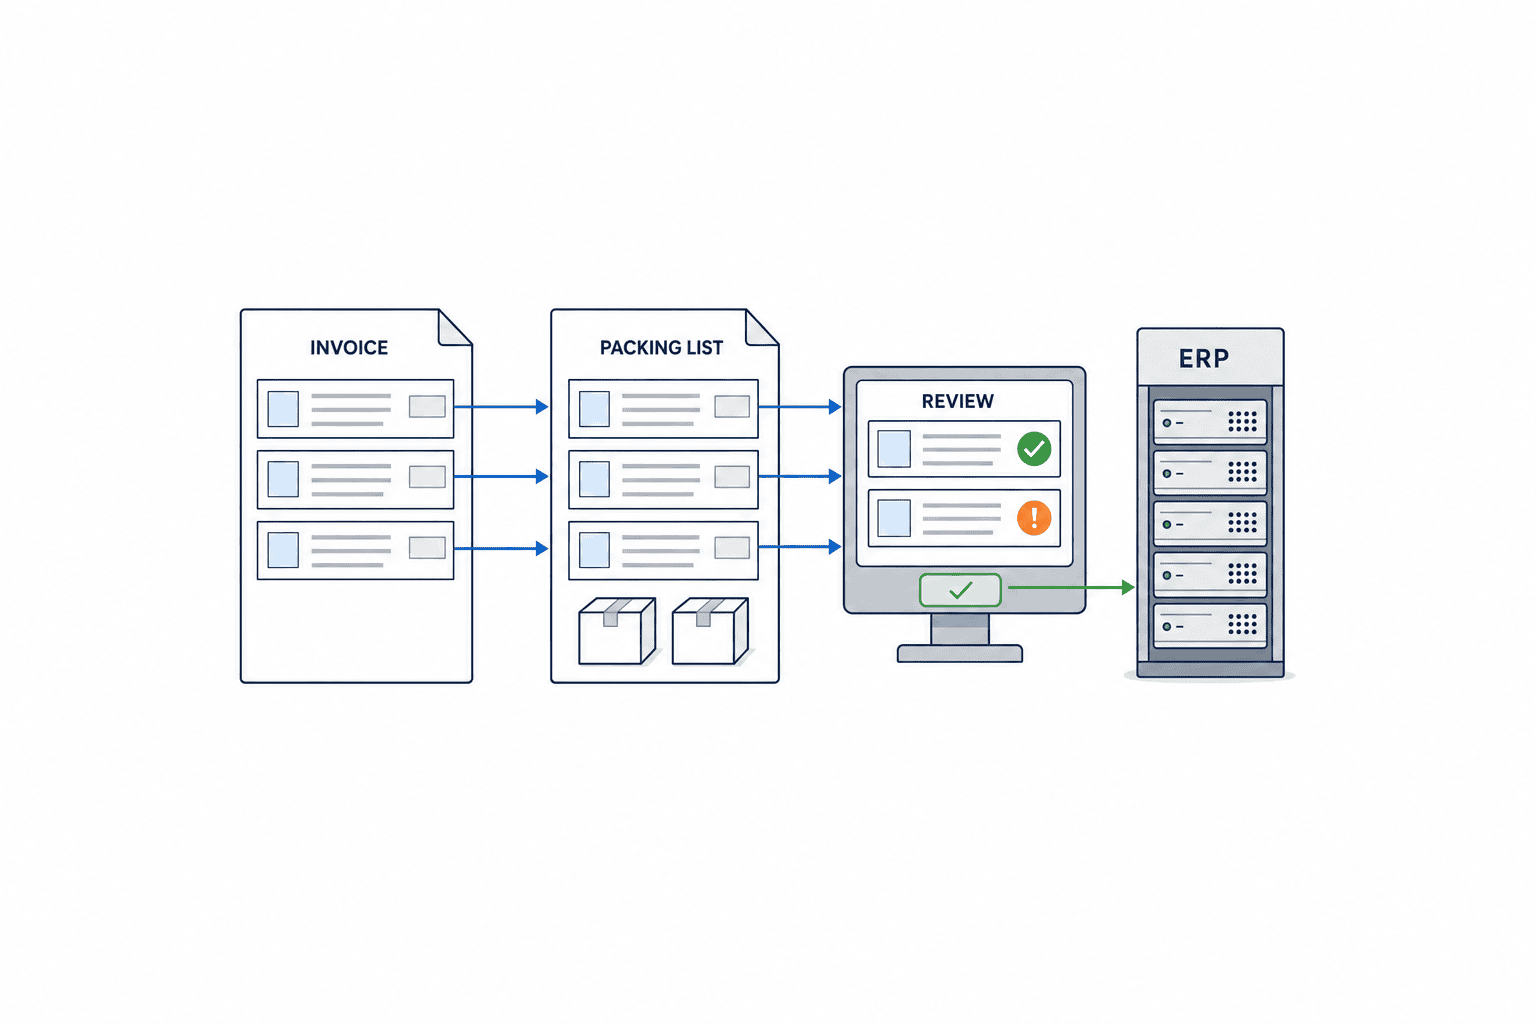
4. 書類間・ERPとの照合
最初に同じ出荷に属する書類か確認し、その後に行単位・箱単位の比較へ進みます。インボイス番号、注文番号、出荷番号などの共通キーが無い場合は、出荷日・相手先・品目を補助に候補を提示しますが、人の確認を必要にします。数量は単位換算と梱包階層の集計後に比較します。金額はインボイスの明細合計と総額、ERPの承認済み価格条件の照合を分けます。パッキングリストには通常金額が無いケースもあるので、存在しない項目を不一致扱いにしません。
照合結果は「一致」「許容差内」「要確認」「比較不能」のように分け、許容差を設ける項目と設けない項目を区別します。たとえば単価や通貨の不一致を重量の計測誤差と同じ扱いにしないことです。許容差の数値はこの記事で一律に推奨しません。商品、取引条件、測定器、顧客の要求に合わせ、顧客側の責任者が承認した値をRFPに書きます。
5. 例外確認と承認
例外画面には原本画像、抽出値、正規化後の値、比較先、差分、推奨される次の確認を並べます。「AIがそう判断した」だけでは担当者が修正できません。人が原本を確認して値を直した場合は、修正前後、理由、担当者、時刻を監査記録に残します。承認者と修正者を分けるかどうかは、取引の重要度と社内統制に合わせて決めます。
人が見なくてもよい条件は、最初から広げすぎない方がよいでしょう。MicrosoftのDocument Intelligenceは信頼度と人手レビューを組み合わせる考え方を示していますが、しきい値は自社書類の検証結果で決める必要があります。自動承認は「必要項目が揃い、同一出荷への紐付けが確実で、重要な照合に差が無く、文書版が承認済み」といった複数条件で定義します。例外は「低信頼度」だけでなく、値の矛盾、欠落、同じ文書番号の重複、版の衝突、品番未登録も対象です。Microsoft公式資料
6. ERP・出荷業務への連携
承認後に初めて確定データとしてERPや出荷管理システムへ渡します。いきなり本テーブルを上書きせず、ステージング領域に処理IDと出典文書IDを保存し、既存データとの競合を検出します。連携先が一時停止した場合は、再送で二重登録しない冪等キーを設けます。原本訂正で再実行する場合は、旧版の処理結果を消すのではなく、版の差分と置換関係を残します。
ERPから書類を生成している企業なら、同じ値を再度OCRで読み戻す目的を明確にします。取引先やフォワーダーが編集した版の確認、印刷後の改変検知、外部書類との突合などが目的なら意味があります。一方、ERPの値と自社生成PDFを比較するだけでは、同じ誤りを二重に確認する可能性があります。RFPには「現場で最後に変更される情報は何か」を書き、照合の起点を決めます。
AI-OCRで照合すべき不一致と、照合しない判断
導入効果を左右するのは、検出対象を増やすことだけではありません。検出できないこと、データ化しても判定すべきでないことを明確にする必要があります。
インボイスとパッキングリストの数量不一致では、まず品番と数量単位を確認します。インボイスの品目1行が複数箱に分かれる場合、箱明細を集計して比較します。販促品や無償品、予備品が片方にだけ載る運用なら、その扱いを別ルールにします。単純な総数量だけ一致しても品目内訳が違えば見逃すため、明細と合計の両方を照合します。
箱数・重量・寸法の不一致は、資料ごとに何を表しているかを確認します。正味重量と総重量、箱単位とパレット単位、見積重量と実測重量を混同すると誤警告が増えます。重量は計測時点が梱包前か後かで異なることもあります。仕様書には項目定義と比較単位を記載し、異なる概念同士は比較しません。
品番と品名の不一致では、品番の完全一致または承認済みの対応表を優先します。顧客品番と自社品番が併記される場合もあります。言語違いの品名は補助情報とし、似た表現だけで同一品目と確定しません。未登録品や新製品は承認フローへ送ります。
書類番号や日付の不一致は、無条件で誤りと決めつけません。パッキングリスト番号とインボイス番号が別体系の会社もあります。必要なのは「この出荷に対してどの版の書類が組になっているか」です。紐付けの根拠が弱ければ、比較不能として保留します。
価格、通貨、インコタームズなどの取引条件は、抽出と表示はできても、正しさの最終判断は承認済み契約や社内権限に従わせます。AI-OCRは条件の読み取りを助けますが、貿易実務や契約判断を代行しません。原産地や関税分類、税関への申告内容の判断も、本稿の自動承認範囲から外します。必要な場合は、担当部署・通関専門家が別の手順で確認します。原産地判定の業務要件はFTA原産地判定システムの解説で別に扱っています。
誤検知と見逃しを同時に管理する
現場の評価では、差異を検出できた件数だけを追うと、確認依頼が大量に出る仕組みを高く評価してしまいます。反対に例外件数を減らすだけなら、厳しい照合を止めれば数字は良くなります。重要な差異をどれだけ拾えたかと、正しい書類をどれだけ不要な確認へ回したかを並べて測る必要があります。誤検知は単なる不便ではありません。確認担当者が毎日同じ警告を見続けると、本当に重要な警告を見落とす要因になります。
テストデータには、正常書類と異常書類を両方入れます。異常書類は文字の読み違いだけでなく、原本そのものの数量違い、別版混入、明細の紐付け違い、箱数の変更、ERPにない品番を含めます。「異常を検出した」と判定する条件も、単に警告が出たことではなく、正しい行・項目を示して担当者が修正に進めることまで定義します。改善後は同じテスト群を再実行し、以前に解決した異常が戻っていないか確認します。
書類テンプレートを整える選択肢
取引先と調整できる場合は、AIの複雑化よりも書類そのものの改善が先かもしれません。文書番号と版を明確にする、箱明細へ品番を必ず入れる、数量単位を一定にする、スキャンではなくテキストを含むPDFを受け取る、といった変更は、読取と照合の両方に効きます。ただし、取引先に統一様式を強制できないケースも多いため、RFPでは「変更できる様式」と「変更できない様式」を分けて提示します。可変様式に対応するためのモデル・ルール・人手確認の費用を見積もりやすくなります。
輸出書類 AI-OCR 導入のRFPに書くべき要件
RFPは「AI-OCRで自動化したい」だけでは比較できません。ベンダーが同じ条件で見積もり、PoCを設計できるよう、書類と現場の条件を具体的に渡します。以下は書き出し用の項目例です。
| RFP項目 | 記載する内容 | 確認したい成果物 |
|---|---|---|
| 対象文書 | インボイスとパッキングリストの様式数、言語、PDF・画像比率、ページ数の分布 | 対象・除外の一覧 |
| 必須項目 | ヘッダー・明細・箱明細の辞書、原本上の場所、出力形式 | 項目マッピング表 |
| 照合 | ERP、書類間、明細内のルールと例外 | ルール表・差分画面 |
| 承認 | 担当者、承認者、修正・差し戻し、監査記録 | 権限設計・操作画面 |
| 連携 | ERP/API/CSV、処理ID、再送、版変更、エラー復旧 | インターフェース仕様 |
| 評価 | サンプルの構成、項目別指標、例外率、処理時間 | PoC結果・FAT/SAT計画 |
| 運用 | テンプレート変更、モデル更新、保管、アクセス権 | 運用手順・保守条件 |
文書サンプルは、きれいな代表例だけでは不十分です。取引先・工場・商品群・言語・発行元の違い、ページ跨ぎ、複数箱、値引き、訂正、スキャン品質の悪い例を含めます。サンプルの正解データは業務担当者が原本と照らして作成し、「OCRの正解」と「照合ルール上の正解」を分けて管理します。ベンダーが調整に使った資料と、最終評価に使う資料も分けます。これは特定の精度値を約束するためでなく、本番に近い性能を見積もるためです。
評価指標は文書単位の「読めた・読めない」だけにしません。インボイス番号、通貨、品番、数量、金額などを項目別に測り、明細行の欠落と誤結合を別々に数えます。書類の結び付け成功率、照合すべき不一致の検出、誤警告、例外確認時間、ERP反映の失敗も測ります。GoogleのDocument AI資料は、信頼度しきい値とprecision・recallを分けて評価することを説明しています。Google公式資料
費用比較では、ライセンス単価だけでなく、サンプル収集、辞書・ルール作成、ERP連携、承認画面、再学習、テンプレート変更時の保守、例外処理の人件費を含めます。ページ課金や処理量課金なら、ピーク時の書類数とページ数、再処理回数も見積もります。見積条件が各社で異なれば、初期費・月額・運用工数の内訳を同じ表に並べます。数字は自社データとベンダー見積で決め、一般的な削減率をそのまま事業計画へ入れないことが重要です。
導入順序もRFPで明らかにします。初期段階では、既に様式が安定した取引先と、品番・数量が確実に結び付く品目群から始める方法があります。次段階で様式の異なる取引先や複雑な梱包を追加し、最後に自動承認の対象を広げます。各段階の終了条件は「何件を処理したか」ではなく、重要項目の読取、書類間の紐付け、誤警告、確認時間、連携失敗の実測結果で決めます。段階的な運用なら、すべての例外を初日にモデルで解決しようとして費用を膨らませるのを防げます。
責任分担には、モデル提供者、システム構築者、貿易実務担当者、ERP管理者、情報管理者を含めます。OCRモデルが出した値の妥当性を誰が確認するか、ルールを誰が変更できるか、取引先テンプレートの変更を誰が通知するか、障害時の手作業へどう戻るかを表にします。AIモデルの更新で結果が変わる場合、試験用の固定書類を使って変更前後を比較し、承認してから本番に反映します。モデルのバージョン記録とロールバック手順も見積対象に含めます。
現場へ移す前に決める運用ルール
小規模な実証で読取が成功しても、日々の担当者が迷わず処理できるとは限りません。導入前に、例外の優先順位と処理期限を決めておきます。たとえば、出荷締切が近い書類、数量が一致しない書類、原本が欠けている書類を、単にOCRスコアの低い書類より先に確認する可能性があります。優先順位は社内の締切と業務影響に合わせて定義し、画面上で理由が見えるようにします。担当者が休暇中のときの引き継ぎ先も指定します。例外が未処理のまま時間を過ぎた場合、書類を自動承認するのではなく、責任者へ通知して人の判断を求めます。
処理できないファイルにも状態を与えます。「受領済み」「分類不能」「抽出失敗」「照合待ち」「確認待ち」「承認済み」「連携失敗」「完了」といった状態を定義し、それぞれの次の操作を決めます。分類不能の書類を再分類したとき、古い抽出結果をどう扱うかも記載します。照合待ちの原因がパッキングリスト未着なら、OCRモデルの再実行では解決しません。原因別の操作を提示することで無駄な再処理を減らせます。
日次運用では、全体件数だけでなく、入口別の受領数、分類不能数、抽出失敗数、照合差異数、担当者の確認待ち数、ERP連携失敗数を見ます。ある取引先の様式変更後に抽出失敗が増えたのか、ERPマスタの更新遅れで品番未登録が増えたのかを区別できるからです。各指標には処理IDから原本へ戻る導線を付けます。数値だけのダッシュボードは、担当者が具体的な改善を始めるには不十分です。
改善会議では「AIモデルを再学習するか」だけを議題にしません。警告の原因を、原本品質、取引先様式、品目マスタ、単位換算、照合ルール、承認権限、連携先の不調に分類します。原因が様式変更なら新しいサンプルを集め、原因がマスタなら品番対応表を直します。原因と対策を結び付ければ、モデル更新を繰り返しても同じ例外が残る事態を避けられます。変更前後の試験票を残し、改善によって別の取引先の書類が読めなくなっていないか確認します。
最後に、手作業へ戻る手順も決めます。ネットワーク障害やOCRサービス停止時、原本を誰が読み、どの表へ記録し、復旧後にどう取り込むかを決めておけば、出荷業務を止めずに済みます。復旧後は手入力済みデータと自動処理結果を同じ出荷IDで照合し、二重登録を防ぎます。手作業に戻した案件も監査記録から除外せず、処理理由と承認者を残します。この設計はAI-OCR固有の機能ではなく、業務システムとして必要な継続性です。
FATとSATで「読める」から「運用できる」へ進める
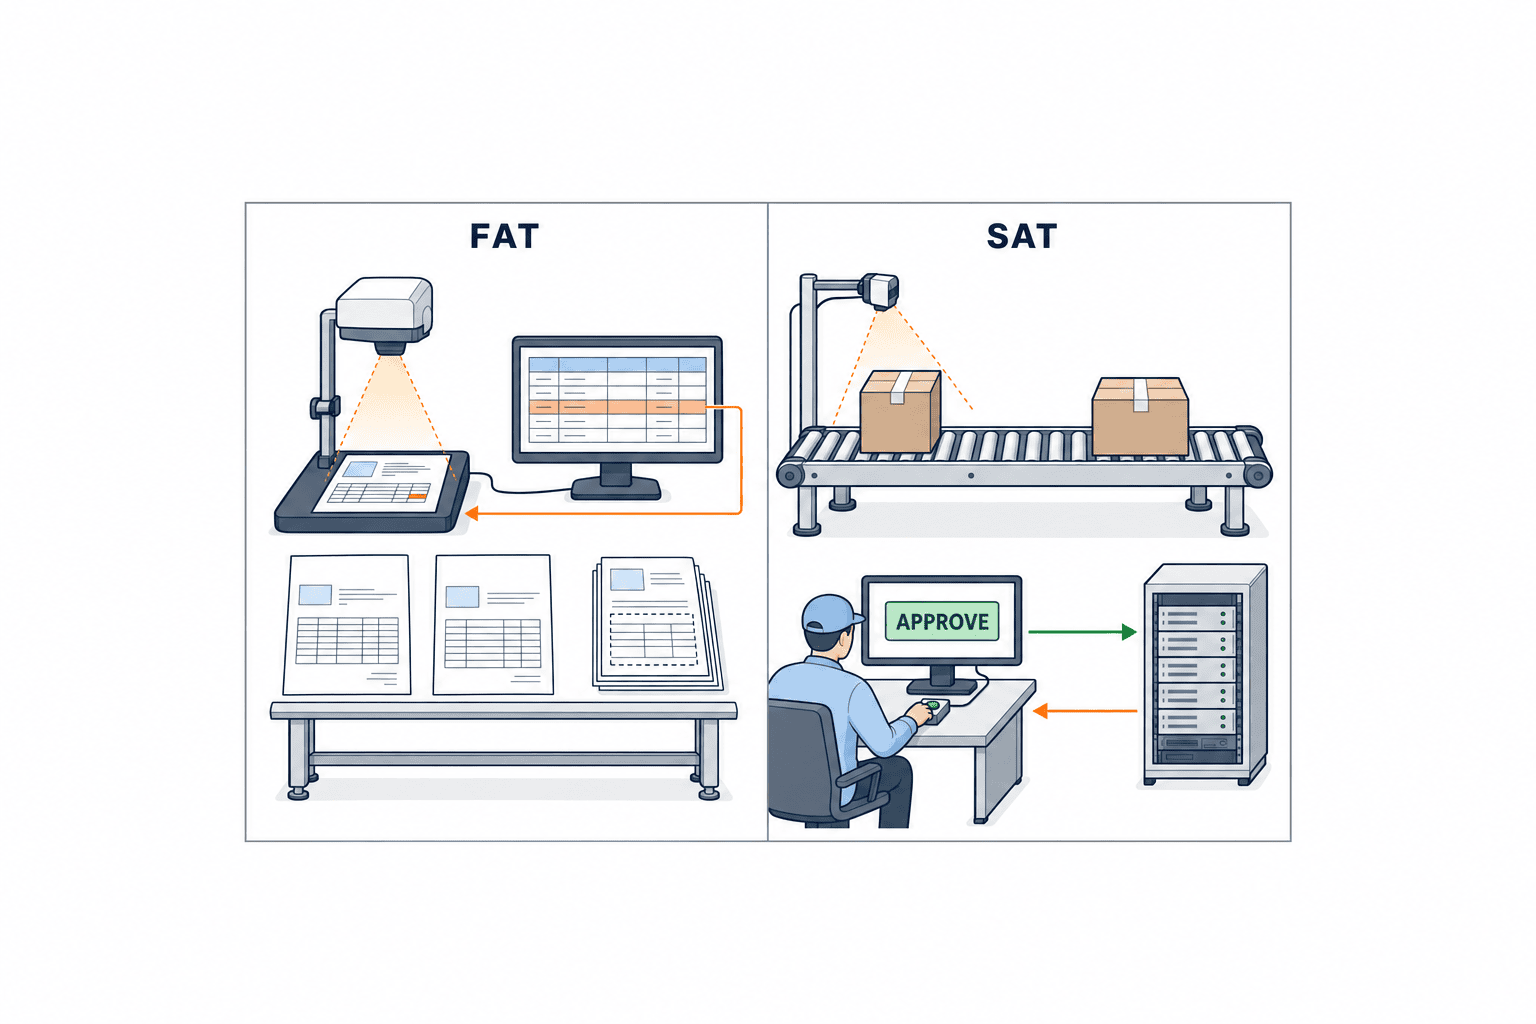
FAT(工場受入試験)はベンダー環境などで仕様を検証し、SAT(現地受入試験)は実際の連携先と運用条件で検証します。両者の定義と契約上の扱いは案件ごとに合意します。OCRのデモ結果だけを受入基準にせず、照合から承認・連携・障害復旧まで試験票に含めます。
FATでは、正しいインボイスとパッキングリストの組、数量違い、品番違い、箱明細の分割、同名品、別出荷の混入、改訂版の再投入、スキャン不良、未登録品、必要ページの欠落を試します。各ケースについて期待する出力を「自動承認」「要確認」「処理不可」などで事前に定めます。項目別の読取結果と照合結果に加え、担当者が原本の根拠箇所へ戻れることも確認します。
SATでは、実際のメール・フォルダ受領、現場のファイル名、ERPマスタ、権限、ネットワーク、日常の締め時間に沿って試します。連携先が停止したときに再送できるか、同じ書類を再投入しても二重登録しないか、担当者が修正した値と原本の差が記録されるか、承認前のデータが確定扱いにならないかを確認します。例外の担当者不在、差し戻し、夜間の処理も運用設計に入れます。
受入基準は、単一の「OCR精度99%」のような言い方だけでは曖昧です。対象サンプル、項目、計算方法、除外条件、許容差、誤警告、処理時間、人手確認時間を記載します。たとえば「品番は文字完全一致か」「明細行の対応は何を正解とするか」を決めてから数値を置きます。重要な不一致の見逃しは、平均精度と分けて扱います。試験結果の差をベンダーと同じ根拠で確認できることが、導入後の改善にも役立ちます。
よくある質問
インボイスとパッキングリストは同じOCRモデルで読めますか?
文書分類と項目辞書を分けて評価するのが出発点です。ヘッダーや表の形、必要な明細階層が違うため、同じ基盤を使えても同じ抽出設定で十分とは限りません。製品によってはインボイス向けの事前学習モデルがあり、パッキングリストにはカスタム抽出が必要な場合があります。自社サンプルで両方を評価してください。
輸出書類のOCR結果はそのままERPへ登録できますか?
技術的にAPI連携できても、業務上は照合と承認の条件を先に決めます。品番未登録、数量単位の不一致、旧版の再投入などを通したまま確定データにしないためです。最初はステージングに保存し、人が差分を確認してから確定する流れが設計しやすいでしょう。
船積書類の照合をどこまで自動化できますか?
本稿はインボイスとパッキングリストを中心に扱います。船荷証券などを追加するなら、書類の発行時点や記載目的が違うことを踏まえ、照合キーと担当部門を別途定義します。数字が一致しない理由をAIが推測して承認する運用は避け、差分と根拠を人へ提示します。
輸出書類 OCR のRFPで最初に提示する資料は何ですか?
対象文書の一覧、各様式の匿名化サンプル、項目辞書、例外の実例、照合先ERPの項目、承認フロー、月間・ピーク時の件数です。サンプルには良い例と難しい例を混ぜ、評価に使う保留資料を別にします。ベンダーはこの情報から処理方式と費用の前提を揃えられます。
AI-OCRだけで税関申告や原産地判定を完結できますか?
本稿の範囲では完結させません。AI-OCRは書類にある情報の入力と照合を助ける道具です。申告や原産地の判断は別の業務手順と専門的確認が必要なため、システムの対象に含める場合でも責任範囲と承認者を個別に設計します。
まとめ:原本、照合ルール、承認の三点を先に固定する
輸出書類のAI-OCR導入は、インボイスとパッキングリストを読めることから始まります。しかし成果を決めるのは、同じ出荷のどの版を比較するか、品目・数量・箱明細をどう結び付けるか、不一致を誰が承認するかです。原本への追跡、項目辞書、例外画面、ERPへの安全な連携をRFPに入れ、FATとSATで実サンプルと現場条件を検証すれば、導入後の手戻りを減らせます。
TOMAS TECHでは、タイの製造現場で使う書類と既存システムを確認し、対象項目・照合ルール・承認フローを小さく定義する段階からご相談いただけます。要件整理中であれば、お問い合わせから現状の文書種類と困っている照合作業をお知らせください。


