


翻訳 自動化を企業で進めるとき、成否を分けるのはモデルの点数ではありません。原文、用語、機密区分、人の確認、受入テストを一つの業務として設計できるかです。本稿では、タイ・ASEANに複数拠点を持つ日系製造業が、RFPから約30日のPoC、運用移管までを安全に進める実務手順を解説します。
翻訳 自動化を企業で成功させる5つの設計軸
結論から言えば、翻訳自動化は次の5つを一体で設計します。
- 原文整備:短く曖昧さの少ない文章、識別可能な版、再利用可能な文書構造にする
- 用語集・翻訳メモリ:製品名、工程名、安全用語、承認済み対訳を資産として管理する
- 機密区分・送信経路:文書ごとに、どのサービスへ、どのリージョン・契約・保持条件で送れるかを決める
- リスク別の人レビュー:安全、品質、契約、顧客向けなど、誤訳時の影響に応じて確認者と承認権限を変える
- 受入テスト・継続評価:平均的な訳の良さだけでなく、必須用語、数値、否定、単位、版、レイアウトを機械・人の両方で検証する
「どのAIが一番自然か」だけを比較すると、デモでは良く見えても量産運用で崩れます。企業の翻訳は、同じ文章を一度きれいに訳す仕事ではありません。改訂、差分、承認、監査、再利用、撤回を繰り返す業務です。モデルはその工程の一部であり、業務全体の責任主体ではありません。
なぜモデル精度比較だけでは多言語文書翻訳が止まるのか
製造業の文書には、一般文とは異なる難しさがあります。たとえば「ライン」は生産ライン、配管、電線、品種系列のいずれも意味し得ます。「かん合」「逃げ」「当たり」「段取り」のような現場語は、文脈や工場で意味が変わります。タイ語では主語を省く表現が自然でも、作業標準では「誰が確認するか」を明記しなければ責任が曖昧になります。日本語の長い修飾節は、英語・タイ語・ベトナム語へ変換すると、どの条件がどの動作に掛かるのか崩れやすくなります。
さらに、文書には文章以外の制約があります。部品番号は翻訳しない、単位は変換しない、図番号は原文と一致させる、警告レベルの表記を保つ、変更履歴を残す、古い版を配布しない、といった条件です。流暢さの点数が高くても、部品番号の一文字や「してはならない」の否定が落ちれば不合格です。
したがって、PoCの評価対象を「訳文」だけにしてはいけません。入力ファイルの抽出、前処理、翻訳、用語適用、後処理、レビュー、承認、再出力、配布、ログまでの一連を評価します。
方式選定は文書リスク×量×更新頻度で行う
翻訳方式は、単一のサービスに統一する必要はありません。文書の用途に応じてレーンを分ける方が現実的です。
| 文書クラス | 例 | 自動化方針 | 人レビュー |
|---|---|---|---|
| A:安全・法務・契約 | 安全手順、化学物質、顧客契約、保証条件 | AIは下訳・用語検査まで | 必須。責任部門が最終承認 |
| B:品質・工程 | 検査標準、異常処置、管理計画、FMEA関連 | 用語集付き自動翻訳+差分レビュー | 原則必須。変更箇所を重点確認 |
| C:社内運用 | 日報、教育補助、改善提案、社内FAQ | リスク条件内で自動化を拡大 | サンプリングまたは例外レビュー |
| D:探索・参照 | 技術調査、受信メールの理解補助 | 自動翻訳を標準にしやすい | 利用者が原文参照可能にする |
この分類は会社共通のたたき台です。実際には、顧客要求、個人データ、輸出管理、知的財産、労務、医療・食品などの規制を加味します。同じ「マニュアル」でも、教育用の説明とロックアウト・タグアウト手順ではリスクが違います。
完全無人化しない文書を最初に宣言する
製造現場の安全、品質判定、契約上の義務、規制当局や顧客へ提出する文書は、AIだけで公開しません。人レビューを残すことは自動化の失敗ではなく、リスクに比例した制御です。自動化すべきなのは、全文の再入力、既訳の探索、用語チェック、数字照合、変更箇所の抽出、レビュー割当、証跡作成です。専門家は、意味と責任の判断へ時間を使います。
原文整備がAI 翻訳 ビジネスの品質上限を決める
翻訳前に、原文を「翻訳可能な情報」に整えます。日本語の原文が曖昧なら、高性能モデルでも曖昧さを別言語へ移すだけです。
一文一動作と条件の明示
「異常がないことを確認して運転を開始し、問題があればリーダーに報告する」は、確認者、異常の定義、報告前に運転を停止するかが曖昧です。次のように分けます。
- オペレーターは、ガードが閉じていることを確認する。
- オペレーターは、非常停止が解除されていることを確認する。
- いずれかを満たさない場合、設備を起動してはならない。
- オペレーターは、シフトリーダーへ異常コードを報告する。
この形なら、否定、主体、順番、条件が機械でも人でも検査しやすくなります。
非翻訳要素を識別する
部品番号、製品名、設備タグ、画面ボタン、PLCアドレス、規格番号、変数、コード、URLは、翻訳対象から分離します。「KEEP」「LOCKED TERM」「TRANSLATE」のような属性を文書部品へ持たせると、後工程で誤変換を検出できます。Word、Excel、HTML、XML、CAD出力など形式ごとの抽出規則も決めます。
文書IDと版を入力時点で固定する
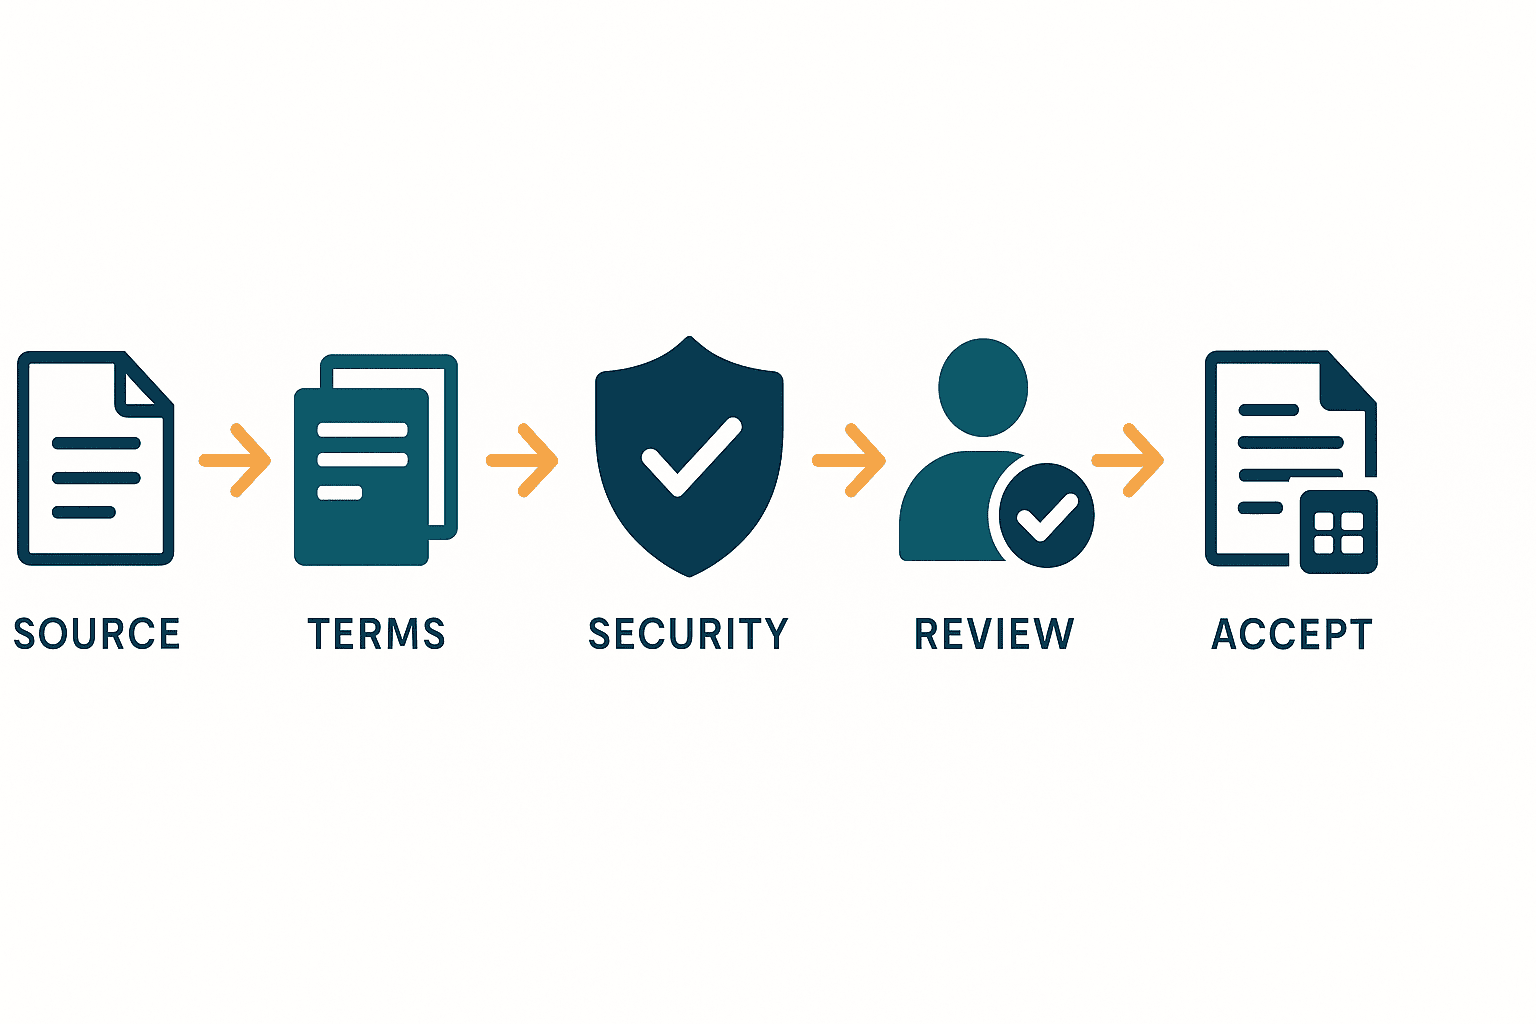
最低限、文書ID、版、原文言語、対象言語、所有部門、承認者、機密区分、発効日をジョブに付与します。ファイル名だけに依存すると、改訂版と旧版が混ざります。翻訳結果から原文の版へ逆引きできることが監査の前提です。
用語集と翻訳メモリを混同しない
用語集は「語・短い句の対訳と使用規則」、翻訳メモリは「承認済みの文・セグメントの対」を扱います。役割が違うため、両方が必要です。
企業用語集に必要な列
| 項目 | 内容 |
|---|---|
| term_id | 変更されない識別子 |
| source_term | 原語。表記・大文字小文字も定義 |
| target_term | 言語別の承認訳 |
| definition | 工程・製品上の意味 |
| do_not_use | 禁止訳、旧称、紛らわしい表現 |
| example | 承認済みの使用例 |
| scope | 全社、事業、工場、顧客、製品など |
| owner | 内容責任者 |
| status | draft、approved、deprecated |
| effective_from | 適用開始日 |
Microsoft Azure TranslatorのDocument Translation資料では、用語集は現在、原文言語と訳文言語の1対1に対応し、文脈固有語、非翻訳語、曖昧語の指定に使えると説明されています。推奨形式はTSVで、既定では大文字小文字が一致条件へ影響します。Google Cloud Translationは一方向用語集に加えて複数言語のequivalent term setsを扱えますが、用語集リソース自体に版管理はないため、元ファイルを保持してロールバックできるようにすることを推奨しています。AWSもcustom terminologyを提供しますが、文脈によっては指定した訳語を毎回使うことを保証しないと明記しています。
つまり「用語集機能あり」は同じ意味ではありません。ファイル形式、方向、大小文字、形態変化、複合語、適用保証、版管理、リージョン、権限を候補ごとにテストします。
翻訳メモリは承認済みだけを昇格させる
AI出力を自動で翻訳メモリへ登録すると、誤訳が再利用されます。登録条件を「担当者承認済み」「原文版が確定」「言語と工場スコープが付与」「撤回可能」にします。完全一致と類似一致を区別し、類似一致は差分を強調します。古い設備名や廃止手順をdeprecatedにし、使用時に警告を出します。
日本語・タイ語・ベトナム語は形の揺れをテストする
日本語はスペースで単語境界が示されず、タイ語も通常は単語間に空白を置きません。用語集が「原文文字列の完全一致」だけなら、助詞、接頭辞、複合語、改行で適用が外れることがあります。ベトナム語は複数音節が空白で区切られる語もあり、単語単位の扱いを誤ると部分一致になります。短い語だけでなく、実文の中で用語適用率と誤適用を測ります。
タイ語 日本語 翻訳 AIで先に決める言語ルール
タイ工場では、日本語原文をタイ語へ訳すだけでなく、タイ語の現場報告を日本語へ戻す双方向運用が発生します。往路と復路で同じ設計を流用せず、それぞれの目的を決めます。
主語と責任者を補う
タイ語は文脈上明らかな主語を省略できますが、作業標準では役割名を残します。「ตรวจสอบแล้ว(確認済み)」だけでなく、Operator、Line Leader、QAなど誰が実施・承認するかを構造化します。日本語原文でも「確認する」だけでなく主体を明記します。
丁寧さより作業上の一義性を優先する
社内連絡の自然さと、安全手順の明確さは別の評価軸です。命令、禁止、許可、推奨を翻訳スタイルガイドで分けます。警告語は承認済み対訳を固定し、色やアイコンだけに意味を持たせません。
短文は原文言語を明示する
DeepLの公式資料は、可能なら原文言語を指定することを推奨し、単語や非常に短い文は自動言語検出が誤る可能性が高いと説明しています。設備アラーム、ボタン、品名のような短い文字列は、ジョブに原文言語を必須で付けます。長い文書も、誤ったファイル混入を検出したうえで、既知なら言語指定を優先します。
セキュリティは「AIに送るか」ではなく送信経路で設計する
セキュリティ評価では、製品名だけで安全・危険を決めません。入力から削除までの経路を図にします。
- 利用者端末・共有フォルダからジョブを受ける
- DLPまたはルールで文書を分類する
- 必要なら氏名、顧客名、図番などをマスキングする
- 承認済みのAPI・リージョン・ネットワーク経路へ送る
- 結果を暗号化領域へ保存し、権限を限定する
- 人レビューと承認を記録する
- 原文、訳文、ログ、キャッシュを保持期限に従って削除する
APIと一般向け画面を同一視しない
契約、データ利用、保持、管理機能は提供形態で異なります。OpenAIのAPIデータ管理資料では、APIへ送信したデータは、明示的にオプトインしない限りモデルの学習・改善に使われないとされています。一方、既定の不正利用監視ログは、法律上または安全上より長い保持が必要な場合を除き、最大30日保持され得ます。さらに、エンドポイントごとにapplication stateやZero Data Retentionの適格性が異なります。したがって「学習に使われない」ことと「保存されない」ことを混同せず、実際に使うエンドポイント、store設定、ファイル、キャッシュ、外部MCP等を個別に確認します。
この30日はすべてのAI翻訳サービスに共通する数字ではなく、公開資料を確認した時点のOpenAI APIの既定条件です。契約・設定・機能・法的要件で変わり得るため、RFP回答と契約書で再確認します。
詳しい設計は、タイ製造業の生成AIデータ漏洩対策も参照してください。
機密区分と許可レーンを対応させる
| 区分 | 例 | 許可レーンの例 |
|---|---|---|
| Public | 公開カタログ、公開Web | 承認済みクラウド翻訳 |
| Internal | 一般社内手順、教育資料 | 企業契約API、アクセス制御、ログ |
| Confidential | 顧客図面、原価、未公開製品 | マスキング、限定環境、個別承認 |
| Restricted | 輸出管理、重大個人情報、秘匿契約 | 原則送信禁止または専用環境・法務承認 |
区分名は自社規程に合わせます。重要なのは、利用者に規約を読ませるだけでなく、システムが禁止レーンを止めることです。例外は申請者、理由、期限、承認者を記録します。
人レビューは文書リスクとエラー種別で設計する
すべてを全文二重チェックすると費用が下がらず、すべてを無人にすると事故リスクが上がります。レビューを層に分けます。
レベル1:機械検査
必須用語、禁止語、数字、単位、日付、部品番号、タグ、URL、否定、警告語、未翻訳箇所、余分な翻訳、表の行列、図参照を検査します。完全一致だけでなく、全角半角、桁区切り、小数点、タイ数字など表記差も扱います。
レベル2:言語レビュー
意味の正確さ、文法、読みやすさ、対象地域の語彙を確認します。単に「自然か」ではなく、原文の義務、条件、禁止、可能性が維持されているかを見ます。タイ語・ベトナム語の母語話者が、現場で誤解なく実行できるか確認します。
レベル3:専門・責任部門レビュー
安全担当、QA、法務、設計、顧客担当などが、業務上の正しさと公開可否を承認します。言語担当者に技術責任を負わせず、技術担当者に言語品質を単独で負わせません。誰が何を承認したかを分けて記録します。
例外キューを先に作る
低信頼、用語衝突、OCR不良、文書版不明、表崩れ、手書き、混在言語、機密判定不能を自動で例外へ送ります。「自動翻訳成功」の定義に、APIが200を返したことだけを使わないでください。
受入テストは流暢さより重大エラーを先に見る
PoCでは、実際の文書をリスク別に抽出し、ゴールドデータを作ります。公開して差し支えない簡単な例だけを選ぶと、量産時の障害を発見できません。
テストセットを固定する
- 文書種別:Word、Excel、PDF、HTML、メール、OCR文書
- 言語方向:JA→TH、TH→JA、JA→EN、JA→VIなど
- 難易度:短文、長文、表、箇条書き、混在言語、略語、誤字を含む原文
- リスク:安全、品質、契約、社内運用、参照
- 変更:新規、軽微改訂、大幅改訂、旧版撤回
テストセットには文書IDと版を持たせ、PoC途中で都合の良い例へ差し替えません。調整に使う開発セットと、最終判定に使うホールドアウトセットを分けます。
合否判定をエラー重みで定義する
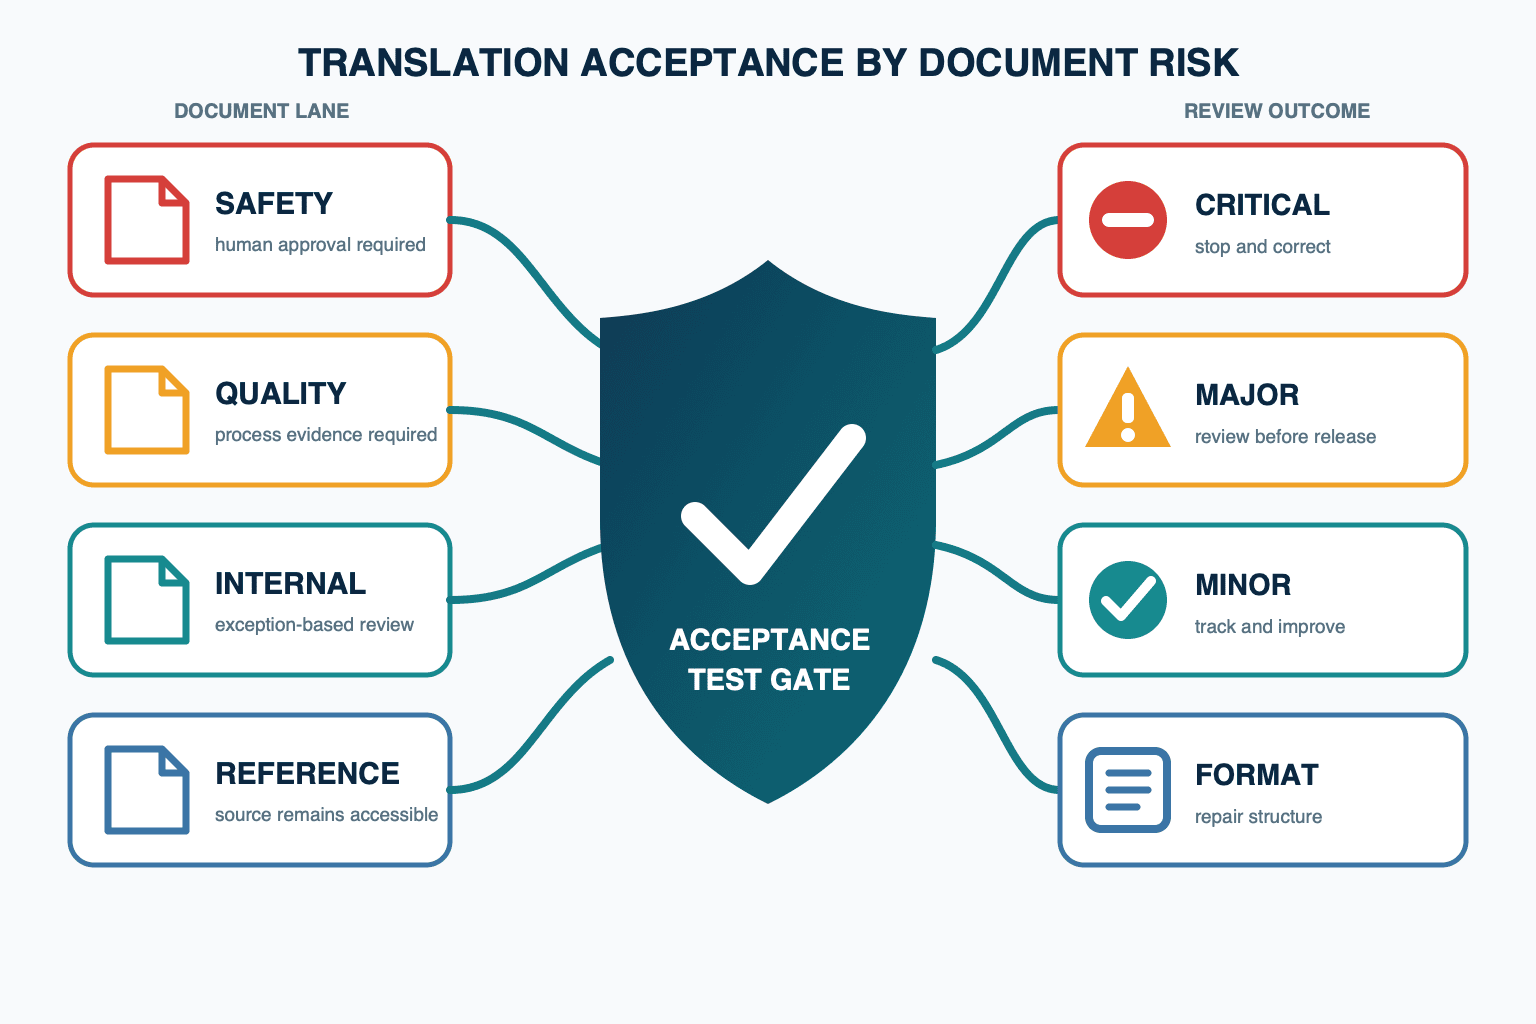
「平均4.2点以上」のような総合点だけでは、重大な否定落ちが平均に埋もれます。少なくとも次を別々に数えます。
- Critical:禁止・許可の反転、危険な数値・単位、誤った法的義務、別部品の指示
- Major:工程を誤る用語、条件・主体・順番の欠落、品質判定への影響
- Minor:意味を変えない文体、句読点、軽微な不自然さ
- Format:表、図、番号、リンク、レイアウトの破損
安全・品質・契約クラスでは、Criticalが1件でもあればその文書は不合格とするなど、文書クラス別にゲートを設定します。閾値は自社のリスクアセスメントで決め、ベンダーの一般指標をそのまま採用しません。
再現性と差分も試す
同じ入力、同じモデル・設定、同じ用語集で再実行した際の差を記録します。モデル更新時は回帰テストを実行します。全文を毎回レビューするのではなく、原文差分、訳文差分、用語集差分、モデル・プロンプト差分を紐づけます。
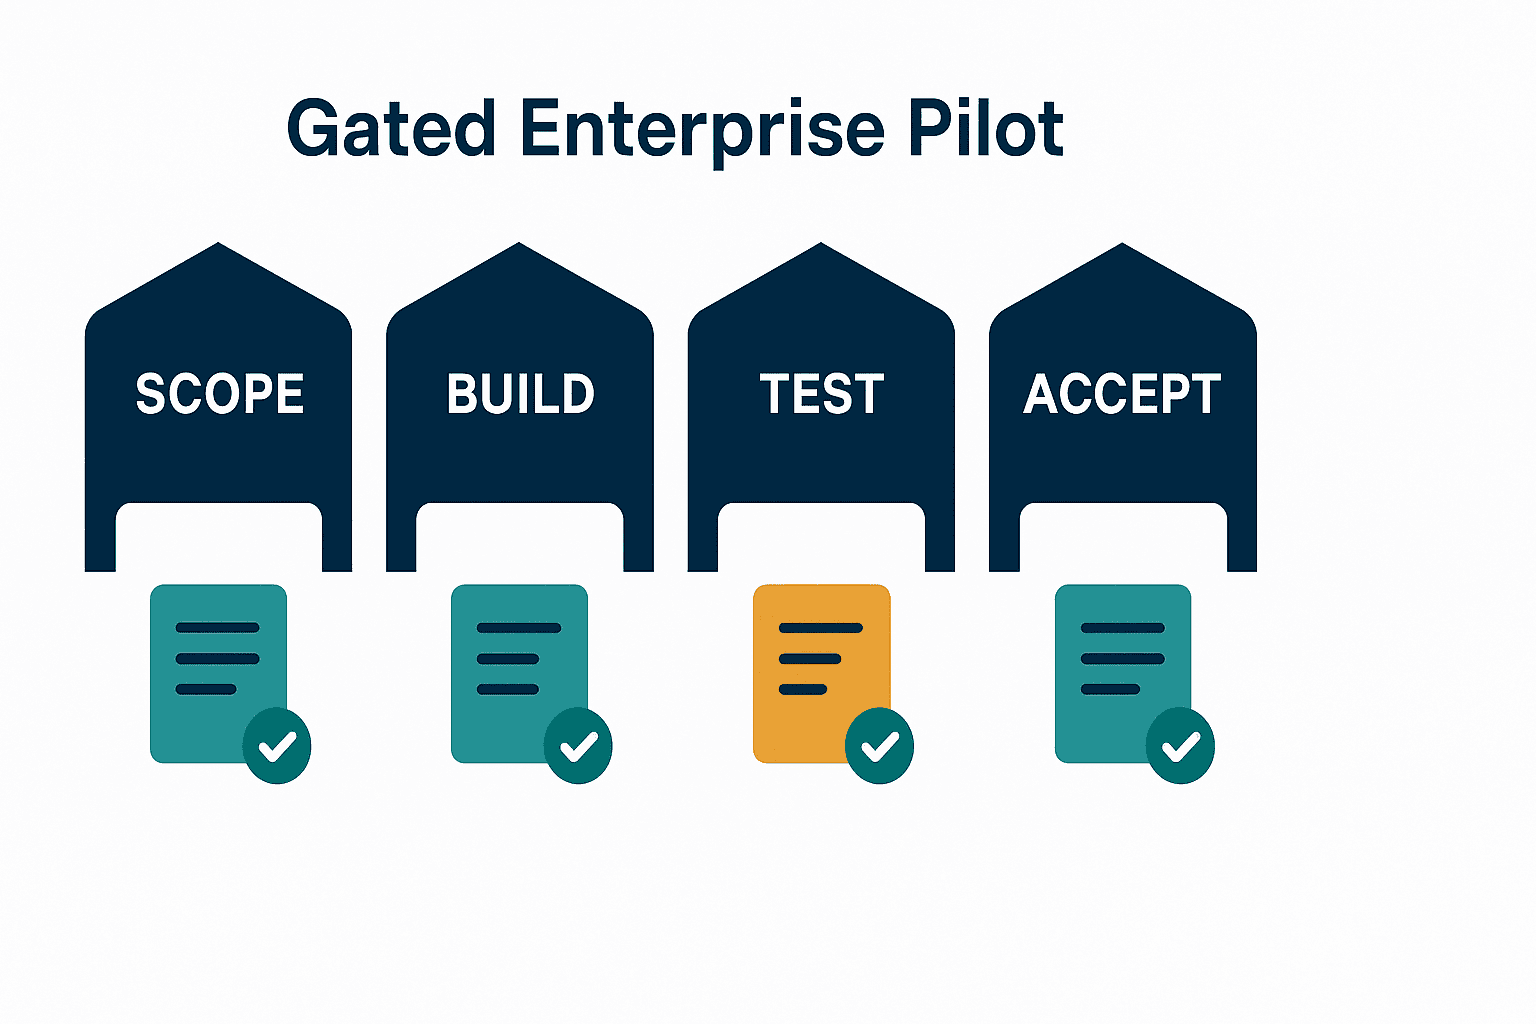
約30日のPoC設計案
30日は公式統計や成功保証ではなく、意思決定に必要な証拠を短期間で集めるための一例です。文書量、権限審査、法務確認に応じて調整します。
1週目:範囲・リスク・ゴールドデータ
- 対象業務と対象外を決める
- 文書クラス、機密区分、言語方向、形式を棚卸しする
- 既存用語集・翻訳メモリ・スタイルガイドを収集する
- テストセットと合否基準を承認する
- 情報セキュリティ、法務、IT/OT、品質、現場の責任者を決める
2週目:最小パイプラインと用語統制
- 文書ID、版、言語、区分を付けて投入する
- 非翻訳要素と個人・顧客情報を検出する
- 候補サービスへ用語集を適用する
- 結果、設定、モデル、用語集版、処理時間、エラーをログに残す
- 例外キューとレビュー画面をつなぐ
3週目:実文書評価と異常試験
- 通常文書と難しい文書を同じ比率で流す
- 用語集不一致、言語誤検出、OCR欠落、API失敗、タイムアウトを注入する
- 人レビュー時間と修正種別を記録する
- 重大エラーを原因別に分類し、原文・用語・設定・モデル・後処理のどこで防ぐか決める
DeepLのproduction checklistは、429または500エラー時に指数バックオフで再試行すること、認証キーをクエリパラメータへ入れないこと、広い文脈を与えること、翻訳結果をキャッシュして重複処理を避けることなどを推奨しています。これは特定サービスの実装指針ですが、企業パイプラインでも、リトライ、秘密管理、コンテキスト、冪等性をテスト項目にする合理性を示します。
4週目:ホールドアウト受入と運用判断
- 未使用のホールドアウトセットで最終評価する
- 文書クラス別の合否と残余リスクを承認する
- 本番へ進めるレーン、追加対策が必要なレーン、禁止レーンを決める
- 運用手順、監視、障害対応、ロールバック、教育を引き渡す
- 次回の回帰テスト日と責任者を設定する
RFPで確認すべき項目
| 領域 | 質問 | 必要な証拠 |
|---|---|---|
| 言語・形式 | JA/TH/EN/VI、混在言語、Word/Excel/PDF/OCRをどう扱うか | 対象形式での実ファイル結果 |
| 用語 | 用語集の方向、形式、大小文字、形態変化、版管理はどうなるか | 実文中の適用・誤適用テスト |
| メモリ | 承認済み訳の再利用、類似一致、撤回、スコープは可能か | 変更履歴とロールバック実演 |
| データ | 学習利用、ログ、application state、保持、削除、サブプロセッサは | 契約条項、設定画面、データフロー |
| 権限 | SSO、MFA、RBAC、サービスアカウント、鍵の保管は | 権限表、監査ログ、鍵更新手順 |
| 可用性 | 429/5xx、タイムアウト、重複送信、順序逆転への対応は | 障害注入と復旧ログ |
| 品質 | 重大エラー、数値、否定、用語、未翻訳をどう測るか | 合意テストセットでの結果 |
| 変更 | モデル更新、API変更、用語集変更をどう通知・検証するか | 変更通知と回帰テスト手順 |
| 人レビュー | 割当、差分、コメント、承認、差戻し、証跡は | 一連のワークフロー実演 |
| 移行 | データエクスポート、契約終了、ベンダー変更は可能か | 標準形式の出力と削除証明 |
価格表だけで比較せず、自社テストセットを同じ条件で実行します。文字単価の差より、前処理、再翻訳、レビュー、例外処理、監査、用語保守を含む総作業を見ます。本稿では市場相場や架空の削減率は提示しません。自社の現状工数を測り、PoC後の同じ工程と比較してください。
本番アーキテクチャはベンダー交換可能性を残す
入力、用語、翻訳、検査、レビュー、承認、配布を疎結合にします。翻訳API固有のレスポンスをそのまま業務DBへ書かず、共通ジョブ形式に正規化します。
推奨するジョブ情報
- job_id、document_id、source_version
- source_language、target_language、locale
- document_class、confidentiality
- glossary_version、translation_memory_version、style_version
- provider、model、endpoint、request_setting
- source_hash、output_hash
- reviewer、approver、decision、timestamp
- error_code、retry_count、fallback_reason
これにより、サービスを変更しても承認履歴と文書系譜を維持できます。APIキーはクライアント端末やExcelマクロへ埋め込まず、サーバー側の秘密管理から呼びます。送信前後のログに本文を残す必要があるかを分け、監視用メタデータだけで足りるなら本文ログを減らします。
キャッシュは便利だが版と機密を持たせる
同じ文を再利用すれば費用と時間を抑えられますが、古い訳、別顧客の訳、異なる機密区分を誤用してはいけません。キャッシュキーに原文ハッシュだけでなく、言語、用語集版、スタイル版、モデル設定、スコープを含めます。撤回された用語や文書版に連動して無効化します。
運用KPIは品質・時間・例外・再利用で測る
件数だけをKPIにすると、難しい文書を現場が避けたり、誤訳を放置したりします。次の指標を組み合わせます。
- 文書クラス別のCritical/Major/Minorエラー件数
- 必須用語の適用率と誤適用率
- 数値・単位・部品番号の一致率
- 初回投入から承認までのリードタイム
- 人レビューの分数と修正種別
- 自動処理率ではなく「無修正承認」「軽微修正」「全面修正」の比率
- 翻訳メモリとキャッシュの再利用率
- 例外率、再試行率、失敗理由
- 旧版配布、誤配布、承認漏れの件数
基準値は自社の現状を測って設定します。モデルやプロバイダーを変更したら、同じホールドアウトセットで比較します。タイ語の生成AI評価については、タイ語生成AIの評価設計が評価データとレビュー設計の補助になります。外部開発を検討する場合は、タイにおけるAI開発委託の進め方も合わせてご覧ください。
タイのAIガバナンス動向を運用へ落とす
タイETDAは2026年の方向性として「Driving Trust AI Governance」を掲げ、ガイドラインとツールキット、実利用、国内外の協力、人材能力の向上を組み合わせる方針を示しています。これは個別企業の法的適合を自動的に保証するものではありませんが、翻訳自動化でも、信頼性をモデル選定だけでなくガバナンス、実装、教育まで含めて考える必要があることと整合します。
運用では、AI利用台帳、文書クラス、データフロー、リスク評価、承認者、テスト結果、インシデント、変更履歴を残します。タイの個人データ、労務、顧客契約、業界規制など、適用法令・契約の判断は法務・専門家と確認してください。
よくある質問
企業の翻訳 自動化はどの文書から始めるべきですか?
量があり、反復が多く、原文と承認者が明確で、誤訳時の影響を限定できる文書から始めます。社内FAQや定型報告が候補です。ただし簡単な文書だけでPoCを終えず、将来対象にする品質・安全文書も評価セットへ入れ、無人公開はしない条件で限界を確認します。
AI 翻訳 ビジネスで用語集だけ作れば品質は安定しますか?
安定しません。用語集は重要ですが、原文の曖昧さ、文書版、翻訳メモリ、スタイル、モデル設定、後処理、人レビューも影響します。また、サービスごとに用語集の一致条件や保証が違うため、実文での適用テストが必要です。
翻訳メモリと生成AIはどう併用しますか?
承認済みの完全一致を優先し、類似一致は差分付きで提示し、該当がない部分をAIで下訳する構成が考えられます。AI出力は承認後にのみ翻訳メモリへ昇格させ、スコープ、版、責任者、撤回状態を持たせます。
タイ語 日本語 翻訳 AIは原文言語を自動判定できますか?
多くのサービスが自動判定を提供しますが、短いアラーム、品名、略語、混在言語は誤判定しやすい領域です。既知なら原文言語を指定し、判定結果と信頼度、混在の検知を例外処理へつなぎます。
機密文書はクラウドAIへ送れますか?
一律には答えられません。文書区分、契約、学習利用、保持、リージョン、サブプロセッサ、暗号化、アクセス、法令、顧客契約を確認し、許可レーンを決めます。必要に応じてマスキング、専用環境、送信禁止を選びます。
人レビューを減らす基準は何ですか?
一定期間の実データで重大エラーが管理され、用語・数値検査、例外検知、回帰テスト、ロールバックが機能し、責任部門が残余リスクを承認したことが条件です。文書クラスごとに決め、安全・品質・契約は完全無人化しません。
多言語 文書 翻訳のRFPで一番重要な証拠は何ですか?
自社の固定テストセットを、実際の用語集、形式、機密条件、レビュー手順で処理した結果です。デモ文章やベンダーの平均スコアだけでは、自社固有の用語、表、版管理、異常時復旧を判断できません。
PoCは30日で完了しますか?
30日は設計例です。範囲、文書量、セキュリティ審査、契約、専門家レビューで変わります。日数を守ることより、ホールドアウト受入、残余リスク、運用責任、禁止レーンを合意することが重要です。
まとめ:翻訳自動化をモデル導入で終わらせない
翻訳 自動化を企業で定着させるには、原文整備、用語集・翻訳メモリ、機密区分と送信経路、リスク別人レビュー、受入テストと継続評価を一つの業務として設計します。モデル比較は必要ですが、判断の中心ではありません。
安全・品質・契約文書は完全無人化せず、機械検査と専門家承認を組み合わせます。RFPでは自社テストセットを使い、約30日のPoC例では通常条件だけでなく、用語不一致、言語誤検出、OCR不良、API失敗、版の混在まで試します。そこで得た証拠から、許可レーン、レビュー強度、禁止レーンを決めます。
TOMAS TECHでは、タイ・ASEAN拠点の文書棚卸し、日タイ英越の用語設計、セキュアな翻訳パイプライン、PoC評価、レビュー・承認フローまで支援しています。製品選定前やRFP作成段階でも、お問い合わせいただけます。まずは対象文書と「誤訳したときの影響」を整理するところから始めましょう。
公式参考情報
- OpenAI — Data controls in the OpenAI platform
- Microsoft Azure Translator — Use glossaries with Document translation
- DeepL — Language detection
- DeepL — Pre-production checklist
- Google Cloud Translation — Creating and using glossaries
- Amazon Translate — Custom terminology
- ETDA — Driving Trust AI Governance 2026
- Thailand BOI — 2026 H1 investment promotion context


