


生成AIに「今月、タイ工場の停止時間が増えた設備は?」「在庫過多と欠品リスクを同時に見たい」と自然な言葉で尋ね、根拠となるSQLやデータソースまで確認できる——そんなデータエージェント導入が、製造業のBI活用を次の段階へ進めようとしています。一方、デモで答えが返ることと、権限を守りながら現場の意思決定に使えることは別問題です。導入判断では、モデルの流暢さよりも、意味定義、アクセス制御、検証済み質問、監査可能性、運用責任を先に設計しなければなりません。
本記事では、タイ・ASEANで工場を運営する企業を想定し、データエージェントを「買うか、組むか」を判断するための要件、BIやRAGとの違い、セマンティックレイヤーの整備、90日PoC、ベンダー評価、工場KPIへの適用方法を実務レベルで整理します。製品価格や処理性能は契約、リージョン、データ量で変わるため、未確認の数値は示しません。
要点:データエージェント導入を成功させる7原則
- 最初の対象は全社横断ではなく、責任者と意味定義が明確な一つの業務領域に絞る。
- 「どの表を読めるか」だけでなく、OEE、良品率、停止時間などの業務定義をセマンティックレイヤーで固定する。
- 汎用チャットの見栄えではなく、検証済み質問とSQLの組で正答性を評価する。
- 利用者本人の権限を継承し、許可されていない行・列を一件も表示しない。
- 回答には、実行クエリ、参照元、対象期間、フィルターを必ず追跡可能な形で残す。
- PoC中は自動書き戻しを行わず、意思決定支援と人間承認に限定する。
- 原因らしい相関を「原因」と断定しない。根本原因分析には別の分析設計と現場確認が必要である。
TOMAS TECHでは、データ棚卸しや30問の評価セット作成段階から相談できます。自社構築と既製サービスの比較、タイ工場を含む権限・データ接続の確認も、お問い合わせからご相談ください。
データエージェントとは何か:自然言語BIを「会話」だけで終わらせない
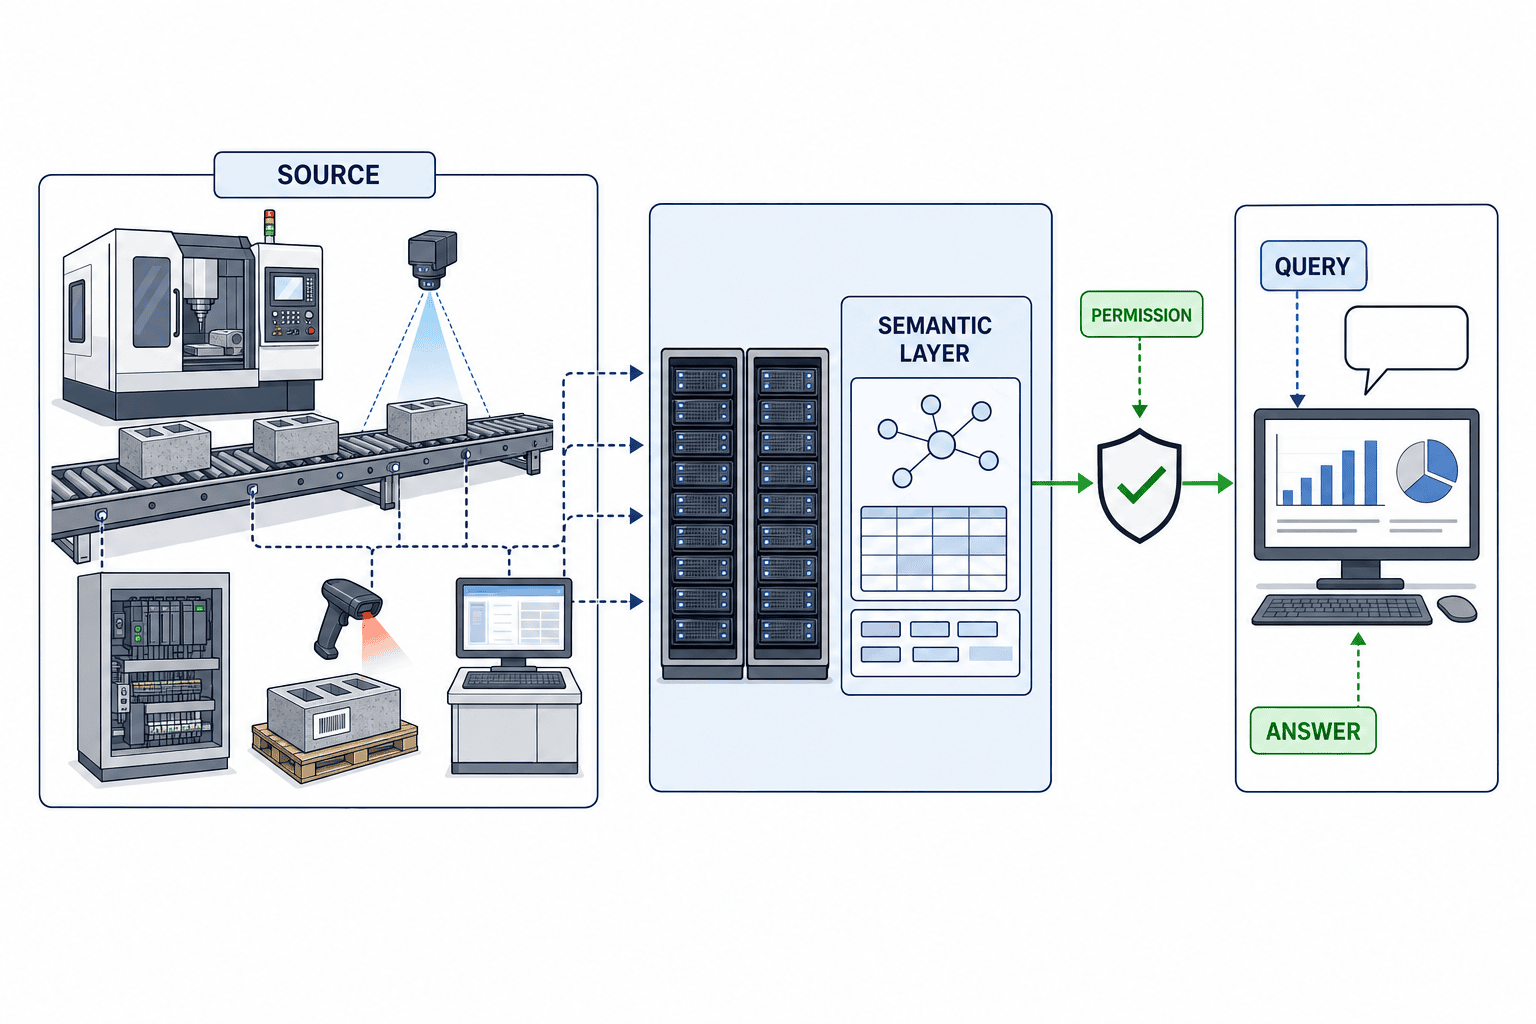
データエージェントは、利用者の自然言語の質問を、企業内で承認されたデータソース、業務定義、アクセス権、クエリ実行、可視化へ結び付ける仕組みです。典型的には、質問の意図を解釈し、対象データを選び、SQL・DAX・KQLなどを生成・実行し、結果を説明します。ただし、単なるNL2SQL機能と同義ではありません。
OpenAIが2026年9月10日に公開した自社のData agentの説明では、承認済みソース、セマンティックレイヤーと業務定義、ユーザー権限の適用、ダッシュボード、さらに人間が承認したアクションが構成要素として示されています。同社内の利用状況として、プロダクトチームのほぼ全員、GTM組織の3分の2超が利用しているとも説明されています。これはOpenAI社内の採用状況であり、他社で同じ利用率や成果が得られるという保証ではありません。
Microsoft Fabric Data agentの公式文書では、利用者本人のIDと権限を用い、自然言語からSQL、DAX、KQLを扱える一方、一つのエージェントに追加できるデータソースは最大5つとされています。また、因果関係や根本原因を問う質問は対象外と明記されています。Databricks Genie Agentsでは、Unity Catalog上のデータセットに、例示SQL、式、指示をキュレーションして応答品質を高める設計が示されています。SnowflakeのVerified Query Repositoryは、検証済みの質問とSQLを蓄積し、信頼性を向上させる考え方です。これらの一次情報に共通するのは、「モデルだけ」ではなく、データ、意味、権限、人間の検証を一体で運用する点です。
データエージェント、RAG、BIダッシュボード、因果分析の違い
導入要件が曖昧になる最大の理由は、似た用語を同じものとして扱うことです。四つの仕組みは補完関係にありますが、問い、根拠、失敗の仕方が異なります。
| 仕組み | 主な対象 | 得意な問い | 根拠 | 注意点 |
|---|---|---|---|---|
| データエージェント | 構造化データ、KPI、履歴 | 「ライン別OEEは?」「先週より停止が増えた設備は?」 | クエリ、表、指標定義 | 誤った結合・集計・期間解釈を検証する必要がある |
| 汎用RAG | 文書、手順書、規程、報告書 | 「このアラームの復旧手順は?」「品質規程の承認条件は?」 | 引用文書、検索チャンク | 数値集計や厳密な表結合には向かない |
| BIダッシュボード | 定義済みの定点指標 | 「今日のOEEを一覧したい」「月次推移を監視したい」 | 定義済みモデル、可視化 | 想定外の追加質問には設計変更が必要 |
| 因果・根本原因分析 | 実験、時系列、工程条件、現場知見 | 「温度上昇が不良を引き起こしたか?」 | 統計設計、実験、因果仮定 | 相関、同時発生、説明文だけでは因果を証明できない |
たとえば「夜勤で歩留まりが低い」という集計結果は、データエージェントが示せます。しかし、夜勤そのものが原因なのか、品種構成、設備、材料ロット、作業条件、測定欠損が影響したのかは、追加分析なしに断定できません。エージェントには「観測された差」「候補となる関連要因」「確認に必要なデータ」を分けて答えさせるべきです。
既存の情報活用全体を見直す場合は、生成AIによるデータ分析の実務ガイドと、文書検索側の企業RAG導入ガイドも併せて確認すると、構造化データと非構造化文書の役割分担を整理しやすくなります。
製造業で狙うべきユースケース:OEE・歩留まり・停止・在庫
OEE:定義差を吸収せず、差を見せる
OEEは一般に稼働率、性能、品質の積で表されますが、計画停止を分母から除くか、速度基準を何にするか、不良をどの時点で数えるかにより数値が変わります。複数工場を横断する場合、同じ「OEE」という列名でも定義が同一とは限りません。
データエージェント導入時は、会社標準定義、工場ローカル定義、計算式、使用テーブル、タイムゾーン、更新頻度を明記します。定義を無理に一つに統合できない場合は、「Group OEE」「Plant OEE」のように別指標として提示し、比較不能なものを一つのランキングにしない設計が安全です。
歩留まり:工程、品種、ロット、再投入を区別する
歩留まりの質問では、初回合格率、最終良品率、スクラップ率、手直し後合格を区別する必要があります。「昨日の歩留まりは?」という問いに、エージェントが任意の定義を選んではいけません。質問が曖昧なら確認し、既定値を使う場合はその定義を回答中に表示します。
停止時間:イベントの重複と未分類を見える化する
PLCイベント、MES停止理由、保全記録が別々に存在する工場では、同じ停止が重複計上されやすくなります。停止時間を集計する前に、開始・終了の補正、重複イベントの扱い、マイクロストップ閾値、計画停止、理由未分類のルールを固定します。「停止理由トップ5」とともに「未分類比率」を示すと、ランキングの見かけだけで改善先を誤るリスクを下げられます。
在庫:現在庫と将来リスクを混同しない
ERP現在庫、WMSロケーション在庫、仕掛品、検査保留、発注残、需要計画は更新時点が異なります。エージェントはスナップショット時刻を示し、利用可能在庫、物理在庫、安全在庫、在庫日数を別々に扱う必要があります。「来週欠品するか」は将来予測を含むため、需要・リードタイムの仮定を明示し、確定事実のように答えないことが重要です。
セマンティックレイヤーAIが導入成否を分ける
セマンティックレイヤーは、データベースの物理構造を業務用語へ翻訳する層です。単なる日本語の列名辞書ではありません。指標の式、粒度、結合、既定フィルター、単位、通貨、タイムゾーン、除外条件、責任者まで含めます。
| 定義項目 | 製造業での例 | 決めない場合の失敗 |
|---|---|---|
| 粒度 | 設備×シフト×品種×日 | 日次とイベント単位を誤結合し、二重計上する |
| 指標式 | 良品数÷投入数 | 手直し品や再投入の扱いで値が変わる |
| 時間境界 | ICT 07:00を操業日開始 | 深夜シフトが別日に分かれる |
| 単位 | kg、piece、THB | 異なる単位を合計する |
| 権限 | 工場、部門、原価列 | 他工場・個人・原価情報が見える |
| 更新鮮度 | 5分、1時間、翌朝 | 現在値と思って古い値を使う |
| 責任者 | 生産技術、品質、経理 | 定義変更の承認者が不在になる |
OpenAIのData agentはセマンティックレイヤーとbusiness definitionsを接続要素として明示しています。Databricksも、データセットを選ぶだけでなく、例示SQL、式、指示をキュレーションする運用を示しています。SnowflakeのVerified Query Repositoryも、信頼できる質問とSQLの組を人間が検証して蓄積するアプローチです。つまり、精度向上の中心は「もっと大きいモデル」だけではなく、意味と正解例を保守できる業務体制にあります。
自然言語BIの権限設計:利用者本人のアクセスを超えさせない
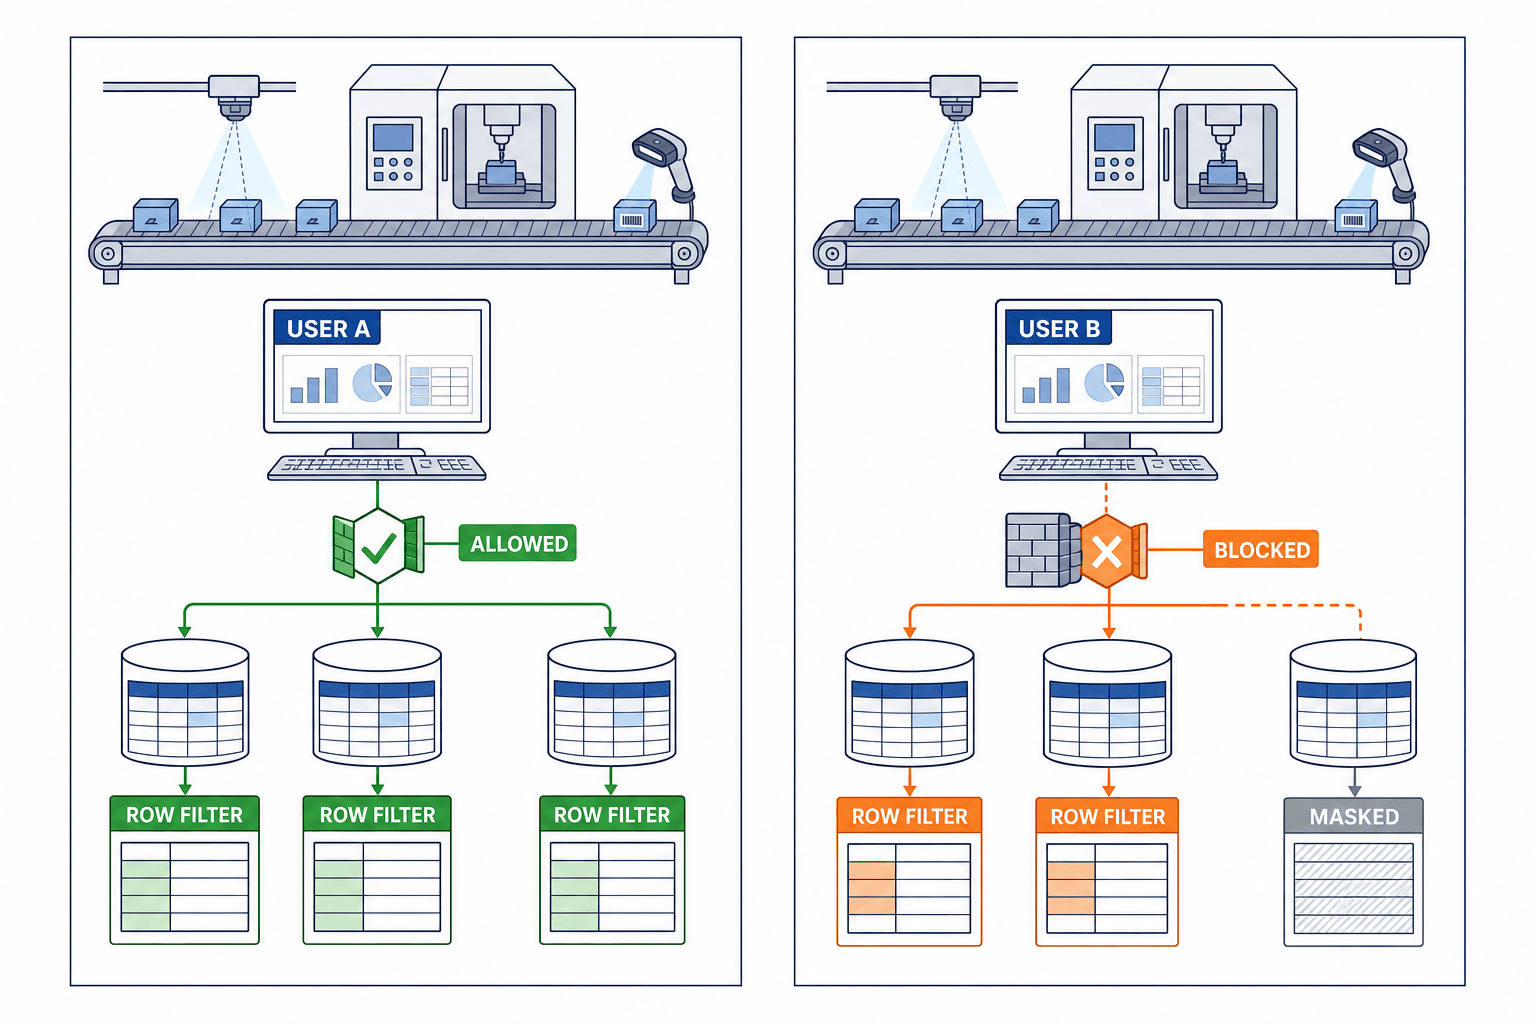
自然言語で尋ねられると、利用者は検索の範囲を意識しにくくなります。通常のBIでは表示されない列でも、生成クエリが参照できれば回答文に含まれる可能性があります。したがって、アプリ側のプロンプトで「機密を出さない」と指示するだけでは不十分です。
最低限、次の制御をデータ層または認証された実行層で適用します。
- SSOや企業IDで利用者を特定し、共有サービスアカウントに全権限を持たせない。
- 工場・部門・顧客・担当者に応じた行レベル権限を適用する。
- 原価、個人情報、給与、顧客機密などを列レベルで制限またはマスキングする。
- 開発、検証、本番を分離し、PoCから本番へ権限をコピーしない。
- 質問、生成クエリ、実行者、実行時刻、参照ソース、結果件数を監査ログに残す。
- CSV出力や共有リンクにも元の権限を引き継ぐ。
- クエリのタイムアウト、行数上限、計算量制限を設定する。
Microsoft Fabricの公式手順がユーザーID権限を明示しているように、エージェントは「データを見られる別人格」ではなく、利用者本人の権限内で働く補助者として設計すべきです。
AIエージェントによるデータ分析をDo/Buyで判断する
「自社構築か製品導入か」は二択ではありません。多くの企業では、認証、カタログ、クエリ実行、監査などの基盤機能を既製サービスで利用し、自社固有の意味定義、評価質問、承認フロー、UI統合を構築するハイブリッドが現実的です。
| 判断軸 | Buy寄り | Do寄り | 確認する証拠 |
|---|---|---|---|
| データ基盤 | 主要データが一つの対応基盤に集約 | 複数DB、オンプレ、独自APIが混在 | 対応コネクターとネットワーク構成 |
| 認証・権限 | 既存IAMと標準統合できる | 独自の工場・顧客権限が複雑 | 実ユーザーでの権限テスト |
| 意味定義 | 標準セマンティックモデルで表現可能 | 複雑な工程ロジックや例外が多い | 指標定義の実装方法と版管理 |
| 応答形式 | 標準チャット・グラフで足りる | MES画面、承認、帳票への組込みが必要 | API、SDK、埋込み方式 |
| 運用能力 | ベンダー機能で監視したい | AI/データチームが運用できる | ログ、評価、障害対応責任 |
| 規制・配置 | 提供リージョンと契約が要件を満たす | 特定環境やネットワーク分離が必須 | データ処理条件、保存、越境 |
ベンダーデモで必ず依頼する5項目
- サンプルデータではなく、自社の匿名化データと実際の曖昧な質問で動かす。
- 正しい回答だけでなく、生成クエリ、参照表、フィルター、対象期間を表示する。
- 権限の異なる二人で同じ質問を行い、結果が正しく変わることを確認する。
- 存在しない指標、結合不能な表、範囲外の因果質問に「答えられない」と言えるか確認する。
- 定義や検証済みSQLを誰が、どの画面で、どの履歴として変更できるか確認する。
製品説明で「正確」「安全」と言われても、自社データでの合格を意味しません。契約前に評価セット、ログの取得方法、障害時の責任分界、データ保持を文書化します。なお、OpenAIの2026年8月の企業利用分析では、月間利用量の上位10%をfrontier firms、45〜55パーセンタイルをtypical firmsと分類しています。frontier firmsはtypical firmsに比べ、アクティブユーザー1人当たりの出力トークン量が8.3倍でした。また週次アクティブユーザーのうち、Plugins利用は21%対9%、skills利用は19%対3%でした。これは利用成熟度の文脈を示す観測値であり、製品導入による因果的ROIや、どの企業にも再現できる成果を示すものではありません。
90日PoC:30問でデータエージェント導入を判定する
以下は研究結果やベンダー保証ではなく、TOMAS TECHが推奨する例示的な90日PoCです。期間、件数、閾値は、対象業務のリスクとデータ品質に応じて合意してください。
PoCの推奨受入基準(TOMAS TECH推奨)
| 評価項目 | 受入閾値 | 判定方法 |
|---|---|---|
| 不正な行・列の露出 | 0件 | 異なる権限のテストユーザーで質問し、結果とログを確認 |
| 凍結済み30問のクエリ・回答正答 | 27問以上/30問 | 承認済みSQL・期待値と照合。27÷30=90% |
| 回答の追跡可能性 | 100% | 全回答から実行クエリと参照ソースへたどれるか確認 |
| 自動書き戻し | 0件 | PoC中は更新API・DB書込権限を与えない |
「27/30」は、30問中27問以上が、クエリと最終回答の両方で正しいことを意味します。回答の文章が自然でも、SQLが誤っていれば不合格です。逆に、クエリが正しくても、単位や期間を誤って説明した場合も不合格です。90%はTOMAS TECHの推奨開始基準であり、品質や安全に関わる用途ではより高い基準や全問合格が必要です。
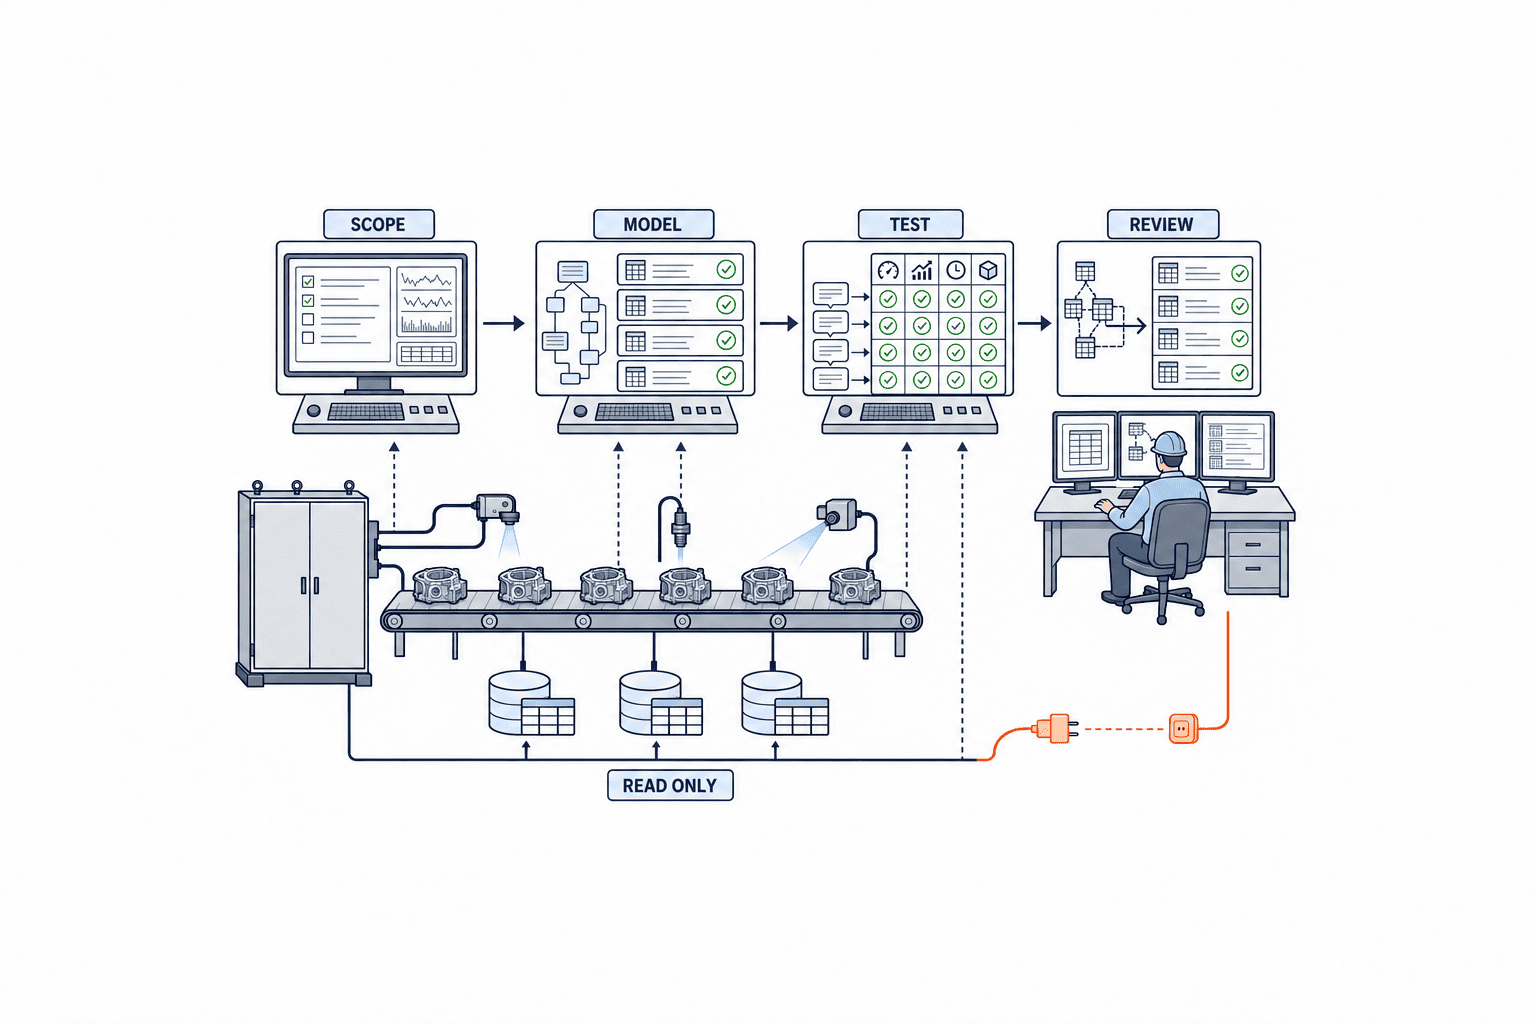
1〜15日:対象と正解を固定する
- 工場、部門、データオーナー、利用者、対象KPIを一つの業務領域に限定する。
- 代表質問20問、曖昧質問5問、権限・拒否質問5問の計30問を作る。
- 各問に期待するSQL、期待値、許容する説明、拒否すべき条件を人間が承認する。
- データの期間とスナップショットを凍結し、評価中に正解が変わらないようにする。
- OEE、歩留まり、停止時間、在庫の定義と責任者を記録する。
30問は簡単な集計だけにしません。「先週」「最新」「工場全体」「停止が多い」のような曖昧語、ゼロ件、欠損、重複、タイムゾーン、閲覧禁止列を含めます。また、「不良の根本原因を断定して」のような範囲外質問に、制約を説明して追加分析を促せるかも確認します。
16〜35日:データとセマンティックレイヤーを接続する
- 読み取り専用の検証環境を用意する。
- 必要最小限のテーブル、ビュー、セマンティックモデルだけを公開する。
- 例示SQL、同義語、指標式、結合、既定期間を登録する。
- 行・列権限とマスキングを本番に近い形で設定する。
- 利用者が古いデータを現在値と誤解しないよう、更新時刻を回答に含める。
データソース数を増やすほど価値が出るとは限りません。たとえばMicrosoft Fabric Data agentは一つのエージェントに最大5ソースという製品上の上限を示しています。製品ごとに上限や接続条件が違うため、必要なソースを先に列挙し、分割や統合が必要かを確認します。
36〜60日:評価、修正、再評価を繰り返す
各質問について、意図解釈、選択ソース、生成クエリ、クエリ結果、説明、可視化を分けて採点します。誤りを「モデルの精度不足」の一語で片付けず、次の分類で記録します。
| エラー分類 | 例 | 主な改善先 |
|---|---|---|
| 意図解釈 | 「先週」の操業週を誤る | 質問確認、時間定義 |
| ソース選択 | 在庫履歴ではなく現在庫を選ぶ | カタログ説明、スコープ |
| 結合 | 設備イベントと生産実績を多対多結合 | キュレーション済みビュー |
| 指標 | 良品率に手直し品を含める | セマンティック定義 |
| 権限 | 原価列が回答文に出る | 列権限、マスキング |
| 説明 | THBを数量として説明 | 単位メタデータ、回答テンプレート |
| 過剰推論 | 相関から原因を断定 | ガードレール、分析範囲の明示 |
修正後は、その問だけでなく凍結した30問すべてを再実行します。一つの例示SQL追加が別質問を悪化させる可能性があるためです。SnowflakeのVerified Query Repositoryのように人間が検証した質問とSQLを蓄積する場合も、変更履歴、承認者、再評価日を管理します。
61〜75日:限定ユーザーで業務試行する
生産管理、品質、保全など5〜10名程度の限定利用者を想定し、実際の会議や日次確認で使います。この人数はTOMAS TECHの例示的推奨であり、必須条件ではありません。利用者には「回答を意思決定の入力として確認する」「不明な指標は定義を開く」「原因断定をしない」「機密結果を権限外へ転送しない」という運用ルールを共有します。
ログから、質問成功率だけでなく、再質問の理由、使われない質問、手作業へ戻った場面を確認します。高速な回答でも、毎回SQLを人間が全面修正するなら運用価値は低いと言えます。一方、定型ダッシュボードで十分な質問が多い場合、すべてをエージェント化せず、BIへのリンクを返す設計が合理的です。
76〜90日:受入判定と本番計画を作る
最終週は、凍結30問を新しいセッションで再実行し、権限、追跡可能性、自動書き戻しなしを確認します。合格後も、いきなり全社公開せず、対象工場、同時利用者、データソースを段階的に広げます。
不合格でも、すぐに製品を却下する必要はありません。誤りが意味定義や元データに集中するなら、製品変更よりデータ整備が先です。権限が実装できない、クエリやソースを追跡できない、必要な配置条件を満たさない場合は、採用中止またはアーキテクチャ見直しが必要です。
工場KPIダッシュボードとの役割分担
データエージェントがあればダッシュボードが不要になるわけではありません。毎朝必ず見るOEE、稼働状況、未処理アラーム、在庫警告は、同じレイアウトで即時確認できるダッシュボードが向いています。エージェントは「なぜこのラインだけ低いのかを、品種とシフトで分けて」「先月と条件をそろえて比べて」のような追加探索に向きます。
推奨する入口は三層です。
- 監視:承認済みKPIを工場KPIダッシュボードで常時表示する。
- 探索:ダッシュボードからデータエージェントへ文脈を渡し、追加質問する。
- 対応:結果を人間が確認し、保全依頼、計画変更、発注など既存ワークフローで承認する。
PoCでは3番目を自動化しません。将来アクション連携を行う場合も、読み取りエージェントと書き込み権限を分離し、対象操作、承認者、上限、ロールバック、二重実行防止を個別に設計します。OpenAIの説明にもhuman-approved actionsが含まれますが、これは無条件の自動実行を意味しません。
導入前データ診断:モデル選定より先に確認すること
データエージェントの評価が進まない企業では、実はデータ側の準備不足が原因であることが少なくありません。以下の質問に答えられない場合、まず2〜4週間程度のデータ診断を置く方法があります。この期間はTOMAS TECHの例示であり、環境により調整します。
- 主要KPIごとに業務責任者とデータ責任者が決まっているか。
- 実績値の正解を確認できる既存レポートや承認済みSQLがあるか。
- 工場、設備、品種、材料のマスターキーがシステム間で対応しているか。
- タイムゾーン、操業日、シフト境界が統一または変換可能か。
- 欠損、遅延、重複、手入力修正を検出できるか。
- 本番と検証で同等の行・列権限を再現できるか。
- クエリログを保存し、後から回答を再現できるか。
診断結果は「導入可/不可」だけでなく、即接続可能、ビュー整備が必要、マスター統合が必要、対象外の四段階程度に分類すると投資判断に使いやすくなります。
運用設計:公開後に精度を落とさない
データ、指標、工場の運用は変化します。PoC時点で正しくても、新設備追加、ERP移行、品種コード変更、会計年度変更により回答が崩れます。運用では少なくとも次を管理します。
| 運用対象 | 推奨する管理内容 |
|---|---|
| 評価セット | 重要30問を回帰テストとして保持し、定義・モデル変更時に再実行 |
| 意味定義 | 変更理由、承認者、適用日、影響する質問を版管理 |
| アクセス権 | 入退社・異動、工場追加、委託先権限を定期再確認 |
| データ品質 | 更新遅延、欠損、重複、異常値を回答前に検知 |
| 利用ログ | 失敗質問、頻出質問、再質問、エクスポートを監査 |
| インシデント | 誤回答、情報露出、過負荷時の停止・通知・再発防止 |
回答画面には「正しそう」という印象ではなく、検証できる材料を出します。少なくとも指標定義、対象期間、最終更新、参照ソース、生成クエリ、制限事項を表示し、利用者が元データへ遡れるようにします。
よくある失敗と回避策
全社データを先に接続する
接続範囲が広いほど質問の曖昧性、同名指標、権限の組合せが増えます。最初は一工場、一業務領域、30問に絞り、合格後に横展開します。
回答文だけを採点する
文章が正しく見えても、誤った結合が偶然同じ数値を返すことがあります。クエリと回答を一組で採点し、参照ソースまで追跡します。
デモ用の整った質問だけで合格にする
実利用では「最近」「悪いライン」「在庫大丈夫?」のような曖昧な問いが出ます。確認質問、拒否、定義表示も能力として評価します。
原因分析をチャット説明に任せる
停止と不良が同時に増えた事実は示せても、片方が他方を引き起こしたとは限りません。原因候補を出す場合は仮説と明記し、工程条件、保全履歴、材料、実験結果を追加確認します。
PoCのまま書き戻し権限を持たせる
誤解釈が発注、計画変更、設備設定へ直結すると影響が拡大します。90日PoCでは自動書き戻しをゼロとし、読み取りと人間承認に限定します。
FAQ:データエージェント導入でよくある質問
データエージェント導入とは、チャットボット導入と何が違いますか?
企業の承認済みデータ、セマンティック定義、利用者権限、クエリ実行、監査を一体で扱う点が異なります。一般的なチャットボットが文章生成だけを行う場合、工場KPIの正確な集計や権限制御は別途必要です。
AIエージェントによるデータ分析はRAGで代替できますか?
完全には代替できません。RAGは手順書や報告書の検索・引用に向き、データエージェントは表データの集計や指標比較に向きます。両者を連携し、数値はクエリ、手順は文書引用という分担が現実的です。
自然言語BIはSQLを知らない人でも使えますか?
利用できますが、SQLを見なくてよいことと、検証不要であることは同じではありません。利用者には対象期間、単位、指標定義、更新時刻を確認する習慣が必要です。高リスクな判断ではデータ担当者の確認を残します。
セマンティックレイヤーAIには何を登録しますか?
指標名と説明だけでなく、式、粒度、結合、単位、タイムゾーン、既定フィルター、除外条件、権限、責任者、検証済み質問とSQLを登録します。変更履歴と回帰テストも必要です。
工場KPIダッシュボードは置き換えられますか?
定点監視はダッシュボード、追加探索はデータエージェントという役割分担が適しています。毎回同じKPIを会話で作り直すより、承認済みダッシュボードを基準にした方が速く安定します。
根本原因を自動で特定できますか?
集計結果から相関や候補を示すことはできますが、因果関係の証明とは異なります。Microsoft Fabricの公式文書でも、causal/root-cause questionsは対象外とされています。必要に応じて統計分析、実験、工程知識、現場確認を組み合わせます。
90日PoCで27問正解なら十分ですか?
27/30=90%はTOMAS TECHの例示的な推奨基準です。安全、品質、法令、財務に直結する質問ではより厳しい基準が必要です。また、正答率とは別に、不正な行・列の露出0件、追跡可能性100%、自動書き戻し0件を満たす必要があります。
データエージェントの費用はどの程度ですか?
製品ライセンス、利用量、データ基盤、ネットワーク、セマンティックモデル整備、運用支援で変わります。本記事では未確認の価格を示していません。比較時は同じ30問、同じデータ、同じ権限要件でPoC総費用と本番運用費を見積もります。
まとめ:買う前に、正解・権限・追跡可能性を作る
データエージェント導入の価値は、自然な会話そのものではなく、現場の質問を承認済みデータと業務定義につなぎ、検証可能な回答へ短時間で到達させることにあります。製造業ではOEE、歩留まり、停止時間、在庫が有力な入口ですが、各指標の粒度、期間、例外、権限を先に固定する必要があります。
Do/Buyの比較では、モデルのブランドやデモの印象だけでなく、自社データでのクエリ正答、権限継承、監査ログ、セマンティックレイヤーの保守性、配置条件を確認します。90日PoCでは、凍結30問中27問以上、無許可データ露出0件、追跡可能性100%、自動書き戻し0件という明確な受入基準を置きます。これはTOMAS TECH推奨の例示基準であり、用途のリスクに応じて強化してください。
原因分析は、観測された差と因果判断を区別します。データエージェントは探索を速める有力な道具ですが、元データの品質、人間の検証、現場知識を置き換えるものではありません。
自社のデータで30問を作れるか、既製サービスと自社構築のどちらが適するか、まだ検討初期でも構いません。タイ・ASEANの工場システムを含むデータ接続、KPI定義、権限設計については、TOMAS TECHへのお問い合わせからご相談ください。
参考情報
- OpenAI: Put data to work with a data agent(2026年9月10日。承認済みソース、セマンティックレイヤー、権限、ダッシュボード、人間承認アクション、社内利用状況)
- OpenAI: How enterprises put AI to work(2026年8月12日。企業利用成熟度に関する観測値)
- Databricks: Genie Agents(Unity Catalogデータ、例示SQL、式、指示のキュレーション)
- Snowflake: Verified Query Repository(人間が検証した質問とSQLによる信頼性向上)
- Microsoft Learn: Create a Fabric Data agent(ユーザー権限、SQL・DAX・KQL、最大5ソース、因果・根本原因質問の範囲外)


