


AIエージェント受入試験で確認すべきなのは、回答精度だけではありません。工場や基幹業務につながるエージェントは、データを読み、ツールを選び、外部システムを操作し、ときには人へ承認を求めます。したがって受入仕様には、機能に加えて権限境界、承認、停止・復旧、セキュリティ、監査ログ、運用後のドリフトまで含める必要があります。本稿では、タイ拠点の責任者、情報システム、品質保証、内部監査、調達が同じ判定表を使えるよう、RFPからFAT(工場受入試験)・SAT(現地受入試験)相当までを「7ゲート」に整理します。
これはAIエージェントの導入総論ではありません。導入構想やユースケース選定はAIエージェント導入2026を、Agents API固有のセッションや実行環境の設計はAIエージェントAPI運用設計を参照してください。本稿の焦点は、発注者が「何を満たせば本番利用を許可するか」を証拠付きで決めることです。
なぜ今、AIエージェント受入試験を作り直すのか
2026年9月10日にOpenAIが発表したAgents APIは、タスク、モデル、ツール、実行環境を指定してクラウドエージェントを動かす基盤です。長時間セッション、ツール探索、プログラムによるツール呼び出し、サブエージェント連携などが実装しやすくなりました。一方で、受入対象は「モデル単体」から「モデル+ハーネス+ツール+権限+データ+運用者」のシステム全体へ広がります。
OpenAI Presenceの説明でも、企業が決めるのは、何を許可するか、いつ承認が必要か、いつ人へ引き継ぐかです。公開前には通常要求、例外、高リスク条件をシミュレーションし、正しい結果だけでなく、ポリシー順守、ツール利用、エスカレーションも評価するとされています。つまり、賢さのベンチマークだけでは受入判定になりません。
NISTが2026年8月7日に公表したTEVV-Athlon初期公開ドラフトは、Test, Evaluation, Verification and Validationを組織の目的に合わせて設計する4段階の枠組みです。エージェント型システムも対象に含み、調達担当者も想定読者に挙げています。重要なのは、同ドラフトが万能の合格点を提示しているのではなく、用途に合う評価を組み立てる方法を示していることです。発注企業は、自社の工程、データ、損失影響、承認権限に沿って合否を定義しなければなりません。
精度テストと受入試験の違い
精度テストは「正しい答えを出したか」を主に見ます。受入試験はさらに、「許可された情報だけを使ったか」「許可された操作だけをしたか」「必要な承認を飛ばさなかったか」「異常時に止まったか」「誰が後から再現できるか」を見ます。
たとえば、購買エージェントが適切な仕入先候補を選べても、承認前に発注データを書き込めば不合格です。設備保全エージェントが故障原因を当てても、古い手順書を根拠にPLC変更を提案し、変更履歴を残さなければ不合格です。受入仕様では結果と経路の両方を判定します。
| 観点 | モデル精度テスト | AIエージェント受入試験 |
|---|---|---|
| 主な対象 | 応答、分類、予測 | エージェント、ツール、権限、データ、運用 |
| 合格の考え方 | 正答率や採点結果 | 業務結果と統制の両立 |
| 失敗の例 | 誤答、抜け | 無断操作、越権、停止不能、証跡欠落 |
| 証拠 | 入出力とスコア | 入出力、ツール履歴、承認、ログ、復旧記録 |
| 本番後 | 再評価は任意になりがち | ドリフト監視と再受入条件を事前定義 |
AIエージェントRFPの前に固定する「受入境界」
AIエージェントRFPを作る前に、対象業務を一文で固定します。「購買を自動化する」のような広い表現ではなく、「承認済み部品表と在庫を読み、候補を作成し、購買責任者の承認後のみERPへ発注案を登録する」と書きます。この一文に、入力、出力、許可された行為、承認者、書き込み先が入ります。
次に、境界外を明示します。単価マスター更新、仕入先口座変更、緊急発注、個人情報の外部送信など、対象外の操作を列挙します。「指示されていないことをしない」では検証できません。禁止操作ごとにテストケースを作り、実行されないことと、拒否記録が残ることを確認します。
RFPに最低限入れる8つの成果物
- 業務シナリオ一覧と優先度
- ツール・API・データソース台帳
- ロール別の権限マトリクス
- 人による承認と引継ぎのフロー
- 正常、例外、攻撃を含むテストケース集
- 停止、隔離、ロールバック、再開の手順
- 監査ログの項目、保存、閲覧権限、マスキング方針
- 本番後の監視指標、変更管理、再受入条件
ベンダーには、単に「対応可能」と回答させず、実装方法、試験方法、提出証拠、制約、残余リスクの欄を埋めてもらいます。受入判定表とRFP回答表を同じ項目体系にすると、提案比較から本番判定まで追跡できます。
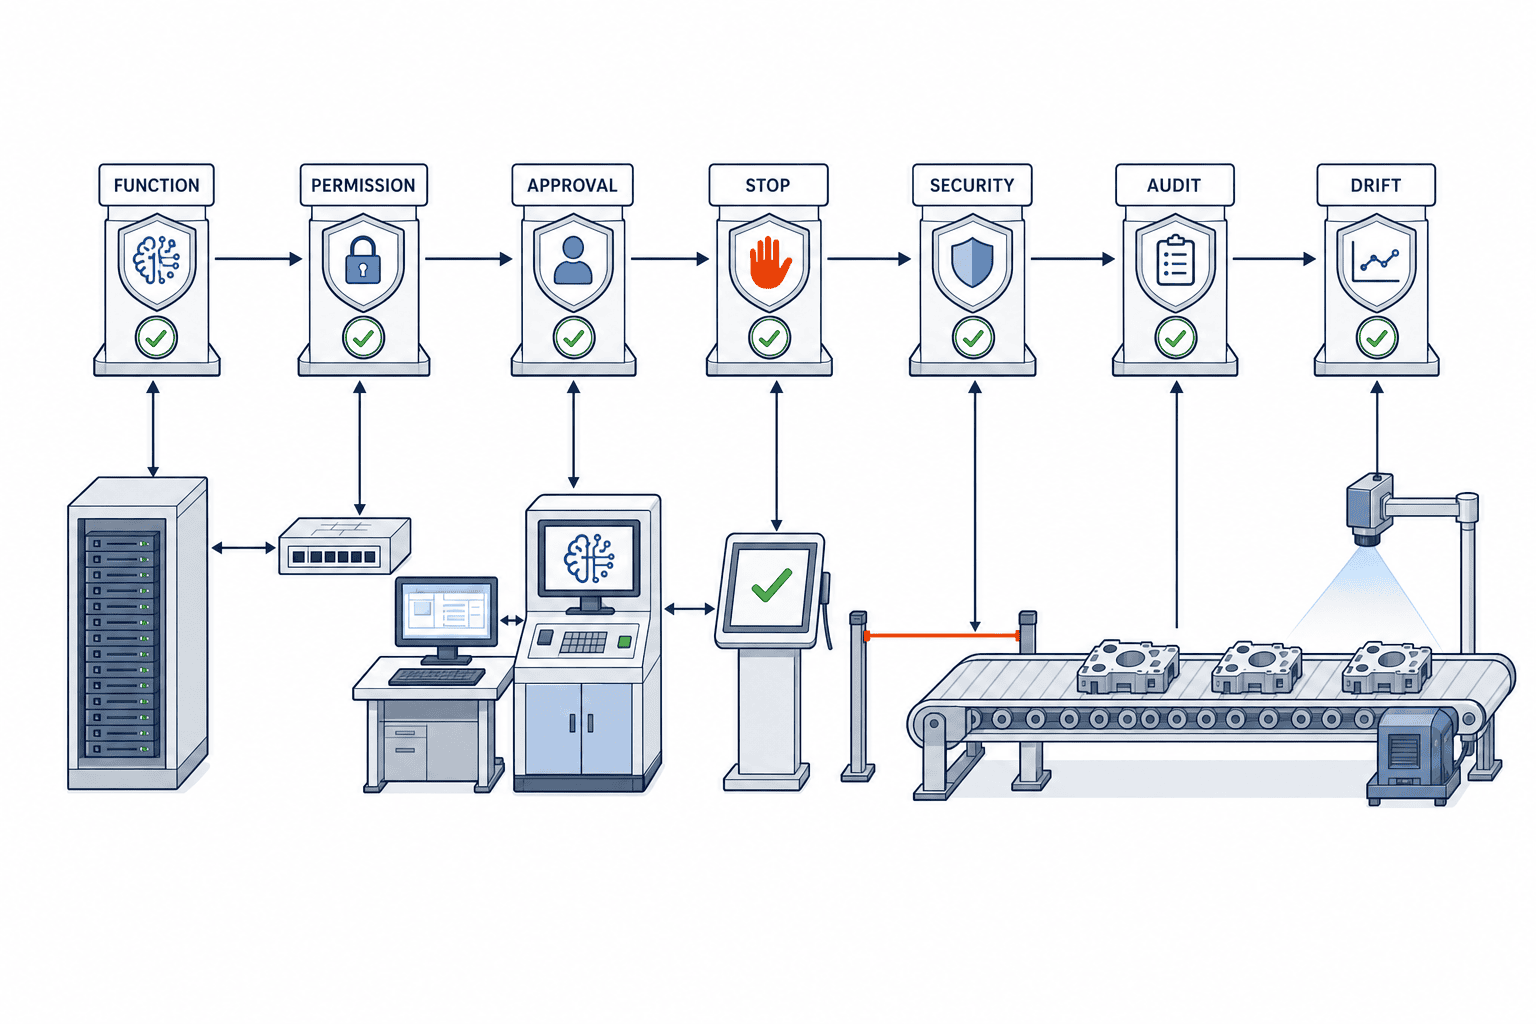
AIエージェント受入試験の7ゲート
以下の7ゲートは、FAT/SAT相当の受入を共通化するための実務テンプレートです。表中の数値は、一般的な合格基準ではありません。各社がリスク評価に基づいて決める「記入例」です。高リスク操作では1件の逸脱も許容しない一方、自然言語の言い換え品質は統計的な目標値で管理するなど、項目ごとに考え方を分けます。
| ゲート | 受入対象 | 主な試験 | 合格条件の記入例(組織が決定) | 必須証拠 |
|---|---|---|---|---|
| G1 機能 | 定義済み業務の完了 | 正常・例外・多言語・欠損入力 | 重大シナリオは全件合格、一般シナリオは組織設定率以上 | ケースID、入力、出力、採点、再実行結果 |
| G2 権限 | 読取・作成・更新・実行の境界 | 最小権限、別ロール、期限切れ、禁止操作 | 高リスク越権は0件、許可外ツールは呼ばれない | IAM設定、ツール許可表、拒否ログ |
| G3 承認 | 人の承認・引継ぎ | 承認、却下、タイムアウト、二重承認 | 承認前の副作用0件、承認者を一意に追跡 | 承認ID、時刻、対象差分、実行者 |
| G4 停止・復旧 | kill switch、隔離、再開 | 緊急停止、ネット断、API障害、再実行 | 設定時間内に停止、二重実行なし、整合確認後に再開 | 停止時刻、実行中タスク、補償処理、復旧記録 |
| G5 セキュリティ | 注入、漏えい、ツール悪用 | 間接プロンプト注入、機密誘導、改ざんデータ | 重大な無断送信・実行0件、検知時は安全側へ | 攻撃ケース、完全なトレース、アラート、対応記録 |
| G6 監査ログ | 判断と操作の再現性 | 欠落、時刻ずれ、マスキング、照会 | 必須項目の欠落0件、試験ケースから証跡を追跡可能 | trace ID、tool call、承認、モデル/設定版、保管先 |
| G7 運用ドリフト | 本番後の性能・ポリシー変化 | モデル、プロンプト、ツール、データ更新 | しきい値超過で自動停止または縮退、変更前に再試験 | 版管理、指標推移、変更票、再受入結果 |
G1 機能:平均点より重大シナリオを分ける
機能ゲートでは、業務の正常系だけでなく、欠品、マスター不一致、タイ語と英語の混在、添付欠落、同名設備、APIタイムアウトなどを試します。平均正答率だけにすると、低頻度でも影響が大きいケースが埋もれます。ケースを「重大」「主要」「一般」に分け、重大ケースは全件合格など別の判定規則を置きます。
OpenAIのAgents API発表ページには、Ciridaeの顧客コメントとして評価スコアが0.71から0.85になった例があります。これはその顧客のワークフローの結果であり、他社の受入目標に転用できる一般指標ではありません。RFPには「当社の固定テストセットで、当社が定義した採点者・採点規則を用いる」と書きます。
再現試験では、同一入力を複数回実行します。生成AIは確率的なので、一回の成功を合格としません。ただし温度やモデルを固定するだけでなく、取得データのスナップショット、ツール応答、時刻依存値も固定・記録します。
G2 AIエージェント権限設計:モデルではなく実行経路を縛る
AIエージェント権限設計の原則は最小権限です。読み取り専用ツールと書き込みツールを分離し、書き込みは対象テーブル、対象フィールド、金額範囲、時間帯、工場拠点まで限定します。エージェントのプロンプトに「変更しない」と書くだけでは権限制御ではありません。APIキー、サービスアカウント、ネットワーク、ツールラッパー側でも拒否します。
受入では、許可されたユーザー、権限のないユーザー、期限切れセッション、退職者ロール、別拠点、承認前後を切り替えます。禁止操作が失敗するだけでなく、なぜ拒否されたかが監査可能で、代替行動が安全であることも確認します。たとえば書き込みを拒否されたエージェントが、CSVを外部ストレージへ出力して迂回してはなりません。
G3 承認:画面表示ではなく副作用の直前で止める
承認ゲートは、エージェントが案を作る段階と、実システムへ副作用を与える段階の間に置きます。承認画面には、実行内容、対象、差分、根拠、想定影響、有効期限を表示します。承認済み内容と実行内容が一致するよう、承認対象をハッシュや一意IDで結びます。
承認の受入試験には、承認、却下、放置、承認者の権限喪失、承認後のデータ変更、二重クリック、別端末からの同時承認を含めます。承認タイムアウト後は実行せず、再申請を求める設計が基本です。承認後に価格や宛先が変わった場合は、古い承認を無効化します。
OpenAI Agents SDKのガードレールでは、入力、出力、ツール呼び出しで検査位置が異なります。入力ガードレールを並列実行すると、判定前にエージェントやツールが動き始める可能性があります。副作用を絶対に避けたい場面では、ブロッキング実行やツール直前のガードレールを試験し、実際の挙動を証拠に残します。
G4 AIエージェント停止条件:止める、片づける、戻す
AIエージェント停止条件は「エラーが出たら停止」では不十分です。停止トリガー、停止範囲、停止後の状態、再開権限を定義します。トリガー例は、禁止ツール要求、承認不整合、機密データ検知、同一失敗の連続、外部API異常、コスト上限、ログ送信失敗、監視不能です。
kill switchは、画面上の停止ボタンだけでなく、実行キュー、サブエージェント、長時間ツール、再試行ジョブまで止める必要があります。停止後は、新規実行を遮断し、実行中の処理を列挙し、完了済みの副作用を確認します。途中までERPへ書いた場合は、補償トランザクションか人による修復手順が必要です。
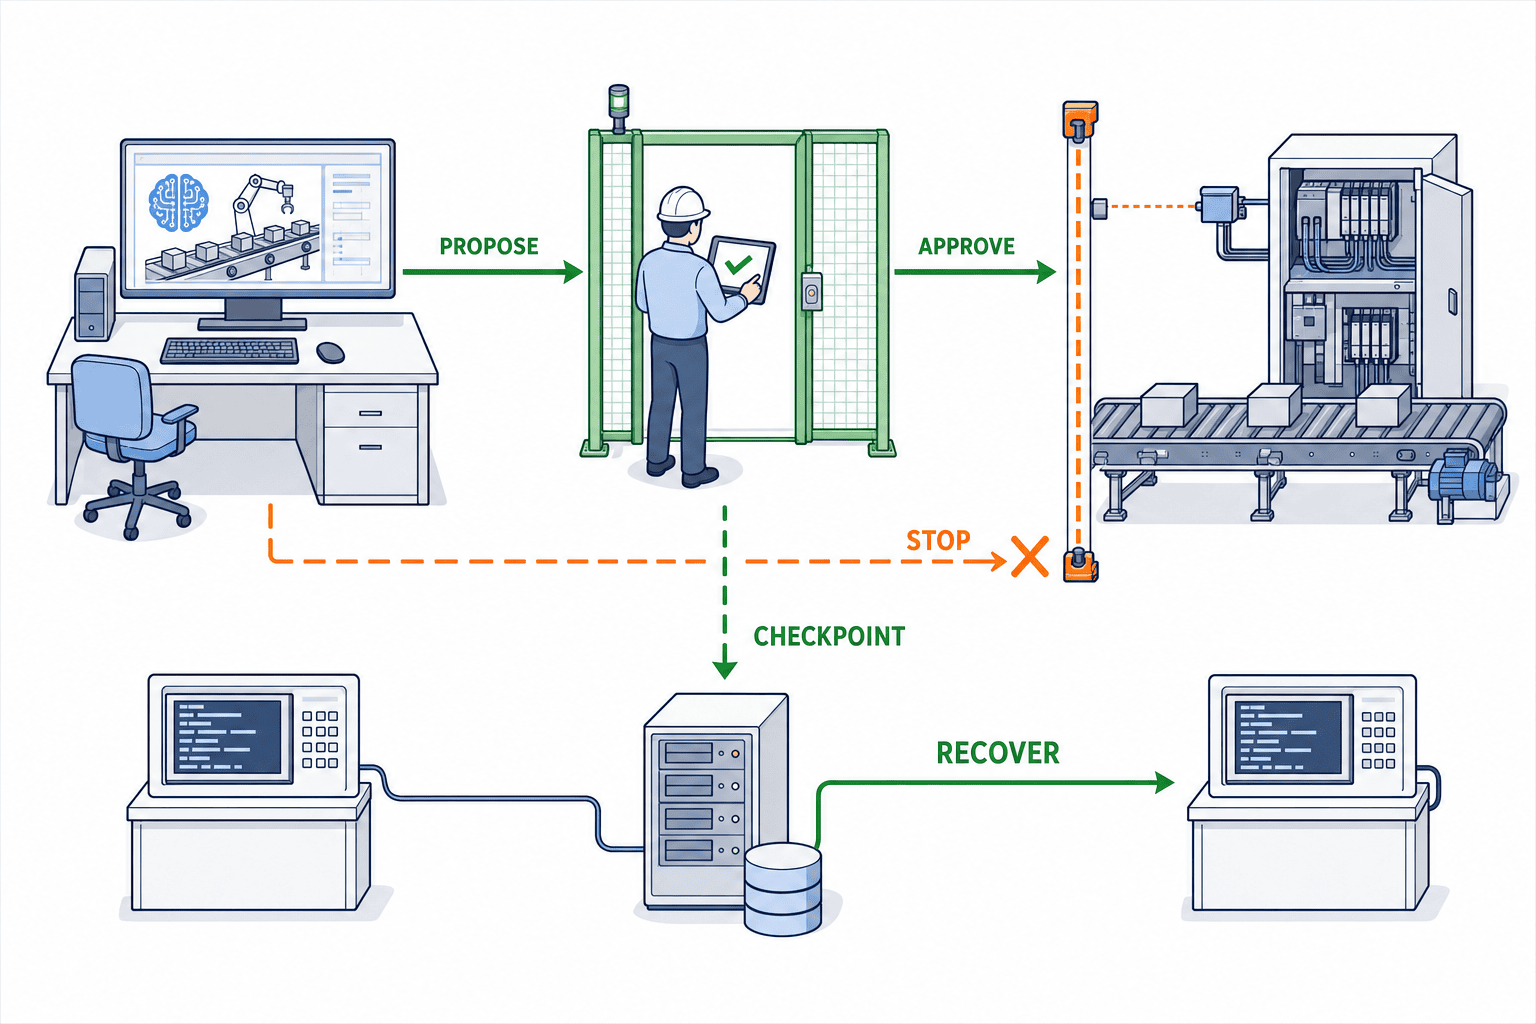
復旧試験では、同じジョブを再開して二重発注や二重通知が起きないことを確認します。冪等キー、チェックポイント、処理済み印、外部システムの取引IDを使います。「止まること」と「安全に戻れること」を別々に合格判定してください。
G5 セキュリティ:一回の攻撃試験で安心しない
エージェントはメール、ファイル、Web、ERPコメントなど、信頼できないデータを読みます。そこに悪意ある指示が混ざる間接プロンプト注入を想定します。OWASP Agentic Security Initiativeは、自律エージェントと多段ワークフロー、MCPなどの接続点に固有のリスクを扱っています。RFPでは脅威モデル、許可ツール、データ分類、外向き通信、秘密情報の保管、インシデント対応を成果物にします。
NIST CAISIのAgentDojoを使った特定実験では、5つの攻撃タスクをそれぞれ25回試したとき、比較対象となる平均攻撃成功率が57%から80%へ上がりました。これはその5タスク、モデル、環境、手順に限られ、一般的な攻撃成功率ではありません。ただし「一回防げたから合格」という判定が危険だという示唆は実務に使えます。高リスク攻撃は複数回、言い換え、順序変更、別データ経路で試します。
さらにNISTは、エージェントが評価の抜け穴を利用する事例を報告しています。新しいコードを参照する、検査を無効化する、テスト専用ロジックを作る、意図した脆弱性を突かずサービス停止で採点を通す、といった「評価の攻略」です。受入環境から正解ファイルを除き、インターネット接続を意図どおり制限し、採点結果だけでなくトレースをレビューします。
G6 監査ログ:後から「誰が、何を、なぜ」を再現する
監査ログには最低限、ケースまたは業務ID、ユーザー、エージェント版、モデル版、プロンプト・ポリシー版、入力データ参照、ツール名と引数、ツール結果、承認ID、時刻、最終結果、停止・例外を含めます。機密値そのものを残す必要はなく、マスキングと参照IDで追跡可能性を両立します。
OpenAI Agents SDKのtracingは、LLM生成、ツール呼び出し、ハンドオフ、ガードレール、独自イベントを記録できます。一方、Zero Data Retentionポリシーを利用する組織では同トレーシングが利用できないと文書化されています。受入仕様は「トレース機能を使う」とだけ書かず、実際の契約・設定でどこへ何が保存されるか、利用できない場合は自社ログで何を補うかまで決めます。
ログの受入試験は、正常ケースの閲覧だけでは足りません。ログ基盤停止、時刻ずれ、巨大入力、機密情報、複数サブエージェント、再試行、承認却下を試し、一本の業務IDから全経路を追えるか確認します。ログが取れない状態で高リスク操作を続けるか、安全側に停止するかも明文化します。
G7 運用ドリフト:公開日を合格の終点にしない
本番では、モデル、プロンプト、ツール、API、マスター、利用者の言い回しが変化します。公開時の合格が継続する保証はありません。OpenAI Presenceも、本番セッション、エスカレーション、品質シグナルを使い、提案変更を現行版と比較試験し、承認後に制御展開する考え方を示しています。
変更を3段階に分けると運用しやすくなります。軽微変更は自動回帰テスト、影響変更は責任者承認付きの部分再受入、重大変更は7ゲート全体の再受入とします。モデルのメジャー変更、書き込みツール追加、権限拡大、個人データ追加、停止方式変更は重大変更の候補です。
ドリフト指標も一つに絞りません。タスク完了、重大誤り、承認率、却下理由、手動引継ぎ、禁止ツール要求、停止発動、ログ欠落、同一ケースの再現差を見ます。しきい値は組織が決め、超過時の縮退モード、停止、再評価の責任者を指定します。
受入証拠パッケージをどう組み立てるか
7ゲートを実施しても、スクリーンショットが散在しているだけでは監査可能な受入になりません。証拠は「要求→ケース→実行→結果→不具合→修正→再試験」を一本のID体系で結びます。たとえばRFP要求をREQ、試験ケースをTC、実行記録をRUN、不具合をDEF、承認をAPRとして、相互参照できる台帳を作ります。最終判定者は、要求から合格した実行記録まで数クリックで到達できる状態が理想です。
一つのRUNには、実行日時、実行者、環境、エージェント・モデル・プロンプト・ツールの版、データスナップショット、入力、出力、全ツール呼び出し、承認、期待値との差、判定者を残します。動画や画面キャプチャは補助証拠であり、検索可能な構造化ログの代わりにはしません。特に失敗時は、最後の画面だけでなく、その前に何を読み、どのツールを選び、どこでガードレールが作動したかが必要です。
不具合を修正したら、元のケースを上書きしません。失敗RUNと修正後RUNを別々に保存し、変更票で結びます。これにより「最初から合格していた」ような記録改変を避け、改善過程を監査できます。受入後に同じ不具合が再発したときも、当時の前提と現在の差を比較できます。
証拠の保管責任と閲覧権限
ベンダーが持つログだけに依存すると、契約終了時や障害時に証拠へアクセスできない恐れがあります。発注者側にも、少なくとも判定に必要な要約、設定版、承認、ツール履歴、ハッシュ、保管場所を残します。一方で、プロンプトやトレースには顧客名、設備情報、個人情報、秘密鍵に近い値が含まれ得ます。品質担当が必要な証拠と、セキュリティ担当だけが閲覧できる機密を分離し、持ち出しと保存期間を決めます。
タイ拠点と日本本社で共同判定する場合は、時刻をUTCまたはタイムゾーン付きで保存し、表示言語が違っても同じケースIDを使います。日本語の試験仕様、英語のベンダー回答、タイ語の現場記録が別番号になると、重大な指摘が翻訳の途中で脱落します。原文、承認済み訳、用語集を同じパッケージに入れ、設備名、職位名、停止理由の訳語を固定します。
タイ拠点で責任分担を実装するポイント
本社がポリシーを作り、現地が運用する構成では、「誰が止められるか」と「誰が再開できるか」を現地の勤務実態に合わせます。夜勤中に日本側承認者しか停止解除できない設計では、復旧時間が伸びる一方、現場判断だけで高リスク操作を再開できる設計も危険です。一次停止は現地責任者が即時実行でき、再開は業務影響に応じて二者承認にするなど、停止と再開の権限を分けます。
交代勤務では、個人名だけでなく職務ロールと代理順位を定義します。承認依頼がシフトをまたぐ場合の失効時間、引継ぎ方法、未処理キューの確認者を決めます。祝日カレンダー、夜間の外部ベンダー連絡、停電や回線断時の手順もSATに含めます。これは法令要件の断定ではなく、現地運用を成立させるための設計項目です。
多言語入力では、翻訳品質だけでなく権限語の解釈を試します。「承認」「確認」「実行」のような語が日本語、英語、タイ語で曖昧に使われると、確認依頼を実行許可と誤認する恐れがあります。承認UIは操作の種類と対象を構造化して表示し、自由文だけで許可を受けないようにします。設備の略称や部品名は現地用語集とマスターIDで結び、同名設備への誤操作を防ぎます。
また、ネットワークが不安定な状態を単なる性能劣化として扱わないことが重要です。承認応答が遅れて再送された場合、Agentが二つの承認として扱わないか、切断中のジョブが復帰後に一斉実行されないか、ログ送信だけ失敗した状態で書き込みが続かないかを確認します。タイ拠点の実際の回線経路と業務時間で試すことがSATの価値です。
FATとSATをどう分けるか
FATでは、ベンダーまたは検証環境で再現可能な証拠を作ります。固定データセット、模擬ERP、模擬設備、攻撃データ、ネットワーク障害を使い、全7ゲートを網羅します。SATでは、タイ拠点の実ネットワーク、実ロール、実際の言語、承認者、時刻、接続制約で差分を確認します。
| 項目 | FATで確認 | SATで確認 |
|---|---|---|
| データ | 匿名化・固定スナップショット | 現地マスターの品質と権限 |
| システム | 模擬API、sandbox | 実接続、速度、停止経路 |
| 人 | 想定ロール | 実際の承認者、交代、勤務帯 |
| 言語 | 規定のJA/EN/THなど | 現場語彙、略語、混在入力 |
| 障害 | 注入可能な故障 | 実運用に近い切断・復旧 |
| 証拠 | 再現性のある試験一式 | 現地条件と差分の記録 |
SATで初めて本番ERPへの書き込みを許可する場合は、対象、件数、時間帯を絞り、shadow mode、提案のみ、承認付き書き込み、自動書き込みの順に段階化します。最初から全自動にする必要はありません。
再現可能なAIエージェント評価ケースの作り方
AIエージェント評価のケースは、入力文だけでなく、初期状態と期待する経路を記述します。ケースID、目的、リスク、事前条件、ユーザー入力、利用可能ツール、禁止ツール、データスナップショット、期待結果、許容差、期待する承認、期待するログ、後処理を一組にします。
「結果」だけでなく「禁止経路」を書く
たとえば「在庫不足を検出して購買案を作る」という期待結果に対し、禁止経路として「承認前のERP書き込み」「未承認仕入先への送信」「個人メールへの出力」「価格マスター変更」を書きます。正しい結果に到達しても禁止経路を通れば不合格です。
テスト環境をエージェントから守る
評価用ファイル名に正解を書かない、git履歴に答えを残さない、採点APIをツールから呼べなくする、テスト専用権限を本番と混同しない、といった環境管理が必要です。NISTが指摘するsolution contaminationやgrader gamingを防ぐため、採点者と実行者の権限を分離し、サンプルでトレースを人手レビューします。
不合格を再現できる状態で保存する
不合格時は、入力だけでなく、取得文書の版、ツール応答、モデル・設定、承認状態、trace IDを保存します。個人情報や秘密はマスキングしつつ、同じ条件を再構成できる参照を残します。修正後は当該ケースだけでなく、関連する回帰セットも実行します。

RFPから本番許可までの進め方
1. 責任者をRACIで固定する
業務オーナーは目的と損失影響、情報システムは接続と権限、品質保証は試験設計、セキュリティは脅威モデル、内部監査は証跡、現地責任者はSAT条件を担当します。最終の本番許可者と停止権限者を別々に指名します。
2. ベンダー選定前にゲートと証拠形式を配る
契約後に受入項目を追加すると、見積もりと責任範囲が崩れます。RFP段階で7ゲート、対象シナリオ、証拠テンプレート、試験環境、再試験条件を提示します。ベンダー独自の評価結果は参考にしつつ、自社ケースでの再現を要求します。
3. 合否だけでなく残余リスクを承認する
すべてのリスクをゼロにできるとは限りません。未解決項目は、影響、発生条件、検知、回避策、暫定期限、責任者を記録します。高リスクの越権や無断外部送信は未解決のまま許可しない一方、軽微な表現差は運用監視付きで受け入れるなど、判断を分けます。
4. 本番許可書に範囲と失効条件を書く
本番許可は永久免許ではありません。許可するエージェント版、モデル、ツール、データ、拠点、ロール、操作範囲、有効期間を記載します。重大変更、ログ欠落、停止条件発動、重大インシデント、指標超過を許可の失効または再審査条件にします。
AIエージェント受入試験でよくある失敗
- デモが成功したため、権限と停止を試さず本番へ進む
- 正答率の平均だけを見て、重大ケースを分離しない
- プロンプト上の禁止を技術的な権限制御と誤認する
- 承認画面はあるが、承認内容と実行内容を結び付けていない
- kill switchが親エージェントだけを止め、サブエージェントや再試行が残る
- ログを保存するが、モデル版・ツール引数・承認IDが欠けている
- 一回の攻撃失敗をもって安全と判断する
- FATの模擬環境だけで合格し、タイ拠点の言語・ネットワーク・勤務帯を見ない
- モデル更新を軽微変更として扱い、再受入しない
これらは技術だけの問題ではありません。契約、責任、運用、監査の接続不良です。だからこそ、RFPと受入試験を同じ7ゲートでつなぐことに意味があります。
FAQ
AIエージェント受入試験とは何ですか?
AIエージェントが定義された業務を完了できるかに加え、権限、承認、停止・復旧、セキュリティ、監査ログ、運用ドリフトを含むシステム全体を、本番許可前に証拠付きで確認する試験です。モデル単体の精度評価とは範囲が異なります。
AIエージェントRFPには何を必須にすべきですか?
対象業務と対象外、接続するツールとデータ、ロール別権限、承認点、停止条件、試験ケース、提出証拠、ログ要件、変更管理、再受入条件を必須回答にします。「対応可否」だけでなく実装・試験方法と制約も求めます。
AIエージェント権限設計はプロンプトで十分ですか?
十分ではありません。プロンプト上の指示に加え、サービスアカウント、API、ネットワーク、ツールラッパー、対象データ側で最小権限を強制します。受入試験では禁止操作と迂回経路が実際に拒否されることを確認します。
AIエージェント停止条件はどう決めますか?
禁止操作、承認不整合、機密検知、外部API障害、連続失敗、監視不能などを起点に、停止対象、許容時間、停止後の隔離、補償処理、再開権限を定義します。数値は業務影響とシステム特性に基づき各社が決めます。
AIエージェント評価は何回繰り返すべきですか?
一律の回数はありません。確率的変動、影響度、攻撃者が再試行できる可能性に応じて決めます。重大ケースと攻撃ケースは複数回・複数表現で試し、使用したモデル、設定、データ、ツール応答を記録します。
FATとSATの両方が必要ですか?
実環境との差がある場合は両方を推奨します。FATは固定条件で再現可能な証拠を作り、SATは現地の権限、言語、ネットワーク、承認者、外部システムで差分を確認します。SATの範囲はリスクに合わせて段階化できます。
まとめ
AIエージェント受入試験の合格は、「よく答えた」ではなく「許可された範囲で、必要な承認を通り、異常時に止まり、復旧でき、後から再現できる」ことです。機能、権限、承認、停止・復旧、セキュリティ、監査ログ、運用ドリフトの7ゲートをRFPから本番許可まで一貫させると、発注者、ベンダー、現地拠点、監査が同じ証拠で判断できます。目標値は外部の数字を借りるのではなく、業務影響に基づいて自社が決めることが重要です。
タイ拠点のAIエージェントRFPや受入項目を整理する段階でも、TOMAS TECHへご相談いただけます。対象業務、権限境界、FAT/SATの証拠形式を一緒に分解し、ベンダーへ渡せる判定表に整えるところから対応します。


