


マニュアル検索AI 2026|精度より出典を返す設計が事故を防ぐ
設備が止まったとき、担当者が最初にやることは思い出すことではなく探すことです。マニュアル 検索 AIという言葉が現場で急に現実味を帯びてきたのは、この「探す」に費やされている時間が、誰の目にも見える形で残っていないからです。探している間、設備は止まったままです。それでも探索時間の削減を目的に据えると、この投資はたいてい期待を下回ります。
設備マニュアルの検索が、社内規程やFAQの検索と決定的に違う点があります。誤った答えが返ったときの行き先です。規程の検索でAIが古い条文を返しても、担当者が気づいて訂正すれば済みます。しかし締付トルクや停止手順を旧版のまま返せば、設備が壊れるか、人が怪我をします。だから設計の第一問は「どれだけ賢く答えるか」ではありません。
本記事の立場ははっきりしています。設備マニュアルの検索AIで決まるのは検索精度ではなく、答えに出典を必ず添えて返せるかどうかです。 出典とは、その答えが①どの機種・シリアルの、②どの版の、③何ページの記述に基づいているか、そして④その原本が何語で書かれているかの4点です。以下ではこれを出典4点セットと呼び、記事全体の背骨に置きます。タイやベトナムの日系工場では、この4点目が固有の壁になります。
マニュアル検索AIとは|一般のナレッジ検索AIと何が違うのか
マニュアル検索AIとは、設備の取扱説明書、保全マニュアル、トラブルシューティング手順書といった技術文書を対象に、自然文の質問から該当箇所を探し出して答えを組み立てる仕組みのことです。技術的にはナレッジ検索AIの一種で、社内文書を検索してから生成モデルに答えさせる構成をとります。しかし対象文書の性格が違うため、設計上の要求は一般の社内ナレッジ検索とかなり違います。
違いは3つあります。第一に、答えが安全と品質に直結します。 利用規程の検索で条文を1つ取り違えても、影響は手続きの遅れにとどまります。保全手順の検索で1つ取り違えると、残圧の残った配管を開けることになります。第二に、答えが切り替わる軸が違います。 社内規程は日付で答えが変わります。設備マニュアルは型番・機種・シリアル番号で答えが変わります。同じ質問文でも、対象が3号機か5号機かで正解が入れ替わります。第三に、原本が社外で作られています。 規程は自社が書いたので自社の言語です。設備マニュアルは装置メーカーが書いたもので、日系工場では日本語で書かれていることが珍しくありません。
社内規程やFAQのように日付で答えが切り替わる問いをどう扱うかは、社内問い合わせ自動化の記事で別に整理しています。本記事はそちらとは切り分け、型番とシリアルで答えが切り替わる検索に絞ります。
エレベーター大手のKONEがAWS上に構築した技術者向けアシスタントは、この分野の代表例として参照できます。検索対象はユーザーマニュアル、過去の保守レポート、接続機器のIoTデータです。背景にあったのは技術ヘルプデスクの待ち時間と、経験豊富な技術者の不足でした。100人・3か月のパイロットを経て11か国・約1,500人の規模まで広がり、数か月のうちに約6,000人、最終的には40,000人の技術者全員への展開を目指すとされています。事例として重要なのは規模ではなく、対象文書の並びです。マニュアルだけでなく過去の保守レポートが最初から入っています。
現場で起きているのは「探せない」ではなく「読めない・古い・当たらない」
導入検討の入り口で「マニュアルが探せない」と言われることが多いのですが、掘り下げると現象は3つに分かれます。それぞれ打ち手が違うので、混ぜたまま要件にすると外します。
| 現象 | 具体的な状態 | 検索AIで解けるか |
|---|---|---|
| 読めない | 原本が日本語で、現地スタッフが内容を判断できない | 部分的に解ける。答えは現地語で返せるが、原本の検証は別の手当てが要る |
| 古い | 手元のPDFが旧版で、改訂版が別のフォルダにある | 検索だけでは解けない。版管理の仕組みが要る |
| 当たらない | 文書はあるが、目次の語彙と現場の言い方が違う | 解ける。ここがセマンティック検索の本来の守備範囲 |
補足として、文書があること自体は技能の引き継ぎを保証しません。労働政策研究・研修機構(JILPT)が2020年2月3日に公表した調査シリーズNo.194では、従業員30人以上の製造業を層化無作為抽出して2万社に郵送した結果として、技能継承が「うまくいっている」「ややうまくいっている」と答えた企業は45.0%にとどまり、将来の技能継承に不安を感じる企業は約8割に達しています。この調査は暗黙知を含む技能全般を扱ったものですが、本記事が扱うのはその手前、すでに文書になっている形式知が引けないという状態です。文書化まで終わっているのに使われていないなら、原因は書き手ではなく引き方の側にあります。
3つ目の「当たらない」は、いちばん検索AIらしい課題です。文書番号を覚えていなくても「充填機の詰まりの直し方」のような現場の言い方で該当の手順に到達できる、というのが製造業向け文書管理製品が挙げる典型的な効能です。ここは素直に効きます。
問題は1つ目と2つ目です。ここを検索の精度改善で解こうとすると、いくら埋め込みモデルを変えても改善しません。読めない問題は表示側の設計で、古い問題は文書のライフサイクル管理で解く話だからです。逆に言えば、この2つを最初から要件に入れておけば、投資の説明はずっとしやすくなります。
情報検索は77.0%、ナレッジ管理は26.3%|使ってはいるが仕組みになっていない
IPA(情報処理推進機構)が2026年7月16日に公表したDX動向調査のポイントには、この状況を裏づける数字が並んでいます。2025年度調査は2026年4月から6月にかけて国内企業を対象に実施されたものです。
AIを導入している企業は全体で42.3%でした。従業員1,001人以上では78.3%、100人以下では16.6%と、規模による差が大きく出ています。効果については「期待以上の効果があった」13.7%と「期待どおりの効果であった」18.1%の合計が31.8%にとどまり、最も多い回答は「一定の効果はあった」の50.6%でした。効果の内容では「業務が効率化したり迅速化した」が91.6%で突出しています。つまり、導入は広がっているが効果は業務効率化に寄っている、という構図です。
本記事にとって重要なのは利用用途の内訳です。以下はAIを導入・利用している企業を母数にした割合であることに注意してください。最も多いのは「文書・音声の要約・翻訳・校正」82.5%、次いで「文書・レポートの作成(社内・社外)」80.5%、「情報検索・収集・分析・レポーティング」77.0%と続きます。一方で「ナレッジ管理・共有」は26.3%です。
| 用途 | 割合 |
|---|---|
| 文書・音声の要約・翻訳・校正 | 82.5% |
| 文書・レポートの作成(社内・社外) | 80.5% |
| 情報検索・収集・分析・レポーティング | 77.0% |
| ナレッジ管理・共有 | 26.3% |
77.0%と26.3%の差が、この記事の出発点です。AIを使っている企業のうち、情報を探す用途で使っているのは4社に3社ある一方、ナレッジを管理・共有する用途まで持っているのは4社に1社しかありません。前者は個人が手元で使っている状態で、後者は組織の資産として運用している状態です。設備マニュアルの検索は、個人が手元で使う段階にとどめると危険な領域です。誰が何を根拠に判断したかが残らないからです。
なお、装置を作る側の動きも同じ方向を向いています。IoT Analyticsが機械メーカーの意思決定者120名に行った調査では、96%が何らかの段階でAIの実装に入っており、55%が特定のユースケースをスケール展開、41%がPoC段階、4%が計画段階でした。障壁の上位は「AIの費用が高い」54%、「データ基盤が不十分」43%、「人材のスキルギャップ」43%です。機械サービスの分野では遠隔診断48%、サービスワークフローの自動化43%、AIを使った拡張現実ツール30%という採用率が示されています。ただしこの調査の回答者は機械を作るメーカー側であって、タイの工場ユーザーの数値ではありません。装置メーカー側が診断とサービスの自動化に投資しているという背景として読むのが妥当です。
技術文書検索AIの出典4点セット|機種・版・ページ・原本言語
ここから設計の話に入ります。技術文書 検索 AIに求めるべき出力は、答えの文章だけではありません。答えと一緒に次の4点が返ってくる状態を仕様にします。
| 出典の要素 | 何を返すか | 返せないと何が起きるか |
|---|---|---|
| 機種・シリアル | 適用機種名と、適用されるシリアル番号の範囲 | 同じ型式の別ロットの手順を実行してしまう |
| 版 | 版番号と発効日、それが現行版であること | 旧版の締付値や停止手順を実行してしまう |
| ページ | 文書内の章とページ、可能なら該当段落 | 検証に時間がかかり、結局は誰も検証しなくなる |
| 原本言語 | 根拠にした原本が何語で書かれているか | 現地スタッフが原本に当たれず、答えを鵜呑みにする |

株式会社エムニは2026年3月11日公開の解説記事で、生成AIをマニュアルに使う際の課題として、ハルシネーションと機密情報の流出を挙げています。ハルシネーションは「事実に基づかない情報をさも正しいかのように出力する」現象で、現場では重大事故につながりうるものとされます。対策として同記事が挙げているのは、AIが参照する資料を制限すること、そして回答の根拠となったマニュアルのページを必ず明示させることです。もう一方の機密情報の流出は、クラウド型のAIサービスに無防備にデータを投入すると学習データとして再利用され競合他社に流出しうる、という論点で、オンプレミス環境や秘匿性の高いエンタープライズ向けクラウドの利用と社内運用ルールの策定が対策として挙げられています。
出典4点セットは、この「ページを必ず明示させる」を工場の実態に合わせて拡張したものです。ページだけでは足りません。ページ番号は文書が特定できて初めて意味を持ち、文書は機種と版が特定できて初めて特定できるからです。
版管理を外すと、正しく検索できたぶんだけ事故が近づく
版管理は、検索AIの周辺機能ではなく前提条件です。理由は単純で、検索の精度が上がるほど旧版がヒットする確率も上がるからです。索引に旧版と現行版の両方が入っていれば、意味的に近い旧版のほうが上位に来る場面は必ず出ます。精度改善は事故確率の低減にならず、むしろ「もっともらしい旧版の手順」を引き当てる力を高めます。
製造業向けの文書管理製品が実装している版管理のパターンは参考になります。ベンダーの製品説明という性格は割り引いて読む必要がありますが、要求仕様の書き方としては具体的です。新版が承認され発効日を迎えた瞬間に、旧版はタブレット、作業画面、モバイル端末、QRコードリンクを含むすべてのアクセスポイントで自動的に置き換わります。旧版は監査証跡として保存されますが、現場からは一切参照できません。承認の流れは作成者・レビュアー・承認者の連鎖として構成され、電子署名が付きます。周知は読んだことの確認までを含み、対象者全員が電子署名とタイムスタンプ付きで確認するまでリマインダーが自動で飛びます。加えてAIが、レビュー期限が近い手順書、廃止された設備や生産中止材料に言及する文書、失効した規格を引用する手順を自動で指摘します。
ここから実装として引き受けるべき点を3つに絞ります。
- 旧版は消さずに隔離する。 監査対応と過去トラブルの追跡に必要なので削除はできません。しかし現場の検索経路からは完全に外します。同じ索引に置いて「現行版を優先する」重み付けで済ませると、いつか順位が入れ替わります。
- 置き換えは全アクセスポイントで同時に起こす。 タブレットの表示だけ更新して、印刷済みの冊子やローカルに落としたPDFが残っていれば、版管理は成立していません。現場に紙が残る前提なら、紙の回収手順まで含めて設計します。
- 発効日を持たせる。 承認済みだがまだ発効していない版が現行版として返ると、これも事故になります。承認日と発効日は別の属性です。
図面の版管理については図面検索AIの記事で扱っています。対象がCAD図面か文章のマニュアルかで、版の付き方も改訂の粒度も違うので、両方を抱えている場合は分けて設計してください。
機種とシリアル番号への紐付け|同じ型式でも仕様が違う
版の次に効くのが機種とシリアルの紐付けです。ここが技術的な核心にあたります。
現場の質問は「3号機のエラーコードが出たときの手順は」という形をしています。文書側が「型式名」までしか属性を持っていないと、検索は型式名が一致する文書までしか絞れません。ところが同じ型式でも、製造ロットやオプション構成で仕様が違うことがあります。制御盤の更新、安全リレーの追加、搬送部のメーカー変更といった差が、手順の一部だけを変えます。この差は文書全体の差ではなく、章単位・段落単位の差として現れるので、文書を1つ選んだだけでは足りません。
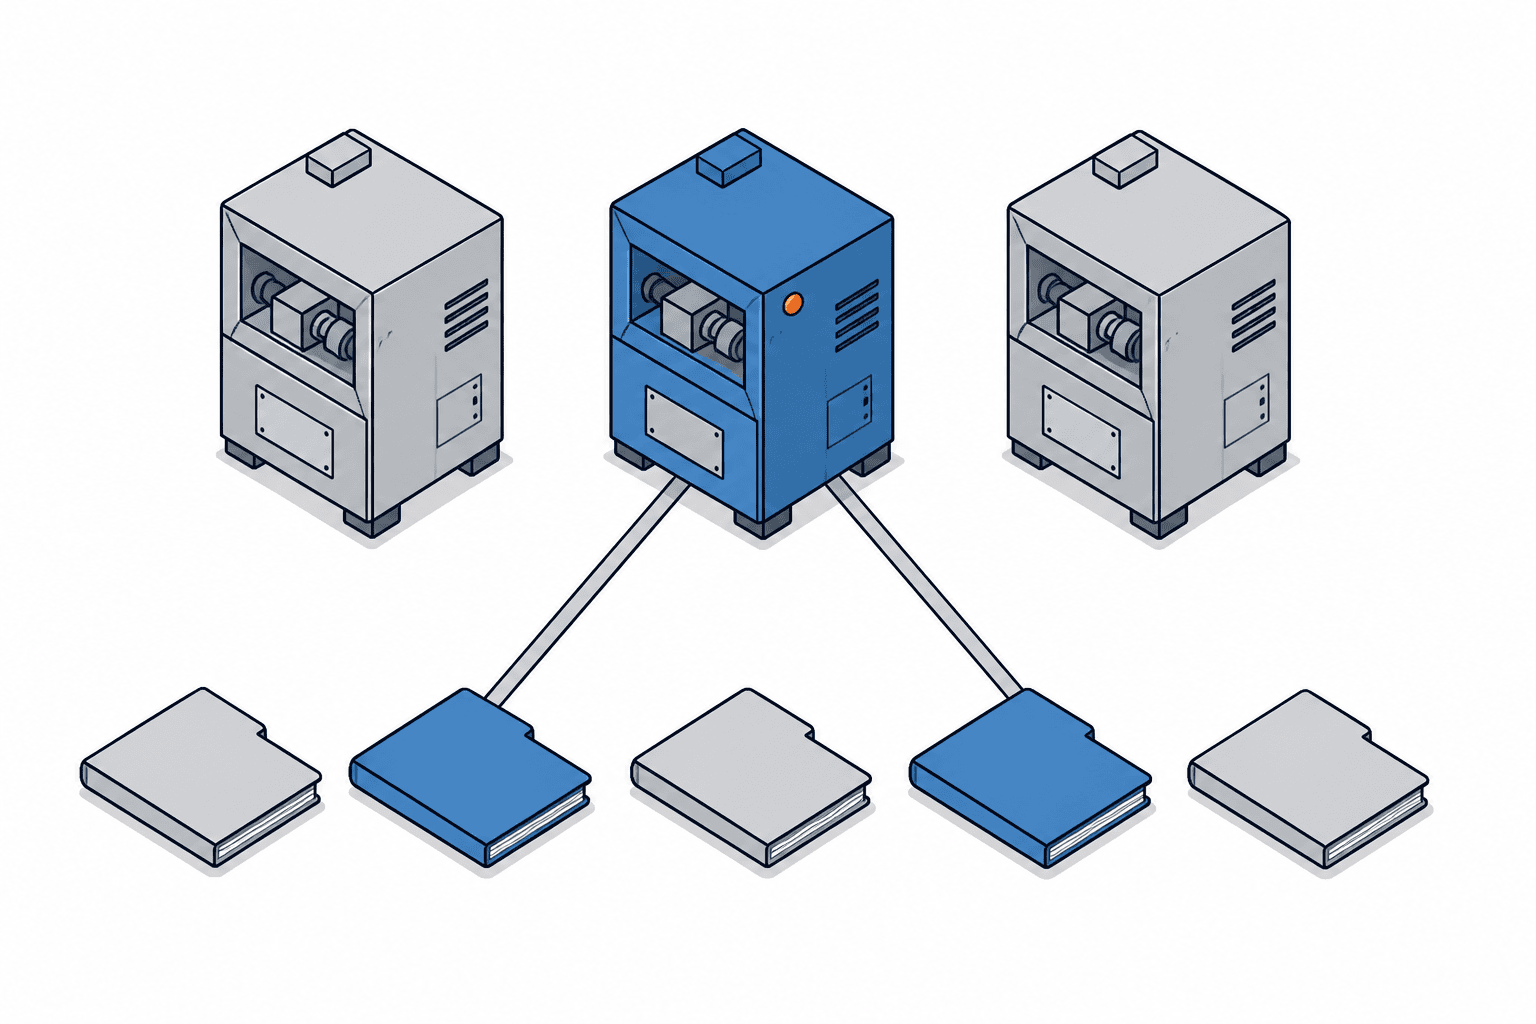
紐付けの実装は、文書側と質問側の両方に属性を持たせることで成立します。
| 側 | 持たせる属性 | 補足 |
|---|---|---|
| 文書側 | 適用機種、適用シリアル範囲、版番号、発効日、章 | 装置メーカーの原本は範囲指定で書かれていることが多く、そのまま属性化できる |
| 質問側 | 設備番号(社内呼称)、機種、シリアル番号 | 現場は社内呼称で呼ぶので、社内呼称から機種とシリアルへ引ける台帳が要る |
この台帳が無い工場は多く、実際には設備台帳の整備が最初の作業になります。設備が3台あり、関係する文書が5冊あるとき、どの設備がどの文書のどの版に対応するかを1行ずつ書き出すと、たいてい不明な組み合わせが出てきます。その不明を潰す作業は検索AIの外側にありますが、これを飛ばすと検索は「型式が同じ文書の束」を返すだけの仕組みになります。
現場でよくある聞かれ方への対処も決めておきます。設備番号を言わずに「あの充填機」と聞かれたら、システムは答える前に対象設備を確認する必要があります。ここで確認を挟まずに最頻の設備で答えると、出典4点セットの1点目が実質的に崩れます。
多言語マニュアル検索の壁|原本が日本語だと出典を検証できない
タイやベトナムの日系工場に固有の論点です。設備マニュアルの原本の多くは日本語です。装置を日本から持ち込んだ場合はもちろん、現地調達の装置でも、社内で作り直した保全手順書は日本語で書かれていることがあります。読む側はタイ語話者・ベトナム語話者です。
答えを現地語で返すこと自体は難しくありません。難しいのはその先です。出典4点セットの狙いは「読者が根拠に当たれること」でした。ところが根拠が日本語の原本なら、現地スタッフはページを開いても検証できません。出典を出しているのに検証できないという状態は、出典が無い状態より危険です。読者は「出典が付いているから正しいのだろう」と考えるからです。
したがって現地拠点では、答えの言語と原本の言語を分けて設計します。実装として現実的なのは次の組み合わせです。
- 回答は現地語で返し、その下に根拠にした原本の該当ページを画像として貼る。図や記号は言語に依存しないので、現地スタッフでも図を見て手順の対象を確認できます。
- 原本の該当ページに対して、見出しと要点だけを現地語で対訳として付ける。全文翻訳ではなく、その章の見出し・警告表示・数値の単位に限定します。範囲を絞れば維持できます。
- 数値と型式名は翻訳させない。 締付トルク、電圧、型式、部品番号は原本の表記のまま出します。翻訳の過程で桁や単位が変わる事故を避けるためです。
多言語のRAGをどう組むか、翻訳をどの層で行うかという設計論はRAG構築の記事で扱っています。本記事はその応用として、検索して当てる場面に絞っています。
もう1つ現地固有の注意点があります。日本人駐在員は3年から5年程度で交代することが多いものです。日本語で書かれた保全手順書に「前任者が口頭で補った前提」が含まれている場合、その前提は文書に無いので検索AIも拾えません。この種の問題は形式知の検索では解けないので、技能伝承AIの記事で扱っている暗黙知の側の打ち手と組み合わせる必要があります。本記事が扱うのは「書いてあるのに当たらない」側だけです。
ハルシネーション耐性の設計|「答えない」を実装する
安全に直結する領域では、正答率を上げる努力と同じくらい、答えない条件を決めておくことが効きます。設計項目として明示的に仕様へ書きます。
| 条件 | システムの振る舞い |
|---|---|
| 該当文書が特定できない | 答えを生成せず、対象設備の確認を返す |
| 機種は特定できたが版が確定しない | 答えを生成せず、版の確認を返す |
| 検索結果の類似度が閾値に届かない | 答えを生成せず、該当なしと候補文書名を返す |
| 質問が停止手順・活線作業・圧力開放に該当する | 答えと同時に、現物の原本での確認を必須と表示する |
生成モデルは「わからない」と言うのが不得意です。何かしら文章を作る方向に寄るので、答えない条件はモデルの外側で判定します。検索側で候補が取れなかった時点で生成に進ませない、という単純な制御で大半は防げます。参照させる資料の範囲を制限することも、エムニの記事が挙げているとおり有効な対策です。
もう1つ、運用側の設計として、回答の履歴を残します。 誰が何を聞き、どの文書のどの版が根拠として返されたかを記録します。事故が起きたときに経路をたどれるようにするためであり、同時に、どの質問が繰り返されているかを見て文書側を直すためでもあります。同じ質問が月に何度も来るなら、それは検索の問題ではなく文書の書き方の問題です。
トラブルシューティングAIへの発展|ヒヤリハットと過去トラブル記録を足す
マニュアルだけを対象にすると、答えられる範囲は「メーカーが想定した故障」に限られます。実際の現場で頻度が高いのは、メーカーが想定していない組み合わせです。だからヒヤリハット報告、過去のトラブル記録、修理伝票、日報のコメント欄といった非構造化データを検索対象に足すと、トラブルシューティング AIとしての価値は明確に上がります。先ほどのKONEの例でも、検索対象は最初からユーザーマニュアルと過去の保守レポートの両方でした。
ただし扱いを分ける必要があります。マニュアルは装置メーカーが承認した正本です。トラブル記録は現場の観察であって、承認されたものではありません。同じ索引に混ぜて同じ体裁で返すと、観察が手順として読まれます。「前回は叩いたら直った」が手順書と並んで表示されれば、それは手順になってしまいます。

作れる範囲として現実的なのは、回答面で層を分けることです。
- 上のブロックに承認済みの正本からの根拠を置き、出典4点セットを付ける。
- 下のブロックに参考情報として過去の記録を置き、記録日・記録者・対象設備を付けて、承認されていない観察であることを明示する。
- 両者を1つの文章に統合させない。統合させると出典の性格が混ざります。
この分離を最初に決めておけば、過去記録の追加は文書を増やすだけの作業になります。逆に、統合した回答を作ってしまってから分離しようとすると、回答の設計からやり直しになります。過大な期待を持たせないためにも、記録から「原因」を推定させる機能は最初の範囲に入れないほうが無難です。記録は原因ではなく、そのとき何をしたかの記述だからです。
保全マニュアルのデジタル化はどこまでやるか|対象文書の絞り方
保全マニュアル デジタル化という言葉は、紙をPDFにすることから、章を分割してメタデータを付けることまで、幅の広い作業を指します。費用の主役はここです。エムニの記事も、紙やPDFのまま放置されたマニュアルをAIが読み取りやすい形式に変換したうえで、社内の最新マニュアルのみを根拠に回答する仕組みを作るのが一般的だと書いています。
全部をやろうとすると終わりません。対象の絞り方を決めます。
| 判断軸 | 優先して電子化する | 後回しにする |
|---|---|---|
| 停止影響 | 止まると生産が止まるボトルネック設備 | 予備機のある設備 |
| 質問頻度 | 過去1年で問い合わせが多かった設備 | 問い合わせ実績が無い設備 |
| 文書の状態 | すでにPDFがあり、目次が付いている | 紙しか無く、手書き追記が多い |
| 安全区分 | 停止手順・圧力開放・活線作業を含む章 | 清掃・外観点検のみの章 |
実務では、この4軸で上位に来た設備の文書から着手します。全設備のマニュアルを一度に投入しようとすると、属性を付ける作業量に潰されます。対象を「新人がよく聞く30問」のように絞れば、同じ期間で出典まで含めて仕上げられます。範囲を絞ることは妥協ではなく、出典4点セットを最初から全部そろえるための条件です。属性を付ける作業は文書1冊ごとに発生するので、冊数を絞らないと属性の品質が落ちます。
対象文書の種類による切り分けも決めておきます。CAD図面は図面検索AIの記事で扱う領域で、表題欄のOCRや図番の体系という別の技術要素が要ります。本記事が対象にしているのは、文章と表と図が混在した取扱説明書・保全マニュアル・トラブルシューティング手順書です。
導入の進め方|90日で30の質問に答えられる状態を作る
エムニの記事は導入を4段階のロードマップとして整理しています。①課題の棚卸しと優先順位の決定、②ナレッジのデジタル化とRAGの構築、③現場主導の評価と運用、④全社展開と継続的な改善です。この骨格に、本記事の論点を差し込んだ90日の進め方を示します。
| 期間 | やること | 完了の判定 |
|---|---|---|
| 1日目から20日目 | 質問の棚卸し。過去1年の問い合わせから頻出30問を抽出し、対象設備を確定する | 30問それぞれについて、答えが載っている文書と版が特定できている |
| 21日目から45日目 | 設備台帳の整備。社内呼称、機種、シリアルの対応表を作る | 対象設備すべてで社内呼称から機種・シリアルが引ける |
| 46日目から70日目 | 電子化とメタデータ付与、検索基盤の構築、出典返却の実装 | 30問すべてに出典4点セット付きで答えが返る |
| 71日目から90日目 | 現場評価。保全担当が実際に使い、答えない条件が正しく効くかを確認する | 誤答ゼロではなく、誤答したときに出典から即座に気づける状態 |
最後の判定基準が重要です。誤答をゼロにすることを完了条件にすると、いつまでも展開できません。出典が付いていれば、担当者は答えの妥当性を自分で確認できます。目指すのは「間違えないシステム」ではなく「間違いに気づけるシステム」です。
費用と効果をモデル工場で試算する
社内ナレッジ 活用 AIの投資判断は、モデルを置かないと議論が抽象論になります。ここでは次の前提でモデル工場を置きます。数値はすべてタイバーツ(THB)のまま扱い、他通貨に換算しません。
- 所在はタイ・チョンブリ県、日系自動車部品メーカー、従業員420名
- 設備保全担当14名、保全担当の時間単価260 THB
- 日本人駐在エンジニア(設備担当)の時間単価900 THB
- 保全担当1人がマニュアルや過去記録を探す時間は1日36分、稼働は月20日
- 駐在エンジニアへの技術エスカレーションは月24件、1件あたり両者の中断は50分
- 旧版の手順を参照したことによる手戻りは年6件、1件あたり18,000 THB
年間の効果は3本に分けます。
| 効果 | 現状の年間コスト | 削減率 | 年間効果 |
|---|---|---|---|
| A 探索時間の削減 | 524,160 THB | 45% | 235,872 THB |
| B 駐在エンジニアへのエスカレーション削減 | 216,000 THB | 40% | 86,400 THB |
| C 旧版参照による手戻りの削減 | 108,000 THB | 60% | 64,800 THB |
| 合計 | — | — | 387,072 THB |
効果Aは、1日36分を月20日で12時間、14名で年524,160 THB相当という計算です。効果Bは月24件・50分で月20時間、年216,000 THB相当です。効果Cは年6件・1件18,000 THBで年108,000 THBです。
初期費用は4層に分けます。ここで重要なのは、どの層にも対応する効果があることです。効果の乗っていない層は読者に削られ、削った瞬間に結論が変わります。
| 初期費用の層 | 金額 | 対応する効果 |
|---|---|---|
| 第1層 文書の電子化と前処理(PDF化、OCR、章分割、メタデータ付与) | 480,000 THB | 効果Aの前提。索引できなければ何も返らない |
| 第2層 検索基盤と出典返却の実装 | 320,000 THB | 効果A |
| 第3層 機種・シリアル台帳との紐付けと版管理 | 260,000 THB | 効果C |
| 第4層 現場UI(多言語表示、出典リンク)と権限設計 | 190,000 THB | 効果B |
| 合計 | 1,250,000 THB | — |
年間の運用費は168,000 THBとします。クラウド利用料、モデルの利用料、版の更新にかかる運用工数です。
年間純便益は387,072 THBから168,000 THBを引いて219,072 THBです。初期費用1,250,000 THBを割ると、回収期間は5.71年になります。
ここで読者が必ず考えることを先回りします。第3層の260,000 THBを削れば初期費用は990,000 THBになり、回収が早まるように見えます。しかし第3層は効果Cを生む層なので、削れば効果Cの64,800 THBが消えます。年間純便益は154,272 THBになり、回収期間は6.42年です。安くすると遅くなります。 同様に第4層190,000 THBを削ると、現地語で読めないので現地スタッフは使わず、駐在エンジニアへの電話は減りません。効果Bの86,400 THBが消え、初期費用1,060,000 THBに対して年間純便益132,672 THB、回収は7.99年に伸びます。
この構造は、費用の全体像を扱ったRAG構築の記事でも同じ形で出てきます。検索基盤そのものより、権限設計や既存システムとの連携に費用が乗るという点は共通です。本記事のモデルでも、純粋な検索基盤は第2層の320,000 THBだけで、総額の4分の1程度です。
感応度分析|利用定着率が落ちたときどこまで持つか
回収5.71年という数字は、現場が実際に使うことを前提にしています。前提が崩れたときにどうなるかを見ます。係数として置くのは現場スタッフの利用定着率です。
ここで注意が要ります。この係数は効果Aと効果Bにはかかりますが、効果Cにはかかりません。 効果Cは、旧版を現場のアクセス経路から外す仕組みそのものが生む効果だからです。旧版が引けなくなっていれば、検索AIを使っているかどうかに関係なく、旧版の手順を参照する事故は減ります。係数を全効果に一律で掛けると、この違いが消えて結論が過度に悪く出ます。
| 利用定着率 | 効果A | 効果B | 効果C | 年間純便益 | 回収期間 |
|---|---|---|---|---|---|
| 100% | 235,872 THB | 86,400 THB | 64,800 THB | 219,072 THB | 5.71年 |
| 70% | 165,110 THB | 60,480 THB | 64,800 THB | 122,390 THB | 10.21年 |
| 50% | 117,936 THB | 43,200 THB | 64,800 THB | 57,936 THB | 21.58年 |
定着率70%で回収は10.21年、50%まで落ちると21.58年です。この幅の広さが示しているのは、投資判断の分かれ目が技術ではなく運用にあることです。IPAの調査で「期待以上」と「期待どおり」の合計が31.8%にとどまり、「一定の効果はあった」が50.6%を占めているのも、同じ構造の反映と読めます。導入はできるが、期待した水準まで使われるかは別問題ということです。
定着率を上げる打ち手は、現場UIと答えない条件の設計に集中します。答えが現地語で返り、出典が付き、わからないときは正直にわからないと返る。この3つが満たされていれば、担当者は使い続けます。逆に、もっともらしい答えが返って1回外すと、その担当者は二度と使いません。
よくある失敗パターン
実際に起きやすい失敗を、原因の側から整理します。
第一に、探索時間の削減だけで稟議を書くパターンです。本記事のモデルでも、効果Aの235,872 THBだけでは年間運用費168,000 THBを引いた残りが67,872 THBにしかならず、初期費用1,250,000 THBの回収は現実的な年数に収まりません。効果Bと効果Cを合わせて初めて成立します。効果Bと効果Cは、多言語表示と版管理という具体的な機能に紐づいているので、機能を削れば効果も消えます。
第二に、全マニュアルを一度に投入するパターンです。属性を付ける作業は文書1冊ごとに発生します。冊数を増やすほど属性の品質が落ち、属性が落ちると出典4点セットが返せなくなり、結局は検証できない答えを返す仕組みになります。頻出30問から始めるのは妥協ではなく設計です。
第三に、版管理を後回しにするパターンです。「まず検索を作って、版管理はあとで」と進めると、旧版を含んだ索引で現場評価をすることになります。評価の期間に旧版がヒットすれば、その時点で現場の信用は失われます。順序としては、版を確定してから索引を作ります。
第四に、答えを日本語のまま返すパターンです。日本人管理職が試すぶんには問題なく動くので、テストは通ります。現地スタッフに渡した瞬間に使われなくなり、駐在エンジニアへの問い合わせは減りません。効果Bが丸ごと消えるので、回収は7.99年まで伸びます。
第五に、過去のトラブル記録をマニュアルと同じ体裁で返すパターンです。承認された手順と現場の観察が同じ見た目で並ぶと、観察が手順として実行されます。混ぜてから分けるのは難しいので、最初から回答面で層を分けます。
まとめ|買うのは検索精度ではなく出典の確からしさ
本記事の主張を整理します。設備マニュアルの検索AIで決まるのは検索精度ではなく、答えに出典を必ず添えて返せるかどうかです。出典とは、機種・シリアル、版、ページ、原本言語の4点です。この4点が返る仕組みは、単なる検索の精度改善では作れません。設備台帳の整備と版管理の実装が前提になります。
版管理を外すと、検索精度が上がるほど旧版を引き当てる力も上がります。旧版は監査証跡として保存しつつ、現場のアクセス経路からは完全に外し、置き換えは発効日に全アクセスポイントで同時に起こします。機種とシリアルの紐付けは、文書側に適用機種と適用シリアル範囲を、質問側に社内呼称から引ける機種とシリアルを持たせて成立します。
タイやベトナムの拠点では、原本が日本語であるという条件が加わります。答えを現地語で返すだけでは足りず、原本の該当ページを画像で示し、見出しと警告表示だけを現地語で補い、数値と型式は原本の表記のまま出す設計が要ります。出典を出しても読者が検証できない状態は、出典が無い状態より危険です。
費用の面では、モデル工場の試算で初期1,250,000 THB、年間運用168,000 THBに対して年間効果387,072 THB、回収5.71年でした。ただしこの数字は、4つの費用層がすべて残っている場合のものです。版管理の層を削れば6.42年、多言語表示の層を削れば7.99年に伸びます。安くすると遅くなる構造なので、削る対象を探すより、対象文書を絞って初期費用そのものを小さくするほうが理にかないます。そして利用定着率が50%まで落ちれば回収は21.58年です。技術ではなく運用が投資判断を決めます。
設備マニュアルの検索を検討している方へ
どの文書から載せるべきか決めきれていない、マニュアルがPDFと紙で散らばっていて全体量が把握できていない、設備台帳と文書の対応が取れていない。この段階でのご相談も歓迎しています。TOMAS TECHはバンコクを拠点に、タイおよびASEANの日系製造業向けに、生産管理システムから工場の情報基盤づくりまでを扱っています。現状の文書と設備の対応を伺いながら、どこから手を付けると出典が返せる状態に近づくかの整理からお手伝いできます。ご相談はお問い合わせフォームからお願いします。
よくある質問(FAQ)
マニュアル検索AIとは何か?
設備の取扱説明書、保全マニュアル、トラブルシューティング手順書といった技術文書を対象に、自然文の質問から該当箇所を探し出し、答えを組み立てて返す仕組みのことです。技術的にはナレッジ検索AIの一種ですが、設備マニュアルを対象にする場合は要求が変わります。答えが安全と品質に直結すること、答えが切り替わる軸が日付ではなく型番・機種・シリアル番号であること、原本を装置メーカーが書いているため自社の言語とは限らないことの3点です。したがって、答えの文章だけを返す実装では足りず、機種・シリアル、版、ページ、原本言語という出典4点セットを一緒に返す設計が必要になります。
マニュアル検索AIの導入費用はどれくらいか?
本記事のモデル工場(タイ・チョンブリ県、従業員420名、保全担当14名)では、初期費用を4層に分けて合計1,250,000 THB、年間の運用費を168,000 THBと置きました。内訳は、文書の電子化と前処理が480,000 THB、検索基盤と出典返却の実装が320,000 THB、機種・シリアル台帳との紐付けと版管理が260,000 THB、現場UIと権限設計が190,000 THBです。費用の主役は検索基盤ではなく、文書の電子化と前処理である点に注意してください。実際の金額は対象文書の冊数、紙の比率、既存の設備台帳の整備度合いで大きく動きます。対象を頻出30問に絞れば、初期費用そのものを小さくできます。
ナレッジ検索AIが誤った手順を答えるのを防ぐにはどうするか?
3つを組み合わせます。第一に、参照させる資料の範囲を制限することです。索引に入れる文書を絞り、旧版を現場の検索経路から外します。第二に、回答の根拠となったページを必ず明示させることです。これは製造業向けの生成AI活用の解説でも対策として挙げられています。第三に、答えない条件を実装することです。該当文書が特定できないとき、版が確定しないとき、検索結果の類似度が閾値に届かないときは、答えを生成せずに確認を返します。生成モデルは「わからない」と言うのが不得意なので、この判定はモデルの外側で行います。目指すのは間違えないシステムではなく、間違いに気づけるシステムです。
保全マニュアルのデジタル化はどこから始めればよいか?
停止影響、質問頻度、文書の状態、安全区分の4軸で対象を絞ります。止まると生産が止まるボトルネック設備、過去1年で問い合わせが多かった設備、すでにPDFがあり目次が付いている文書、停止手順や圧力開放や活線作業を含む章が優先です。全設備のマニュアルを一度に投入すると、属性を付ける作業の量に潰されます。属性の品質が落ちると出典が返せなくなり、検証できない答えを返す仕組みになってしまいます。過去の問い合わせから頻出30問を抽出し、その30問に出典付きで答えられる状態を最初のゴールに置くのが現実的です。
多言語のマニュアル検索はどこまで実現できるか?
答えを現地語で返すところまでは問題なく実現できます。難しいのはその先で、原本が日本語のままだと現地スタッフは根拠を検証できません。現実的な実装は、回答を現地語で返したうえで根拠にした原本の該当ページを画像として貼り、そのページの見出しと警告表示だけを現地語で補うという組み合わせです。全文翻訳ではなく範囲を絞るので維持できます。数値、単位、型式、部品番号は翻訳させず原本の表記のまま出します。翻訳の過程で桁や単位が変わる事故を避けるためです。なお、日本語の手順書に「前任者が口頭で補った前提」が含まれている場合、その前提は文書に無いので検索では拾えません。これは形式知の検索の外側にある問題です。
参考情報
1. IPA「DX動向調査」2025年度調査のポイント(2026年7月16日公表)
AI導入率42.3%、利用用途の内訳(情報検索77.0%、ナレッジ管理・共有26.3%)、効果の状況(期待以上と期待どおりの合計31.8%)の出典です。
2. IPA「DX動向調査」ページ
調査全体の位置づけと、過去年度のデータ集はこちらから確認できます。
3. エムニ「製造業のマニュアルへの生成AI活用ガイド|2026年の最新事例」(2026年3月11日公開)
ハルシネーションと機密情報流出という2つのリスク、回答の根拠となったマニュアルのページを明示させる対策、導入4段階のロードマップの出典です。
4. AWS「KONE case study」
ユーザーマニュアル・過去の保守レポート・IoTデータを対象にした技術者向け生成AIアシスタントの事例。パイロット100人・3か月、11か国・約1,500人、目標6,000人および40,000人という規模の出典です。
5. IoT Analytics「AI in machine building 2026」
機械メーカーの意思決定者120名への調査。AI実装率96%、障壁の順位、機械サービス分野のユースケース採用率の出典です。回答者は機械を作る側であり、工場ユーザーの数値ではありません。
6. iFactory「AI Document Management for Manufacturing Plants」
版管理の実装パターン(発効日での全アクセスポイント同時置換、旧版の監査証跡としての隔離、承認連鎖と周知確認、AIによる期限切れ文書の指摘)とセマンティック検索の説明の出典です。ベンダーの製品ページです。
AI Document Management for Manufacturing Plants
7. JILPT 調査シリーズNo.194「ものづくり産業における技能継承の現状と課題に関する調査結果」(2020年2月3日公表)
従業員30人以上の製造業を層化無作為抽出して2万社へ郵送した調査。技能継承が「うまくいっている」「ややうまくいっている」は45.0%、将来の技能継承に不安を感じる企業は約8割という出典です。


