


Bài viết này bàn về triển khai LLM cục bộ, tức là chạy mô hình open-weight trên máy chủ của chính công ty hoặc trong môi trường khép kín đặt tại Thái Lan. Chú thích trên bản vẽ, công thức phối trộn, hồ sơ chất lượng, thông số kỹ thuật của khách hàng, giá thành. Chúng tôi nhận được các yêu cầu tư vấn từ doanh nghiệp sản xuất tại Thái Lan muốn dùng AI tạo sinh với những dữ liệu không muốn đưa lên đám mây bên ngoài, hoặc theo hợp đồng với khách hàng thì không được phép đưa ra ngoài như vậy, và phương án được cân nhắc khi đó chính là LLM cục bộ. AI tạo sinh dạng SaaS đã bắt đầu được dùng ở một số bộ phận, nhưng câu hỏi vẫn còn đó: có nên dựng LLM cục bộ cho dữ liệu mật hay không, và nếu dựng thì dùng mô hình nào, trên GPU nào, tốn bao nhiêu, ai vận hành. Bài viết này trả lời câu hỏi đó theo đúng trình tự công việc thực tế.
Bài viết này chỉ có một luận điểm. Thành bại của LLM cục bộ không nằm ở hiệu năng của GPU hay mô hình, mà nằm ở việc đã quyết định trước ba điều sau hay chưa. ① Nghiệp vụ mục tiêu và phân loại dữ liệu (dữ liệu nào, vì sao không được đưa ra ngoài công ty; những nghiệp vụ có thể đưa ra ngoài thì để lại cho SaaS hoặc API). ② Thước đo đánh giá (bộ đánh giá và tiêu chí đạt được xây dựng từ tài liệu của chính công ty và tổ hợp ngôn ngữ của chính công ty). ③ Người chịu trách nhiệm vận hành (ai cập nhật mô hình, ai xử lý lỗ hổng bảo mật, ai quản lý log, ai khôi phục về trạng thái trước khi có sự cố). GPU và mô hình được chọn sau khi ba điều này đã rõ, bằng cách tính ngược ra “cấu hình tối thiểu cần thiết”. Cả “toàn bộ cục bộ” lẫn “toàn bộ SaaS” đều không phải là mục tiêu.
Bản thân quyết định chọn cách sở hữu nào trong API, tự vận hành (self-host) và kết hợp đã được sắp xếp trong bài Triển khai LLM được quyết định bởi cách sở hữu nền tảng – API thương mại, tự vận hành, kết hợp. Bài viết này chỉ tập trung vào thiết kế và đặt hàng khi xây dựng thực tế, dành cho những công ty đã chọn tự vận hành (LLM cục bộ) hoặc đã xem đó là phương án ứng viên mạnh. Số người, số giờ tiết kiệm, đơn giá, chi phí và số năm hoàn vốn của nhà máy mô hình trong bài đều là số giả định đặt ra riêng cho bài viết này. Đó không phải là mức trung bình ngành, không phải số liệu khảo sát, cũng không phải giá của nhà cung cấp.
Vì sao ngành sản xuất cân nhắc triển khai LLM cục bộ
Việc sử dụng mô hình open-weight đang mở rộng
Theo khảo sát của Enterprise Technology Research (ETR) do trang tin chuyên ngành Techstrong.ai đưa tin ngày 22/09/2026 (200 người trả lời, thực hiện vào tháng 9/2026; bài báo không ghi quốc gia hay khu vực của người trả lời), tỷ trọng của mô hình open-weight trong lượng token AI mà doanh nghiệp sử dụng là 34%, tăng từ 23% một năm trước, và được dự kiến sẽ đạt 41% sau 12 tháng nữa. Tỷ lệ người trả lời đang dùng trong vận hành thật là 42% (khảo sát tháng 7 là 31%), còn ở giai đoạn thí điểm là 43%. Về hạ tầng triển khai, đám mây tự quản lý chiếm 46%, tại chỗ (on-premises) chiếm 42%. Mặt khác, các trở ngại khi đưa vào vận hành thật được nêu ra gồm “chưa hoàn tất thẩm định bảo mật và tuân thủ” với 62%, và chi phí tự vận hành với 50%.
Bài viết của Constellation Research (26/09/2026) phân tích cùng khảo sát này cho biết 69% người dùng trong vận hành thật nêu lý do là cắt giảm chi phí, và 60% đã chuyển một phần khối lượng công việc khỏi mô hình độc quyền (proprietary). Tuy nhiên, cùng bài viết đó cũng cho biết 93% đồng thời đang tăng sử dụng mô hình độc quyền. Cách đọc tự nhiên hơn là: thay vì chuyển hẳn sang mô hình open-weight, thực tế là “dùng song song”, phân chia theo mục đích sử dụng.
Điều doanh nghiệp Nhật Bản lo nhất là rò rỉ thông tin
Trong khảo sát doanh nghiệp tại 4 quốc gia được nêu trong “Sách trắng Thông tin và Truyền thông năm 2026 (Reiwa 8)” của Bộ Nội vụ và Truyền thông Nhật Bản, tỷ lệ nêu “có rủi ro bảo mật như rò rỉ thông tin nội bộ” là rủi ro đáng lo ngại khi ứng dụng AI tạo sinh là: Nhật Bản 46,4%, Mỹ 36,9%, Đức 31,7%, Trung Quốc 42,7%. Tại Nhật Bản, đây là mục được chọn nhiều nhất, tiếp theo là “độ chính xác của kết quả đầu ra có vấn đề” 35,3% và “khả năng xâm phạm quyền như bản quyền” 31,3%. Ở Mỹ và Trung Quốc, độ chính xác của đầu ra (Mỹ 44,3%, Trung Quốc 52,1%) là mục cao nhất, còn ở Đức là bản quyền và các quyền liên quan (44,7%). Cũng theo sách trắng này, về biện pháp đối phó rủi ro, tại Nhật Bản “đã xây dựng chỉ thị hoặc hướng dẫn trên toàn công ty” là cao nhất với 41,1%, trong khi ở 3 quốc gia còn lại, tỷ lệ thẩm định chuyên môn ở giai đoạn đưa vào và đánh giá, kiểm chứng định kỳ sau khi đưa vào có xu hướng cao hơn Nhật Bản.
Có thể cho rằng một trong những bối cảnh khiến các doanh nghiệp sản xuất vốn Nhật cân nhắc LLM cục bộ chính là cảm giác “lo rò rỉ” này. Tuy nhiên, như sẽ thấy ở phần sau, đặt ở cục bộ không có nghĩa là rủi ro rò rỉ biến mất. Xu hướng mà sách trắng chỉ ra, rằng tỷ lệ của Nhật Bản trong các hoạt động đánh giá và kiểm chứng sau khi đưa vào thấp hơn 3 quốc gia còn lại, cũng sẽ trở thành thách thức y hệt đối với LLM cục bộ.
Mô hình tiếng Thái và hạ tầng tính toán trong nước đang tăng lên
Tại Thái Lan, trong bài viết ngày 01/04/2026, NSTDA giới thiệu LLM quốc gia “ThaiLLM” do Bộ Kinh tế và Xã hội Số (MDES), Viện Dữ liệu lớn (BDI), Bộ Giáo dục Đại học, Khoa học, Nghiên cứu và Đổi mới (MHESI), NECTEC và các đơn vị khác cùng phát triển. Theo đó, có 2 mô hình là 8B (ưu tiên tốc độ) và 30B (hiệu năng cao), được huấn luyện trên dữ liệu tiếng Thái hơn 100 tỷ token, và Playground, API cũng như việc tải mô hình đều được cung cấp miễn phí. Dòng Typhoon của SCB 10X cũng công bố các mô hình hướng tới tiếng Thái, cùng OCR, dịch thuật và các công cụ khác (theo nội dung trên trang của công ty này).
Về phía hạ tầng tính toán, Ủy ban Đầu tư Thái Lan (BOI) công bố ngày 08/07/2026 đã phê duyệt các khoản đầu tư tổng cộng 1,99 tỷ USD (66,3 tỷ baht), trong đó có dự án của công ty con tại Thái Lan thuộc công ty Data Section của Nhật Bản, xây dựng hạ tầng máy chủ GPU hiệu năng cao tại Bangkok và Pathum Thani với 235,2 triệu USD (7,8 tỷ baht). Theo tin tức tháng 12/2024, SIAM.AI CLOUD, đơn vị vốn Thái tự giới thiệu là NVIDIA Cloud Partner, đã khởi động cụm GPU H100 và nêu mục tiêu duy trì chủ quyền dữ liệu (quy mô vận hành tính đến năm 2026 chưa được xác nhận trong phạm vi khảo sát của bài viết này). Ngoài việc đặt máy trong công ty, phương án thuê GPU trên đám mây khép kín trong nước Thái Lan đang dần trở nên khả thi.
LLM cục bộ là gì: khác biệt giữa open-weight, tại chỗ (on-premises) và đám mây khép kín trong nước Thái Lan
Cụm từ “LLM cục bộ” được mỗi người hiểu với phạm vi khác nhau. Trước khi bắt đầu thảo luận trong nội bộ, tách riêng 3 khái niệm sau sẽ giúp mọi người nói cùng một chuyện.
| Thuật ngữ | Chỉ điều gì | Nơi đặt dữ liệu | Chủ thể vận hành |
|---|---|---|---|
| Mô hình open-weight | Mô hình có trọng số (các tham số đã huấn luyện) được công bố, có thể tải về và chạy trong môi trường của mình | Bản thân mô hình không phụ thuộc nơi đặt | Người sử dụng (trong phạm vi điều kiện giấy phép) |
| LLM tại chỗ (on-premises) | Hình thức chạy mô hình open-weight trên máy chủ GPU đặt tại nhà máy hoặc trung tâm dữ liệu của công ty | Trong khuôn viên của công ty | Công ty hoặc bên nhận ủy thác bảo trì |
| Đám mây khép kín trong nước Thái Lan | Hình thức thuê GPU tại trung tâm dữ liệu trong nước Thái Lan theo khu vực chuyên dụng hoặc kết nối khép kín, rồi chạy mô hình open-weight | Thiết bị trong nước của nhà cung cấp đám mây đã ký hợp đồng | Chia sẻ giữa nhà cung cấp đám mây và công ty |
Bài viết này xem cả LLM tại chỗ lẫn đám mây khép kín trong nước là “LLM cục bộ”. Điểm chung là công ty tự quyết định chạy mô hình nào, phiên bản nào, trên dữ liệu nào, và prompt cùng câu trả lời không được chuyển cho nhà cung cấp mô hình bên ngoài. Điểm khác nhau nằm ở việc mua hay thuê GPU, và ai sửa phần cứng khi có sự cố.
Phần so sánh 3 cấu hình gồm SaaS có kiểm soát, lớp bao API (API wrapper), và khép kín hoặc tự vận hành, theo phạm vi bảo vệ được và tổng chi phí 5 năm, có trong bài Môi trường AI an toàn 2026 — Chi phí 5 năm của 3 cấu hình. Ở đây không nhắc lại phần so sánh, mà đi vào nội dung khi tự xây dựng hệ thống tự vận hành.
Điều cần quyết định đầu tiên: “nghiệp vụ đặt ở cục bộ” và phân loại dữ liệu
Điều cần quyết định đầu tiên khi cân nhắc LLM cục bộ không phải GPU, cũng không phải mô hình, mà là đặt nghiệp vụ nào ở cục bộ.
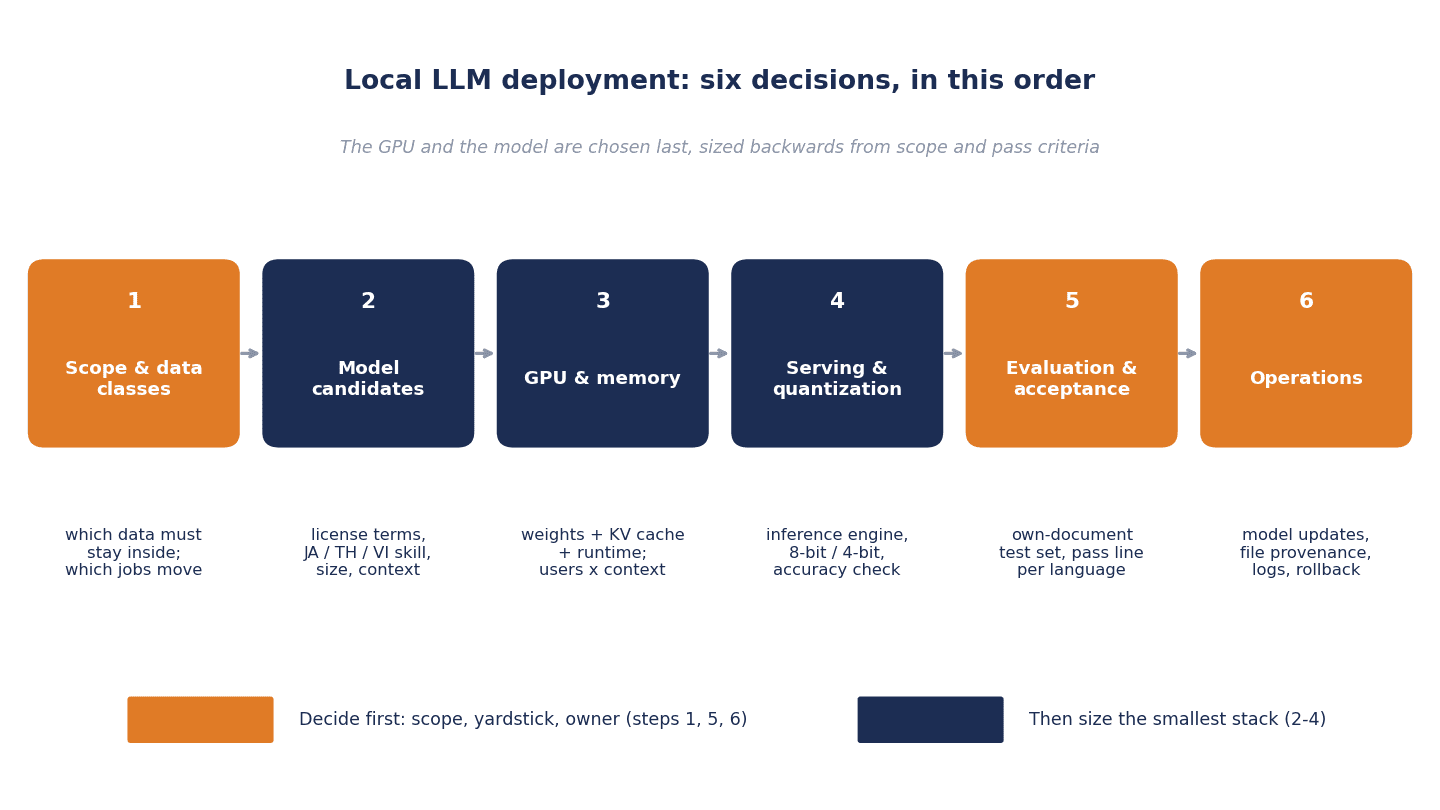
Hình trên là trình tự 6 bước để quyết định LLM cục bộ. ① Nghiệp vụ mục tiêu và phân loại dữ liệu, ② chọn mô hình ứng viên, ③ ước tính GPU và bộ nhớ, ④ phần mềm suy luận và lượng tử hóa, ⑤ đánh giá và nghiệm thu, ⑥ vận hành. Nếu bước trên chưa quyết định thì bước dưới không thể ước tính. Ví dụ, nếu mục tiêu vẫn chỉ là “để mọi nhân viên hỏi được mọi thứ”, thì không xác định được cùng lúc có bao nhiêu người, đưa vào tài liệu dài đến đâu, và do đó không quyết định được số lượng GPU.
Ví dụ phân loại dữ liệu
Bảng dưới đây liệt kê theo từng loại dữ liệu: có được đưa ra ngoài công ty hay không, và ví dụ về nơi đặt. Cách phân loại thay đổi theo quy chế an ninh thông tin nội bộ và hợp đồng với khách hàng, nên đây chỉ là ví dụ về cách tư duy.
| Loại dữ liệu | Có được đưa ra ngoài công ty không (ví dụ) | Ví dụ nơi đặt | Ví dụ lý do |
|---|---|---|---|
| Soạn thảo văn bản thông thường, tóm tắt thông tin công khai, bản nháp dịch | Được | SaaS hoặc API | Không chứa thông tin mật. Có thể ưu tiên hiệu năng và sự tiện lợi |
| Quy chế nội bộ, tiêu chuẩn thao tác, quy trình nội bộ | Tùy theo quy chế | SaaS (có kiểm soát) hoặc cục bộ | Phụ thuộc vào việc có được xếp vào loại mật nội bộ hay không |
| Bản vẽ của khách hàng, thông số kỹ thuật của khách hàng, yêu cầu chất lượng nhận từ khách hàng | Tùy theo hợp đồng (thường là không được) | Cục bộ | Hợp đồng bảo mật có thể hạn chế việc gửi lên máy chủ của bên thứ ba |
| Công thức phối trộn, điều kiện công đoạn, giá thành, căn cứ báo giá | Không muốn đưa ra | Cục bộ | Chính là năng lực cạnh tranh của công ty |
| Hồ sơ chất lượng, hồ sơ lỗi, hồ sơ khiếu nại của khách hàng | Không muốn đưa ra | Cục bộ | Chứa tên khách hàng và nội dung lỗi |
| Dữ liệu cá nhân của nhân viên (nhân sự, sức khỏe, đánh giá) | Về nguyên tắc không đưa ra | Cục bộ, hoặc nằm ngoài phạm vi của LLM | Thuộc phạm vi PDPA. Có vấn đề về chuyển dữ liệu ra nước ngoài |
Hãy điền cột thứ hai từ phải sang cho từng bộ phận. Điểm mấu chốt là thu hẹp các nghiệp vụ đặt ở cục bộ. Nếu kéo cả việc soạn thảo văn bản thông thường về cục bộ, số người dùng sẽ tăng làm thiếu GPU, và về hiệu năng thì có thể còn kém SaaS. Cách thực tế là bắt đầu từ các bộ phận xử lý dữ liệu mật hằng ngày, chẳng hạn như thiết kế, đảm bảo chất lượng, quản lý sản xuất và mua hàng.
Viết lý do “vì sao không được đưa ra ngoài” trong một dòng
Khi quyết định phân loại, hãy viết lý do “không được đưa ra ngoài” trong một dòng. Nếu viết được như “hợp đồng với khách hàng A cấm lưu trữ trên máy chủ của bên thứ ba” hay “công thức phối trộn thuộc loại mật theo phân loại của trụ sở chính, không được tiết lộ ra ngoài”, thì sau này có thể dùng nguyên văn khi viết RFP, khi thiết kế kiểm thử nghiệm thu và khi giải trình với kiểm toán. Dữ liệu nào không viết được lý do thì thực ra có thể dùng SaaS là đủ. Yêu cầu và kiểm thử nghiệm thu cho chính biện pháp chống rò rỉ thông tin từ AI tạo sinh được trình bày chi tiết trong bài Ngăn rò rỉ dữ liệu từ AI tạo sinh: RFP và kiểm thử nghiệm thu cho nhà máy Thái Lan.
Cách chọn mô hình open-weight: giấy phép, ngôn ngữ, kích thước, độ dài ngữ cảnh
Khi đã xác định nghiệp vụ mục tiêu, tiếp theo là chọn mô hình ứng viên. Bảng dưới đây liệt kê những mô hình mà trong phạm vi khảo sát của bài viết này đã xác nhận được qua model card chính thức hoặc trang của nhà phát triển, dưới dạng “ví dụ ứng viên”, không phải khuyến nghị. Hiệu năng và thông số đều là nội dung do nhà phát triển ghi (khẳng định của nhà cung cấp).
| Mô hình (nhà phát triển) | Quy mô | Độ dài ngữ cảnh | Giấy phép, điều kiện sử dụng | Ghi chú về ngôn ngữ |
|---|---|---|---|---|
| gpt-oss-20b và gpt-oss-120b (OpenAI) | 20b có tổng 21B, hoạt động 3,6B; 120b có tổng 117B, hoạt động 5,1B | 128K theo ghi chú của bản phân phối trên Ollama | Apache 2.0 | — |
| Qwen3-30B-A3B-Instruct-2507 (Qwen, Alibaba) | Tổng 30,5B, kích hoạt 3,3B | Nguyên bản 262.144 token | apache-2.0 | — |
| Llama 4 Scout và Llama 4 Maverick (Meta) | Scout kích hoạt 17B, tổng 109B; Maverick kích hoạt 17B, tổng 400B | Scout 10M, Maverick 1M token | Llama 4 Community License Agreement (sản phẩm có trên 700 triệu người dùng hoạt động hằng tháng cần nộp đơn xin phép Meta) | 12 ngôn ngữ, trong đó có tiếng Thái, tiếng Việt, tiếng Indonesia. Tiếng Nhật không nằm trong danh sách ngôn ngữ hỗ trợ chính thức |
| Gemma 4 (Google) | 5 loại: E2B, E4B, 12B, 26B A4B (MoE), 31B (dense) | Loại nhỏ 128K, loại trung bình 256K | Được cho là có thể sử dụng thương mại. Điều kiện sử dụng mô hình cần xác nhận trên trang điều khoản sử dụng chính thức (Gemma terms) | — |
| Mistral-Small-3.2-24B-Instruct-2506 (Mistral AI) | 24B | — | apache-2.0 | Hỗ trợ 24 ngôn ngữ |
| DeepSeek-V3.2 (DeepSeek) | Tổng 685B | — | Trên kho mã nguồn ghi MIT License | — |
| GPT-OSS Swallow 20B và 120B (dự án Swallow) | Dựa trên gpt-oss | — | Apache 2.0 (dùng được cho cả thương mại và nghiên cứu) | Chuyên biệt cho tiếng Nhật |
| Typhoon2.1-Gemma3-12B (SCB 10X) | 12B (dựa trên Gemma3 12B) | 128K | Gemma License. Khi sử dụng cần đồng ý với điều khoản sử dụng và thông báo quyền riêng tư của OpenTyphoon | Tiếng Thái, tiếng Anh |
| ThaiLLM (MDES, BDI, MHESI, NECTEC và các đơn vị khác) | 8B và 30B | — | Tên giấy phép chưa được xác nhận trong khảo sát của bài viết này | Tiếng Thái (huấn luyện trên dữ liệu tiếng Thái hơn 100 tỷ token) |
Dấu “—” trong bảng là mục không có thông tin trong phạm vi đã kiểm tra của khảo sát cho bài viết này.
Đọc giấy phép theo điều kiện, không theo “tên gọi”
Cùng là “mở”, nhưng điều kiện lại khác nhau. Có những mô hình ghi Apache 2.0 hoặc MIT, trong khi Llama 4 dùng giấy phép cộng đồng riêng, theo đó sản phẩm hoặc dịch vụ có trên 700 triệu người dùng hoạt động hằng tháng cần nộp đơn xin phép Meta. Typhoon2.1-Gemma3-12B yêu cầu đồng ý với điều khoản sử dụng của OpenTyphoon, ngoài Gemma License. Trang tổng quan chính thức của Gemma 4 có ghi rằng có thể sử dụng thương mại và rằng điều khoản sử dụng của Gemma 4 áp dụng cho mô hình, nhưng chi tiết điều kiện cần được xác nhận trực tiếp trên chính trang điều khoản sử dụng. Với ThaiLLM, khảo sát của bài viết này chưa xác nhận được tên giấy phép. Hãy lấy làm tiền đề rằng khi đã có mô hình ứng viên được chọn, cùng bộ phận pháp chế đọc nguyên văn điều khoản sử dụng tại thời điểm đó.
Xem ngôn ngữ qua cả “danh sách hỗ trợ” lẫn “đo thực tế trên tài liệu của công ty”
Ở những nhà máy dùng lẫn tiếng Nhật, tiếng Thái và tiếng Việt, cách xử lý ngôn ngữ trở thành điểm phân định khi lựa chọn. Model card của Llama 4 nêu 12 ngôn ngữ hỗ trợ, trong đó có tiếng Thái và tiếng Việt, nhưng tiếng Nhật không nằm trong danh sách chính thức. Về mô hình chuyên biệt cho tiếng Nhật, dự án Swallow của Đại học Khoa học Tokyo và các đơn vị khác đã công bố GPT-OSS Swallow 20B và 120B (v0.1 ngày 20/02/2026, bản MXFP4 ngày 28/05/2026), và cho biết trên benchmark JamC-QA kiểm tra kiến thức liên quan đến Nhật Bản, bản 20B cải thiện 13,0 điểm và bản 120B cải thiện 11,4 điểm so với gpt-oss gốc (công bố của nhà phát triển). Với tiếng Thái, có ThaiLLM và Typhoon2.1-Gemma3-12B đã nêu ở trên.
Tuy nhiên, danh sách ngôn ngữ hỗ trợ hay benchmark không đảm bảo rằng mô hình dùng được với chú thích bản vẽ hay hồ sơ chất lượng của công ty bạn. Cần đo thực tế với tổ hợp ngôn ngữ của chính công ty, chẳng hạn tóm tắt bằng tiếng Nhật một tiêu chuẩn thao tác viết bằng tiếng Thái, hay truyền đạt bằng tiếng Thái cho hiện trường những điểm chính trong thông số kỹ thuật của khách hàng viết bằng tiếng Nhật. Cách xây dựng đánh giá nghiệp vụ bằng tiếng Thái được sắp xếp trong bài AI tạo sinh tiếng Thái: Hướng dẫn RFP và kiểm thử nghiệm thu.
Kích thước và độ dài ngữ cảnh
Mô hình càng lớn thì càng có thể kỳ vọng độ chính xác cao hơn, nhưng bộ nhớ GPU và chi phí cũng tăng theo. Những mô hình như gpt-oss, Qwen3-30B-A3B hay Llama 4 được ghi tách riêng “tổng tham số” và “tham số hoạt động (kích hoạt)” là các mô hình có cấu trúc gọi là MoE (hỗn hợp chuyên gia). Dù mỗi lần tính toán chỉ dùng một phần tham số, toàn bộ trọng số vẫn phải được nạp vào bộ nhớ, nên việc ước tính bộ nhớ GPU được thực hiện theo tổng tham số.
Độ dài ngữ cảnh là độ dài văn cảnh có thể đọc vào trong một lần. Như trong bảng, con số này trải từ 128K đến 10M token, nhưng dùng nguyên văn cảnh dài bao nhiêu thì bộ nhớ KV cache tăng bấy nhiêu. Điểm này được trình bày ở chương tiếp theo.
Cách chọn GPU cho LLM: phương pháp tính bộ nhớ cần thiết
Bộ nhớ cho trọng số là “số tham số × số byte”
Việc ước tính bộ nhớ GPU bắt đầu từ trọng số. Blog kỹ thuật của NVIDIA (17/11/2023) đưa ra công thức cơ bản tính bộ nhớ trọng số bằng “số tham số × số byte cho mỗi tham số”, và lấy ví dụ nạp Llama 2 7B ở 16 bit (FP16 hoặc BF16) thì cần khoảng 14 GB. Số byte cho mỗi tham số là 2 byte với 16 bit, 1 byte với 8 bit và 0,5 byte với 4 bit.
Dùng công thức này để ước tính bộ nhớ trọng số theo quy mô mô hình và độ chính xác, kết quả như sau (ước tính với 1 GB = 1 tỷ byte, chỉ là giá trị của trọng số).
| Quy mô mô hình | 16 bit | 8 bit | 4 bit |
|---|---|---|---|
| 8B (8 tỷ) | 16 GB | 8 GB | 4 GB |
| 32B (32 tỷ) | 64 GB | 32 GB | 16 GB |
| 70B (70 tỷ) | 140 GB | 70 GB | 35 GB |
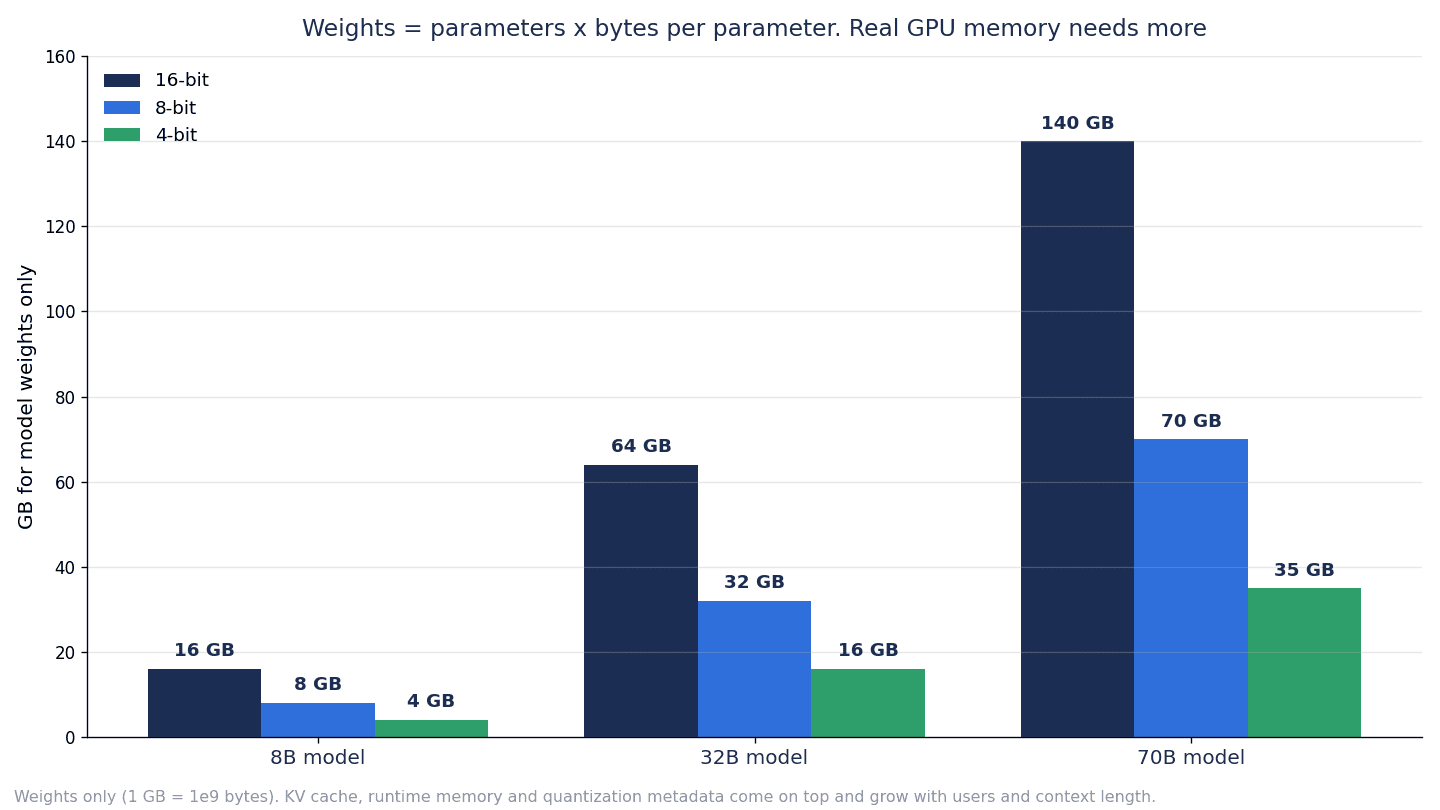
Bảng này không bao gồm KV cache, vùng nhớ khi chạy của phần mềm suy luận và thông tin đi kèm của lượng tử hóa. Bộ nhớ GPU thực tế cần thiết sẽ lớn hơn các giá trị này. Lớn hơn bao nhiêu thì thay đổi theo số kết nối đồng thời, độ dài văn cảnh và phần mềm suy luận.
Hãy xem thêm các giá trị do nhà phát triển công bố. Google đưa ra bảng chính thức về mức bộ nhớ tham khảo chỉ để nạp trọng số của Gemma 4 (khẳng định của nhà cung cấp).
| Mô hình Gemma 4 | BF16 | SFP8 | Q4_0 |
|---|---|---|---|
| 31B | 69,9 GB | 34,9 GB | 17,5 GB |
| 26B A4B | 57,7 GB | 28,8 GB | 14,4 GB |
| 12B | 26,7 GB | 13,4 GB | 6,7 GB |
| E4B | 17,9 GB | 8,9 GB | 4,5 GB |
| E2B | 11,4 GB | 5,7 GB | 2,9 GB |
Google chú thích rằng bảng này chỉ thể hiện bộ nhớ cần để nạp trọng số tĩnh của mô hình, không bao gồm phần bộ nhớ bổ sung cần cho phần mềm và cửa sổ ngữ cảnh (KV cache). Google cũng cho biết mức tiêu thụ bộ nhớ tăng động theo tổng số token của prompt và câu trả lời được sinh ra. Giá trị tính bằng công thức đơn giản và giá trị trong bảng của nhà phát triển có thể không khớp nhau tùy mô hình, nên khi đã có ứng viên, hãy kiểm tra bằng bảng của nhà phát triển hoặc giá trị trong model card.
Các model card khác cũng có mức tham khảo. Model card của Mistral-Small-3.2-24B-Instruct-2506 cho biết khi chạy trên GPU ở bf16 hoặc fp16 cần khoảng 55 GB GPU RAM. Model card của gpt-oss cho biết nhờ áp dụng lượng tử hóa MXFP4 cho trọng số MoE, bản 120b vừa trong một GPU 80 GB duy nhất (ví dụ NVIDIA H100 hoặc AMD MI300X), còn bản 20b chạy được trong 16 GB bộ nhớ. Llama 4 Scout được cho là vừa trong một GPU H100 duy nhất với lượng tử hóa int4 tức thời (on-the-fly). Tất cả đều là khẳng định của nhà phát triển, và điều kiện về số kết nối đồng thời cũng như độ dài văn cảnh cần được kiểm tra riêng.
KV cache tăng theo số kết nối đồng thời và độ dài văn cảnh
Sau trọng số, yếu tố tác động tiếp theo là KV cache. Đây là vùng giữ văn cảnh của hội thoại hoặc tài liệu trong bộ nhớ GPU, và blog kỹ thuật của NVIDIA nêu trên đưa ra tổng dung lượng theo công thức sau.
KV cache = kích thước batch × độ dài chuỗi × 2 × số lớp × hidden size × số byte của FP16
Trong ví dụ của cùng blog, khi chạy Llama 2 7B với batch 1, độ dài chuỗi 4.096, 32 lớp, hidden size 4.096, FP16, KV cache khoảng 2 GB. Như công thức cho thấy, KV cache tăng tỷ lệ thuận với kích thước batch (số yêu cầu được xử lý đồng thời) và độ dài chuỗi (độ dài văn cảnh). Với những mục đích như đưa dài các hồ sơ chất lượng hay phần mô tả bản vẽ vào qua RAG và nhiều người dùng cùng lúc, dung lượng KV cache có thể không chỉ dừng ở mức vài chục phần trăm dung lượng trọng số.
Có một điểm cần lưu ý. Công thức này dùng hidden size, nhưng với các mô hình áp dụng GQA (grouped-query attention, chú ý theo nhóm truy vấn), KV cache được tính bằng số KV head × chiều của head. Ví dụ, Qwen3-30B-A3B-Instruct-2507 nêu trên có 4 KV head, nên nếu áp nguyên công thức này sẽ ra ước tính quá lớn. Giá trị chính xác cần được kiểm tra bằng cấu hình của mô hình được chọn và đo thực tế trên phần mềm suy luận.
Phía phần mềm suy luận cũng có thiết lập để giảm KV cache. Theo FAQ của Ollama, thiết lập lượng tử hóa KV cache (OLLAMA_KV_CACHE_TYPE) mặc định là f16; chuyển sang q8_0 thì bộ nhớ còn khoảng một nửa so với f16, và q4_0 thì còn khoảng một phần tư (ghi chú của nhà phát triển). Giống như lượng tử hóa trọng số, đổi lại việc giảm bộ nhớ là cần kiểm tra ảnh hưởng đến độ chính xác.
Thông số chính thức của các sản phẩm GPU
Bảng dưới đây liệt kê dung lượng bộ nhớ và các thông số khác được đăng trên trang chính thức của các sản phẩm GPU. Tất cả đều là nội dung do nhà sản xuất ghi; giá không được ghi trên trang chính thức nên bài viết này không đề cập.
| Sản phẩm (NVIDIA) | Bộ nhớ GPU | Băng thông bộ nhớ | Công suất tiêu thụ tối đa | Ghi chú |
|---|---|---|---|---|
| L4 | 24 GB | 300 GB/s | 72 W (TDP) | 1 khe cắm, PCIe low-profile |
| L40S | 48 GB GDDR6 (ECC) | 864 GB/s | 350 W | 2 khe cắm (dual-slot) |
| RTX PRO 6000 Blackwell Server Edition | 96 GB GDDR7 (ECC) | 1.597 GB/s | 600 W (có thể cấu hình) | Có thể chia thành tối đa 4 phiên bản độc lập bằng MIG |
| H200 | 141 GB HBM3e | 4,8 TB/s | SXM tối đa 700 W, NVL tối đa 600 W (có thể cấu hình) | 2 dạng SXM và NVL |
| DGX Spark | 128 GB bộ nhớ hợp nhất LPDDR5x (cũng có cấu hình 64 GB qua OEM) | — | — | Được cho là hỗ trợ suy luận mô hình tối đa 200 tỷ tham số và tinh chỉnh (fine-tuning) mô hình tối đa 70 tỷ tham số. Kết nối tối đa 4 máy |
Trình tự lựa chọn là ① dùng bảng trọng số để thu hẹp tổ hợp mô hình ứng viên và độ chính xác, ② tính thêm phần dư cho KV cache dựa trên số kết nối đồng thời và độ dài văn cảnh, ③ quyết định xem có vừa trong 1 card hay phải chia ra nhiều card. Công suất tiêu thụ và làm mát, chỗ trống trên rack, dung lượng nguồn điện là những ràng buộc dễ bị bỏ sót trong phòng máy chủ của nhà máy. Điều kiện nơi lắp đặt nên được xác nhận với bộ phận cơ điện trước khi chọn GPU.
Phần mềm suy luận và lượng tử hóa: chọn cái gì thì điều gì thay đổi
Giữa mô hình và GPU là phần mềm suy luận (inference engine, phần mềm serving). Tùy lựa chọn mà khả năng chịu tải kết nối đồng thời, định dạng lượng tử hóa được hỗ trợ và phần cứng chạy được sẽ thay đổi. Toàn bộ nội dung dưới đây là ghi chú của nhà phát triển hoặc đơn vị vận hành.
| Phần mềm suy luận | Định vị (theo mô tả của nhà phát triển) | Đặc điểm chính | API | Ví dụ tình huống phù hợp |
|---|---|---|---|---|
| vLLM | Thư viện nhanh và dễ dùng cho suy luận và serving LLM | Quản lý bộ nhớ KV bằng PagedAttention, continuous batching, prefix caching. Hỗ trợ các dạng lượng tử hóa như FP8, MXFP4, INT8, INT4, GPTQ và AWQ, GGUF | API tương thích OpenAI, Anthropic Messages API, gRPC | Máy chủ nội bộ cho nhiều người dùng đồng thời |
| SGLang | Framework serving hiệu năng cao cho LLM và mô hình đa phương thức (do LMSYS vận hành) | RadixAttention, prefix caching, song song đa GPU. Hỗ trợ BF16, FP8, NVFP4 và các dạng khác. Hỗ trợ NVIDIA, AMD, Intel Xeon, Google TPU và các nền tảng khác | — | Serving vận hành thật trên nhiều GPU |
| llama.cpp | Cho phép suy luận LLM trên nhiều loại phần cứng với thiết lập tối thiểu | Lượng tử hóa số nguyên từ 1,5 bit đến 8 bit, định dạng GGUF. Hỗ trợ Apple Silicon, CUDA, HIP, Vulkan, CPU | llama-server cung cấp API tương thích OpenAI | Kiểm chứng quy mô nhỏ, môi trường có ít GPU |
| Ollama | Môi trường chạy mô hình hoạt động cục bộ | Mặc định bind vào 127.0.0.1:11434. Số xử lý đồng thời cho mỗi mô hình (OLLAMA_NUM_PARALLEL) mặc định là 1. Cửa sổ ngữ cảnh mặc định là 4.096 token theo FAQ tại thời điểm truy cập | — | Thử nghiệm cá nhân hoặc nhóm nhỏ, giai đoạn đầu của PoC |
Dấu “—” trong bảng là mục không có thông tin trong phạm vi đã kiểm tra của khảo sát cho bài viết này.
Tách riêng thử nghiệm nhóm nhỏ và vận hành thật ở cấp bộ phận
Ở giai đoạn đầu của PoC, thử nhanh bằng Ollama hoặc llama.cpp là hợp lý. Tuy nhiên, Ollama mặc định chỉ bind vào localhost, và muốn mở ra mạng thì cần thiết lập OLLAMA_HOST một cách tường minh. Số xử lý đồng thời mặc định cho mỗi mô hình cũng là 1. Nếu dùng chung trong bộ phận như một máy chủ nội bộ, cần thiết kế riêng phần thiết lập kết nối đồng thời, xác thực và kiểm soát truy cập. Cửa sổ ngữ cảnh mặc định cũng được ghi là 4.096 token trong FAQ tại thời điểm truy cập, nên với mục đích đưa tài liệu dài vào thì cần kiểm tra thiết lập (giá trị mặc định này là thiết lập đã thay đổi qua các phiên bản).
Trong vận hành thật khi nhiều người trong bộ phận dùng cùng lúc, các phần mềm serving có continuous batching và quản lý KV cache như vLLM hay SGLang sẽ là ứng viên. Như việc model card của Qwen3-30B-A3B-Instruct-2507 nêu vLLM 0.8.5 trở lên và SGLang 0.4.6.post1 trở lên là phần mềm serving khuyến nghị, có những mô hình được chỉ định phần mềm suy luận và phiên bản khuyến nghị. Hãy chọn mô hình và phần mềm suy luận theo tổ hợp.
Lượng tử hóa giảm bộ nhớ, nhưng độ chính xác phải tự kiểm tra
Lượng tử hóa là kỹ thuật thu nhỏ trọng số từ 16 bit xuống 8 bit hoặc 4 bit để giảm bộ nhớ. Như đã thấy ở bảng trọng số, dùng 4 bit thì còn một phần tư so với 16 bit. Tuy nhiên, độ chính xác giảm bao nhiêu thì tùy mô hình, phương pháp lượng tử hóa và nghiệp vụ. Với những mục đích mà chỉ một chút suy giảm cũng dẫn đến sai sót nghiệp vụ, như đọc số liệu, chép lại mã sản phẩm hay giá trị tiêu chuẩn, danh từ riêng tiếng Thái, hãy đưa vào kiểm thử nghiệm thu việc so sánh bản 16 bit và bản lượng tử hóa trên cùng một bộ đánh giá.
Định dạng lượng tử hóa được hỗ trợ cũng thay đổi theo thế hệ GPU. Theo bảng tương thích lượng tử hóa của vLLM, AWQ được hỗ trợ trên GPU NVIDIA từ thế hệ Turing trở về sau (không bao gồm Volta) và một số nền tảng khác, FP8 (W8A8) của llm-compressor được hỗ trợ trên thế hệ Ada, Hopper và GPU AMD, đồng thời có chú thích rằng bảng tương thích có thể thay đổi trong tương lai. Hãy kiểm tra tổ hợp GPU và định dạng lượng tử hóa bằng bảng tương thích mới nhất của phần mềm suy luận trước khi đặt hàng.
Cấu hình tổng thể khi xây dựng máy chủ LLM nội bộ: xác thực, RAG, log, giám sát
LLM cục bộ không thể dùng cho nghiệp vụ nếu chỉ nạp mô hình lên máy chủ GPU. Cấu hình tổng thể khi xây dựng thành máy chủ nội bộ đại thể chia thành các lớp sau.
- Cổng vào của người dùng: màn hình chat nội bộ, tích hợp vào hệ thống quản lý tài liệu hoặc cổng thông tin hiện có. Liên kết với tài khoản nhân viên bằng đăng nhập một lần (single sign-on).
- Xác thực và kiểm soát truy cập: làm cho quyền tìm kiếm tài liệu của từng người khớp với quyền truy cập tài liệu hiện có. Một trong những cái bẫy lớn của LLM cục bộ là người không có quyền lại đọc được hồ sơ chất lượng hay giá thành vốn không được xem, thông qua RAG.
- RAG (tìm kiếm tài liệu nội bộ): lớp tìm kiếm chú thích bản vẽ, thông số kỹ thuật của khách hàng, hồ sơ chất lượng, quy chế nội bộ rồi chuyển cho LLM. Quản lý phiên bản tài liệu, việc trộn lẫn ngôn ngữ, cách xử lý bảng và hình ảnh quyết định độ chính xác. Toàn bộ việc xây dựng và đánh giá RAG được trình bày trong bài Triển khai RAG cho doanh nghiệp: hướng dẫn xây dựng, chi phí và đánh giá thực tế, còn biện pháp đối với vấn đề trả lời từ tài liệu phiên bản cũ có trong bài Quản lý phiên bản tài liệu trong RAG nhà máy: triển khai và nghiệm thu.
- Máy chủ suy luận: phần mềm suy luận và GPU ở chương trước. Nếu dùng nhiều mô hình theo từng mục đích, việc chuyển đổi giữa chúng cũng được xử lý ở đây.
- Log và giám sát: ghi lại ai, khi nào, hỏi gì, câu trả lời nào được trả về dựa trên tài liệu nào. Giám sát mức sử dụng GPU, thời gian phản hồi và lỗi. Bản thân log cũng chứa thông tin mật, nên cần quyết định cả nơi lưu trữ log và quyền xem log.
- Ranh giới với hệ thống hiện có: khi cho LLM tham chiếu dữ liệu từ MES hoặc ERP, cần quyết định chỉ cho đọc hay cho phép ghi, và chuyển đến những trường dữ liệu nào. Thiết kế kết nối MES và ERP của nhà máy với AI agent một cách an toàn được trình bày trong bài Xây dựng MCP server cho nhà máy: kết nối MES, ERP với AI agent an toàn.
Khi vẽ sơ đồ cấu hình, hãy ghi rõ “lớp nào nằm trên thiết bị của ai, ở quốc gia nào”. Dù chỉ đặt máy chủ suy luận trong công ty, nếu nền tảng tìm kiếm của RAG hay log được đặt trên SaaS ở nước ngoài thì dữ liệu vẫn ra khỏi công ty.
Bảo mật: những rủi ro không biến mất dù đặt ở cục bộ
Đặt ở cục bộ có ưu điểm là prompt và câu trả lời không được chuyển cho nhà cung cấp mô hình bên ngoài. Tuy nhiên, phần lớn rủi ro đặc thù của ứng dụng LLM vẫn còn, bất kể đặt ở đâu. Bảng dưới đây sắp xếp những mục đặc biệt cần lưu ý với LLM cục bộ, lấy từ “OWASP Top 10 for LLM Applications 2025” do OWASP (cộng đồng tiêu chuẩn hóa phi lợi nhuận) công bố tháng 3/2025, và “NIST AI 600-1”, bản tổng hợp rủi ro dành cho AI tạo sinh do NIST công bố tháng 7/2024.
| Rủi ro (mục trong nguồn) | Điều xảy ra với LLM cục bộ | Ví dụ biện pháp |
|---|---|---|
| Chuỗi cung ứng (OWASP LLM03), tích hợp thành phần của bên thứ ba (NIST) | Đưa vào tệp mô hình không rõ nguồn gốc hoặc đã bị sửa đổi | Chỉ lấy từ kho chính thức của nhà phát triển. Ưu tiên định dạng safetensors. Ghi lại giá trị hash |
| Prompt injection (OWASP LLM01) | LLM làm theo chỉ thị được cài sẵn trong tài liệu đọc vào qua RAG | Giới hạn nguồn nạp tài liệu. Thu hẹp quyền cấp cho LLM |
| Tiết lộ thông tin nhạy cảm (OWASP LLM02) | Người dùng không có quyền đọc được tài liệu mật của bộ phận khác qua RAG | Luôn đối chiếu quyền truy cập tài liệu khi tìm kiếm. Đưa câu hỏi vượt quyền truy cập vào kiểm thử nghiệm thu |
| Quyền hạn quá mức (OWASP LLM06) | LLM có thể ghi vào MES hoặc ERP | Bắt đầu từ chế độ chỉ đọc. Việc ghi phải qua phê duyệt của con người |
| Điểm yếu của vector và embedding (OWASP LLM08) | Nội dung tài liệu mật bị suy đoán ra từ cơ sở dữ liệu vector dùng cho tìm kiếm | Áp dụng cho cơ sở dữ liệu vector cùng mức kiểm soát truy cập như tài liệu |
| Thông tin sai lệch (OWASP LLM09), bịa đặt (confabulation, NIST) | Chép nguyên câu trả lời sai nhưng nghe có vẻ hợp lý vào bản vẽ hoặc báo cáo | Hiển thị tài liệu căn cứ. Vận hành theo nguyên tắc kiểm tra số liệu và giá trị tiêu chuẩn trên bản gốc |
| Tiêu thụ không giới hạn (OWASP LLM10) | Đưa vào hàng loạt tài liệu dài làm GPU bị chiếm dụng, người dùng khác không dùng được | Giới hạn cho từng người dùng, giới hạn độ dài văn cảnh |
Kiểm tra nguồn lấy tệp mô hình
Một vấn đề đặc thù của LLM cục bộ là độ an toàn của tệp mô hình. Tài liệu của Hugging Face giải thích rằng pickle, định dạng trọng số mặc định của PyTorch, có nguy cơ cho phép thực thi mã tùy ý khi nạp. Biện pháp được nêu gồm lấy từ tổ chức đáng tin cậy, kiểm tra commit có chữ ký (tuy nhiên chữ ký đảm bảo nguồn gốc chứ không đảm bảo độ an toàn), và các định dạng thay thế như safetensors. safetensors được mô tả là định dạng lưu tensor an toàn, khác với pickle. Hugging Face Hub có quét các tệp được tải lên, nhưng ghi rõ rằng việc này “không chắc chắn 100%” và “việc xác nhận an toàn là trách nhiệm của người dùng”.
Về quy tắc vận hành nội bộ, nguyên tắc cơ bản là ghi lại tệp nào, phiên bản nào, từ kho nào, ai phê duyệt và đưa vào. Mỗi lần cập nhật mô hình, thực hiện lại đúng quy trình này.
Đừng giải thích rằng “vì là cục bộ nên an toàn”
Khi giải thích với ban lãnh đạo hay khách hàng, hãy tránh khẳng định “vì là cục bộ nên không xảy ra rò rỉ thông tin”. Việc dữ liệu không được chuyển cho nhà cung cấp mô hình bên ngoài và việc không xảy ra truy cập vượt quyền trong nội bộ hay sử dụng sai kết quả đầu ra là hai chuyện khác nhau. NIST AI 600-1 cũng nêu các rủi ro đặc thù hoặc bị khuếch đại bởi AI tạo sinh, như bịa đặt (confabulation), quyền riêng tư dữ liệu, an ninh thông tin, tích hợp không minh bạch các thành phần của bên thứ ba. “Hướng dẫn dành cho doanh nghiệp AI” (AI Guidelines for Business) của Nhật Bản đã công bố phiên bản 1.2 vào tháng 3/2026, kèm theo danh sách kiểm tra và bảng tính (worksheet). Có thể tham khảo làm khung đánh giá rủi ro trong nội bộ.
Lưu ý khi triển khai tại Thái Lan và ASEAN
Chuyển dữ liệu ra nước ngoài theo PDPA
Theo Luật Bảo vệ Dữ liệu Cá nhân của Thái Lan (PDPA), 2 thông báo của Ủy ban Bảo vệ Dữ liệu Cá nhân (PDPC) về chuyển dữ liệu ra nước ngoài, căn cứ Điều 28 và Điều 29, đã được ban hành ngày 25/12/2023 và có hiệu lực từ ngày 24/03/2024. Theo phân tích của công ty luật, Điều 28 yêu cầu quốc gia hoặc tổ chức quốc tế nhận dữ liệu phải có mức bảo vệ đầy đủ, còn Điều 29 quy định việc chuyển dữ liệu dựa trên biện pháp bảo vệ thích hợp như quy tắc doanh nghiệp ràng buộc trong tập đoàn (BCR) hoặc điều khoản hợp đồng mẫu. Việc gửi prompt có chứa dữ liệu cá nhân đến LLM dạng SaaS hoặc API ở nước ngoài có thể thuộc diện chuyển dữ liệu ra nước ngoài này. Có thuộc diện hay không, hãy xác nhận với bộ phận pháp chế hoặc chuyên gia bên ngoài. LLM cục bộ là một trong những lựa chọn khi muốn giữ các nghiệp vụ có chứa dữ liệu cá nhân ở trong nước.
Tình hình luật AI
Tại Thái Lan, Cơ quan Phát triển Giao dịch Điện tử (ETDA) đã công bố dự thảo luật AI ngày 09/07/2026 và lấy ý kiến công chúng đến ngày 14/08/2026. Theo phân tích của công ty luật, dự thảo có khung dựa trên rủi ro, trong đó các cơ quan quản lý theo từng lĩnh vực đặt ra yêu cầu thay vì một cơ quan quản lý duy nhất. Tính đến ngày 10/10/2026, văn bản vẫn đang ở giai đoạn dự thảo, và có quan điểm cho rằng sau khi Nội các chấp thuận về nguyên tắc, việc ban hành và có hiệu lực có thể mất từ 6 đến 24 tháng.
Tại Việt Nam, Luật Trí tuệ nhân tạo được thông qua vào tháng 12/2025 và có hiệu lực từ ngày 01/03/2026. Theo cổng thông tin của Chính phủ Việt Nam, luật có tổng cộng 35 điều. Theo các bài phân tích, luật áp dụng phân loại rủi ro 3 mức cao, trung bình, thấp, và có biện pháp chuyển tiếp cho các hệ thống AI hiện có (y tế, giáo dục, tài chính là 18 tháng, các lĩnh vực khác là 12 tháng).
Xu hướng quản lý tại Thái Lan và Việt Nam ảnh hưởng thế nào đến quyết định tự vận hành đã được đề cập trong bài Triển khai LLM được quyết định bởi cách sở hữu nền tảng. Ở đây, với tiền đề là tình hình quản lý khác nhau giữa các quốc gia và đang thay đổi, bài viết chỉ dừng ở mức khuyến nghị xây dựng cấu hình có thể lưu lại hồ sơ log và đánh giá.
Xử lý tiếng Thái và tiếng Việt
Tại các cơ sở ở Thái Lan, tiếng Nhật, tiếng Thái và tiếng Anh thường xuất hiện lẫn trong cùng một tài liệu. Với công ty có cơ sở tại Việt Nam, còn có thêm tiếng Việt. Như đã thấy ở chương chọn mô hình, mức hỗ trợ ngôn ngữ khác nhau tùy mô hình. Hãy so sánh mô hình chuyên biệt cho tiếng Thái (ThaiLLM, Typhoon), mô hình chuyên biệt cho tiếng Nhật (GPT-OSS Swallow) và mô hình đa ngôn ngữ, bằng tổ hợp ngôn ngữ của chính công ty. Vấn đề độ chính xác tiếng Việt bị hỏng ở khâu tiền xử lý được trình bày trong bài Độ chính xác AI tạo sinh tiếng Việt — chỗ hỏng là tiền xử lý chứ không phải mô hình.
Tính toán mô hình chi phí và hiệu quả (số giả định)
Từ đây là phép tính mô hình nhằm thể hiện “cấu trúc” của việc tính toán. Tất cả các con số dưới đây đều là số giả định đặt ra riêng cho bài viết này. Đó không phải là mức trung bình ngành, không phải số liệu của công ty khảo sát, cũng không phải giá của nhà cung cấp. Hãy thay bằng số liệu của chính công ty bạn khi sử dụng.
Tiền đề của nhà máy mô hình
Giả định 1 cơ sở của một nhà sản xuất linh kiện vốn Nhật tại Thái Lan. 120 người thuộc các bộ phận thiết kế, đảm bảo chất lượng, quản lý sản xuất và mua hàng dùng LLM cục bộ để tìm kiếm tài liệu nội bộ (RAG) và soạn nháp, tóm tắt tài liệu, với đối tượng là chú thích bản vẽ, thông số kỹ thuật của khách hàng, hồ sơ chất lượng và quy chế nội bộ. Đơn vị tiền tệ là baht Thái (THB).
| Hạng mục | Giá trị giả định |
|---|---|
| Số người dùng U | 120 người |
| Số giờ tiết kiệm mỗi tháng của mỗi người h | Kịch bản chính 3 giờ/tháng |
| Đơn giá giờ công W | 400 THB/giờ |
| Chi phí ban đầu I | 2.400.000 THB (phần cứng như máy chủ GPU 1.500.000 + xây dựng 900.000 [liên kết xác thực, RAG, log, xây dựng bộ đánh giá, PoC]) |
| Chi phí vận hành hằng năm L | 780.000 THB/năm (điện năng và lắp đặt 120.000 + bảo trì và hỗ trợ bên ngoài 360.000 + nhân sự vận hành nội bộ 0,3 người × 1.000.000 = 300.000) |
| Số năm sử dụng phần cứng | Giả định 5 năm |
Kịch bản chính (h = 3 giờ/tháng)
| Hạng mục | Kịch bản chính (h = 3 giờ/tháng) | Cách tính |
|---|---|---|
| Số giờ tiết kiệm hằng năm | 4.320 giờ/năm | 120 × 3 × 12 |
| Giá trị quy đổi thành tiền của số giờ tiết kiệm | 1.728.000 THB/năm | 4.320 × 400 |
| Chi phí vận hành hằng năm | −780.000 THB/năm | Giả định |
| Hiệu quả ròng hằng năm | 948.000 THB/năm | 1.728.000 − 780.000 |
| Số năm hoàn vốn đơn giản | Khoảng 2,5 năm | 2.400.000 ÷ 948.000 = 2,53 |
Viết dưới dạng công thức tổng quát thì như sau.
Hiệu quả ròng hằng năm = 576.000 × h − 780.000
576.000 là phần giá trị quy đổi thành tiền hằng năm tăng thêm mỗi khi số giờ tiết kiệm mỗi tháng của mỗi người tăng 1 giờ (120 × 400 × 12).
Kết quả thay đổi thế nào khi số giờ tiết kiệm thay đổi
Chỉ thay đổi số giờ tiết kiệm mỗi tháng của mỗi người h.
| h (giờ/tháng) | Giá trị quy đổi thành tiền của số giờ tiết kiệm | Hiệu quả ròng hằng năm | Số năm hoàn vốn đơn giản |
|---|---|---|---|
| 1 | 576.000 THB | −204.000 THB | Không hoàn vốn (không bù được chi phí vận hành hằng năm) |
| 2 | 1.152.000 THB | 372.000 THB | Khoảng 6,5 năm (2.400.000 ÷ 372.000 = 6,45). Vượt quá số năm sử dụng giả định là 5 năm |
| 3 | 1.728.000 THB | 948.000 THB | Khoảng 2,5 năm (2.400.000 ÷ 948.000 = 2,53) |
| 5 | 2.880.000 THB | 2.100.000 THB | Khoảng 1,1 năm (2.400.000 ÷ 2.100.000 = 1,14) |
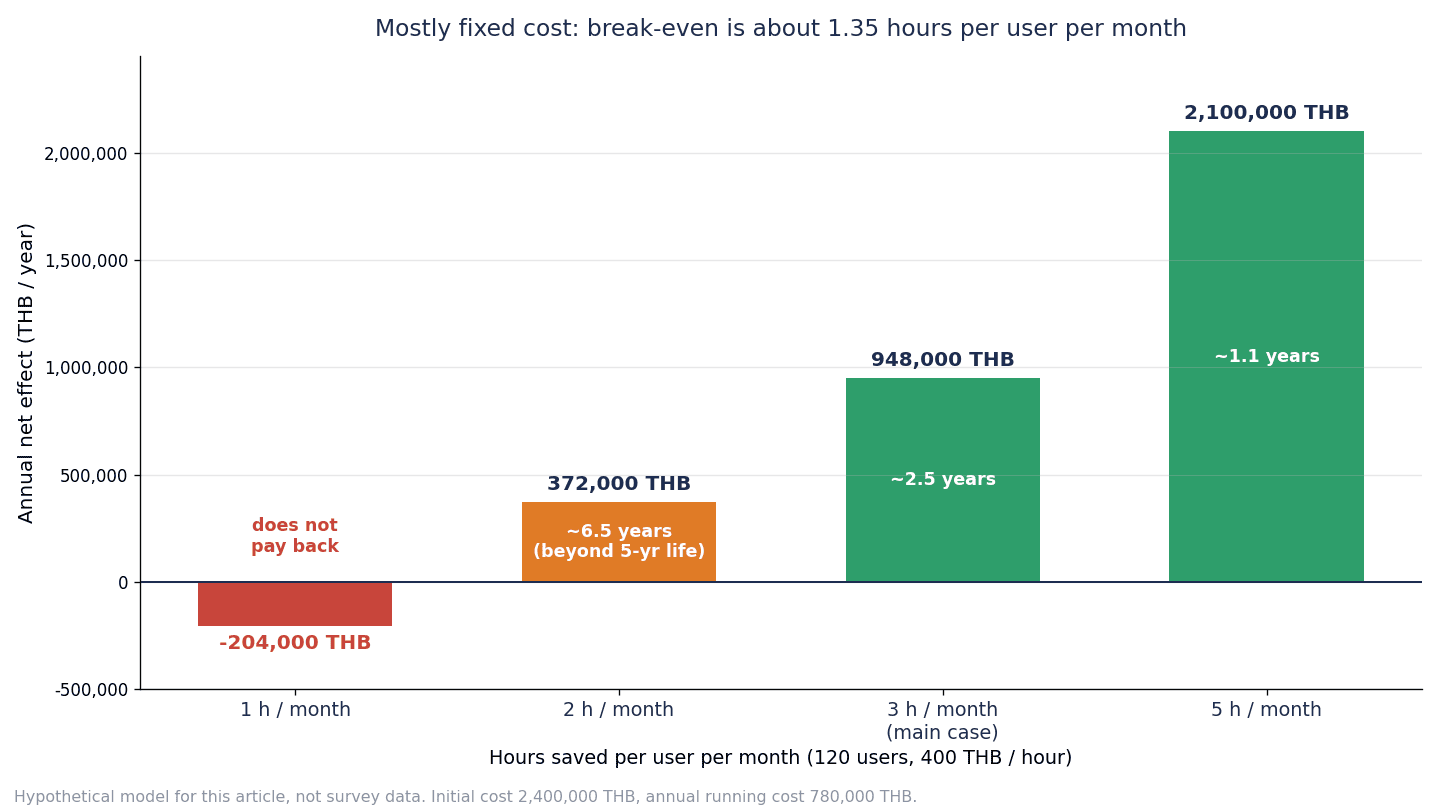
Giá trị h làm hiệu quả ròng hằng năm bằng 0 được tính từ 576.000 × h = 780.000, ra h ≈ 1,35 giờ/tháng. Nếu thấp hơn mức này, giá trị quy đổi thành tiền của số giờ tiết kiệm không bù nổi cả chi phí vận hành hằng năm. Ngoài ra, để hoàn vốn chi phí ban đầu trong vòng 5 năm sử dụng phần cứng, hiệu quả ròng hằng năm cần đạt từ 480.000 THB (2.400.000 ÷ 5) trở lên, và từ 576.000 × h ≥ 1.260.000, điều kiện là h ≈ 2,19 giờ/tháng trở lên. Với h = 2 giờ/tháng, hiệu quả ròng hằng năm tuy có lãi nhưng thời gian hoàn vốn khoảng 6,5 năm, vượt quá số năm sử dụng giả định là 5 năm.
Nói cách khác, với các tiền đề giả định này, điểm phân định nằm quanh mức 2 giờ mỗi người mỗi tháng, và nếu thấp hơn khoảng 1,35 giờ mỗi tháng thì không bù nổi cả chi phí hằng năm. Phần lớn chi phí là chi phí cố định như máy chủ GPU, bảo trì, nhân sự vận hành. Nếu số người dùng ít, hoặc thời gian sử dụng ngắn, thì không hoàn vốn.
Tách riêng phần giảm tiền mặt và phần giảm giờ công
Giá trị quy đổi thành tiền của số giờ tiết kiệm sẽ không trở thành khoản giảm tiền mặt, trừ khi thời gian được giải phóng được chuyển sang công việc khác. Khoản tiền mặt thực sự chi ra là chi phí ban đầu I và chi phí vận hành hằng năm L. Việc thời gian được giải phóng có được dùng cho xử lý khách hàng, cải tiến chất lượng hay phát triển sản phẩm tiếp theo hay không sẽ làm thay đổi lớn ý nghĩa của khoản đầu tư.
Những gì chưa đưa vào phép tính này
Các hạng mục sau thay đổi nhiều tùy điều kiện nên chưa được quy thành tiền.
- Phần giảm phí sử dụng SaaS hoặc API tương ứng với phần chuyển về cục bộ (vì thay đổi tùy việc có hợp đồng hiện có hay không)
- Hiệu quả về kiểm toán của khách hàng và về mặt hợp đồng nhờ không đưa dữ liệu mật ra ngoài công ty
- Tránh được sự cố rò rỉ thông tin
- Chi phí thay mới GPU (từ năm thứ 6 trở đi)
Hãy đánh giá các hạng mục này riêng. Cách tư duy quản lý giá thành của AI tạo sinh theo đơn vị kết quả được sắp xếp trong bài AI FinOps: Quản lý chi phí AI tạo sinh theo kết quả đã nghiệm thu.
Điều rút ra từ phép tính
Không được đặt số giờ tiết kiệm h theo phỏng đoán. Hãy đo thực tế thời gian làm việc của nghiệp vụ mục tiêu trước và sau khi đưa vào trong PoC, rồi thay bằng giá trị đó. Trên cơ sở đó, điều có thể nói là trình tự: không bắt đầu từ “dành cho toàn bộ nhân viên”, mà thu hẹp vào “các bộ phận xử lý dữ liệu mật hằng ngày”, đo thực tế số giờ tiết kiệm trong PoC rồi mới quyết định cấu hình GPU cho vận hành thật.
Với các bộ phận có ít người dùng, cũng có lựa chọn là trước tiên thuê GPU trên đám mây khép kín trong nước Thái Lan theo tháng để thực hiện PoC, rồi quyết định việc mua phần cứng sau khi có số đo thực tế. Phí GPU đám mây thay đổi tùy nhà cung cấp và điều kiện hợp đồng, nên hãy xác nhận qua báo giá.
Các mục cần ghi trong RFP cho LLM cục bộ
Khi viết RFP (hồ sơ mời đề xuất) để mua sắm máy chủ GPU hoặc ủy thác xây dựng và vận hành, hãy đưa vào các mục sau. RFP chỉ ghi “tên mô hình và mã GPU” thì không thể so sánh các đề xuất.
| STT | Hạng mục | Nội dung cần ghi |
|---|---|---|
| 1 | Nghiệp vụ mục tiêu và phân loại dữ liệu | Bộ phận mục tiêu, nghiệp vụ mục tiêu, dữ liệu đặt ở cục bộ và lý do, cách xử lý các nghiệp vụ có thể đưa ra ngoài công ty |
| 2 | Quy mô sử dụng | Số người dùng, số kết nối đồng thời dự kiến, độ dài tài liệu đưa vào mỗi lần, khung giờ cao điểm |
| 3 | Mô hình ứng viên và giấy phép | Mô hình và phiên bản đề xuất, điều kiện giấy phép và điều khoản sử dụng, hỗ trợ ngôn ngữ, khả năng thay thế |
| 4 | Căn cứ về GPU và bộ nhớ | Chi tiết trọng số, KV cache, vùng nhớ khi chạy, có lượng tử hóa hay không, căn cứ tính phần dư khi có kết nối đồng thời |
| 5 | Phần mềm suy luận | Phần mềm suy luận và phiên bản, thiết lập kết nối đồng thời và hàng đợi, tương thích giữa định dạng lượng tử hóa và GPU |
| 6 | Đánh giá và tiêu chí nghiệm thu | Số lượng và cách xây dựng bộ đánh giá từ tài liệu của công ty, tiêu chí đạt theo từng ngôn ngữ, so sánh trước và sau lượng tử hóa, thời gian phản hồi |
| 7 | Xác thực và kiểm soát truy cập | Đăng nhập một lần, khớp với quyền truy cập tài liệu, cách xử lý câu hỏi vượt quyền truy cập |
| 8 | Log và kiểm toán | Các mục được ghi lại, nơi và thời hạn lưu trữ, quyền xem, định dạng nộp cho kiểm toán |
| 9 | Nguồn lấy và cập nhật mô hình | Nguồn lấy tệp mô hình, định dạng (như safetensors), quy trình phê duyệt khi đưa vào, đánh giá lại khi cập nhật |
| 10 | Vận hành và xử lý sự cố | Các mục giám sát, quy trình khôi phục về trạng thái trước khi có sự cố, bảo trì và thay thế GPU, đội ngũ hỗ trợ tại Thái Lan, bàn giao vận hành |
| 11 | Điều kiện lắp đặt | Nơi lắp đặt (phòng máy chủ của công ty, trung tâm dữ liệu trong nước, đám mây khép kín), dung lượng nguồn điện, làm mát, rack |
| 12 | Chi tiết chi phí | Chi phí ban đầu (phần cứng, xây dựng, xây dựng bộ đánh giá, PoC) và chi phí hằng năm (điện năng, bảo trì, hỗ trợ bên ngoài), các điều kiện làm chi phí thay đổi |
Đặc biệt, mục 4 và mục 6 là những mục giúp phân biệt chất lượng đề xuất. Đề xuất không đưa ra được căn cứ bộ nhớ theo chi tiết từng phần, hay đề xuất chỉ ghi tiêu chí nghiệm thu là “điểm cao trên benchmark thông dụng”, có nguy cơ không đáp ứng đủ sau khi đi vào vận hành.
Những điều cần kiểm tra trong PoC: 5 tình huống cố ý thử
Trong PoC, chỉ kiểm tra rằng hệ thống chạy được với những câu hỏi suôn sẻ là chưa đủ. Cần kiểm tra khi đưa vào điều kiện hóc búa, hệ thống có phát hiện được câu trả lời sai không, có giữ được quyền truy cập không, thời gian phản hồi có trụ được không.
| Tình huống | Làm gì | Kiểm tra điều gì |
|---|---|---|
| ① Trả lời sai trên tài liệu của công ty | Trộn vào các câu hỏi mà câu trả lời không có trong tài liệu, câu hỏi chứa mã sản phẩm gần giống hoặc giá trị tiêu chuẩn của phiên bản cũ | Có trả lời “không biết” không. Có chỉ đúng tài liệu căn cứ không |
| ② Độ chính xác theo từng ngôn ngữ | Chạy cùng một bộ đánh giá với tổ hợp ngôn ngữ của công ty, như hỏi bằng tiếng Thái về tài liệu tiếng Nhật, tóm tắt bằng tiếng Nhật một tiêu chuẩn thao tác tiếng Thái | Tỷ lệ đạt theo từng tổ hợp ngôn ngữ. Nhầm lẫn danh từ riêng và số liệu |
| ③ Thời gian phản hồi khi có kết nối đồng thời | Gửi đồng thời các yêu cầu đưa vào tài liệu dài, với số kết nối đồng thời dự kiến | Thời gian phản hồi có nằm trong phạm vi chấp nhận được cho nghiệp vụ không. Có lỗi do thiếu bộ nhớ GPU không |
| ④ Câu hỏi vượt quyền truy cập | Dùng tài khoản của người dùng không có quyền để cố khai thác hồ sơ chất lượng hoặc giá thành của bộ phận khác | Quyền truy cập có được đối chiếu ngay ở bước tìm kiếm và không xuất hiện trong câu trả lời không |
| ⑤ Thay thế mô hình | Thay bằng bản lượng tử hóa hoặc mô hình khác, chạy lại cùng bộ đánh giá | Tỷ lệ đạt thay đổi bao nhiêu. Đánh giá lại mất bao nhiêu ngày |
Các KPI cần đo
- Thời gian làm việc của nghiệp vụ mục tiêu (đo thực tế trước và sau khi đưa vào; đây là giá trị thay cho h trong phép tính mô hình)
- Tỷ lệ đạt trên bộ đánh giá (theo từng tổ hợp ngôn ngữ, tách riêng bản 16 bit và bản lượng tử hóa)
- Thời gian phản hồi khi có kết nối đồng thời
- Số trường hợp thông tin bị lộ với câu hỏi vượt quyền truy cập (phải là 0)
- Giờ công cần cho việc đánh giá lại
Tình huống ⑤ thay thế mô hình thường bị bỏ qua nhưng rất quan trọng. Với mô hình open-weight, có thể có phiên bản mới hoặc mô hình khác được công bố, và hoàn toàn có thể xảy ra tình huống muốn đổi mô hình sau khi đã đi vào vận hành. Nếu không có cơ chế chạy lại bộ đánh giá mỗi lần như vậy, sẽ chỉ còn hai lựa chọn: tiếp tục dùng mô hình cũ, hoặc đổi mà không đánh giá. Hãy kiểm tra trước quy trình đánh giá lại và thời gian cần thiết ngay ở giai đoạn PoC. Tiêu chí quyết định kết thúc PoC để chuyển sang vận hành thật, cùng thiết kế nghiệm thu và bàn giao vận hành, được trình bày trong bài Tiêu chí kết thúc AI PoC để nghiệm thu, vận hành thật và bàn giao.
Câu hỏi thường gặp
LLM cục bộ là gì?
Đó là hình thức chạy mô hình open-weight (mô hình có trọng số được công bố, có thể tải về và chạy) trong môi trường do công ty quản lý, như máy chủ của công ty hoặc đám mây khép kín trong nước Thái Lan. Điểm khác với AI tạo sinh dạng SaaS là công ty tự quyết định chạy mô hình nào, phiên bản nào, trên dữ liệu nào, và prompt cùng câu trả lời không được chuyển cho nhà cung cấp mô hình bên ngoài.
LLM cục bộ cần GPU như thế nào?
Điều này được quyết định bởi quy mô và độ chính xác của mô hình, số kết nối đồng thời và độ dài văn cảnh. Bộ nhớ trọng số có thể ước tính bằng “số tham số × số byte cho mỗi tham số”; như bảng trong bài, giả sử với mô hình 32B thì mức tham khảo chỉ riêng trọng số là 64 GB ở 16 bit và 16 GB ở 4 bit. Cộng thêm vào đó là KV cache và vùng nhớ khi chạy của phần mềm suy luận. Thay vì chọn từ tên sản phẩm GPU, hãy quyết định nghiệp vụ mục tiêu và số kết nối đồng thời trước, rồi tính ngược ra bộ nhớ cần thiết.
Chi phí của LLM tại chỗ (on-premises) là bao nhiêu?
Giá GPU không được ghi trên trang chính thức và thay đổi nhiều tùy cấu hình và báo giá. Về cấu trúc chi phí, hãy lấy báo giá tách riêng chi phí ban đầu (phần cứng, xây dựng, xây dựng bộ đánh giá, PoC) và chi phí hằng năm (điện năng và lắp đặt, bảo trì và hỗ trợ bên ngoài, nhân sự vận hành nội bộ). Trong phép tính mô hình của bài (số giả định), vì phần lớn chi phí là chi phí cố định, kết quả là nếu số giờ tiết kiệm mỗi tháng của mỗi người dưới khoảng 1,35 giờ thì không bù nổi cả chi phí hằng năm, và để hoàn vốn trong 5 năm cần từ khoảng 2,19 giờ trở lên.
LLM cục bộ có dùng được với tiếng Nhật và tiếng Thái không?
Điều này khác nhau tùy mô hình. Ví dụ, model card của Llama 4 nêu tiếng Thái và tiếng Việt là ngôn ngữ hỗ trợ, nhưng tiếng Nhật không nằm trong danh sách chính thức. Cũng có những mô hình như GPT-OSS Swallow chuyên biệt cho tiếng Nhật, ThaiLLM hay Typhoon2.1-Gemma3-12B hướng tới tiếng Thái. Tuy nhiên, danh sách hỗ trợ hay benchmark không đảm bảo độ chính xác trên tài liệu của công ty bạn. Hãy đo thực tế bằng bộ đánh giá xây dựng từ tổ hợp ngôn ngữ của chính công ty.
Dùng LLM cục bộ thì có tránh được rò rỉ thông tin không?
Về điểm prompt và câu trả lời không được chuyển cho nhà cung cấp mô hình bên ngoài thì có lợi thế, nhưng không có nghĩa là rủi ro rò rỉ biến mất. Các rủi ro như nhân viên không có quyền đọc được tài liệu mật của bộ phận khác qua RAG, đưa vào tệp mô hình không rõ nguồn gốc, hay bản thân log chứa thông tin mật, vẫn còn dù đặt ở cục bộ. Cần đối chiếu quyền truy cập tài liệu, quản lý nguồn lấy tệp mô hình, và thiết kế việc lưu trữ cũng như quyền xem log.
Chọn mô hình open-weight như thế nào?
Thu hẹp ứng viên theo 4 điểm: điều kiện giấy phép và điều khoản sử dụng, mức hỗ trợ ngôn ngữ mà công ty sử dụng, quy mô mô hình (có vừa bộ nhớ GPU không), và độ dài ngữ cảnh; cuối cùng so sánh bằng bộ đánh giá từ tài liệu của công ty. Hãy đọc giấy phép theo điều kiện chứ không theo từ “mở”, và xác nhận nguyên văn điều khoản sử dụng cùng bộ phận pháp chế trước khi áp dụng.
Tổng kết
Nếu bắt đầu triển khai LLM cục bộ bằng việc so sánh mã GPU hay benchmark của mô hình, kết quả có thể là mua máy chủ đắt tiền mà không ai dùng. Trước tiên, dùng phân loại dữ liệu để quyết định đặt nghiệp vụ nào ở cục bộ, và để lại các nghiệp vụ có thể đưa ra ngoài công ty cho SaaS hoặc API. Tiếp theo, xây dựng bộ đánh giá và tiêu chí đạt từ tài liệu của công ty và tổ hợp ngôn ngữ của công ty. Sau đó, quyết định ai đảm nhận việc cập nhật mô hình, quản lý nguồn lấy tệp mô hình, log và khôi phục về trạng thái trước khi có sự cố. GPU và mô hình được tính ngược ra cấu hình tối thiểu cần thiết sau khi ba điều này đã rõ, bằng cách cộng dồn trọng số, KV cache và phần dư cho kết nối đồng thời.
Trong phép tính mô hình (số giả định), vì phần lớn chi phí là chi phí cố định, nếu số giờ tiết kiệm mỗi tháng của mỗi người dưới khoảng 1,35 giờ thì không bù nổi cả chi phí hằng năm, và để hoàn vốn trong 5 năm cần từ khoảng 2,19 giờ trở lên. Chính vì vậy, hãy bắt đầu bằng cách thu hẹp vào các bộ phận xử lý dữ liệu mật hằng ngày, đo thực tế số giờ tiết kiệm trong PoC rồi mới quyết định cấu hình GPU cho vận hành thật. Khi số người dùng còn ít, cũng có cách thuê GPU trên đám mây khép kín trong nước để thử.
TOMAS TECH hỗ trợ chuẩn hóa tài liệu nội bộ, ứng dụng AI tạo sinh và kết nối với các hệ thống hiện có, phù hợp với nghiệp vụ của nhà máy tại Thái Lan. Bạn có thể trao đổi với chúng tôi ngay cả khi chưa quyết định mô hình hay GPU, chẳng hạn ở giai đoạn thu hẹp nghiệp vụ mục tiêu hay sắp xếp phân loại dữ liệu. Vui lòng liên hệ qua biểu mẫu này.
Thông tin tham khảo
- Hugging Face: openai/gpt-oss-120b model card
- Ollama Library: gpt-oss
- Hugging Face: Qwen/Qwen3-30B-A3B-Instruct-2507 model card
- Hugging Face: meta-llama/Llama-4-Scout-17B-16E-Instruct model card
- Google AI for Developers: Gemma models overview
- Hugging Face: deepseek-ai/DeepSeek-V3.2 model card
- Hugging Face: mistralai/Mistral-Small-3.2-24B-Instruct-2506 model card
- Swallow LLM project: GPT-OSS Swallow
- Hugging Face: scb10x/typhoon2.1-gemma3-12b model card
- vLLM documentation
- vLLM documentation: Quantization
- GitHub: ggml-org/llama.cpp
- Ollama Docs: FAQ
- SGLang Documentation
- NVIDIA: L4 Tensor Core GPU
- NVIDIA: L40S GPU
- NVIDIA: H200 Tensor Core GPU
- NVIDIA: RTX PRO 6000 Blackwell Server Edition
- NVIDIA: DGX Spark
- NVIDIA Technical Blog: Mastering LLM Techniques: Inference Optimization (17/11/2023)
- OWASP GenAI Security Project: OWASP Top 10 for LLM Applications 2025
- NIST: AI 600-1 Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- Hugging Face Hub docs: Pickle Scanning
- Hugging Face docs: Safetensors
- Bộ Nội vụ và Truyền thông Nhật Bản: Sách trắng Thông tin và Truyền thông năm 2026 (Reiwa 8), Hình I-2-1-8 (CSV)
- Bộ Nội vụ và Truyền thông Nhật Bản: Sách trắng Thông tin và Truyền thông năm 2026 (Reiwa 8), Phần I Chương 2
- Techstrong.ai: Open-Weight AI Models Expected to Capture 41% of Enterprise Token Usage (22/09/2026)
- Constellation Research: Evidence Shows Enterprises Use of Open Weight Models is Mainstream (26/09/2026)
- Tilleke & Gibbins: Thailand Unveils Regulations for Cross-Border Personal Data Transfer (04/01/2024)
- Rajah & Tann Asia: Thailand’s Proposed AI Law: Moving Towards a Risk-Based Regulatory Framework (28/07/2026)
- Baker McKenzie: Vietnam: Artificial Intelligence Law – Foundation and Outlook (24/02/2026)
- Vietnam Government News: First-ever law on artificial intelligence approved
- NSTDA: ThaiLLM (01/04/2026)
- BOI: Thailand Approves $1.99 Billion in New Investment, Led by AI and Advanced Electronics (08/07/2026)
- Kaohoon International: SIAM.AI CLOUD Launches Thailand’s AI Infrastructure (04/12/2024)
- SCB 10X: OpenTyphoon
- Bộ Nội vụ và Truyền thông Nhật Bản: Hướng dẫn dành cho doanh nghiệp AI (AI Guidelines for Business)


