


“รายงาน Near Miss ส่งมาเป็นภาษาไทยบนกระดาษและ LINE แค่อ่าน แปล จัดหมวดหมู่ ลงทะเบียน และสรุปรายงานเดือนก็หมดเวลาแล้ว นับสถิติได้ แต่ตามไม่ได้ว่ามาตรการปิดจริงหรือยัง” เราได้ยินเสียงนี้บ่อยจาก จป. ผู้จัดการฝ่ายความปลอดภัย และผู้จัดการโรงงานบริษัทญี่ปุ่นในไทย ทางเลือกที่มักถูกยกขึ้นมาจึงเป็นการนำ AI วิเคราะห์รายงาน Near Miss มาใช้ โดยให้ Generative AI แปล สรุป และจัดหมวดหมู่รายงาน Near Miss (เหตุการณ์เกือบเกิดอุบัติเหตุ)
ขอสรุปก่อน การวิเคราะห์ Near Miss ด้วย AI จะได้ผลหรือไม่ ไม่ได้ตัดสินจาก “ความแม่นยำในการจัดหมวดหมู่ของ AI” แต่ตัดสินจาก “รายงานส่งได้ง่ายขึ้นจนจำนวนเพิ่มขึ้น และเวลาจนกว่ามาตรการจะถูกมอบหมายและปิดได้สั้นลงหรือไม่” ต่อให้การจัดหมวดหมู่และการรวบรวมสถิติเร็วขึ้นเพียงใด หากผู้รับผิดชอบ กำหนดเสร็จ และการยืนยันว่ามาตรการเสร็จสิ้นไม่ได้หมุนไปจริง อุบัติเหตุก็จะไม่ลดลง
สิ่งที่ต้องตัดสินใจในการนำมาใช้มี 5 เรื่อง ได้แก่ (1) ช่องทางการรายงาน (2) ขอบเขตที่มอบให้ AI (3) จะสร้างคำตอบที่ถูกต้องของการจัดหมวดหมู่อย่างไร (4) การมอบหมายมาตรการและการยืนยันว่าเสร็จสิ้น (5) การจัดการข้อมูลส่วนบุคคลและการรายงานตามกฎหมาย หากตัดสินใจตามลำดับนี้ ทั้งการเลือกผลิตภัณฑ์ RFP และการทดสอบรับมอบจะไม่ค่อยหลงทิศ
อนึ่ง จำนวนรายงาน เวลาดำเนินการ ค่าแรง ค่าใช้จ่าย ความเสียหายจากอุบัติเหตุ และระยะคืนทุนของโรงงานที่ปรากฏในบทความนี้ ทั้งหมดเป็นค่าประมาณการและค่าสมมติ (ค่าตั้งไว้ชั่วคราว) ที่บทความนี้จัดทำขึ้นเองบนสมมติฐานของโรงงานจำลองที่จะอธิบายภายหลัง ไม่ใช่ค่าเฉลี่ยของอุตสาหกรรมหรือค่าจากการสำรวจ และไม่ได้ใช้ราคาของผู้ขาย (vendor) ในการประมาณการ ขอให้อ่านเป็น “แบบฟอร์มการคำนวณ” ที่ต้องนำผลจริงและใบเสนอราคาของบริษัทท่านมาแทนค่า
ทำไมการนำ AI วิเคราะห์รายงาน Near Miss มาใช้ในโรงงานไทยจึงเป็นประเด็นในตอนนี้
กำแพง 4 ด้าน: กระดาษ LINE หลายภาษา และรายงานประจำเดือน
ในโรงงานบริษัทญี่ปุ่นในไทย รายงาน Near Miss ส่วนใหญ่ส่งมาเป็นภาษาไทย บางฉบับเขียนด้วยลายมือบนแบบฟอร์มกระดาษ บางฉบับหัวหน้าทีมส่งรูปพร้อมข้อความสั้นๆ ทาง LINE บางฉบับเป็นการบอกเล่าด้วยปากแล้วเจ้าหน้าที่ความปลอดภัยเขียนแทน ทั้งรูปแบบและความละเอียดจึงไม่เหมือนกันเลย บางโรงงานยังมีรายงานในภาษาอื่นปนอยู่ เช่น ภาษาแม่ของแรงงานที่มาจากประเทศเพื่อนบ้าน
การจะทำให้ผู้บริหารชาวญี่ปุ่นอ่านเข้าใจได้ ต้องมีคนอ่านทีละฉบับ จับใจความ แปลเป็นภาษาญี่ปุ่น จัดหมวดหมู่ตามประเภทอุบัติเหตุหรือสถานที่ แล้วกรอกลงทะเบียน พอสิ้นเดือนก็ต้องนับจำนวน ทำกราฟ และสรุปเป็นรายงานประจำเดือน เวลาส่วนใหญ่ของเจ้าหน้าที่ความปลอดภัยจึงหมดไปกับ “อ่าน แปล แยก นับ” จนแทบไม่เหลือเวลาให้กับงานสำคัญ คือ “คิดว่าตรงไหนอันตราย ลงมือแก้ และตรวจว่าปิดได้แล้วหรือยัง”
ที่ลำบากกว่านั้นคือ ยิ่งรายงานมาก ยิ่งประมวลผลไม่ทัน โดยหลักแล้ว ยิ่งรวบรวม Near Miss ได้มาก ยิ่งเห็นว่าอันตรายอยู่ตรงไหนได้ง่ายขึ้น แต่จากมุมของผู้ประมวลผล จำนวนที่เพิ่มขึ้นก็คือภาระที่เพิ่มขึ้น ผลคือเกิดบรรยากาศ “รายงานน้อยๆ จะสบายกว่า” โดยไม่รู้ตัว และช่องทางการรายงานก็ค่อยๆ ตีบลง คุณค่าของการใช้ AI ลดภาระการแปล สรุป และจัดหมวดหมู่ อยู่ตรงจุดนี้
เก็บ Near Miss ไปเพื่ออะไร
“เว็บไซต์ความปลอดภัยในที่ทำงาน” ของกระทรวงสาธารณสุข แรงงาน และสวัสดิการของญี่ปุ่น (MHLW) อธิบายว่ากิจกรรม Near Miss คือการหยิบประสบการณ์ที่ทำให้ตกใจหรือสะดุ้งขึ้นมาพิจารณาเพื่อเชื่อมโยงไปสู่การป้องกันอุบัติเหตุ และเป็นวิธีที่ได้ผลวิธีหนึ่งในการระบุปัจจัยอันตราย ในขณะเดียวกันก็ระบุว่า การรายงาน Near Miss “ไม่ใช่เรื่องน่าภาคภูมิใจนัก” สำหรับผู้รายงาน ดังนั้น หากไม่ตกลงและปฏิบัติตามข้อตกลงว่าจะไม่กล่าวโทษผู้ปฏิบัติงาน ระบบก็จะอยู่ได้ไม่นาน แม้กรณีที่ไม่ได้ทำตามคู่มือขั้นตอนการทำงาน ก็ควรมองว่าเป็นโอกาสทบทวนคู่มือ และการเผยแพร่ตัวอย่างการปรับปรุงให้กว้างขวาง เช่น ผ่านจดหมายข่าวภายในบริษัท จะช่วยให้ขยายผลไปยังจุดอื่นและยกระดับความตระหนักได้
ในบริบทของ Near Miss มักมีการอ้างถึงกฎของไฮน์ริช (Heinrich’s Law) คำอธิบายศัพท์ในเว็บไซต์เดียวกันแนะนำว่าเป็นกฎที่ไฮน์ริช วิศวกรความปลอดภัยของบริษัทประกันวินาศภัยในสหรัฐอเมริกา เผยแพร่ไว้ โดยมีสัดส่วนว่า จากอุบัติเหตุ 330 ครั้งที่เกิดจากบุคคลคนเดียวกัน มี 1 ครั้งที่เป็นอุบัติเหตุร้ายแรง 29 ครั้งเป็นการบาดเจ็บเล็กน้อย และ 300 ครั้งเป็นอุบัติเหตุที่ไม่มีการบาดเจ็บ อย่างไรก็ตาม คำอธิบายเดียวกันกล่าวถึงว่าไฮน์ริชเองก็เคยบอกว่าสัดส่วนนี้แตกต่างกันระหว่างงานประกอบโครงเหล็กกับงานพนักงานสำนักงาน และสรุปว่า สิ่งสำคัญไม่ใช่ตัวเลขของสัดส่วน แต่คือการที่มีปัจจัยอันตรายอยู่เป็นจำนวนมาก
สัดส่วนนี้ยังมีข้อวิจารณ์ด้วย นิตยสาร Safety+Health ของสภาความปลอดภัยแห่งชาติสหรัฐอเมริกา (NSC) นำเสนอข้อวิจารณ์ของ Fred A. Manuele ว่า แฟ้มข้อมูลต้นฉบับไม่หลงเหลืออยู่จึงไม่มีบุคคลที่สามตรวจสอบได้ สัดส่วนถูกแก้ไขโดยไม่มีคำอธิบายทุกครั้งที่พิมพ์ฉบับใหม่ และหากยึดสมมติฐานว่า “อุบัติเหตุส่วนใหญ่เกิดจากการกระทำที่ไม่ปลอดภัย” มาตรการจะพุ่งไปที่ตัวผู้ปฏิบัติงานแทนที่จะเป็นระบบงาน การรับรู้สัดส่วนนี้ในฐานะกฎจากประสบการณ์ที่ถูกนำมาเล่าต่อจึงเหมาะสมกว่า และไม่สามารถใช้เป็นเครื่องมือคำนวณว่าลด Near Miss ได้กี่ครั้งแล้วอุบัติเหตุร้ายแรงจะลดลงกี่ครั้ง
บทความนี้จึงไม่ได้ตั้งเป้าหมายของการวิเคราะห์ Near Miss ด้วย AI ไว้ที่ “การลดจำนวน” เป้าหมายคือการรู้ให้เร็วว่าอันตรายอยู่ตรงไหน ลงมือแก้ และยืนยันว่ามาตรการปิดแล้วจริง
ความเคลื่อนไหวในปี 2025-2026: AI ที่สร้างรายงานจากวิดีโอ และ AI ที่อ่านรายงานครบทุกฉบับ
ในด้าน Near Miss กับ AI เห็นความเคลื่อนไหวได้ 2 สายใหญ่ๆ (การแบ่งเป็น 2 สายนี้เป็นการจัดกลุ่มของบทความนี้เอง)
สายที่ 1 คือ การค้นหา “Near Miss ที่ไม่ได้ถูกรายงาน” จากวิดีโอและเซนเซอร์ เมื่อวันที่ 25 มีนาคม 2026 NEC และ Sumitomo Heavy Industries ประกาศการพัฒนาร่วมกันของระบบที่ดึง Near Miss ออกมาจากภาพของกล้องที่ติดตั้งบนรถขุดไฮดรอลิกและข้อมูลจากเซนเซอร์ แล้วใช้ Generative AI สร้างรายงานสรุปลำดับเหตุการณ์โดยอัตโนมัติ ทั้งสองบริษัทระบุว่าได้ทดสอบพิสูจน์เทคโนโลยีเสร็จในเดือนกันยายน 2025 จะพัฒนาเทคโนโลยีและทดสอบความเป็นไปได้เชิงธุรกิจในปีงบประมาณ 2026 และตั้งเป้าใช้งานจริงในปีงบประมาณ 2027 นี่คือแผน ณ เวลาที่ประกาศ และยังไม่ได้เป็นผลิตภัณฑ์ เป้าหมายก็เป็นวิดีโอของเครื่องจักรก่อสร้าง ไม่ใช่ระบบจัดหมวดหมู่ข้อความในรายงานของโรงงาน ในงานแสดงสินค้าด้านการก่อสร้างและการสำรวจเมื่อเดือนมิถุนายน 2026 ระบบนี้ถูกแนะนำในชื่อ “ฟังก์ชันตรวจจับ Near Miss และสร้างรายงานอัตโนมัติ HAW (ชื่อชั่วคราว)” และข่าวระบุว่าเบื้องหลังคือปัญหาที่รายงาน Near Miss ในไซต์ก่อสร้างไม่ค่อยถูกส่งขึ้นมา แนวคิดการใช้กล้องในโรงงานตรวจจับสถานการณ์อันตรายเราได้กล่าวไว้ในบทความ กล้อง AI เพื่อการจัดการความปลอดภัย
สายที่ 2 คือ การอ่านรายงานที่เป็นข้อความซึ่งคนเขียน ครบทุกฉบับ แล้วจัดหมวดหมู่และสรุป Nomura Research Institute (NRI) เปิดเผยโซลูชันที่ใช้การประมวลผลภาษาธรรมชาติดึงองค์ประกอบที่เกี่ยวกับ Near Miss ออกจากรายงานการปฏิบัติงานแล้วจัดให้เป็นโครงสร้าง และระบุว่ามีกรณีที่ขยายการวิเคราะห์ซึ่งเดิมทำแบบสุ่มตัวอย่างไปเป็นการวิเคราะห์ครบทุกฉบับราว 24,000 ฉบับต่อปี และทำให้อัตโนมัติไปจนถึงการแชร์ผ่านแดชบอร์ด โดยลดเวลาได้ราว 600 ชั่วโมงต่อปี นี่คือค่าจากกรณีการนำไปใช้ 1 กรณีที่ผู้ขายเผยแพร่เอง ไม่ได้หมายความว่าทุกโรงงานจะได้ผลเท่ากัน ในต่างประเทศ Benchmark Gensuite ระบุถึงการรายงานอันตรายผ่านแบบฟอร์มบนมือถือ รวมถึงฟังก์ชัน AI ที่ระบุเหตุการณ์ที่อาจร้ายแรงได้โดยอัตโนมัติ ส่วนนี้ก็เป็น คำกล่าวอ้างของผู้ขาย เช่นกัน ไม่มีการเผยแพร่ตัวเลขความแม่นยำ และเราไม่สามารถยืนยันได้ว่ารองรับภาษาไทยหรือภาษาเวียดนาม
บทความนี้ว่าด้วยสายที่ 2 เป็นหลัก คือการใช้ AI วิเคราะห์รายงานที่เป็นข้อความ
งานวิจัยรู้อะไรแล้วบ้าง
ฝั่งงานวิจัย ในปี 2025 Ando และคณะจาก University of Occupational and Environmental Health ประเทศญี่ปุ่น เผยแพร่ผลการใช้โมเดลภาษาขนาดใหญ่ (LLM) จัดหมวดหมู่รายงานอุบัติเหตุจากการทำงานโดยอัตโนมัติ งานนี้นำข้อมูลอุบัติเหตุจากการทำงานที่ต้องหยุดงานตั้งแต่ 4 วันขึ้นไปของปี 2021 มาคัดเฉพาะผู้บาดเจ็บและเสียชีวิตจาก “การหกล้ม” ในธุรกิจสาธารณสุขและธุรกิจค้าปลีก 2,619 ราย จัดหมวดหมู่ด้วย LLM 4 ชนิด แล้วเทียบกับการจัดหมวดหมู่ด้วยมือของผู้เชี่ยวชาญ โมเดลรุ่นใหม่ได้ค่าสัมประสิทธิ์แคปปา (Kappa: ระดับความสอดคล้องที่หักส่วนที่ตรงกันโดยบังเอิญออกแล้ว) เกินราว 0.7 ในหลายหมวดหมู่ ยกเว้น “สิ่งที่ทำให้เกิดเหตุ” และอัตราความถูกต้องของสถานที่เกิดเหตุ (ในอาคารหรือนอกอาคาร) เกิน 91% ส่วนหมวดสิ่งที่ทำให้เกิดเหตุซึ่งยากที่สุด o4-mini ได้ค่าแคปปา 0.662 การประมวลผลทั้งหมดใช้เวลาประมาณ 90 นาที และค่าใช้จ่ายประมาณ 11 ดอลลาร์สหรัฐ
อย่างไรก็ตาม งานวิจัยนี้ศึกษารายงานอุบัติเหตุจากการทำงานที่เกิดขึ้นจริง ไม่ใช่ Near Miss และเป็นรายงานภาษาญี่ปุ่น จำกัดเฉพาะอุบัติเหตุจากการหกล้มใน 2 ประเภทธุรกิจ จึงไม่สามารถสรุปเหมารวมว่า “ความแม่นยำในการจัดหมวดหมู่ของ LLM คือ 90%” ได้ จะสอดคล้องได้แค่ไหนกับรายงานของบริษัทท่านและระบบหมวดหมู่ของบริษัทท่าน วัดได้ด้วยการทดสอบรับมอบเท่านั้น
ในด้านการเดินเรือ งานวิจัยของ University of Strathclyde ประเทศอังกฤษ ร่วมกับบริษัทเรือข้ามฟาก CalMac Ferries วิเคราะห์รายงาน Near Miss 4,360 ฉบับในช่วง 5 ปีด้วยโมเดลหัวข้อ (topic model) ใช้ GPT ช่วยตั้งชื่อหัวข้อ แล้วตรวจสอบผลลัพธ์ด้วยการทบทวนแบบมีโครงสร้างโดยผู้เชี่ยวชาญหลายคน งานนี้ดึงหัวข้อของเหตุการณ์ได้เกิน 75 หัวข้อ และหัวข้อของมาตรการป้องกัน 87 หัวข้อ พร้อมแสดงความแปรผันตามฤดูกาล เช่น ความเสี่ยงที่เกี่ยวกับผู้โดยสารมีมากในฤดูร้อน และอุปกรณ์ขัดข้องมีมากในฤดูหนาว รวมถึงความเชื่อมโยงระหว่างเหตุการณ์กับมาตรการ งานนี้ศึกษาด้านการเดินเรือ และไม่ได้ให้ตัวเลขอัตราความถูกต้อง แต่เป็นแบบอย่างที่ดีของการออกแบบ “ให้คนตรวจสอบป้ายกำกับที่ AI ติดให้”
นอกจากนี้ งานวิจัยที่ยังไม่ผ่านการประเมินโดยผู้ทรงคุณวุฒิ (ABEX-RAT) ซึ่งศึกษารายงานอุบัติเหตุในงานก่อสร้างของสหรัฐอเมริกา ยกปัญหา “ความไม่สมดุลของคลาสอย่างรุนแรง” ที่ประเภทอุบัติเหตุซึ่งเกิดไม่บ่อยแต่ร้ายแรงกลายเป็นคลาสที่มีข้อมูลน้อย ประเภทที่ร้ายแรงแต่มีจำนวนน้อย AI มักจัดหมวดหมู่ได้ยากกว่า นี่คือเหตุผลที่ในการทดสอบรับมอบซึ่งจะกล่าวภายหลัง เราให้ความสำคัญกับ “การพลาดเหตุการณ์ร้ายแรง” ก่อนอัตราความสอดคล้องโดยรวม
บริบทจากสถิติของญี่ปุ่น
เพื่อเป็นข้อมูลอ้างอิง ขอดูตัวเลขของญี่ปุ่น ตัวเลขต่อไปนี้ทั้งหมดเป็นสถิติของญี่ปุ่น ไม่ใช่ตัวเลขของไทย ตามสถานการณ์อุบัติเหตุจากการทำงานของปีเรวะที่ 7 (ค.ศ. 2025) ที่ MHLW เผยแพร่เมื่อวันที่ 27 พฤษภาคม 2026 (ไม่รวมกรณีติดเชื้อโควิด) จำนวนผู้เสียชีวิตอยู่ที่ 700 คน ซึ่งต่ำที่สุดเป็นประวัติการณ์ และจำนวนผู้บาดเจ็บและเสียชีวิตที่ต้องหยุดงานตั้งแต่ 4 วันขึ้นไปอยู่ที่ 135,333 คน ลดลง 0.3% จากปีก่อน เมื่อแยกตามประเภทธุรกิจ อุตสาหกรรมการผลิตมีผู้บาดเจ็บและเสียชีวิตมากที่สุด 26,371 คน เมื่อแยกตามประเภทอุบัติเหตุ ผู้บาดเจ็บและเสียชีวิตในทุกอุตสาหกรรมมาจาก “การหกล้ม” มากที่สุด 37,195 คน ส่วนผู้เสียชีวิตจาก “การถูกหนีบหรือถูกม้วนเข้าเครื่องจักร” มี 117 คน เพิ่มขึ้น 6.4% จากปีก่อน
แผนป้องกันอุบัติเหตุจากการทำงานฉบับที่ 14 ของญี่ปุ่นตั้งเป้าลดจำนวนผู้บาดเจ็บและเสียชีวิตจาก “การถูกหนีบหรือถูกม้วนเข้า” ที่เกิดจากเครื่องจักรในอุตสาหกรรมการผลิตลงอย่างน้อย 5% ภายในปีเรวะที่ 9 เมื่อเทียบกับปีเรวะที่ 4 (ปีเรวะคือปีตามศักราชของญี่ปุ่น) ประเภทที่เกิดบ่อยอย่างการหกล้ม กับประเภทที่เกิดไม่บ่อยแต่หนักอย่างการถูกหนีบหรือถูกม้วนเข้า การวิเคราะห์ Near Miss ต้องออกแบบให้ไม่มองข้ามทั้งสองแบบ
การวิเคราะห์ Near Miss ด้วย AI คืออะไร: ขอบเขตที่มอบให้ AI และขอบเขตที่คนตัดสินใจ

ลำดับ 4 ขั้นจากรายงานถึงมาตรการ
การวิเคราะห์ Near Miss ด้วย AI จะเข้าใจง่ายขึ้นเมื่อแบ่งเป็น 4 ขั้นใหญ่ๆ ดังนี้
- การรายงาน: ผู้ปฏิบัติงานรายงานเหตุการณ์ที่ทำให้ตกใจผ่านสมาร์ตโฟนหรือกระดาษ
- AI เตรียมข้อมูลเบื้องต้น: แปล สรุป เสนอหมวดหมู่ รวมรายงานที่ซ้ำ และประเมินสถานที่
- รวบรวมสถิติและแสดงผล: นับตามประเภทอุบัติเหตุ สถานที่ และช่วงเวลา แล้วหาจุดที่รายงานกระจุกตัว (hotspot)
- มาตรการและการยืนยันว่าเสร็จสิ้น: กำหนดผู้รับผิดชอบและกำหนดเสร็จ ลงมือแก้ ตรวจผล แล้วปิดเรื่อง
ภาพด้านบนแสดงภาพจำลองของลำดับ 4 ขั้นนี้ AI ทำงานหลักในขั้นที่ 2 และ 3 ส่วนขั้นที่ 1 และ 4 ขึ้นกับการออกแบบคนและระบบ การหารือเรื่องการนำมาใช้มักเอนไปที่ประสิทธิภาพของ AI เพราะขั้นที่ 2 มองเห็นได้ง่ายที่สุด แต่สิ่งที่ชี้ขาดผลลัพธ์จริงๆ กลับเป็นขั้นที่ 1 และ 4
ขอบเขตที่มอบให้ AI ได้
งานที่มอบให้ AI ได้ง่ายคืองาน “เตรียมข้อมูลเบื้องต้น” ดังต่อไปนี้
- การแปล: แปลรายงานภาษาไทย ภาษาเวียดนาม ภาษาอังกฤษ ฯลฯ เป็นภาษาญี่ปุ่น หรือแปลคำสั่งภาษาญี่ปุ่นเป็นภาษาท้องถิ่น
- การสรุป: เรียบเรียงข้อความ LINE ยาวๆ หรือรายงานลายมือให้อยู่ในรูป “เมื่อไร ที่ไหน อะไร และเกือบจะเกิดอะไรขึ้น”
- การเสนอหมวดหมู่: ติดแท็กที่เป็นตัวเลือกให้กับประเภทอุบัติเหตุ สิ่งที่ทำให้เกิดเหตุ สถานที่ และระดับความรุนแรงที่คาดการณ์
- การรวมรายงานที่ซ้ำ: เมื่อหลายคนรายงานเหตุการณ์เดียวกัน ให้เสนอตัวเลือกว่าควรรวมฉบับใด
- การประเมินสถานที่: ประเมินพื้นที่ในโรงงานจากคำเรียกของหน้างาน เช่น “หลังเครื่องปั๊มของไลน์ 2” หรือ “ตรงเสาในพื้นที่ส่งสินค้า”
- การชวนให้เขียนเพิ่ม: เมื่อรายงานขาดสถานที่หรือเวลา ให้ถามกลับตั้งแต่ขั้นกรอกข้อมูล
ทั้งหมดนี้เป็นงาน “เสนอตัวเลือก โดยมีคนยืนยันขั้นสุดท้าย” AI ไม่ได้เป็นผู้ยืนยันหมวดหมู่ แต่ให้เจ้าหน้าที่ความปลอดภัยดูทีละฉบับแล้วอนุมัติหรือแก้ไข
ขอบเขตที่คนตัดสินใจ
ในทางกลับกัน การตัดสินใจต่อไปนี้ต้องคงไว้ให้คน
- การตัดสินระดับความรุนแรงขั้นสุดท้าย: เหตุการณ์นั้นหากพลาดไปอีกนิดจะนำไปสู่อุบัติเหตุร้ายแรงหรือไม่
- การตัดสินใจเลือกมาตรการ: จะป้องกันด้วยอุปกรณ์ เปลี่ยนขั้นตอน หรือเสริมด้วยป้ายและการอบรม
- การมอบหมายผู้รับผิดชอบและกำหนดเสร็จ: ใคร ทำอะไร ภายในเมื่อไร
- การยืนยันว่าเสร็จสิ้นและได้ผล: มาตรการถูกดำเนินการแล้ว และไม่มีรายงานแบบเดิมกลับมาอีก
- การรายงานตามกฎหมาย: กรณีเกิดอุบัติเหตุขึ้นจริง ต้องแจ้งและส่งรายงานเป็นลายลักษณ์อักษรต่อหน่วยงานที่รับผิดชอบ
เหตุผลที่ไม่มอบการตัดสินระดับความรุนแรงให้ AI ก็ตามที่กล่าวไว้ข้างต้น คือประเภทที่ร้ายแรงแต่มีจำนวนน้อย AI มักทำได้ไม่ดี ระดับความรุนแรงที่ AI คาดการณ์ให้ใช้เพื่อ “เรียงลำดับรายงานที่คนควรดูก่อน” ส่วนการตัดสินให้คนเป็นผู้ทำ สำหรับแนวคิดด้านมาตรการ วิธีทำให้อุปกรณ์ไม่เปิดโอกาสให้เกิดความผิดพลาดอยู่ในบทความ Poka-Yoke และวิธีใช้ AI ช่วยเขียนรายงานการปฏิบัติการแก้ไข (corrective action) อยู่ในบทความ AI สำหรับรายงานการแก้ไข
การออกแบบช่องทางการรายงาน: ส่งได้ใน 30 วินาทีหลายภาษา และข้อตกลงไม่กล่าวโทษ
ถ้าช่องทางแคบ AI ก็หาอะไรไม่เจอ
การวิเคราะห์ของ AI ทำงานได้กับรายงานที่ส่งขึ้นมาเท่านั้น ถ้าช่องทางการรายงานใช้ยาก จำนวนก็ไม่เพิ่ม และต่อให้วิเคราะห์ก็มองไม่เห็นว่าอันตรายอยู่ตรงไหน นี่คือเหตุผลที่สิ่งแรกที่ต้องตัดสินใจในการนำมาใช้คือช่องทาง
เกณฑ์คร่าวๆ ที่ดีคือ ผู้ปฏิบัติงานส่งจากสมาร์ตโฟนได้ภายใน 30 วินาทีหรือไม่ ตัวอย่างการออกแบบมีดังนี้
- รายงานได้ทันทีจากแอปที่ใช้อยู่เป็นประจำ (เช่น LINE หรือ Teams)
- ถ่ายรูป 1 รูปแล้วเขียนเพิ่มสั้นๆ ก็ส่งได้ ข้อความสั้นได้
- เขียนด้วยภาษาของตัวเองได้ ทั้งภาษาไทย ภาษาเวียดนาม ภาษาญี่ปุ่น ฯลฯ และเลือกพูดแล้วแปลงเป็นข้อความได้ด้วย
- ระบุสถานที่ได้ด้วยการสแกน QR โค้ดของพื้นที่ หรือเลือกจากแผนผัง
- ไม่บังคับกรอกชื่อผู้รายงาน และคงตัวเลือกส่งแบบไม่ระบุตัวตนไว้
จะคงแบบฟอร์มกระดาษไว้ด้วยก็ได้ บางพื้นที่นำสมาร์ตโฟนเข้าไม่ได้ และบางคนก็ถนัดเขียนมากกว่า รายงานที่ส่งเป็นกระดาษให้ถ่ายรูปแล้วให้ AI อ่าน จากนั้นคนตรวจผลการอ่าน ก็จะนำเข้าทะเบียนเดียวกันได้ แนวคิดการแปลงเอกสารกระดาษ เช่น รายงานประจำวันและบันทึกการตรวจ ให้เป็นดิจิทัล เราได้กล่าวไว้ในบทความ AI สำหรับรายงานประจำวันของโรงงาน และ การแปลงใบตรวจเช็กเป็นดิจิทัล
เขียน “ข้อตกลงไม่กล่าวโทษ” เป็นภาษาท้องถิ่นให้ชัดเจน
ตามคำอธิบายของ MHLW หากไม่มีข้อตกลงว่าจะไม่กล่าวโทษผู้รายงาน ระบบ Near Miss ก็จะอยู่ได้ไม่นาน ในไทยก็เช่นเดียวกัน และเพราะมีกำแพงภาษา หน้างานจึงยิ่งรับรู้ได้ยากว่าผู้บริหารชาวญี่ปุ่นมองรายงานอย่างไร ความกังวลว่า “เขียนไปแล้วจะโดนดุหรือเปล่า” จึงมักหลงเหลืออยู่
ดังนั้นให้เขียนเนื้อหาต่อไปนี้เป็นภาษาท้องถิ่น เช่น ภาษาไทย ให้ชัดเจน แล้วสื่อสารซ้ำในการประชุมเช้าและการอบรมความปลอดภัย
- จะไม่ลดผลประเมินหรือตำหนิด้วยเหตุผลว่ารายงาน Near Miss
- แม้พบว่าไม่ได้ทำตามขั้นตอน ก็จะทบทวนขั้นตอนและอุปกรณ์ก่อน
- จะตอบกลับทุกครั้งว่าได้ทำอะไรกับรายงานนั้น (“ได้รับแล้ว” “กำหนดมาตรการแล้ว” “มาตรการเสร็จแล้ว”)
- จะแชร์และชื่นชมรายงานที่ดี และการปรับปรุงที่เกิดจากรายงาน ภายในบริษัท
เว็บไซต์อธิบาย ISO 45001 ระบุว่าข้อ 5.4 (การปรึกษาหารือและการมีส่วนร่วมของผู้ปฏิบัติงาน) กำหนดให้ระบุและขจัดอุปสรรคต่อการมีส่วนร่วม โดยยกตัวอย่าง เช่น การไม่ตอบสนองต่อข้อเสนอของผู้ปฏิบัติงาน ปัญหาด้านภาษาหรือการอ่านเขียน และนโยบายที่ขัดขวางการมีส่วนร่วม ช่องทางหลายภาษาและการตอบกลับรายงานก็คือความพยายาม “ขจัดอุปสรรค” นี้โดยตรง และการแปลด้วย AI ถือเป็นเครื่องมือลดกำแพงภาษา
วิธีกำหนดระบบหมวดหมู่: ประเภทอุบัติเหตุ สิ่งที่ทำให้เกิดเหตุ สถานที่ และระดับความรุนแรง
กำหนดแกน 4 แกนก่อน
ก่อนให้ AI จัดหมวดหมู่ ต้องกำหนดระบบหมวดหมู่ไว้ก่อน หากสั่ง AI ว่า “จัดหมวดหมู่ให้หน่อย” โดยไม่มีระบบ แต่ละรายงานจะได้แท็กเป็นคำที่ต่างกันไป และนับสถิติไม่ได้
พื้นฐานคือแกน 4 แกนต่อไปนี้
| แกน | เนื้อหา | ตัวอย่าง |
|---|---|---|
| ประเภทอุบัติเหตุ | เกือบเกิดอะไรขึ้น | หกล้ม, ถูกหนีบหรือถูกม้วนเข้า, ตกจากที่สูง, ถูกชน, ถูกบาดหรือถูกครูด, วัตถุปลิวหรือตกใส่ |
| สิ่งที่ทำให้เกิดเหตุ | อะไรเกือบเป็นต้นเหตุ | รถยก (โฟล์กลิฟต์), เครื่องปั๊มขึ้นรูป, สายพานลำเลียง, รถเข็น, บันได, น้ำมันบนพื้น |
| สถานที่ | ตรงไหนในโรงงาน | พื้นที่เครื่องปั๊มโรงงานที่ 1, พื้นที่ส่งสินค้า, ทางเดินในคลังสินค้า, ทางรับของเข้านอกอาคาร |
| ระดับความรุนแรงที่คาดการณ์ | ถ้าเกิดขึ้นจริงจะเสียหายแค่ไหน | อาจถึงขั้นต้องหยุดงาน, ระดับบาดเจ็บเล็กน้อย, ระดับทรัพย์สินเสียหาย |
หากตั้งชื่อประเภทอุบัติเหตุให้สอดคล้องกับการจำแนกในสถิติอุบัติเหตุจากการทำงานของญี่ปุ่น จะรายงานไปยังสำนักงานใหญ่ที่ญี่ปุ่นและเปรียบเทียบกับฐานการผลิตอื่นได้ง่ายขึ้น แต่ถ้าแบ่งละเอียดเกินไป ทั้ง AI และคนจะจัดหมวดหมู่ไม่ตรงกันได้ง่าย การเริ่มจากประเภทหลักราว 10 ประเภท แล้วค่อยเพิ่มเมื่อรายงานที่ตกไปอยู่ใน “อื่นๆ” มีมากขึ้น น่าจะใช้งานได้สะดวกกว่า
ทำตารางจับคู่คำของหน้างานกับคำของฝ่ายบริหาร
จุดที่สะดุดมากที่สุดในการจัดหมวดหมู่คือความไม่ตรงกันระหว่างคำของหน้างานกับคำของฝ่ายบริหาร ผู้ปฏิบัติงานเขียนว่า “รถยกถอยหลังมา เกือบชน” ส่วนในภาษาของฝ่ายบริหารคือ “ถูกชน สิ่งที่ทำให้เกิดเหตุคือรถยก” สถานที่ที่หน้างานเรียกว่า “หลังไลน์ 2” ในแบบแปลนอาจเป็น “ทางเดินด้านตะวันออกของพื้นที่เครื่องปั๊มโรงงานที่ 1”
จึงควรทำตารางที่จับคู่สำนวนที่หน้างานใช้บ่อยกับหมวดหมู่ในระบบ โดยเรียงสำนวนภาษาไทย สำนวนภาษาญี่ปุ่น ชื่อเรียกของพื้นที่ และชื่อในแบบแปลนไว้ด้วยกัน ตารางนี้นำไปใช้เป็นคำสั่งให้ AI (prompt) หรือเป็นตัวอย่างอ้างอิงในการจัดหมวดหมู่ได้ทันที วิธีตรวจสอบว่า Generative AI จัดการข้อความภาษาไทยได้ถูกต้องเพียงใด มีรายละเอียดอยู่ในบทความ การประเมิน Generative AI ภาษาไทย
คำตอบที่ถูกต้องของการจัดหมวดหมู่ ให้เจ้าหน้าที่ความปลอดภัยเป็นผู้สร้าง
การจะตัดสินว่า AI จัดหมวดหมู่ถูกหรือไม่ ต้องมี “คำตอบที่ถูกต้อง” ซึ่งก็คือหมวดหมู่ที่เจ้าหน้าที่ความปลอดภัยเป็นผู้กำหนด รายละเอียดจะอยู่ในหัวข้อการทดสอบรับมอบ แต่โดยสรุปคือ เลือกรายงานในอดีตหลายร้อยฉบับ ให้เจ้าหน้าที่ความปลอดภัย 2 คนจัดหมวดหมู่แยกกัน ฉบับที่ความเห็นไม่ตรงกันให้หารือแล้วตัดสิน ในขั้นนี้ ให้บันทึกสัดส่วนที่ 2 คนจัดไม่ตรงกันไว้ด้วย หมวดหมู่ที่แม้แต่คนด้วยกันยังจัดไม่ตรงกัน การคาดหวังให้ AI สอดคล้องได้มากกว่าคนก็ไม่มีความหมาย ระดับความสอดคล้องระหว่างคนด้วยกันจึงเป็นเกณฑ์คร่าวๆ ของเพดานระดับที่จะคาดหวังจาก AI
จากสถิติสู่มาตรการ: วิธีหา hotspot และผู้รับผิดชอบ กำหนดเสร็จ การยืนยันว่าเสร็จสิ้น
ดู hotspot จาก “สถานที่ x ประเภทอุบัติเหตุ x ช่วงเวลา”
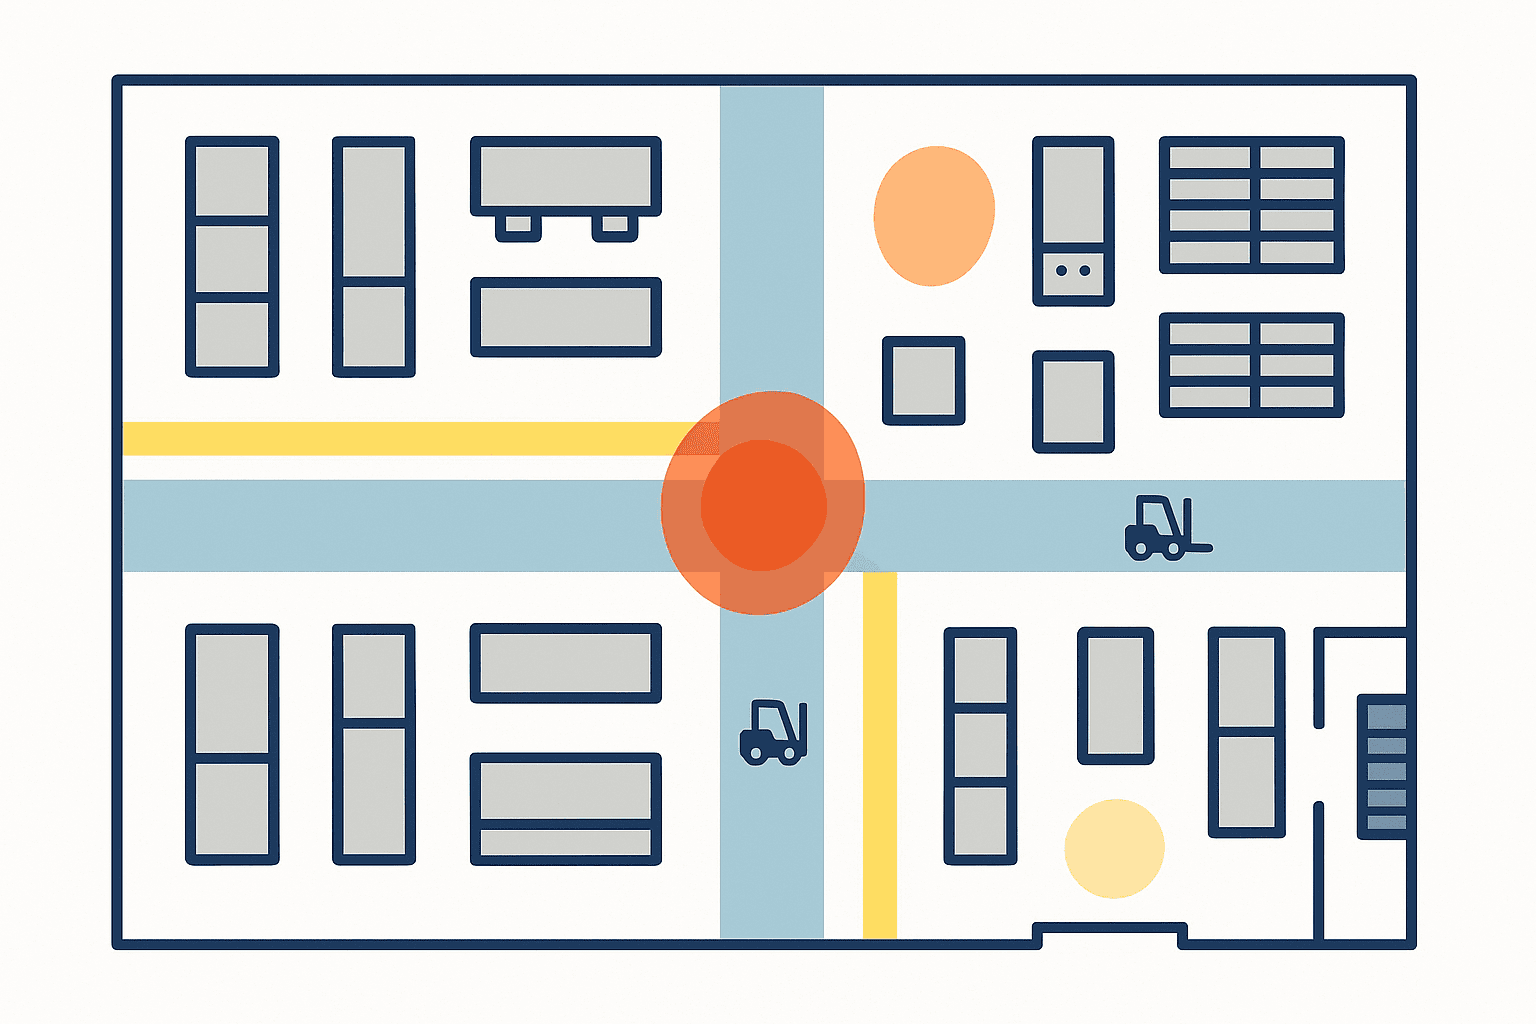
เมื่อรายงานที่จัดหมวดหมู่แล้วสะสมอยู่ในทะเบียน ก็จะเริ่มรวบรวมสถิติได้ สิ่งที่มีประโยชน์ที่สุดคือสถิติแยกตามสถานที่ ภาพด้านบนเป็นภาพจำลองของ heatmap ที่ซ้อนความหนาแน่นของรายงานด้วยความเข้มของสีลงบนแผนผังโรงงาน แสดงจุดที่รายงานมักกระจุกตัว เช่น จุดที่ทางวิ่งของรถยกตัดกับทางเดินของคนเดินเท้า
เมื่อพบ hotspot แล้ว ให้ดูประเภทอุบัติเหตุและช่วงเวลาซ้อนกันด้วย แม้เป็นทางแยกเดียวกัน มาตรการที่ควรทำจะต่างกันไปตามว่า “เกือบชน” กระจุกตัวช่วงก่อนและหลังเปลี่ยนกะ หรือกระจุกตัวในกะกลางคืน AI เหมาะกับการรวบรวมสถิติแบบผสมเงื่อนไขเช่นนี้ และการดึงจุดร่วมจากข้อความอิสระออกมาอย่างรวดเร็ว แต่การอ่านความหมายจากผลสถิติและการตัดสินว่าจะลงมือแก้ที่ไหน ให้คนเป็นผู้ตัดสิน
ถ้าดูแต่ประเภทที่มีจำนวนมาก ก็จะมองข้ามประเภทที่ร้ายแรง ในสถิติของญี่ปุ่นเองก็เช่นกัน ประเภทที่มีผู้บาดเจ็บและเสียชีวิตมากที่สุดคือการหกล้ม แต่ในอันดับต้นของผู้เสียชีวิตกลับมี “การถูกหนีบหรือถูกม้วนเข้า” ซึ่งมีจำนวนผู้บาดเจ็บและเสียชีวิตน้อยกว่าการหกล้มมาก หน้าจอสถิติจึงควรออกแบบให้รายงานที่คาดการณ์ระดับความรุนแรงสูงขึ้นมาอยู่ด้านบนเสมอ แยกจากอันดับตามจำนวน
วาง “ผู้รับผิดชอบ กำหนดเสร็จ การยืนยันว่าเสร็จสิ้น” ไว้หลังการจัดหมวดหมู่
ส่วนนี้คือส่วนที่ถูกมองข้ามบ่อยที่สุดในการวิเคราะห์ Near Miss ด้วย AI ต่อให้การจัดหมวดหมู่และการรวบรวมสถิติเร็วขึ้นเพียงใด หากไม่ได้กำหนดผู้รับผิดชอบและกำหนดเสร็จของมาตรการ และไม่ได้ยืนยันว่าเสร็จสิ้น อันตรายก็ยังคงอยู่เหมือนเดิม
ให้ทะเบียนมีข้อมูล 4 อย่างต่อไปนี้ สำหรับแต่ละรายงานหรือแต่ละ hotspot
- ผู้รับผิดชอบ: ใครเป็นผู้ดำเนินมาตรการ (ระบุเป็นบทบาทแทนชื่อบุคคลก็ได้)
- กำหนดเสร็จ: ต้องทำให้เสร็จภายในเมื่อไร
- เนื้อหามาตรการ: ทำอะไร ด้วยวิธีใด ระหว่างอุปกรณ์ ขั้นตอน ป้าย หรือการอบรม
- การยืนยันผล: หลังทำมาตรการ รายงานจากสถานที่เดิมและประเภทเดิมเปลี่ยนไปอย่างไร
เว็บไซต์อธิบาย ISO 45001 อธิบายว่าข้อ 10.2 กำหนดให้จัดการกับเหตุการณ์ (incident) และความไม่สอดคล้องอย่างทันท่วงที สอบสวนเพื่อระบุสาเหตุ ประเมินความจำเป็นและดำเนินการแก้ไข ทบทวนประสิทธิผล และเก็บบันทึกไว้ รวมถึงกำหนดให้ผู้ปฏิบัติงานมีส่วนร่วมในกระบวนการนี้ด้วย อนึ่ง ตามคำอธิบายนิยามในเว็บไซต์เดียวกัน incident ใน ISO 45001 รวมถึง near miss ด้วย หากยึดแนวคิดนี้ ทะเบียน Near Miss ก็ควรบริหารต่อเนื่องเป็นสายเดียวไปจนถึงการดำเนินมาตรการและการยืนยันผล
AI ช่วยในขั้นตอนนี้ได้เช่นกัน เช่น แจ้งผู้รับผิดชอบเมื่อมาตรการใกล้ถึงกำหนด ดึงมาตรการที่เลยกำหนดขึ้นไปไว้ต้นรายงานประจำเดือน และแจ้งเตือนเมื่อมีรายงานคล้ายเดิมมาจากสถานที่เดิมหลังทำมาตรการแล้ว
ตัวชี้วัดที่ควรดูไม่ใช่ “จำนวน”
ตัวชี้วัดที่ควรติดตามหลังนำ AI มาใช้มีดังนี้
- เวลาตั้งแต่ได้รับรายงานจนมอบหมายผู้รับผิดชอบ
- อัตรามาตรการที่เสร็จภายในกำหนด
- สัดส่วนที่รายงานจากสถานที่เดิมและประเภทเดิมกลับมาอีกหลังมาตรการปิดแล้ว
- สัดส่วนของรายงานที่คาดการณ์ระดับความรุนแรงสูงซึ่งมาตรการปิดแล้ว
- เวลาจนกว่าการตอบกลับจะถึงผู้รายงาน
จำนวนรายงานเองไม่ใช่ตัวชี้วัดที่ควรลด หากทำช่องทางให้ง่าย และข้อตกลงไม่กล่าวโทษสื่อสารไปถึง จำนวนก็จะเพิ่มขึ้นเป็นธรรมดา การมองว่าจำนวนที่เพิ่มขึ้นเป็นสัญญาณว่ามองเห็นอันตรายได้ง่ายขึ้น น่าจะใกล้ความจริงมากกว่า ภาพรวมของการวัดผลการนำ AI มาใช้ ดูเพิ่มเติมได้ที่บทความ การวัดผลการนำ AI มาใช้
ค่าใช้จ่ายและ ROI ของการวิเคราะห์ Near Miss ด้วย AI: การประมาณการแบบจำลอง
ต่อจากนี้เป็นการประมาณการของโรงงานจำลอง ตัวเลขต่อไปนี้ทั้งหมดเป็นค่าประมาณการและค่าสมมติ (ค่าตั้งไว้ชั่วคราว) ที่บทความนี้จัดทำขึ้นเอง ไม่ใช่ค่าเฉลี่ยของอุตสาหกรรมหรือค่าจากการสำรวจ และไม่ได้ใช้ราคาของผู้ขาย
สมมติฐานร่วม (โรงงานจำลอง M)
สมมติเป็นโรงงานผลิตชิ้นส่วนของบริษัทญี่ปุ่นในภาคกลางของไทย
| รายการ | ค่าสมมติ | การคำนวณ |
|---|---|---|
| ขนาด | พนักงานรวมผู้รับเหมาในพื้นที่ประมาณ 600 คน ทำงาน 3 กะ | – |
| จำนวนรายงานปัจจุบัน | 1,800 ฉบับต่อปี (150 ฉบับต่อเดือน) ส่วนใหญ่เป็นภาษาไทยทางกระดาษและ LINE | – |
| เวลาประมวลผลต่อ 1 ฉบับในปัจจุบัน | 10 นาที สำหรับอ่าน แปลเป็นภาษาญี่ปุ่น จัดหมวดหมู่ และกรอกทะเบียน | 1,800×10÷60 = 300 ชั่วโมง/ปี |
| การทำรายงานประจำเดือนในปัจจุบัน | 16 ชั่วโมงต่อเดือน | 16×12 = 192 ชั่วโมง/ปี |
| รวมปัจจุบัน | – | 300+192 = 492 ชั่วโมง/ปี |
| เวลาประมวลผลต่อ 1 ฉบับหลังนำ AI มาใช้ | คนตรวจ 3 นาที | 1,800×3÷60 = 90 ชั่วโมง/ปี |
| การทำรายงานประจำเดือนหลังนำ AI มาใช้ | 4 ชั่วโมงต่อเดือน | 4×12 = 48 ชั่วโมง/ปี |
| รวมหลังนำ AI มาใช้ | – | 90+48 = 138 ชั่วโมง/ปี |
| ค่าแรงเจ้าหน้าที่ความปลอดภัย (สมมติว่ารวมประกันสังคมและอื่นๆ แล้ว) | THB 350/ชั่วโมง | – |
| ค่าใช้จ่ายเริ่มต้น | THB 600,000 (แบบฟอร์มรายงานหลายภาษา ช่องทาง LINE/Teams การออกแบบระบบหมวดหมู่ แดชบอร์ด และการเชื่อมต่อกับทะเบียน) | – |
| ค่าใช้จ่ายรายปี | THB 240,000 (ไลเซนส์ API และการบำรุงรักษา) | – |
| ความเสียหายต่ออุบัติเหตุที่ต้องหยุดงาน 1 ครั้ง | THB 400,000 (ค่าตั้งไว้ชั่วคราวของผลรวมค่ารักษา บุคลากรทดแทน ผลกระทบต่อการผลิต และการรับมือการสอบสวน) | – |
ผลของการลดภาระงานเป็นดังนี้
- เวลาที่ลดได้: 492−138 = 354 ชั่วโมง/ปี
- มูลค่า: 354×350 = THB 123,900/ปี
เปรียบเทียบ 3 กรณี
ผลสุทธิรายปีคือ “ผลรายปี − ค่าใช้จ่ายรายปี” และระยะคืนทุนคือ “ค่าใช้จ่ายเริ่มต้น ÷ ผลสุทธิรายปี” หน่วยเงินทั้งหมดเป็น THB
| กรณี | ผลรายปี | ค่าใช้จ่ายรายปี | ผลสุทธิรายปี | ระยะคืนทุน |
|---|---|---|---|---|
| A ลดภาระการรวบรวมสถิติเท่านั้น | 123,900 | 240,000 | −116,100 | ไม่คืนทุน |
| B ลดภาระ + ป้องกันอุบัติเหตุที่ต้องหยุดงานได้ปีละ 1 ครั้ง | 123,900+400,000 = 523,900 | 240,000 | 283,900 | 600,000÷283,900 = ประมาณ 2.1 ปี |
| C ลดภาระ + ป้องกันอุบัติเหตุที่ต้องหยุดงานได้ 2 ปีต่อ 1 ครั้ง (ปีละ 0.5 ครั้ง) | 123,900+200,000 = 323,900 | 240,000 | 83,900 | 600,000÷83,900 = ประมาณ 7.2 ปี |
กรณี A คือกรณีที่นับเฉพาะการลดภาระการแปล การจัดหมวดหมู่ และการทำรายงานประจำเดือนเป็นผลลัพธ์ 123,900−240,000 = −116,100 หมายความว่าต้องควักเงินเพิ่มปีละ THB 116,100 การลดภาระการรวบรวมสถิติเพียงอย่างเดียวไม่คืนทุน
กรณี B คือกรณีที่นอกจากการลดภาระแล้ว ยังป้องกันอุบัติเหตุที่ต้องหยุดงานได้ปีละ 1 ครั้ง อันเป็นผลจากมาตรการที่ทำตามแนวโน้มที่ AI ค้นพบ ผลรายปีคือ 123,900+400,000 = 523,900 ผลสุทธิรายปีคือ 523,900−240,000 = 283,900 ระยะคืนทุนคือ 600,000÷283,900 = 2.11… หรือ ประมาณ 2.1 ปี
กรณี C คือกรณีที่อุบัติเหตุที่ต้องหยุดงานซึ่งป้องกันได้มีเพียง 2 ปีต่อ 1 ครั้ง (ปีละ 0.5 ครั้ง) ผลการป้องกันอุบัติเหตุคือ 400,000×0.5 = 200,000 ผลรายปีคือ 123,900+200,000 = 323,900 ผลสุทธิรายปีคือ 323,900−240,000 = 83,900 ระยะคืนทุนคือ 600,000÷83,900 = 7.15… หรือ ประมาณ 7.2 ปี
กรณีที่รายงานเพิ่มขึ้น
สมมติว่าเมื่อทำช่องทางให้ง่ายขึ้นแล้ว รายงานเพิ่มเป็นเท่าตัวเป็น 3,600 ฉบับต่อปี เวลาตรวจเมื่อมี AI จะเป็น 3,600×3÷60 = 180 ชั่วโมง รวมกับรายงานประจำเดือน 48 ชั่วโมง เป็น 228 ชั่วโมง/ปี ซึ่งต่ำกว่า 492 ชั่วโมงในปัจจุบัน แม้จำนวนจะเพิ่มเป็นเท่าตัว หากนับเฉพาะเวลาตรวจรายงานและทำรายงานประจำเดือน ภาระของเจ้าหน้าที่ความปลอดภัยก็ยังเบากว่าปัจจุบันตามการคำนวณ
อย่างไรก็ตาม เราไม่นำ 228 ชั่วโมงนี้ไปบวกเป็นมูลค่าผลลัพธ์ การเพิ่มขึ้นของรายงานเป็นเป้าหมายในตัวเอง และผลลัพธ์นับไว้แล้วจากการลดภาระและการป้องกันอุบัติเหตุในกรณี A ถึง C หากนำเวลาที่สมมติว่าประมวลผลจำนวนที่เพิ่มขึ้นด้วยมือแบบปัจจุบัน (เช่น 3,600 ฉบับ×10 นาที) ไปบวกเป็นผลการลดเวลา ก็จะกลายเป็นการลดเวลาที่ในปัจจุบันไม่ได้เกิดขึ้นจริง และนับผลลัพธ์เกินจริง
ประเด็นสำคัญ: สิ่งที่ชี้ขาดการคืนทุนคือ “อุบัติเหตุที่ป้องกันได้”
สิ่งที่บอกได้จากการประมาณการนี้คือ สิ่งที่ชี้ขาดการคืนทุนไม่ใช่ความแม่นยำในการจัดหมวดหมู่ และไม่ใช่การลดภาระการรวบรวมสถิติ แต่คือ “มาตรการที่ทำตามแนวโน้มที่ AI ค้นพบ ป้องกันอุบัติเหตุที่ต้องหยุดงานได้จริงหรือไม่” การลดภาระอย่างเดียวในกรณี A ไม่ถึงค่าใช้จ่ายรายปี สิ่งที่สร้างความแตกต่างคือผลของการป้องกันอุบัติเหตุ
และจำนวนที่ป้องกันได้นั้นต่างกันโดยสิ้นเชิงในแต่ละโรงงาน ปีละ 1 ครั้งหรือปีละ 0.5 ครั้งในที่นี้เป็นค่าตั้งไว้ชั่วคราวเพื่อการคำนวณ ไม่ใช่ตัวเลขที่มีหลักฐานรองรับ นอกจากนี้ การนำ AI มาใช้เพียงอย่างเดียวไม่ได้ทำให้อุบัติเหตุลดลง ผลการป้องกันอุบัติเหตุเกิดขึ้นได้ก็ต่อเมื่อรายงานถูกส่งขึ้นมา พบ hotspot กำหนดผู้รับผิดชอบและกำหนดเสร็จของมาตรการ และมาตรการปิดได้จริง หากกลไกหลังการจัดหมวดหมู่ไม่หมุน ผลนี้จะเป็น 0
หากในขั้น PoC (Proof of Concept) ตัดสินใจนำมาใช้จริงจากความแม่นยำในการจัดหมวดหมู่เพียงอย่างเดียว โดยไม่วัด “จนกว่ามาตรการจะปิด” ก็มีแนวโน้มจะตกอยู่ในสภาพแบบกรณี A วิธีจบ PoC และเกณฑ์ตัดสินใจนำมาใช้จริง ดูเพิ่มเติมได้ที่บทความ เกณฑ์การจบ AI PoC
ข้อควรระวังเพื่อไม่ให้นับซ้ำ
- การลดภาระคือเวลาของเจ้าหน้าที่ความปลอดภัย ส่วนการป้องกันอุบัติเหตุคือความเสียหายจากอุบัติเหตุ เป็นคนละสิ่งกัน จึงนำมารวมกันได้
- การป้องกันอุบัติเหตุนับ “เฉพาะกรณีที่ป้องกันได้อันเป็นผลจากมาตรการที่ทำตามการวิเคราะห์ของ AI” ไม่รวมส่วนที่ลดลงโดยไม่เกี่ยวกับการนำ AI มาใช้
- เวลาตรวจในกรณีที่รายงานเพิ่มขึ้น (228 ชั่วโมง) ไม่นำไปบวกเป็นมูลค่าผลลัพธ์
- การลดเวลาแปลรวมอยู่ในเวลาประมวลผล 10 นาทีต่อ 1 ฉบับแล้ว ไม่นำไปบวกแยก
เมื่อคำนวณเอง ขอให้แทนค่าอย่างน้อย 5 รายการ คือ “จำนวนรายงานต่อปี” “เวลาประมวลผลต่อ 1 ฉบับ” “เวลาทำรายงานประจำเดือน” “ค่าแรงเจ้าหน้าที่ความปลอดภัย” และ “ความเสียหายต่ออุบัติเหตุที่ต้องหยุดงาน 1 ครั้ง” ด้วยค่าจริง จำนวนอุบัติเหตุที่ป้องกันได้นั้นไม่สามารถรู้ล่วงหน้า ต้องตรวจสอบหลังนำมาใช้โดยเทียบบันทึกมาตรการกับบันทึกอุบัติเหตุ
12 รายการที่ควรเขียนใน RFP ของ AI วิเคราะห์ Near Miss
เมื่อขอข้อเสนอจากผู้ขายหลายราย ให้เขียน 12 รายการต่อไปนี้ใน RFP เพื่อให้สมมติฐานของข้อเสนอตรงกัน
| No. | รายการ | สิ่งที่ต้องเขียน |
|---|---|---|
| 1 | ช่องทางการรายงานและภาษา | ประเภทช่องทาง เช่น LINE, Teams, เว็บฟอร์ม, รูปถ่ายของกระดาษ ภาษาที่รองรับ (ภาษาไทย ภาษาญี่ปุ่น ภาษาอังกฤษ ภาษาเวียดนาม ฯลฯ) มีการป้อนด้วยเสียงหรือไม่ และรายงานแบบไม่ระบุตัวตนได้หรือไม่ |
| 2 | ข้อมูลเป้าหมายและการย้ายข้อมูลในอดีต | จะย้ายรายงานย้อนหลังกี่ปี รูปแบบของกระดาษ Excel และประวัติ LINE และการแบ่งงานในการย้ายข้อมูล |
| 3 | ระบบหมวดหมู่และบทบาทของ AI | หมวดหมู่ของประเภทอุบัติเหตุ สิ่งที่ทำให้เกิดเหตุ สถานที่ และระดับความรุนแรง และลำดับงานที่ AI ติดเพียงตัวเลือก ส่วนคนเป็นผู้ยืนยัน |
| 4 | การจัดการรายงานที่ AI ไม่มั่นใจ | AI ตอบว่า “ไม่ทราบ” ได้หรือไม่ กลไกส่งรายงานที่ความมั่นใจต่ำให้คน และค่าเกณฑ์ของกลไกนั้น |
| 5 | เกณฑ์การพลาดเหตุการณ์ร้ายแรง | ประเมินการพลาดเหตุการณ์ร้ายแรง เช่น การถูกหนีบหรือถูกม้วนเข้า งานบนที่สูง การเฉี่ยวชนกับรถยก แยกจากอัตราความสอดคล้องโดยรวม |
| 6 | เกณฑ์คุณภาพการแปลและการสรุป | ประเมินความผิดพลาดของปฏิเสธ จำนวน และสถานที่ และมีหน้าจอให้ตรวจต้นฉบับกับคำแปลเคียงกัน |
| 7 | การแจ้งเตือนและการมอบหมายผู้รับผิดชอบ | การแจ้งเตือนทันทีสำหรับรายงานที่คาดการณ์ระดับความรุนแรงสูง มอบหมายผู้รับผิดชอบอัตโนมัติได้หรือไม่ ผู้รับการแจ้งเตือนและช่องทางแจ้งเตือน |
| 8 | การติดตามความคืบหน้าของมาตรการ | บริหารผู้รับผิดชอบ กำหนดเสร็จ เนื้อหามาตรการ และการยืนยันผลในทะเบียนได้หรือไม่ และการแจ้งเตือนเมื่อเลยกำหนด |
| 9 | ข้อมูลส่วนบุคคลและ PDPA | การปิดบัง (masking) ชื่อผู้รายงาน ชื่อผู้เกี่ยวข้อง และข้อมูลการบาดเจ็บ สิทธิ์การเข้าดู ระยะเวลาเก็บรักษา การประมวลผลก่อนส่งให้ AI และสถานที่จัดเก็บข้อมูล |
| 10 | บันทึกการตรวจสอบย้อนหลังและประวัติการแก้ไข | ใครแก้หมวดหมู่ของ AI เมื่อไร และเก็บทั้งรายงานต้นฉบับและหมวดหมู่หลังแก้ไขไว้ได้หรือไม่ |
| 11 | การส่งออกเป็นข้อมูลสำหรับรายงานตามกฎหมายและเอกสารคณะกรรมการความปลอดภัย | รูปแบบการส่งออกเอกสารประจำเดือนของคณะกรรมการความปลอดภัย และข้อมูลที่เป็นวัตถุดิบของรายงานตามกฎหมาย (ไม่ใช่สิ่งที่ใช้แทนรายงานตามกฎหมาย) |
| 12 | การสนับสนุนในประเทศและหน้าจอภาษาไทย | การรองรับภาษาไทยของหน้าจอ แบบฟอร์ม และการแจ้งเตือน การรับเรื่องสอบถามภายในประเทศไทยและเวลาทำการ |
โดยเฉพาะข้อ 4, 5 และ 6 เป็นรายการที่มักไม่ได้เขียนไว้ในข้อเสนอ กลไกที่ AI ติดหมวดหมู่ที่ดูน่าเชื่อถือให้เงียบๆ แม้กับรายงานที่ไม่มั่นใจ อันตรายกว่ากลไกที่ตอบตรงๆ ว่า “ไม่ทราบ” ต่อให้อัตราความสอดคล้องโดยรวมสูง หากพลาดเหตุการณ์ร้ายแรงไปแม้เพียง 1 ฉบับ การวิเคราะห์นั้นก็เชื่อถือในฐานะเครื่องมือจัดการความปลอดภัยไม่ได้ หากการแปลเปลี่ยน “ไม่ได้ทำ” เป็น “ทำ” หรือเปลี่ยน “2 เมตร” เป็น “20 เมตร” ทิศทางของมาตรการก็จะเปลี่ยนไปด้วย
ข้อ 9 สำคัญเป็นพิเศษในกรณีที่ออกแบบให้ส่งข้อความรายงานไปยังบริการ Generative AI ภายนอก เพราะรายงานอาจมีเนื้อหาการบาดเจ็บหรือชื่อของผู้เกี่ยวข้อง ภาพรวมของวิธีส่งข้อมูลให้ Generative AI และการจัดการข้อมูล ดูเพิ่มเติมได้ที่บทความ มาตรการป้องกันข้อมูลรั่วไหลจาก Generative AI
สิ่งที่ต้องตรวจใน FAT/SAT ของ AI วิเคราะห์ Near Miss
สร้างชุดข้อมูลประเมินก่อน
ก่อนการทดสอบรับมอบ ให้สร้างชุดข้อมูลประเมิน ตัวอย่างเช่น คัดรายงานในอดีตออกมา 300 ฉบับ ให้มีภาษาไทย ภาษาญี่ปุ่น ภาษาอังกฤษ และภาษาเวียดนามปนกัน และรวมรูปถ่ายรายงานลายมือกับข้อความ LINE สั้นๆ ไว้ด้วย จากนั้นให้เจ้าหน้าที่ความปลอดภัย 2 คนจัดหมวดหมู่ (ประเภทอุบัติเหตุ สิ่งที่ทำให้เกิดเหตุ สถานที่ ระดับความรุนแรงที่คาดการณ์) แล้วใช้เป็น “คำตอบที่ถูกต้อง” ฉบับที่ 2 คนจัดไม่ตรงกันให้หารือแล้วตัดสิน และ บันทึกสัดส่วนที่จัดไม่ตรงกันไว้ด้วย เพราะระดับความสอดคล้องระหว่างคนด้วยกันคือเกณฑ์คร่าวๆ ของเพดานความสอดคล้องที่จะคาดหวังจาก AI
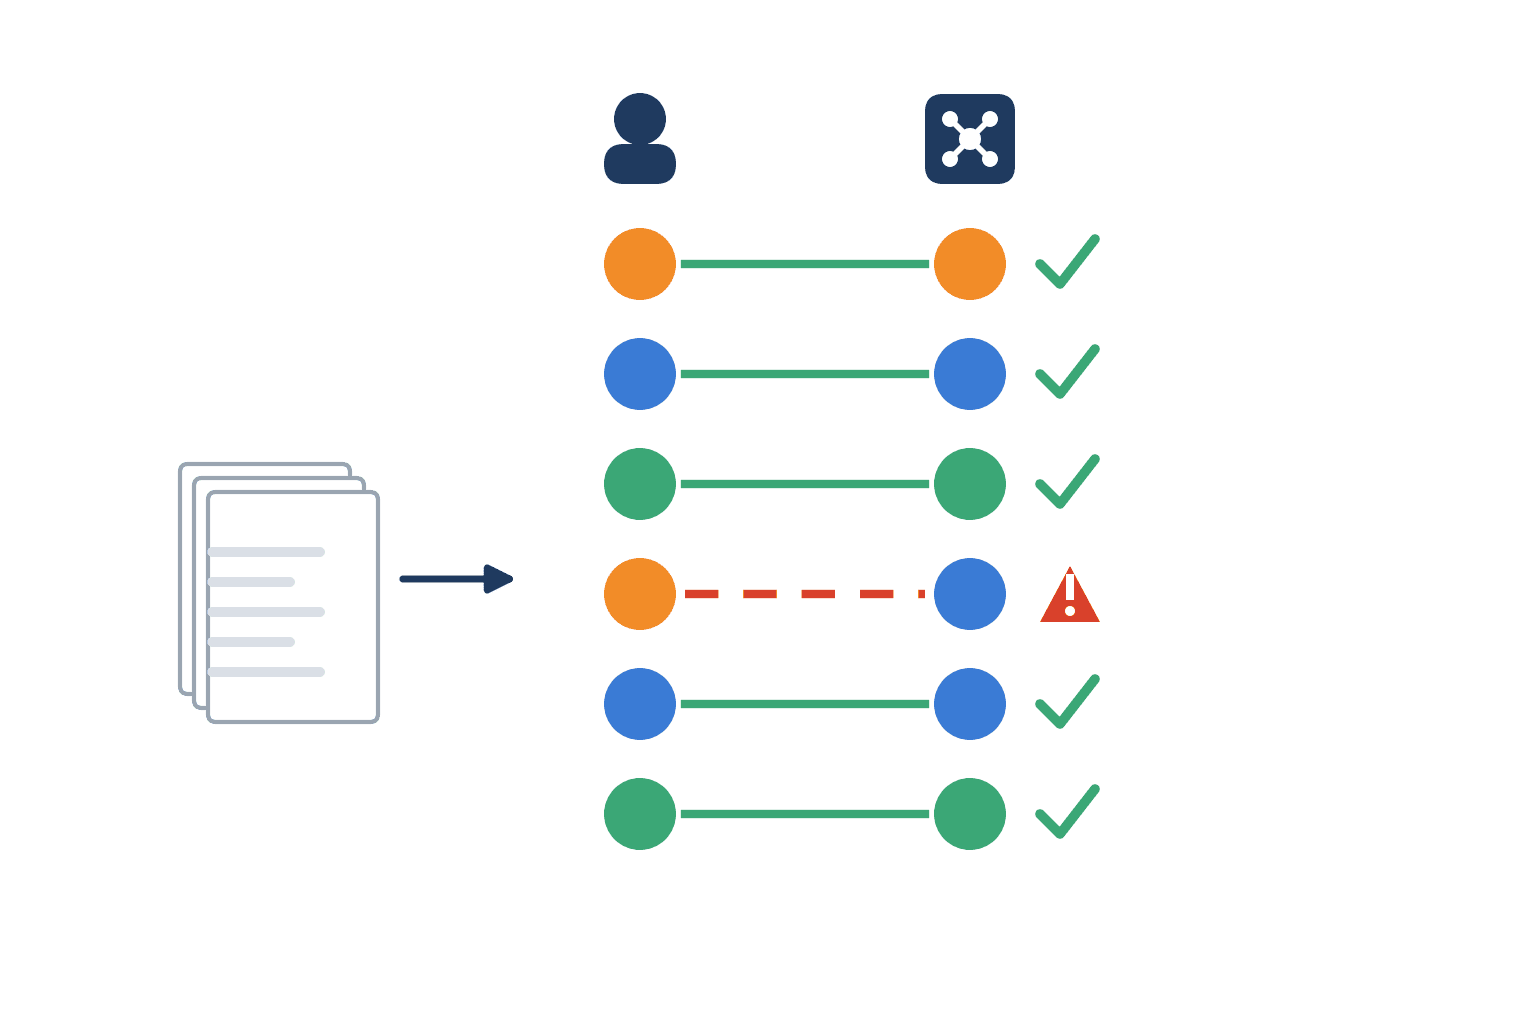
ภาพด้านบนเป็นภาพจำลองของการทดสอบรับมอบ ที่วางหมวดหมู่ของคน (ซ้าย) กับหมวดหมู่ของ AI (ขวา) เทียบกัน ติดคำเตือนที่ฉบับที่ไม่ตรงกัน แล้วให้คนตรวจ
ใน FAT (การทดสอบในสภาพแวดล้อมของผู้ขาย) ให้ส่งชุดข้อมูลประเมินให้ผู้ขายแล้วทดสอบในสภาพแวดล้อมของผู้ขาย ใน SAT (การทดสอบด้วยข้อมูลจริงของบริษัทผ่านช่องทางที่ใช้งานจริง) ให้ป้อนตามขั้นตอนเดียวกันจากช่องทางการรายงานจริง การใช้ชุดข้อมูลประเมินเดียวกันและขั้นตอนเดียวกันกับทั้งสองการทดสอบ ทำให้เห็นเป็นตัวเลขได้ว่า ในสภาพแวดล้อมของผู้ขายทำได้ดี แต่ที่ช่องทางหน้างานกลับไม่ได้ผลหรือไม่ แนวคิดทั่วไปในการทดสอบรับมอบระบบที่มี AI ฝังอยู่ เราได้กล่าวไว้ในบทความ การทดสอบรับมอบ AI Agent
ค่าเป้าหมายต่อไปนี้เป็นตัวอย่างที่ตั้งไว้ชั่วคราว ไม่ใช่ค่ามาตรฐาน เกณฑ์ผ่านให้โรงงานกำหนดเอง
ตัวชี้วัดที่ต้องดู
- ความสอดคล้องรายหมวดหมู่: คำนวณอัตราความสอดคล้องกับการจัดหมวดหมู่ของคน และค่าสัมประสิทธิ์แคปปา แยกตามหมวดหมู่ ตัวอย่างเป้าหมายคือ “หมวดหมู่หลักใกล้เคียงกับระดับความสอดคล้องระหว่างคนด้วยกัน” อย่าดูแต่ค่าเฉลี่ยรวม ให้ดูหมวดหมู่ที่มักจัดไม่ตรงกัน เช่น สิ่งที่ทำให้เกิดเหตุ เป็นรายหมวด
- จำนวนเหตุการณ์ร้ายแรงที่พลาด: นับจำนวนเหตุการณ์ร้ายแรงที่ AI พลาด เช่น การถูกหนีบหรือถูกม้วนเข้า งานบนที่สูง การเฉี่ยวชนกับรถยก เป็นตัวชี้วัดที่ต้องดูก่อนอัตราความสอดคล้องโดยรวม ตัวอย่างเป้าหมายคือ 0 ฉบับ
- ตอบว่า “ไม่ทราบ” ได้หรือไม่: มีกลไกที่ AI ส่งรายงานที่ความมั่นใจต่ำให้คนหรือไม่ และตรวจว่า AI ไม่ได้ให้หมวดหมู่ที่ดูน่าเชื่อถือทั้งที่ความมั่นใจต่ำ
- การแปลและการสรุปเปลี่ยนความหมายหรือไม่: ตรวจเทียบกับต้นฉบับว่าไม่มีความผิดพลาดของปฏิเสธ (ทำ/ไม่ได้ทำ) จำนวน (ระยะทาง น้ำหนัก จำนวนคน) และสถานที่ (ไลน์ไหน ทางเดินไหน)
- เวลาตั้งแต่รายงานจนแจ้งเตือนและมอบหมายผู้รับผิดชอบ: เวลาตั้งแต่รายงานที่คาดการณ์ระดับความรุนแรงสูงถูกส่งขึ้นมา จนการแจ้งเตือนถึงผู้รับผิดชอบและมีการมอบหมาย
- การจัดการชื่อบุคคลและข้อมูลการบาดเจ็บ: การปิดบังทำงานหรือไม่ การแสดงผลเปลี่ยนตามสิทธิ์การเข้าดูหรือไม่ และข้อมูลถูกลบเมื่อพ้นระยะเวลาเก็บรักษาหรือไม่
- บันทึกการตรวจสอบย้อนหลัง: บันทึกว่าใครแก้หมวดหมู่ของ AI ถูกเก็บไว้พร้อมหมวดหมู่ก่อนแก้หรือไม่
หลังใช้งานจริงแล้วก็ให้คนจัดหมวดหมู่ซ้ำเดือนละ 1 ครั้งเพื่อตรวจสอบ
ผ่านการทดสอบรับมอบแล้วก็ยังไม่จบ วิธีเขียนรายงานเปลี่ยนไปตามฤดูกาลและการเปลี่ยนตัวคน และตัวโมเดลของ Generative AI เองก็อาจถูกอัปเดต หลังใช้งานจริงจึง ควรสุ่มเลือก 20 ฉบับเดือนละ 1 ครั้ง ให้คนจัดหมวดหมู่ซ้ำ แล้วตรวจระดับความสอดคล้องกับ AI หากความสอดคล้องลดลง ให้ทบทวนตารางจับคู่และตัวอย่างอ้างอิงในการจัดหมวดหมู่ หากแนบผลการตรวจรายเดือนนี้ไว้กับเอกสารของคณะกรรมการความปลอดภัย คณะกรรมการก็จะรับรู้ร่วมกันได้ว่าการวิเคราะห์ของ AI เชื่อถือได้ถึงระดับใด
ประเด็นเฉพาะของไทยและอาเซียน
1. รายงานอุบัติเหตุตามกฎหมายไม่สามารถใช้สถิติจาก AI แทนได้
มาตรา 34 ของพระราชบัญญัติความปลอดภัย อาชีวอนามัย และสภาพแวดล้อมในการทำงาน พ.ศ. 2554 (ค.ศ. 2011) กำหนดหน้าที่ของนายจ้างเมื่อเกิดอุบัติเหตุร้ายแรงในสถานประกอบกิจการ เป็นต้น ตามคำแปลภาษาอังกฤษอย่างไม่เป็นทางการ เมื่อลูกจ้างเสียชีวิต นายจ้างต้องแจ้งพนักงานตรวจความปลอดภัยทางโทรศัพท์ โทรสาร หรือช่องทางอื่นทันทีที่ทราบ และส่งรายละเอียดและสาเหตุเป็นลายลักษณ์อักษรภายใน 7 วันนับแต่วันที่ลูกจ้างเสียชีวิต กรณีอัคคีภัย การระเบิด การรั่วไหล หรืออุบัติภัยร้ายแรงอื่นที่ทำให้สถานประกอบกิจการเสียหาย ต้องหยุดการผลิต หรือมีผู้บาดเจ็บ ต้องแจ้งทันที และส่งรายงานเป็นลายลักษณ์อักษรที่ระบุสาเหตุและมาตรการป้องกันการเกิดซ้ำภายใน 7 วันนับแต่วันเกิดเหตุ สำหรับการบาดเจ็บหรือเจ็บป่วยที่อยู่ในขอบเขตของเงินทดแทน เมื่อรายงานต่อสำนักงานประกันสังคมแล้ว ต้องส่งสำเนาให้พนักงานตรวจความปลอดภัยภายใน 7 วัน การฝ่าฝืนมีโทษปรับไม่เกิน 50,000 บาท
สถิติ Near Miss จาก AI ไม่สามารถใช้แทนรายงานตามกฎหมายนี้ได้ อนึ่ง มาตรานี้ไม่ได้กำหนดหน้าที่ให้แจ้ง Near Miss ประโยชน์ของทะเบียนจาก AI คือ เมื่อเกิดอุบัติเหตุขึ้นจริง สามารถดึงรายงานในอดีตและประวัติมาตรการที่เกี่ยวข้องออกมาได้ทันที และรวบรวมวัตถุดิบของรายงานตามกฎหมายได้เร็วขึ้น ผู้มีหน้าที่รายงานและกำหนดเวลาเป็นไปตามกฎหมาย และไม่เปลี่ยนแปลงแม้นำ AI มาใช้ สำหรับแนวปฏิบัติล่าสุดและการปรับใช้กับบริษัทท่าน ขอให้ตรวจสอบกับหน่วยงานที่รับผิดชอบหรือผู้เชี่ยวชาญเป็นรายกรณี
2. จะนำสถิติจาก AI ไปใช้กับคณะกรรมการความปลอดภัยและการวิเคราะห์สถิติของ จป. อย่างไร
กฎกระทรวงการจัดให้มีเจ้าหน้าที่ความปลอดภัยในการทำงาน บุคลากร หน่วยงาน หรือคณะบุคคลเพื่อดำเนินการด้านความปลอดภัยในสถานประกอบกิจการ พ.ศ. 2565 (ค.ศ. 2022) กำหนดระดับและการจัดให้มีเจ้าหน้าที่ความปลอดภัยในการทำงาน (จป.) ตามข้อ 25 สถานประกอบกิจการที่มีลูกจ้างตั้งแต่ 50 คนขึ้นไปต้องจัดให้มีคณะกรรมการความปลอดภัย อาชีวอนามัย และสภาพแวดล้อมในการทำงานภายใน 30 วันนับแต่วันที่มีลูกจ้างครบจำนวนดังกล่าว และตามข้อ 33 คณะกรรมการต้องประชุมอย่างน้อยเดือนละ 1 ครั้ง หน้าที่ของ จป. ระดับเทคนิครวมถึงการรวบรวมสถิติ แล้วจัดทำรายงานและข้อเสนอแนะเสนอต่อนายจ้าง ส่วน จป. ระดับเทคนิคขั้นสูงและระดับวิชาชีพมีหน้าที่วิเคราะห์ข้อมูลเพิ่มเติมด้วย
สถิติจาก AI จึงถือเป็นเครื่องมือที่ช่วยให้งาน “รวบรวม รายงาน และวิเคราะห์สถิติ” นี้เร็วขึ้น ตัวอย่างการใช้งาน เช่น นำเสนอต่อคณะกรรมการความปลอดภัยประจำเดือน ได้แก่ รายการ hotspot อัตรามาตรการที่เสร็จภายในกำหนด มาตรการที่เลยกำหนด รายงานที่คาดการณ์ระดับความรุนแรงสูงและสถานะการดำเนินการ และผลการตรวจความสอดคล้องของ AI รายเดือน การอ่านผลวิเคราะห์และการจัดทำข้อเสนอแนะเป็นงานของ จป. และคณะกรรมการ ระดับของการจัดให้มี จป. แตกต่างกันตามประเภทกิจการ จึงขอให้ตรวจสอบกับหน่วยงานที่รับผิดชอบหรือผู้เชี่ยวชาญ รวมถึงว่าบริษัทท่านอยู่ในระดับใด
3. PDPA: ข้อมูลการบาดเจ็บและสุขภาพเป็นข้อมูลอ่อนไหว
พระราชบัญญัติคุ้มครองข้อมูลส่วนบุคคล พ.ศ. 2562 (PDPA) ของไทยมีผลบังคับใช้เต็มรูปแบบเมื่อวันที่ 1 มิถุนายน 2022 ตามคำแปลภาษาอังกฤษอย่างไม่เป็นทางการ มาตรา 26 โดยหลักแล้วห้ามเก็บรวบรวมข้อมูลส่วนบุคคลที่อ่อนไหว เช่น ข้อมูลสุขภาพ โดยไม่ได้รับความยินยอมโดยชัดแจ้งจากเจ้าของข้อมูล ข้อยกเว้นที่ระบุไว้ ได้แก่ กรณีป้องกันอันตรายต่อชีวิต ร่างกาย หรือสุขภาพ (เมื่อเจ้าของข้อมูลไม่สามารถให้ความยินยอมได้) กรณีจำเป็นต่อการเรียกร้องตามกฎหมาย และกรณีจำเป็นเพื่อปฏิบัติตามกฎหมาย (เช่น เวชศาสตร์ป้องกันหรืออาชีวเวชศาสตร์ การประเมินความสามารถในการทำงานของลูกจ้าง การคุ้มครองแรงงานและการประกันสังคม โดยทั้งหมดมีเงื่อนไขว่าต้องมีมาตรการคุ้มครองที่เหมาะสม) ตามบทความอธิบายกฎหมาย การฝ่าฝืนบางประเภทอาจมีโทษทางปกครองสูงสุด 5,000,000 บาท หรือโทษทางอาญาจำคุกไม่เกิน 1 ปี
รายงาน Near Miss อาจมีเนื้อหาการบาดเจ็บ เช่น “นิ้วถูกบาดเล็กน้อย” “ปวดหลัง” หรือโรคประจำตัว ซึ่งอาจเข้าข่ายข้อมูลสุขภาพ สิ่งที่ต้องกำหนดในการออกแบบมีดังนี้
- การจัดการชื่อผู้รายงานและชื่อผู้เกี่ยวข้อง (ไม่บังคับกรอก และคงตัวเลือกรายงานแบบไม่ระบุตัวตนไว้)
- การปิดบังข้อมูลก่อนส่งให้ Generative AI (ชื่อ รหัสพนักงาน รายละเอียดการบาดเจ็บ)
- สิทธิ์การเข้าดู (แยกคนที่ดูข้อความเต็มได้ กับคนที่ดูได้เฉพาะสถิติ)
- ระยะเวลาเก็บรักษาและขั้นตอนการลบ
การตัดสินว่าจะประมวลผลภายใต้ข้อยกเว้นใดได้ ขอให้มอบให้นักกฎหมายพิจารณา ความสัมพันธ์ระหว่างข้อมูลของโรงงานกับ PDPA เราได้กล่าวไว้ในบทความ IoT ในโรงงานกับ PDPA
4. หลายภาษา: ส่งถึงผู้บริหารชาวญี่ปุ่นโดยไม่เปลี่ยนความหมาย
เมื่อส่งรายงานภาษาไทยถึงผู้บริหารชาวญี่ปุ่น สิ่งที่น่ากลัวที่สุดคือความหมายเปลี่ยนไปในการแปล คำปฏิเสธหายไป หลักของจำนวนเปลี่ยน “ขวา” กับ “ซ้าย” สลับกัน หมายเลขไลน์คลาดเคลื่อน ความผิดพลาดเช่นนี้ คนที่อ่านแต่คำแปลจะไม่สามารถสังเกตเห็นได้
มาตรการมี 2 อย่าง อย่างที่ 1 คือทดสอบความผิดพลาดของการแปลอย่างเป็นรูปธรรมในการทดสอบรับมอบ อีก 1 อย่างคือให้หน้าจอทะเบียนแสดงต้นฉบับกับคำแปลเคียงกันเสมอ เพื่อให้ผู้รับผิดชอบที่อ่านภาษาไทยได้ย้อนกลับไปดูต้นฉบับได้ทุกเมื่อ ในโรงงานที่มีรายงานในภาษาอื่นปนอยู่ ให้ใส่รายงานในภาษานั้นไว้ในชุดข้อมูลประเมินด้วย
5. ข้อตกลงไม่กล่าวโทษจะสื่อถึงได้ก็ต่อเมื่อเขียนเป็นภาษาท้องถิ่น
กฎการปฏิบัติที่ไม่กล่าวโทษผู้รายงาน หากเขียนไว้เพียงในระเบียบภาษาญี่ปุ่นก็จะไม่ไปถึงหน้างาน ต้องเขียนให้ชัดเจนเป็นภาษาท้องถิ่น เช่น ภาษาไทย และเตรียมให้หัวหน้าทีมหรือหัวหน้างานอธิบายได้ด้วยคำพูดของตัวเอง การตอบกลับรายงานก็ต้องตอบเป็นภาษาของผู้รายงาน การแปลด้วย AI ยังใช้ลดภาระของงาน “ตอบกลับเป็นภาษาท้องถิ่น” นี้ได้ด้วย
6. ฐานการผลิตในเวียดนาม: กฎหมายคุ้มครองข้อมูลส่วนบุคคล Law 91/2025/QH15
หากมีฐานการผลิตในเวียดนาม ให้ตรวจสอบกฎหมายคุ้มครองข้อมูลส่วนบุคคล (Law No. 91/2025/QH15) ซึ่งผ่านความเห็นชอบของรัฐสภาเมื่อวันที่ 26 มิถุนายน 2025 และมีผลบังคับใช้เมื่อวันที่ 1 มกราคม 2026 ตามคำแปลภาษาอังกฤษของฐานข้อมูลกฎหมาย โทษปรับสูงสุดคือ 5% ของรายได้ปีก่อนหน้าสำหรับการฝ่าฝืนเรื่องการโอนข้อมูลข้ามพรมแดน 10 เท่าของรายได้จากการฝ่าฝืนสำหรับการซื้อขายข้อมูล และ 3,000 ล้านด่องสำหรับการฝ่าฝืนอื่นๆ หากออกแบบให้ประมวลผลรายงาน Near Miss ของโรงงานในเวียดนามในไทย ญี่ปุ่น หรือบนคลาวด์ในต่างประเทศ ขอให้ตรวจสอบขั้นตอนการโอนข้อมูลข้ามพรมแดน ขอบเขตของข้อมูลอ่อนไหวเป็นไปตามรายการที่รัฐบาลกำหนด จึงปลอดภัยกว่าหากตรวจสอบกับผู้เชี่ยวชาญ รวมถึงการจัดการข้อมูลที่เกี่ยวกับสุขภาพด้วย
แผน 90 วันสำหรับการนำ AI วิเคราะห์รายงาน Near Miss มาใช้
การนำมาใช้ให้ดำเนินเป็น 3 ระยะ โดยใช้เวลาประมาณ 90 วัน
วันที่ 0-30: สำรวจข้อมูลที่มีและสร้างคำตอบที่ถูกต้อง
- รวบรวมรายงาน Near Miss ย้อนหลัง 1 ปี และนับจำนวนแยกตามรูปแบบ เช่น กระดาษ LINE Excel
- กำหนดระบบหมวดหมู่ของประเภทอุบัติเหตุ สิ่งที่ทำให้เกิดเหตุ สถานที่ และระดับความรุนแรง แล้วทำตารางจับคู่กับคำของหน้างาน
- เลือกรายงานในอดีต 300 ฉบับ ให้เจ้าหน้าที่ความปลอดภัย 2 คนจัดหมวดหมู่เพื่อสร้างคำตอบที่ถูกต้อง และบันทึกสัดส่วนที่จัดไม่ตรงกันไว้ด้วย
- จัดทำข้อตกลงไม่กล่าวโทษผู้รายงานเป็นเอกสารภาษาท้องถิ่น
วันที่ 31-60: ทดลองใน 1 ไลน์และเทียบผล
- ทดลองช่องทางการรายงาน (รายงานจากสมาร์ตโฟน) ใน 1 ไลน์หรือ 1 พื้นที่
- เทียบหมวดหมู่ของ AI กับหมวดหมู่ของคน นับความสอดคล้องรายหมวดหมู่และการพลาดเหตุการณ์ร้ายแรง
- ตรวจว่าไม่มีความผิดพลาดของการแปล (ปฏิเสธ จำนวน สถานที่)
- วัดจำนวนรายงานและเวลาที่ผู้รายงานใช้ในการกรอก
วันที่ 61-90: วัดว่ามาตรการปิดได้หรือไม่ แล้วตัดสินใจนำมาใช้จริง
- มอบหมายผู้รับผิดชอบและกำหนดเสร็จให้กับ hotspot ในพื้นที่ทดลอง และวัดอัตรามาตรการที่เสร็จภายในกำหนด
- วัดเวลาตั้งแต่รายงานจนมอบหมายผู้รับผิดชอบ
- กำหนดขอบเขตการนำมาใช้จริง RFP (12 รายการข้างต้น) และเกณฑ์ผ่านของ FAT/SAT แล้วตัดสินว่าจะสั่งซื้อหรือไม่
แม้ ณ วันที่ 60 ความสอดคล้องของการจัดหมวดหมู่จะเพียงพอ แต่หาก ณ วันที่ 90 ยังไม่มีมาตรการใดปิดได้เลย ก็ควรทบทวนกลไกหลังการจัดหมวดหมู่ก่อนนำมาใช้จริง ในทางกลับกัน แม้ความสอดคล้องจะอยู่ในระดับพอใช้ หากจำนวนรายงานเพิ่มขึ้นและมาตรการเริ่มหมุน การจัดหมวดหมู่ของ AI ก็คุ้มค่าที่จะใช้ต่อไปโดยมีสมมติฐานว่าคนเป็นผู้ตรวจ
คำถามที่พบบ่อย (FAQ)
การจัดหมวดหมู่รายงาน Near Miss อัตโนมัติด้วย AI แม่นยำได้แค่ไหน?
มีงานวิจัยที่ใช้ LLM จัดหมวดหมู่รายงานอุบัติเหตุจากการทำงานของญี่ปุ่น (อุบัติเหตุจากการหกล้มใน 2 ประเภทธุรกิจ 2,619 ราย) และพบว่าโมเดลรุ่นใหม่ได้ค่าสัมประสิทธิ์แคปปาเกินราว 0.7 ในหลายหมวดหมู่ ยกเว้นสิ่งที่ทำให้เกิดเหตุ และอัตราความถูกต้องของการแยกในอาคารหรือนอกอาคารเกิน 91% ส่วนหมวดสิ่งที่ทำให้เกิดเหตุซึ่งยากที่สุดได้ค่าแคปปา 0.662 อย่างไรก็ตาม งานนี้ศึกษารายงานอุบัติเหตุจากการทำงานที่เกิดขึ้นจริง ไม่ใช่ Near Miss หากประเภทธุรกิจ ประเภทอุบัติเหตุ หรือระบบหมวดหมู่ต่างไป ผลก็ต่างไปด้วย ขอให้วัดความสอดคล้องด้วยรายงานของบริษัทท่านและระบบหมวดหมู่ของบริษัทท่านในช่วงการทดสอบรับมอบ
เมื่อใช้ AI รวบรวมและวิเคราะห์ข้อมูล Near Miss จำนวนรายงานเป็นตัวชี้วัดที่ควรลดหรือไม่?
ไม่ใช่ตัวชี้วัดที่ควรลด หากทำช่องทางให้ง่ายและข้อตกลงไม่กล่าวโทษผู้รายงานสื่อสารไปถึง จำนวนก็จะเพิ่มขึ้นเป็นธรรมดา และการเพิ่มขึ้นอาจเป็นสัญญาณว่ามองเห็นอันตรายได้ง่ายขึ้น สิ่งที่ควรติดตามคือเวลาตั้งแต่รายงานจนมอบหมายผู้รับผิดชอบ อัตรามาตรการที่เสร็จภายในกำหนด และสัดส่วนที่รายงานจากสถานที่เดิมและประเภทเดิมกลับมาอีกหลังทำมาตรการ
รายงาน Near Miss ภาษาไทยหรือหลายภาษา AI วิเคราะห์ได้หรือไม่?
หากใช้การแปลและการสรุปของ Generative AI ก็สามารถเรียบเรียงรายงานภาษาไทย ภาษาเวียดนาม ภาษาอังกฤษ ฯลฯ ให้อยู่ในรูปที่ผู้บริหารชาวญี่ปุ่นอ่านได้ แต่หากการแปลทำให้ปฏิเสธ จำนวน หรือสถานที่ผิดไป ทิศทางของมาตรการก็จะเปลี่ยนไปด้วย ขอให้ทดสอบความผิดพลาดอย่างเป็นรูปธรรมในการทดสอบรับมอบ และออกแบบให้ทะเบียนแสดงต้นฉบับกับคำแปลเคียงกัน
ค่าใช้จ่ายในการนำ AI วิเคราะห์ Near Miss มาใช้และระยะคืนทุนโดยประมาณเป็นเท่าไร?
ในการประมาณการแบบจำลองของบทความนี้ (ทั้งหมดเป็นค่าตั้งไว้ชั่วคราว) เมื่อค่าใช้จ่ายเริ่มต้น THB 600,000 และค่าใช้จ่ายรายปี THB 240,000 การลดภาระการรวบรวมสถิติเพียงอย่างเดียวให้ผลเพียง THB 123,900 ต่อปี และไม่คืนทุน หากมาตรการที่ทำตามการวิเคราะห์ของ AI ป้องกันอุบัติเหตุที่ต้องหยุดงานได้ปีละ 1 ครั้ง จะคืนทุนในประมาณ 2.1 ปี และหาก 2 ปีต่อ 1 ครั้ง จะคืนทุนในประมาณ 7.2 ปีตามการคำนวณ จำนวนที่ป้องกันได้ต่างกันโดยสิ้นเชิงในแต่ละโรงงาน และการนำ AI มาใช้เพียงอย่างเดียวไม่ได้ทำให้อุบัติเหตุลดลง ขอให้คำนวณใหม่ด้วยผลจริงและใบเสนอราคาของบริษัทท่าน
ใช้สถิติจาก AI แทนรายงานอุบัติเหตุตามกฎหมายของไทยได้หรือไม่?
ไม่ได้ มาตรา 34 ของพระราชบัญญัติความปลอดภัย อาชีวอนามัย และสภาพแวดล้อมในการทำงาน พ.ศ. 2554 กำหนดให้นายจ้างแจ้งทันทีและส่งรายงานเป็นลายลักษณ์อักษรภายใน 7 วัน เป็นต้น สำหรับอุบัติเหตุที่มีผู้เสียชีวิตหรืออุบัติภัยร้ายแรง ทะเบียนจาก AI ใช้เพื่อรวบรวมวัตถุดิบของรายงานตามกฎหมายให้เร็วขึ้นได้ แต่ไม่สามารถใช้แทนตัวรายงานได้ การประชุมคณะกรรมการความปลอดภัยและหน้าที่ของ จป. ก็เช่นเดียวกัน สำหรับแนวปฏิบัติล่าสุดและการปรับใช้กับบริษัทท่าน ขอให้ตรวจสอบกับหน่วยงานที่รับผิดชอบหรือผู้เชี่ยวชาญเป็นรายกรณี
ใน RFP และการทดสอบรับมอบ (FAT/SAT) ของ AI วิเคราะห์ Near Miss ควรตรวจอะไรบ้าง?
ใน RFP ให้เขียน 12 รายการ เช่น ช่องทางการรายงานและภาษา ระบบหมวดหมู่และบทบาทของ AI การจัดการรายงานที่ AI ไม่มั่นใจ เกณฑ์การพลาดเหตุการณ์ร้ายแรง เกณฑ์คุณภาพการแปลและการสรุป การติดตามความคืบหน้าของมาตรการ PDPA และบันทึกการตรวจสอบย้อนหลัง ในการทดสอบรับมอบ ให้ใช้หมวดหมู่ที่เจ้าหน้าที่ความปลอดภัย 2 คนจัดให้กับรายงานในอดีต 300 ฉบับเป็นคำตอบที่ถูกต้อง แล้วตรวจความสอดคล้องรายหมวดหมู่ จำนวนเหตุการณ์ร้ายแรงที่พลาด การตอบว่า “ไม่ทราบ” ได้หรือไม่ ความผิดพลาดของความหมายในการแปล เวลาจนถึงการแจ้งเตือนและการมอบหมายผู้รับผิดชอบ การจัดการข้อมูลส่วนบุคคล และบันทึกการตรวจสอบย้อนหลัง
สรุป
- การวิเคราะห์ Near Miss ด้วย AI จะได้ผลหรือไม่ ไม่ได้ตัดสินจากความแม่นยำในการจัดหมวดหมู่ แต่ตัดสินจากว่า รายงานส่งได้ง่ายขึ้นจนจำนวนเพิ่มขึ้น และเวลาจนกว่ามาตรการจะถูกมอบหมายและปิดได้สั้นลงหรือไม่
- สิ่งที่มอบให้ AI มีเพียงการแปล การสรุป การเสนอหมวดหมู่ การรวมรายงานที่ซ้ำ และการประเมินสถานที่ ส่วนการตัดสินระดับความรุนแรงขั้นสุดท้าย มาตรการ ผู้รับผิดชอบและกำหนดเสร็จ และการยืนยันว่าเสร็จสิ้น ให้คนเป็นผู้ตัดสิน
- ช่องทางการรายงานคือ “ส่งจากสมาร์ตโฟนใน 30 วินาที ด้วยภาษาของตัวเอง และไม่ถูกกล่าวโทษ” ข้อตกลงไม่กล่าวโทษต้องเขียนเป็นภาษาท้องถิ่นให้ชัดเจน
- คำตอบที่ถูกต้องของการจัดหมวดหมู่ให้เจ้าหน้าที่ความปลอดภัยเป็นผู้สร้าง และใช้ความสอดคล้องระหว่างคนด้วยกันเป็นเกณฑ์คร่าวๆ ของระดับที่คาดหวังจาก AI
- ในการประมาณการแบบจำลอง (ค่าตั้งไว้ชั่วคราว) การลดภาระการรวบรวมสถิติเพียงอย่างเดียวไม่คืนทุน สิ่งที่ชี้ขาดการคืนทุนคือมาตรการที่ทำตามการวิเคราะห์ของ AI ป้องกันอุบัติเหตุได้จริงหรือไม่
- ในการทดสอบรับมอบ ให้ดูการพลาดเหตุการณ์ร้ายแรงและความผิดพลาดของการแปลก่อนอัตราความสอดคล้องโดยรวม
- หน้าที่ด้านรายงานอุบัติเหตุตามกฎหมาย คณะกรรมการความปลอดภัย และ PDPA ของไทย ไม่เปลี่ยนแปลงแม้นำ AI มาใช้ การปรับใช้กฎหมายขอให้ตรวจสอบกับหน่วยงานที่รับผิดชอบหรือผู้เชี่ยวชาญ
จะเริ่มปรึกษาตั้งแต่ขั้นสำรวจรายงานในอดีต การสร้างระบบหมวดหมู่ หรือการสร้างข้อมูลคำตอบที่ถูกต้องร่วมกับเจ้าหน้าที่ความปลอดภัยก็ได้ หากท่านกำลังพิจารณาการนำ AI วิเคราะห์รายงาน Near Miss มาใช้ในโรงงานในไทย เราช่วยเรียบเรียงประเด็นร่วมกันได้ตั้งแต่จุดเริ่มต้นของการพิจารณา สามารถปรึกษาได้อย่างสบายใจผ่านแบบฟอร์มติดต่อ
ข้อมูลอ้างอิง
- กฎของไฮน์ริช (เว็บไซต์ความปลอดภัยในที่ทำงาน กระทรวงสาธารณสุข แรงงาน และสวัสดิการของญี่ปุ่น): https://anzeninfo.mhlw.go.jp/yougo/yougo24_1.html
- Near Miss (เว็บไซต์ความปลอดภัยในที่ทำงาน กระทรวงสาธารณสุข แรงงาน และสวัสดิการของญี่ปุ่น): https://anzeninfo.mhlw.go.jp/yougo/yougo26_1.html
- Examining the foundation (Safety+Health magazine, 1 ตุลาคม 2011): https://www.safetyandhealthmagazine.com/articles/6368-examining-the-foundation
- การพัฒนาร่วมกันของ NEC และ Sumitomo Heavy Industries สำหรับระบบดึง Near Miss และสร้างรายงานอัตโนมัติ (NEC, 25 มีนาคม 2026): https://jpn.nec.com/press/202603/20260325_02.html
- การแนะนำฟังก์ชันตรวจจับ Near Miss และสร้างรายงานอัตโนมัติ HAW (ชื่อชั่วคราว) (Norimono News, 25 มิถุนายน 2026): https://trafficnews.jp/post/681242/2
- Ando และคณะ การจัดหมวดหมู่รายงานอุบัติเหตุจากการทำงานอัตโนมัติด้วย LLM (บทคัดย่อ medRxiv, ตุลาคม 2025): https://api.biorxiv.org/details/medrxiv/10.1101/2025.10.02.25337141
- Uncovering patterns in ferry near-misses (Ocean Engineering, University of Strathclyde): https://strathprints.strath.ac.uk/96699/1/Black-etal-OE-2026-Uncovering-patterns-in-ferry-near-misses-a-topic.pdf
- ABEX-RAT (arXiv, กันยายน 2025): https://arxiv.org/abs/2509.02072
- การวิเคราะห์ Near Miss (Nomura Research Institute): https://www.nri.com/jp/service/solution/incident_analysis_ai.html
- Concern Reporting Software (Benchmark Gensuite): https://benchmarkgensuite.com/app/concern-reporting-software
- สถานการณ์อุบัติเหตุจากการทำงานปีเรวะที่ 7 (MHLW, เผยแพร่ 27 พฤษภาคม 2026): https://www.mhlw.go.jp/stf/newpage_73382.html
- สถานการณ์อุบัติเหตุจากการทำงานปีเรวะที่ 6 (MHLW, เผยแพร่ 30 พฤษภาคม 2025): https://www.mhlw.go.jp/stf/newpage_58198.html
- คำแปลภาษาอังกฤษอย่างไม่เป็นทางการของพระราชบัญญัติความปลอดภัย อาชีวอนามัย และสภาพแวดล้อมในการทำงาน พ.ศ. 2554 (Open Development Mekong): https://data.opendevelopmentmekong.net/dataset/a3d165ff-700e-4c32-a4eb-dd6b393e866b/resource/b171c6cf-58a1-46d7-a30e-fb4734dd2d24/download/occupational-safety-health-and-environment-act-b.e.-2554-a.d.-2011.pdf
- Occupational health and safety regulations in Thailand (Gratanet, 14 พฤศจิกายน 2025): https://gratanet.com/publications/occupational-health-and-safety-regulations-in-thailand
- กฎกระทรวงการจัดให้มีเจ้าหน้าที่ความปลอดภัยในการทำงาน พ.ศ. 2565 (PDF ราชกิจจานุเบกษา เผยแพร่ซ้ำโดย SHECU จุฬาลงกรณ์มหาวิทยาลัย): https://www.shecu.chula.ac.th/data/boards/748/กฎกระทรวง%20การจัดให้มีเจ้าหน้าที่ความปลอดภัยในการทำงาน%202565.PDF
- คำแปลภาษาอังกฤษอย่างไม่เป็นทางการของพระราชบัญญัติคุ้มครองข้อมูลส่วนบุคคล พ.ศ. 2562 (มหาวิทยาลัยมหาสารคาม): https://pdpa.msu.ac.th/wp-content/uploads/2022/05/EN-PDPA-2019.pdf
- Thailand Personal Data Protection Act (Securiti): https://securiti.ai/thailand-personal-data-protection-act-pdpa
- กฎหมายคุ้มครองข้อมูลส่วนบุคคลของเวียดนาม Law No. 91/2025/QH15 (LuatVietnam): https://english.luatvietnam.vn/dan-su/law-on-personal-data-protection-law-no-91-2025-qh15-405135-d1.html
- คำอธิบาย ISO 45001 ข้อ 10.2 (Presencis): https://cdn.presencis.com/regulations/iso-45001/article-10.2/
- คำอธิบายนิยาม incident ของ ISO 45001 (Presencis): https://cdn.presencis.com/regulations/iso-45001/definitions/incident/
- คำอธิบาย ISO 45001 ข้อ 5.4 (ISO 9001 Checklist): https://www.iso-9001-checklist.co.uk/iso-45001/5.4-consultation-and-participation-of-workers.htm


