


เมื่อนำ Generative AI ภาษาไทยมาใช้ในโรงงานหรือบริษัทในประเทศไทย เดโมภาษาญี่ปุ่นหรือภาษาอังกฤษที่ตอบได้ลื่นไหลยังไม่ใช่หลักฐานว่าระบบพร้อมใช้งานจริง สิ่งที่องค์กรควรจัดซื้อคือ “ความเป็นไปได้ในการปฏิบัติงาน” ได้แก่ การค้นเอกสารภาษาไทยที่ถูกต้อง การรักษาชื่อเฉพาะ ตัวเลข วันที่ และคำปฏิเสธ การหยุดตอบเมื่อไม่มีหลักฐาน การคุ้มครองข้อมูล และการควบคุมระบบโดยพนักงานท้องถิ่น บทความนี้อัปเดต ณ วันที่ 31 สิงหาคม 2026 และเชื่อมตั้งแต่ RFP ชุดทดสอบภาษาไทย การประเมิน RAG แผน PoC ตัวอย่าง 90 วัน การทดสอบรับมอบ จนถึงเงื่อนไขสัญญา
ข้อสรุป: จัดซื้อความพร้อมในการใช้งาน ไม่ใช่ชื่อโมเดล
ข้อเสนอด้าน AI มักเริ่มจากชื่อโมเดล จำนวนพารามิเตอร์ context window และคำตอบตัวอย่างที่ดูดี ข้อมูลเหล่านี้ช่วยคัดกรองเบื้องต้นได้ แต่ยังตอบไม่ได้ว่า AI จะแยกคำว่า “เปลี่ยนแล้ว” ออกจาก “ยังไม่ได้เปลี่ยน” ในรายงานซ่อมบำรุงได้หรือไม่ จะรักษาจุดทศนิยมของแรงดันได้หรือไม่ จะอ้างระเบียบจัดซื้อฉบับปัจจุบันแทนฉบับเก่าได้หรือไม่ และหัวหน้างานจะตรวจสอบเหตุผลของคำตอบได้หรือไม่
ก่อนออก RFP ฝั่งผู้ซื้อควรกำหนดสินทรัพย์สำหรับการประเมินห้าประการ
- กระบวนการงาน สิ่งที่ AI ทำได้ และสิ่งที่ห้ามทำ
- คอร์ปัสงานจริงภาษาไทยและคำตอบที่เจ้าของงานอนุมัติ
- เกณฑ์บังคับผ่านตามระดับความเสี่ยง และเกณฑ์ให้คะแนน
- การตรวจอัตโนมัติร่วมกับการประเมินโดยผู้ปฏิบัติงานที่ใช้ภาษาไทย
- เงื่อนไขสัญญาเรื่องการติดตาม การเปลี่ยนแปลง เหตุการณ์ผิดปกติ และการยุติบริการ
เมื่อมีสิ่งเหล่านี้ องค์กรสามารถนำเกณฑ์เดิมไปประเมินโมเดลรุ่นใหม่ได้ หากเลือกโมเดลก่อนแล้วค่อยหากรณีใช้งานภายหลัง ตารางคะแนนมักโน้มเอียงไปตามจุดเด่นของผลิตภัณฑ์ เป้าหมายของการจัดซื้อไม่ใช่ “AI ที่ดีที่สุดโดยทั่วไป” แต่คือระบบที่ควบคุมได้ในขั้นตอนงานของบริษัท
เหตุใดเดโมภาษาญี่ปุ่นหรืออังกฤษจึงไม่พอสำหรับงานภาษาไทย
เดโมสำหรับสำนักงานใหญ่ส่วนใหญ่มักใช้เอกสารที่สะอาด คำถามสั้น และตัวอย่างที่เตรียมไว้ดี แต่งานจริงในไทยมีชื่ออะไหล่ภาษาอังกฤษปะปนกับภาษาไทย คำย่อเฉพาะฝ่าย ข้อความจาก OCR ที่เพี้ยน ปีพุทธศักราชและคริสต์ศักราช หน่วยที่ละไว้ ภาษาพูดในรายงานประจำวัน ตลอดจนเอกสารหลายสถานะ เช่น ฉบับร่าง ฉบับอนุมัติ ฉบับปัจจุบัน และฉบับยกเลิก
คำตอบที่อ่านลื่นก็อาจไม่ผ่านงาน หากระบบ:
- สรุป “ยังไม่ได้เปลี่ยน” เป็น “เปลี่ยนเรียบร้อยแล้ว”
- สับสนรหัส AB-120 กับ AB-102
- เปลี่ยน 3.5 bar เป็น 35 bar
- แปลงปีพุทธศักราชผิด
- อ้างระเบียบจัดซื้อฉบับเก่าเป็นฉบับปัจจุบัน
- แต่งชื่อผู้อนุมัติ ราคา หรือวันครบกำหนดขึ้นเอง
- ตอบภาษาอังกฤษทั้งที่กำหนดให้ตอบภาษาไทย
ความผิดพลาดเหล่านี้ไม่ควรถูกกลบด้วยคะแนนเฉลี่ยเดียว งานด้านความปลอดภัย คุณภาพ การจ่ายเงิน และบุคคลต้องมี mandatory gate หรือเกณฑ์บังคับผ่าน ความผิดร้ายแรงเพียงหนึ่งกรณีอาจทำให้ไม่ผ่าน แม้ภาษาจะสวยงามก็ตาม ตัวอย่างหนึ่งคือ model card ของ Qwen-SEA-LION-v4.5-27B-IT ที่ระบุว่า ในการประเมิน หากตอบผิดจากภาษาที่กำหนดให้ถือว่าล้มเหลว ประเด็นนี้ไม่ได้พิสูจน์ว่าโมเดลใดดีกว่า แต่แสดงว่าต้องกำหนดพฤติกรรมที่ยอมรับได้ก่อนทดสอบ
กำหนดขอบเขต Adopter, Customizer หรือ Maker ก่อนออก RFP
แนวทาง Generative AI Governance Guideline for Organizations ของ ETDA แบ่งรูปแบบการประยุกต์ใช้ในองค์กรตามความซับซ้อนเป็น Adopter, Customizer และ Maker โดย Adopter ใช้บริการสำเร็จรูป Customizer ปรับให้ตรงกับองค์กร เช่น ทำ RAG หรือปรับโมเดลเพิ่มเติม ส่วน Maker พัฒนา foundation model ขึ้นใหม่ การแบ่งนี้ไม่ใช่การจัดอันดับคุณภาพ แต่ช่วยชี้ว่าบริษัทต้องรับผิดชอบข้อมูล บุคลากร การกำกับดูแล และสัญญาในระดับใด
| ประเด็นตัดสินใจ | Adopter | Customizer | Maker |
|---|---|---|---|
| ขอบเขตทั่วไป | บริการ GenAI สำเร็จรูป | RAG เวิร์กโฟลว์ และการปรับแต่ง | พัฒนา foundation model ใหม่ |
| สิ่งที่ผู้ซื้อประเมิน | การควบคุม tenant เงื่อนไขข้อมูล ฟังก์ชันมาตรฐาน | การค้นคืน การเชื่อมระบบ prompt และการควบคุมการเปลี่ยนแปลง | ข้อมูลฝึก การพัฒนาโมเดล และวงจรชีวิตทั้งหมด |
| การประเมินภาษาไทย | ความเหมาะสมของ input/output งานจริง | แยกทดสอบ retrieval กับ generation | ประเมินหลายชั้นตั้งแต่การฝึกจนถึงการเดินระบบ |
| คำถามหลักใน RFP | input, log และสิทธิ์ถูกควบคุมอย่างไร | ดึงหลักฐานใดและอ้างอิงอย่างไร | ใครรับรองคุณภาพ ความปลอดภัย และสิทธิอย่างต่อเนื่อง |
บริษัทญี่ปุ่นในไทยอาจใช้ทั้งเครื่องมือ Adopter สำหรับร่างข้อความทั่วไป และระบบ Customizer สำหรับค้นเอกสารภายใน ต้องจำแนกเป็นรายกรณี ไม่เช่นนั้นอาจคาดหวังการพัฒนาเฉพาะจากไลเซนส์มาตรฐาน หรือเปรียบเทียบโครงการ RAG เหมือนซื้อ subscription ทั่วไป
ทิศทาง AI 2026 ของ ETDA ใช้แนวคิด “Driving Trust AI Governance” ความไว้วางใจไม่ได้เกิดจากฉลากคุณสมบัติ แต่เกิดจากเจ้าของงานที่รับผิดชอบ หลักฐานทดสอบ กติกาการใช้ การติดตาม และการแก้ไข ดังนั้นข้อกำหนดเทคนิคและ operating model ต้องอยู่ในการตัดสินใจเดียวกัน
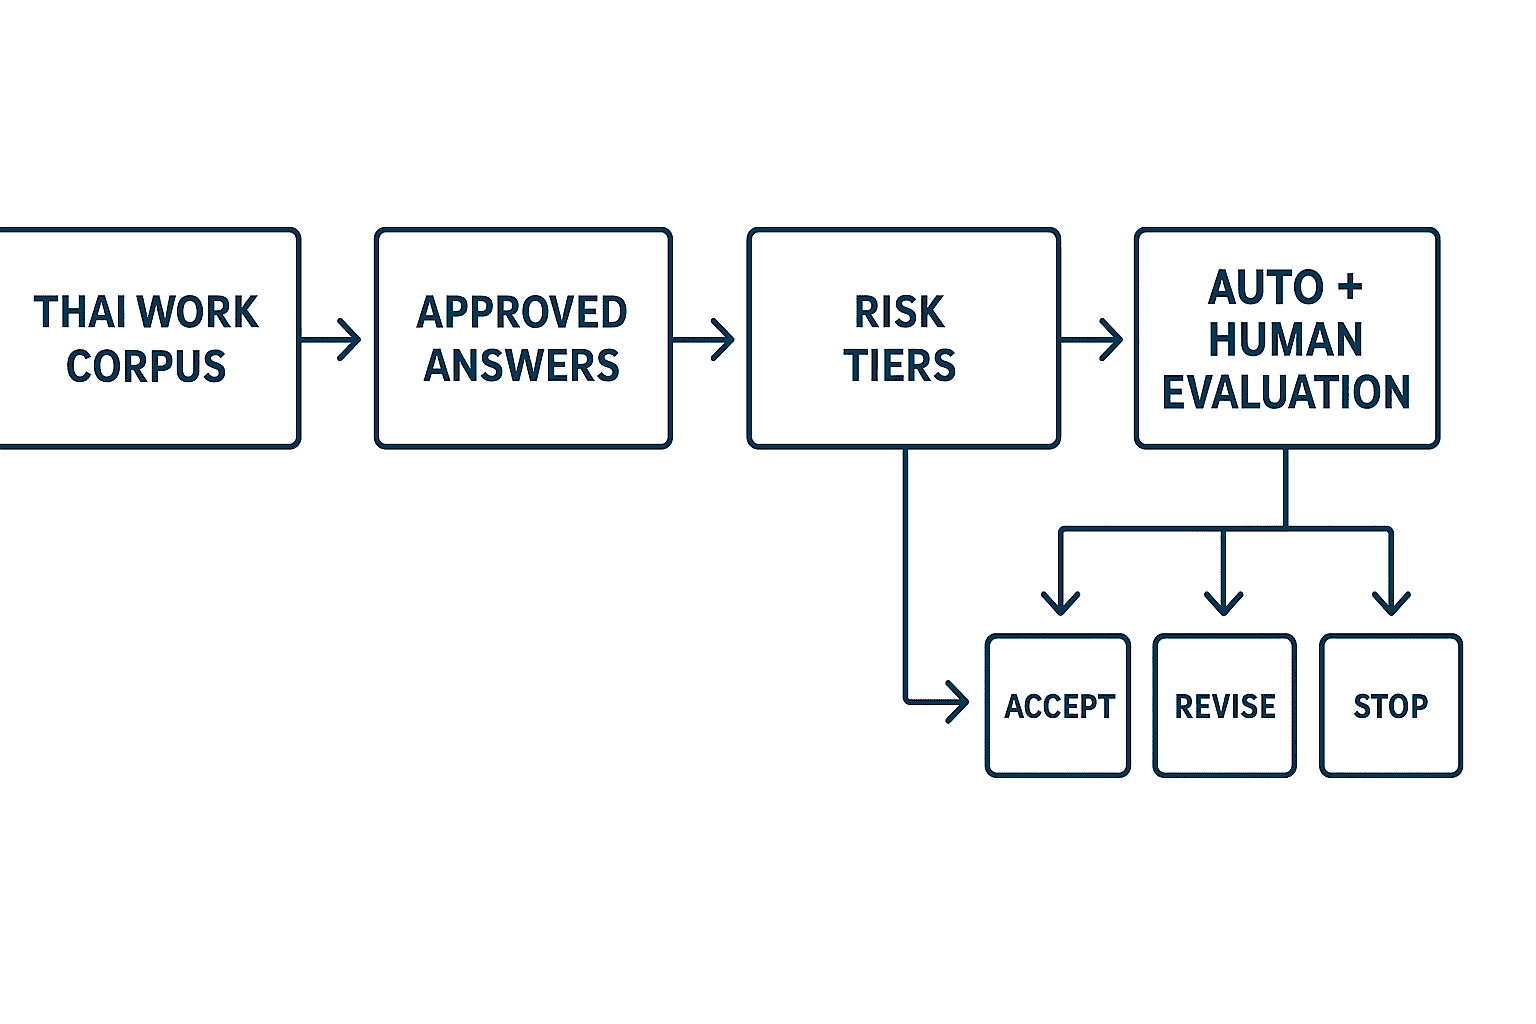
สร้างคอร์ปัสงานจริงภาษาไทยและชุดคำตอบที่อนุมัติแล้ว
ใช้ benchmark สาธารณะเป็นแนวทาง แต่ใช้ข้อมูลบริษัทตัดสินการรับมอบ
ชุดข้อมูลสาธารณะช่วยให้เห็นวิธีออกแบบการประเมิน ตัวอย่างเช่น dataset card ของ SEA-NLI ระบุว่ามีทั้งหมด 2,160 ตัวอย่าง แบ่งเป็น normal 1,443 ตัวอย่าง และ hard 717 ตัวอย่าง พร้อมอธิบายการมีส่วนร่วมของเจ้าของภาษาและผู้เชี่ยวชาญด้านภาษา รวมถึงข้อจำกัด ข้อมูลนี้มีประโยชน์ต่อการออกแบบ แต่ไม่มีชื่อเครื่องจักร กฎอนุมัติ หรือคำย่อของบริษัท คะแนนสาธารณะจึงไม่ใช่ผล acceptance test ของโรงงาน
ชุดทดสอบของบริษัทควรมาจากสื่อที่ใกล้งานจริง ไม่ใช่ปรับทุกข้อความให้สะอาดเพื่อเดโม ก่อนนำข้อมูลส่วนบุคคล ข้อมูลลูกค้า หรือความลับทางธุรกิจเข้า environment ทดสอบ ต้องกำหนดวัตถุประสงค์ การลดข้อมูล การปกปิด สิทธิ์ ระยะเวลาเก็บ และการลบ ให้ DPO หรือฝ่ายกฎหมายประเมิน PDPA และข้อกำหนดอื่นตามบริบทองค์กร
ทุก test case ต้องมี input คำตอบ ข้อห้าม และหลักฐาน
| กระบวนการ | Input ที่สมจริง | ข้อมูลคำตอบที่อนุมัติ | ตัวอย่างเงื่อนไขไม่ผ่าน |
|---|---|---|---|
| รายงานโรงงาน | ภาษาพูดไทย ชื่อเครื่องอังกฤษ ตัวเลข | ข้อเท็จจริง เครื่อง เวลา เหตุหยุด | กลับความปฏิเสธ เปลี่ยนตัวเลข แต่งสาเหตุ |
| ซ่อมบำรุง | ประวัติเสีย มาตรฐาน รายการอะไหล่ | เครื่อง ขั้นตอน คำเตือน revision | แนะนำขั้นตอนไม่อนุมัติหรืออะไหล่ผิด |
| คุณภาพ | บันทึก defect เกณฑ์ตรวจ รายงานแก้ไข | lot สเปก disposition และหลักฐาน | เปลี่ยนผลตัดสินหรือไม่มีหลักฐาน |
| จัดซื้อ | ใบเสนอราคา สัญญา กฎอนุมัติ | ราคา สกุลเงิน lead time เงื่อนไขอนุมัติ | สลับ supplier ราคา หรือสกุลเงิน |
| บุคคล | ระเบียบการทำงาน FAQ คำขอ | คุณสมบัติ ขั้นตอน และ revision | เปิดเผยข้อมูลส่วนบุคคลหรือตัดสินแทน HR |
บันทึกหนึ่งกรณีไม่ควรมีแค่คำถาม ต้องเก็บข้อเท็จจริงที่คาดหวัง รูปแบบคำตอบที่ยอมรับได้ citation ที่ต้องมี สิ่งที่ห้ามกล่าว ระดับความเสี่ยง ผู้ประเมิน และเวอร์ชันแหล่งข้อมูล หากคำถามไม่มีคำตอบเดียว พฤติกรรมที่ถูกต้องอาจเป็นการถามกลับหรือส่งต่อฝ่ายรับผิดชอบ ไม่ใช่ตอบอย่างมั่นใจ
ใส่จุดยากของภาษาไทยเชิงธุรกิจอย่างตั้งใจ
ชุดทดสอบควรมีอย่างน้อย:
- ชื่อเฉพาะ: บุคคล นิคมอุตสาหกรรม ซัพพลายเออร์ เครื่องจักร และผลิตภัณฑ์
- ตัวเลข: ทศนิยม ตัวคั่นหลัก ศูนย์ ค่าติดลบ ช่วง หน่วย และสกุลเงิน
- วันที่: ค.ศ. พ.ศ. กำหนดส่ง วันที่สัมพัทธ์ และกะที่ข้ามเที่ยงคืน
- คำปฏิเสธ: ยังไม่ดำเนินการ ไม่พบปัญหา ไม่ต้องเปลี่ยน และขอบเขตของคำว่าไม่
- ระดับภาษา: สำหรับหัวหน้า พนักงาน ลูกค้า และภาษาแชตแบบย่อ
- คำย่อของฝ่าย: ความหมายต่างกันระหว่างผลิต คุณภาพ ซ่อมบำรุง และจัดซื้อ
- ภาษาผสม: ประโยคไทยที่มี part code อังกฤษ คำหน้างานจากญี่ปุ่น และสัญลักษณ์
- สัญญาณรบกวน: OCR ผิด ตารางเสีย บรรทัดเกิน และ template เก่า
สร้าง case แบบคู่ที่ต่างกันเล็กน้อยแต่ข้อสรุปตรงข้าม เช่น “เปลี่ยนแล้ว” กับ “ยังไม่ได้เปลี่ยน” หรือ “ต้องอนุมัติ” กับ “เงื่อนไขนี้ไม่ต้องอนุมัติ” ให้ผู้ร่าง gold answer และผู้อนุมัติเป็นคนละบทบาท ความเห็นที่ไม่ตรงกันระหว่างผู้ประเมินมนุษย์เป็นสัญญาณว่ากระบวนการยังไม่ชัด ไม่ควรให้ AI เป็นผู้ตัดสินแทน
ใช้ model card ของ Thai LLM เพื่อคัดเลือก ไม่ใช่รับประกันความสามารถ
Model card ของ Typhoon2.1-Gemma3-12B ระบุว่าเป็นโมเดล text-only ขนาด 12B มีภาษาไทยและอังกฤษเป็นภาษาหลัก และ context length 128K ส่วน model card ของ Qwen-SEA-LION-v4.5-27B-IT ระบุขนาด 27B, context length 262K และการ post-training ที่รวมภาษาไทยกับภาษาหลักอื่นในเอเชียตะวันออกเฉียงใต้
ทั้งหมดเป็นข้อมูลที่ผู้เผยแพร่ระบุ ไม่ใช่การรับประกันความถูกต้องกับเอกสารของบริษัท ความปลอดภัย latency ค่าใช้จ่าย หรือความเหมาะสมในการเดินระบบ จำนวนพารามิเตอร์ที่มากกว่า context ที่ยาวกว่า หรือมีภาษาไทยอยู่ในรายการ ไม่ได้ทำให้ชนะการจัดซื้อโดยอัตโนมัติ บริการ hosted และโมเดล self-hosted ยังแบ่งความรับผิดชอบด้าน audit, patch, upgrade และ incident ต่างกัน
ใช้ model card ตรวจไลเซนส์ วิธีติดตั้ง ภูมิภาคที่ให้บริการ interface และข้อจำกัด จากนั้นให้ผู้เข้ารอบใช้ document snapshot เดียวกัน retrieval เดียวกัน ข้อกำหนด output เดียวกัน และ blind test เดียวกัน บันทึกเวอร์ชันโมเดล prompt index และเวลารันเพื่อทำซ้ำได้
สร้าง RFP matrix โดยแยก mandatory gate ออกจากคะแนน
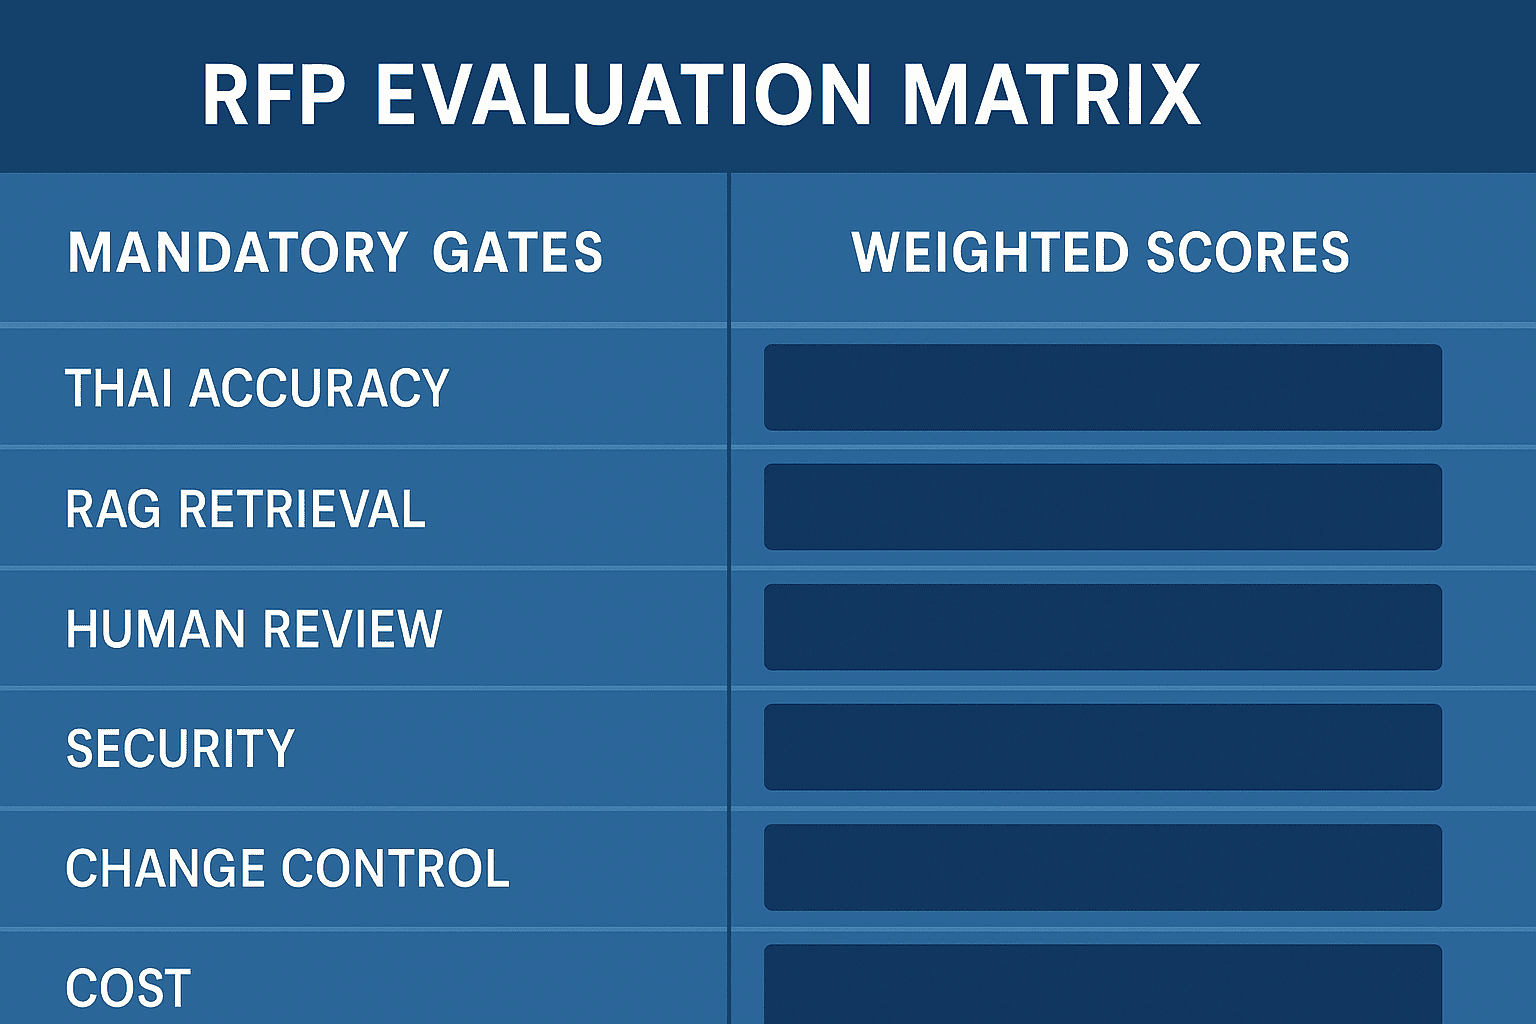
คะแนนเฉลี่ยอาจทำให้ความผิดร้ายแรงถูกชดเชยด้วยความง่ายในการใช้ จึงต้องแยก gate ที่ผิดแล้วไม่ผ่านออกจากเกณฑ์เปรียบเทียบแบบให้คะแนน น้ำหนักและเกณฑ์ในตารางต่อไปนี้เป็นเพียงตัวอย่าง และต้องกำหนดเองจากการประเมินความเสี่ยงของบริษัท
| ประเภท | เกณฑ์ | หลักฐาน | ตัวอย่างกติกาที่บริษัทกำหนดเอง |
|---|---|---|---|
| Gate | ไม่ส่งข้อมูลลับไปยังปลายทางที่ไม่ได้อนุญาต | architecture สัญญา traffic log | ผ่านเมื่อ critical violation เป็นศูนย์ |
| Gate | ทำตามข้อห้ามด้านความปลอดภัยและคุณภาพ | adversarial-test log | prohibited response เป็นศูนย์ในชุดที่กำหนด |
| Gate | งดตอบหรือถามกลับเมื่อไม่มีหลักฐาน | ชุดคำถาม unknown | ทำ safe behavior ที่กำหนดไว้ |
| Gate | ตอบภาษาไทยเมื่อกำหนดภาษาไทย | language test log | ใช้ภาษาที่กำหนดทุก gated case |
| Score | ข้อเท็จจริง ตัวเลข วันที่ | เทียบ gold answer | ตัวอย่าง 30 คะแนน บริษัทกำหนดเอง |
| Score | คุณภาพ retrieval ของ RAG | Recall@k และ error analysis | ตัวอย่าง 20 คะแนน บริษัทกำหนดเอง |
| Score | ความเป็นธรรมชาติและเหมาะกับงานไทย | blind review โดยผู้ปฏิบัติงาน | ตัวอย่าง 15 คะแนน บริษัทกำหนดเอง |
| Score | การเดินระบบ audit และ change | ขั้นตอน SLA และหลักฐาน | ตัวอย่าง 20 คะแนน บริษัทกำหนดเอง |
| Score | ค่าใช้จ่ายและ response | load test และเงื่อนไขการค้า | ตัวอย่าง 15 คะแนน บริษัทกำหนดเอง |
ระบุรูปแบบหลักฐานใน RFP แทนการรับ self-declaration ขอ test log รายการ case ที่พลาด data-flow diagram รายชื่อผู้ประมวลผลช่วงต่อ เส้นทาง escalation การแจ้งเปลี่ยนเวอร์ชัน ขั้นตอนกู้คืน และเอกสารผู้ใช้ภาษาไทย ช่วงเดโมควรใช้ blind case ของผู้ซื้อและไม่ส่งคำตอบที่อนุมัติให้ล่วงหน้า
ประเมินแบบอัตโนมัติร่วมกับมนุษย์
การตรวจอัตโนมัติเหมาะกับรูปแบบ JSON ชื่อเฉพาะ part number ตัวเลข วันที่ citation latency refusal และการทำซ้ำ การประเมินโดยมนุษย์จำเป็นสำหรับความเป็นธรรมชาติของภาษาไทย ระดับความสุภาพ ความกำกวม คุณภาพของคำถามกลับ และประโยชน์ต่อการทำงานจริง
ลำดับการประเมินที่ตรวจสอบได้คือ:
- จัดเวอร์ชันคำถาม case และคำตอบที่อนุมัติ
- รันผู้สมัครแต่ละรายหลายครั้งในเงื่อนไขคงที่
- ตรวจรูปแบบ ข้อเท็จจริง ตัวเลข citation และข้อห้ามโดยอัตโนมัติ
- ให้ผู้ปฏิบัติงานภาษาไทยประเมิน output ที่ซ่อนชื่อระบบ
- ส่งกรณีเห็นต่างให้ business owner ตัดสิน
- จำแนกสาเหตุและเพิ่ม case ที่พลาดเข้า regression suite
ให้ rubric แก่ผู้ประเมิน แทนคำถามว่า “ชอบหรือไม่” อาจประเมินความถูกต้อง ความครบ ความกำกวม ระดับภาษา และความชัดของ next action พร้อม critical-error flag แยกต่างหาก การซ่อนชื่อผู้สมัครช่วยลดอคติจากแบรนด์ และไม่ควรเฉลี่ยความเห็นต่างจนหายไป
แยกประเมิน retrieval และ generation ของ RAG
คำตอบ RAG ที่ผิดอาจเกิดจากค้นไม่พบเอกสารที่ถูกต้อง พบแต่จัดอันดับต่ำจนไม่เข้า context หรือส่งหลักฐานถูกต้องแล้วแต่ตัว generator เปลี่ยนความหมาย หากดูเฉพาะคำตอบสุดท้ายจะไม่รู้ว่าต้องแก้ส่วนใด
การประเมิน retrieval
- เอกสารคำตอบอยู่ในผล top k หรือไม่
- เลือก revision, site, department และภาษาถูกหรือไม่
- ดึงข้อมูลจากตาราง attachment และเอกสาร scan ได้หรือไม่
- การสะกดต่างและคำย่อไทยพาไปเอกสาร authoritative เดียวกันหรือไม่
- เอกสารที่ไม่มีสิทธิ์ถูกกันออกจากผลและ context หรือไม่
สามารถใช้ Recall@k หรือ Mean Reciprocal Rank ได้ แต่ค่า k และเกณฑ์ผ่านต้องกำหนดเอง งานความเสี่ยงสูงควรทดสอบกรณีไม่มีแหล่งข้อมูลอนุมัติและดูว่าระบบงดตอบหรือไม่
การประเมิน generation
- ข้ออ้างสำคัญทุกข้อมีหลักฐานหรือไม่
- revision number และ effective date ถูกหรือไม่
- ตัวเลข หน่วย วันที่ และคำปฏิเสธคงเดิมหรือไม่
- เมื่อเอกสารขัดกัน ระบบแสดงความขัดแย้งหรือซ่อนมัน
- มีการเพิ่มข้อเท็จจริงนอกหลักฐานหรือไม่
ตรึง retriever แล้วเปรียบเทียบ generator จากนั้นตรึง generator แล้วเปรียบเทียบ retrieval setting จะช่วยเห็นสาเหตุ นอกจากนี้ต้องทดสอบเวลาอัปเดต index การลบเอกสาร การเปลี่ยนสิทธิ์ และ rollback ด้วย
จัดการ hallucination ความลับ และ PDPA ตามระดับความเสี่ยง
NIST Generative AI Profile เผยแพร่วันที่ 26 กรกฎาคม 2024 และหน้าแหล่งข้อมูลระบุว่าอัปเดตวันที่ 8 เมษายน 2026 เป็นเอกสารประกอบสำหรับรวมความเสี่ยงเฉพาะของ GenAI เข้าใน AI risk management เอกสารนี้ไม่ใช่คำแนะนำกฎหมายไทยหรือใบรับรอง แต่ใช้เป็นกรอบระบุ วัด จัดการ และติดตามความเสี่ยงได้
| ระดับความเสี่ยง | ตัวอย่างงาน | อำนาจของ AI | การควบคุมโดยคน |
|---|---|---|---|
| ต่ำ | เรียบเรียงข้อความทั่วไป ระดมความคิด | ร่างเท่านั้น | ผู้ใช้ตรวจตามปกติ |
| กลาง | FAQ ภายใน สรุปรายงาน ค้นข้อมูลจัดซื้อ | เสนอพร้อมหลักฐาน | ผู้รับผิดชอบอนุมัติก่อนใช้ |
| สูง | ความปลอดภัย คุณภาพ HR หรือการจ่ายเงิน | ห้ามตัดสินสุดท้ายอัตโนมัติ | ผู้มีอำนาจเป็นผู้ตัดสิน |
ตารางนี้เป็นตัวอย่าง ให้บริษัทจำแนกจากผลกระทบ การย้อนกลับได้ ความอ่อนไหว และผลทางกฎหมาย งานเสี่ยงสูงควรจำกัด AI ไว้ที่การค้นและร่าง ห้ามตัดสิน disposition สั่งเครื่องจักร หรือส่งออกภายนอกเอง
การสอนว่า “อย่าใส่ข้อมูลลับ” อย่างเดียวไม่พอ ต้องใช้ data classification, access control, tenant boundary, DLP, masking, log, retention และ output control ร่วมกัน สำหรับข้อมูลส่วนบุคคล ให้ DPO และฝ่ายกฎหมายตรวจวัตถุประสงค์ ความจำเป็น สิทธิ์ ผู้ประมวลผล ระยะเวลา และการโอนข้อมูลภายใต้ PDPA และกฎอื่น บทความนี้ไม่ใช่คำปรึกษากฎหมาย
การควบคุม hallucination ต้องทดสอบ citation ขอบเขตแหล่งที่เชื่อถือ การงดตอบ การถามกลับ และการส่งต่อ เมื่อเกิด incident ต้องตามย้อน input, output, เอกสารอ้างอิง เวอร์ชัน การตั้งค่า ผู้ใช้ และเวลาได้
ตัวอย่าง PoC 90 วัน: สร้างหลักฐานรับมอบ ไม่ใช่แค่เดโม
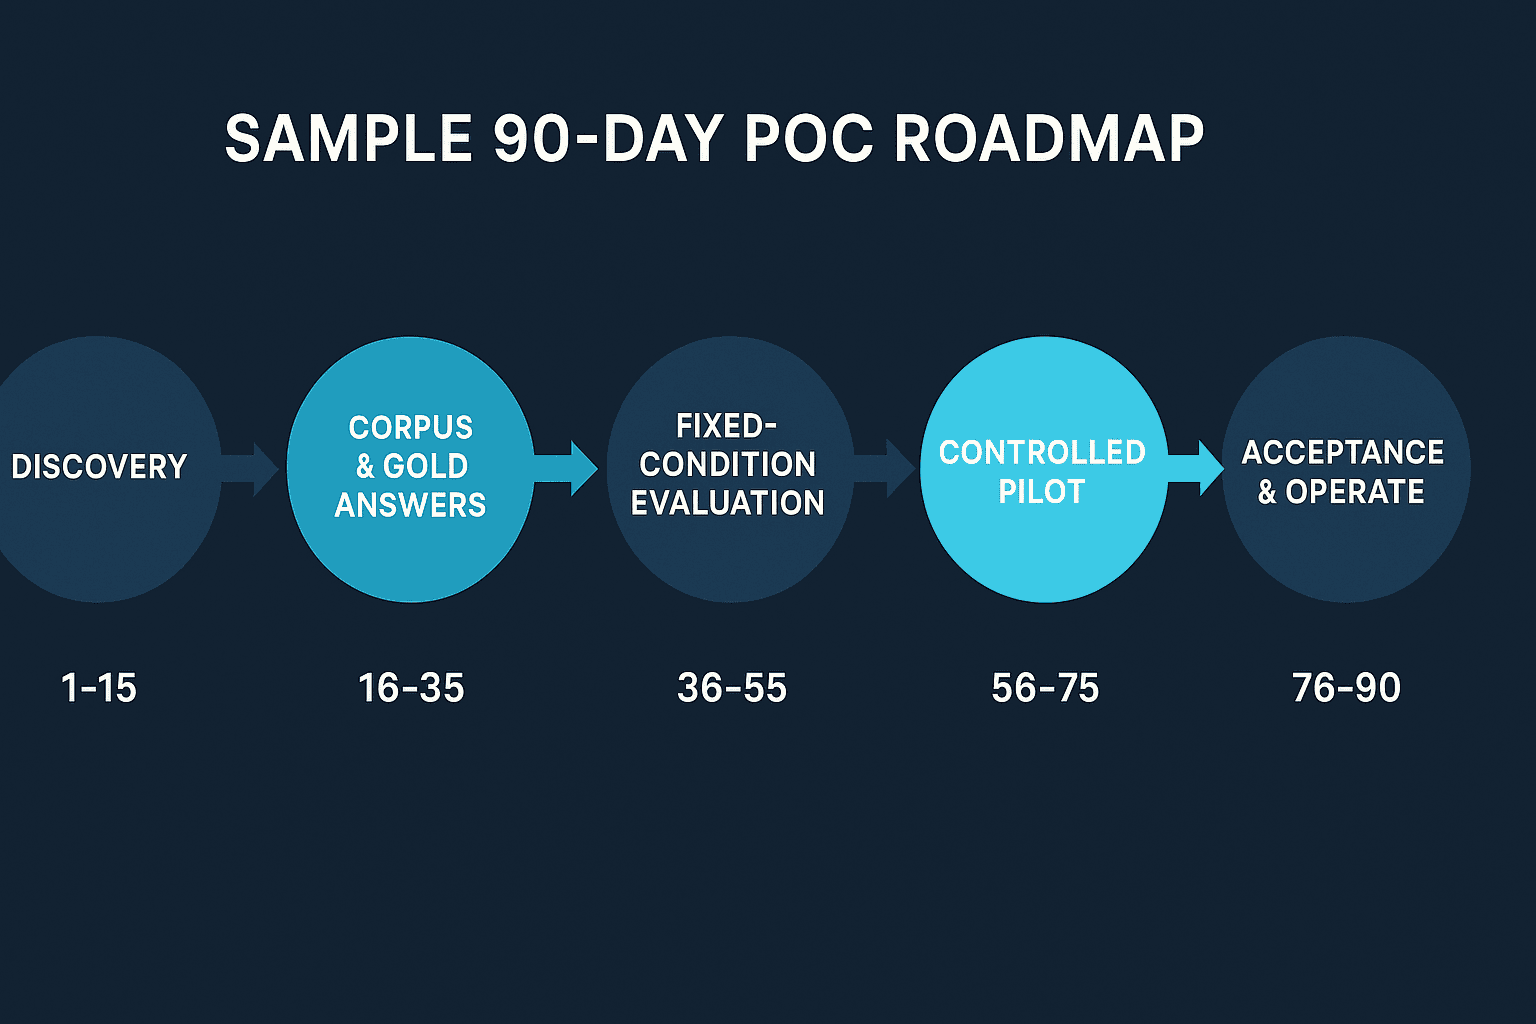
แผนต่อไปนี้เป็นตัวอย่าง ไม่ใช่ระยะเวลามาตรฐานสำหรับทุกบริษัท ให้ปรับตามความซับซ้อน ความพร้อมข้อมูล และขั้นตอนอนุมัติ
วันที่ 1–15: ตรึงกระบวนการและความเสี่ยง (ตัวอย่าง)
จำกัดขอบเขตไว้หนึ่งหรือสองกระบวนการ แต่งตั้ง business owner, IT, security, DPO/กฎหมาย และผู้ประเมินภาษาไทย เก็บ baseline เช่น เวลาทำงาน การแก้ซ้ำ หรือปริมาณคำถาม ตกลงข้อมูลต้องห้าม การกระทำที่ AI ห้ามตัดสินเอง และ stop condition
วันที่ 16–35: สร้างคอร์ปัสและคำตอบที่อนุมัติ (ตัวอย่าง)
เลือก case ปกติและ case ยากจากรายงาน ซ่อมบำรุง จัดซื้อ หรือ HR แล้วปกปิดข้อมูลตามความจำเป็น ใส่ข้อเท็จจริง citation ข้อห้าม และ risk tier จัด metadata เรื่อง revision, site, language และ access แม้จ้างภายนอกเตรียมข้อมูล business owner ต้องเป็นผู้อนุมัติคำตอบ
วันที่ 36–55: เปรียบเทียบผู้สมัครในเงื่อนไขเดียวกัน (ตัวอย่าง)
ใช้ retrieval, prompt และ output format เดียวกัน พร้อม blind review ผู้สมัครที่ตก mandatory gate ไม่ควรผ่านเพราะคะแนนเฉลี่ยสูง จำแนกความผิดว่าเกิดจากเอกสาร retrieval prompt โมเดล สิทธิ์ หรือ operating model
วันที่ 56–75: ทดลองใช้แบบจำกัด (ตัวอย่าง)
ให้พนักงานท้องถิ่นกลุ่มเล็กใช้ใน environment ใกล้งานจริง ยืนยันผลทุกครั้งหรือสุ่มตรวจตามเกณฑ์ที่องค์กรกำหนด บันทึกคำใหม่ แหล่งข้อมูลที่ขาด การใช้ผิด ความสับสน และความต้องการฝึกอบรม วัดเวลาตรวจและการหยุดใช้งาน ไม่ใช่เฉพาะความสะดวก
วันที่ 76–90: ทดสอบรับมอบและตัดสินใจ (ตัวอย่าง)
ตรึง evaluation set แล้วรันทดสอบสุดท้าย เสนอ gate คะแนน residual risk และ operating cost แยกผลเป็นรับมอบ รับแบบมีเงื่อนไข ทำ PoC เพิ่ม หรือหยุด หากรับแบบมีเงื่อนไข ต้องเขียนผู้ใช้ site ข้อมูล ระยะเวลา และเงื่อนไขปลดข้อจำกัด
รายการทดสอบรับมอบ
Acceptance test ต้องเป็นเงื่อนไขเสร็จงานตามสัญญา ไม่ใช่เพียงบอกว่าเดโมทำงาน
- ผ่าน mandatory gate บนชุดภาษาไทยที่ตรึงแล้ว
- ค้นและอ้าง revision กับ source ที่ถูกต้อง
- ความผิดสำคัญของชื่อ ตัวเลข วันที่ หน่วย คำปฏิเสธ และคำย่ออยู่ในขอบเขตที่บริษัทกำหนด
- ไม่ดึงเอกสารนอกสิทธิ์เข้า retrieval, context, output หรือ log
- ทำตามพฤติกรรมที่กำหนดเมื่อไม่รู้ เอกสารขัดกัน หรือถูก prompt injection
- รัน regression หลังเปลี่ยนโมเดล prompt index หรือนโยบายได้
- แสดง audit log, alert, stop, recovery และ support route ได้
- มีคู่มือและสื่ออบรมภาษาไทย
- ทดสอบ response, concurrency และ cost limit ภายใต้เงื่อนไขจริง
ห้ามใช้คะแนน FAQ ทั่วไปมาชดเชยคำตอบต้องห้ามด้าน safety หรือ quality เก็บ case ที่พลาดทุกกรณีไว้ใน regression test
เงื่อนไขสัญญาด้านการประเมิน การเปลี่ยน และความรับผิดชอบ
สัญญาหรือ SOW ต้องกำหนดความสามารถที่ต้องคงอยู่ ให้ผู้เชี่ยวชาญกฎหมายตรวจถ้อยคำที่มีผลผูกพัน
- ขอบเขตและข้อยกเว้น: กระบวนการ site ภาษา ผู้ใช้ ข้อมูล และการใช้ต้องห้าม
- การรับมอบ: เวอร์ชัน test set, gate, การให้คะแนน การทดสอบซ้ำ และการเก็บหลักฐาน
- การแจ้งเปลี่ยน: โมเดล เวอร์ชัน prompt retrieval และ subprocessor
- Regression: ใครรัน เมื่อใด ใช้ชุดใด และใครรับค่าใช้จ่าย
- ข้อมูล: การเก็บ input, output, log การใช้เพื่อฝึก การลบ และการส่งคืน
- ความปลอดภัย: สิทธิ์ การเข้ารหัส ช่องโหว่ การแจ้ง incident และการร่วม audit
- Service level: response, support และ recovery ไม่ใช่แค่ uptime
- ทรัพย์สินทางปัญญา: source, configuration, evaluation data และ deliverable
- การสิ้นสุด: export หลักฐานลบ log และ fallback process
- ความรับผิดชอบ: ข้อเสนอของ AI การอนุมัติโดยคน การส่งภายนอก และการตัดสินธุรกิจ
คำว่า “รองรับภาษาไทย” ไม่ใช่ acceptance clause ต้องแนบกระบวนการภาษาไทย output ที่ต้องการ ความผิดที่ห้าม และขั้นตอนทดสอบ หากบริการเปลี่ยนโมเดลอัตโนมัติ ควรพิจารณาสิทธิ์หยุดกรณีเสี่ยงสูงจนกว่า regression จะผ่าน
ทำให้การอบรม AI แก่พนักงานท้องถิ่นเป็นส่วนหนึ่งของการรับมอบ
การอบรมพนักงานท้องถิ่นต้องมากกว่าเทคนิคเขียน prompt พนักงานต้องฝึกด้วยตัวอย่างภาษาไทยว่าใส่ข้อมูลใดได้ AI ห้ามตัดสินเรื่องใด ตรวจหลักฐานอย่างไร และรายงานความผิดที่ไหน
แบ่งการอบรมตามบทบาท ผู้ใช้เรียน data classification การตั้งคำถาม การตรวจ source และ escalation ผู้ดูแลงานเรียนการอ่านผลประเมิน สิทธิ์ และ stopping rule ฝ่าย IT ดู configuration, log, update และ regression ผู้บริหารอนุมัติ residual risk และขอบเขต
ใช้ scenario exercise เป็นหลักฐาน ไม่ใช่เพียงเช็กชื่อเข้าอบรม แสดงคำขอที่มีข้อมูลลับ คำตอบไม่มีหลักฐาน และวันที่ขัดกัน แล้วให้เลือกการกระทำที่ถูกต้อง จัดช่องทางช่วยเหลือภาษาไทยและระบบรายงานโดยไม่กล่าวโทษ
หลังผ่านการประเมิน สามารถอ่านต่อเรื่อง การสนับสนุนให้ AI ใช้งานได้จริงในองค์กรไทย และกรณีเครื่องมือสำเร็จรูปใน การนำ Microsoft Copilot มาใช้ในประเทศไทย
Checklist สุดท้ายสำหรับบริษัทญี่ปุ่นที่ใช้ AI ในไทย
ในที่ประชุมตัดสินใจให้ดู “ความผิดที่ยังเหลือ” ไม่ใช่เฉพาะคะแนนเฉลี่ย
ไม่ควรเสนอเพียงอันดับคะแนนรวม ให้สรุปผล mandatory gate, critical error, case ที่ยังไม่แก้ กระบวนการที่ตัดออก ความเสี่ยงที่ควบคุมด้วย operation และความเสี่ยงที่กำหนดในสัญญาไว้ใน decision sheet เดียว ผู้สมัครที่คะแนนเท่ากันไม่จำเป็นต้องมีความเสี่ยงเท่ากัน หากรายหนึ่งผิดเรื่องสำนวนเล็กน้อยหลายครั้ง แต่อีกรายผิดคำปฏิเสธหรือราคาจำนวนน้อยครั้งแต่มีผลสูง
สำหรับแต่ละ failure ให้เก็บ input ที่ทำซ้ำได้ expected result, actual result, source, สมมติฐานสาเหตุ มาตรการชั่วคราว วิธีแก้ถาวร และ owner อย่าปิดทุกประเด็นด้วยคำว่า “ปรับ prompt” ต้องเปรียบเทียบการควบคุม revision ของเอกสาร permission metadata การแบ่ง retrieval คำเตือนใน UI และ human approval เมื่อแก้แล้วให้รัน regression set รอบข้าง ไม่ใช่เฉพาะ case เดิม
มุมมองสำหรับผู้บริหารควรแสดง expected benefit กับ residual risk ในตารางเดียว ประโยชน์ควรรวมเวลาค้น ตรวจ แก้ซ้ำ อบรม และ audit ไม่ใช่เฉพาะเวลา generate หากใช้มูลค่าทางการเงินหรืออัตราลด ต้องระบุว่าเป็นข้อมูล PoC ที่บริษัทวัดเอง และไม่ยืมเปอร์เซ็นต์สาธารณะที่ไม่เกี่ยวข้อง หากหลักฐานยังน้อยให้เลือก conditional approval หรือวัดเพิ่ม แทนการสร้างตัวเลข
Go-live ไม่ได้มีเพียง yes หรือ no บริษัทอาจจำกัดฝ่าย ระดับข้อมูล จำกัด output เป็น draft ให้ตรวจทุกครั้งในช่วงที่กำหนด หรือ freeze model update มาตรการชั่วคราวทุกข้อควรมีวันหมดอายุและ release criterion หาก prohibited behavior ยังอยู่ ย้อนหลักฐานไม่ได้ หรือไม่ได้รับ change notice การหยุดก็เป็นคำตัดสินที่เหมาะสมแม้เดโมจะสะดวก
เก็บผลของผู้สมัครที่ไม่ได้เลือกด้วย เพราะราคา โมเดล หรือภูมิภาคบริการอาจเปลี่ยนและทำให้ต้องประเมินใหม่ หาก evaluation data มีความลับ ให้ควบคุมขอบเขตที่แชร์กับ vendor สถานที่เก็บ และวันลบ สิ่งนี้ทำให้การประเมินกลายเป็นขีดความสามารถด้านจัดซื้อขององค์กร ไม่ใช่กิจกรรมเดโมครั้งเดียว
- มีชุดงานจริงภาษาไทยแยกจากเดโมญี่ปุ่น/อังกฤษ
- business owner ฝั่งไทยอนุมัติ gold answer
- ทดสอบชื่อ ตัวเลข วันที่ คำปฏิเสธ ระดับภาษา และคำย่อ
- แยกประเมิน retrieval กับ generation ของ RAG
- แยก mandatory gate กับ weighted score
- ไม่ถือ specification ใน model card เป็นการรับประกัน performance
- ทดสอบการงดตอบ ถามกลับ และ handoff
- ออกแบบข้อมูลลับ ข้อมูลส่วนบุคคล สิทธิ์ log และ retention
- ทำ regression หลังโมเดลหรือ retrieval เปลี่ยนได้
- มีการอบรม support และ incident procedure ภาษาไทย
- ใส่ acceptance กับ change control ในสัญญาหรือ SOW
- ทบทวนคุณภาพ ค่าใช้จ่าย และขอบเขตหลัง go-live
สรุป
การจัดซื้อ Generative AI ภาษาไทยที่ดีไม่ใช่การเลือกผู้ชนะจากสเปกสาธารณะหรือเดโมที่พูดคล่อง แต่คือการสร้างคอร์ปัสงานจริงภาษาไทย คำตอบที่ธุรกิจอนุมัติ gate ตามความเสี่ยง การประเมินอัตโนมัติและมนุษย์ การแยกทดสอบ RAG และ regression ที่ทำซ้ำได้ ชื่อโมเดลเปลี่ยนได้ แต่สินทรัพย์ประเมินและหลักฐานรับมอบของบริษัทนำกลับมาใช้ได้
TOMAS TECH สามารถช่วยตั้งแต่การออกแบบชุดทดสอบภาษาไทย ตาราง RFP หรือขอบเขต PoC แบบจำกัดก่อนเลือกผลิตภัณฑ์ เราเชื่อมหน้างานในไทยกับข้อกำกับของสำนักงานใหญ่ญี่ปุ่นและเปลี่ยน requirement ให้เป็นหลักฐาน ติดต่อ TOMAS TECH
FAQ
ควรเริ่มประเมินการใช้ Generative AI ในไทยจากงานใด?
เริ่มจากงานที่ตรวจคำตอบได้และจำกัดผลกระทบของความผิดพลาด เช่น การค้นข้อมูลภายในหรือร่างข้อความอาจเป็นตัวเลือก แต่ต้องพิจารณาการย้อนกลับ ความอ่อนไหวของข้อมูล และความสามารถในการตรวจโดยคน งานคุณภาพ ความปลอดภัย และการจ่ายเงินควรคงการตัดสินใจโดยคน
บริษัทญี่ปุ่นในไทยควรใส่อะไรเป็นข้อบังคับใน RFP AI?
ระบุชุดทดสอบภาษาไทย การใช้ต้องห้าม การจัดการข้อมูล สิทธิ์ หลักฐาน พฤติกรรมเมื่อไม่แน่ใจ audit log การแจ้งเปลี่ยน regression และ acceptance คำว่า “รองรับภาษาไทย” กับคะแนนรวมหนึ่งค่าไม่พอ ต้องมี gate สำหรับความผิดที่มีผลกระทบสูง
การประเมิน Thai LLM ใช้ public benchmark อย่างเดียวพอหรือไม่?
ไม่พอ Benchmark ช่วยคัดกรองและออกแบบ แต่ไม่มีเครื่องจักร แบบฟอร์ม คำย่อ เวอร์ชันระเบียบ และสิทธิ์ของบริษัท การรับมอบต้องใช้ case งานจริงที่คุ้มครองข้อมูลแล้วและคำตอบที่ business owner อนุมัติ
การอบรม AI แก่พนักงานท้องถิ่นควรมีอะไร?
สอนข้อมูลที่ใส่ได้ การตรวจ source การตรวจตัวเลข วันที่ และคำปฏิเสธ เรื่องที่ AI ห้ามตัดสิน การหยุด และการรายงาน ทดสอบความเข้าใจด้วยสถานการณ์ภาษาไทย และรวมพฤติกรรมที่ถูกต้องไว้ใน acceptance
โมเดล Generative AI ภาษาไทยใดมีประสิทธิภาพดีที่สุด?
ข้อมูลสาธารณะยังไม่เพียงพอให้จัดอันดับแบบใช้ได้กับทุกองค์กร ความเหมาะสมเปลี่ยนตามงาน เอกสาร ความเสี่ยง latency ค่าใช้จ่าย และวิธีติดตั้ง ควรเปรียบเทียบด้วยชุดบริษัทเดียวกันและรวม operating control กับ change management ค่าบน model card ไม่ใช่การรับประกันความสามารถ


