


หมายเหตุในแบบงาน สูตรผสม บันทึกคุณภาพ ข้อกำหนดของลูกค้า และต้นทุน โรงงานผลิตในไทยได้ปรึกษาเราเข้ามาว่าอยากใช้ Generative AI กับข้อมูลที่ไม่อยากส่งออกไปยังคลาวด์ภายนอก หรือส่งออกไปไม่ได้ตามสัญญากับลูกค้า ทางเลือกที่ถูกหยิบขึ้นมาคือ “การติดตั้ง LLM แบบโลคัล” ซึ่งรันโมเดล Open-weight บนเซิร์ฟเวอร์ของบริษัทเอง หรือในสภาพแวดล้อมแบบปิดภายในประเทศไทย หลายบริษัทเริ่มใช้ Generative AI แบบ SaaS ในบางฝ่ายแล้ว แต่ยังมีคำถามว่าควรตั้ง LLM แบบโลคัลสำหรับข้อมูลลับหรือไม่ และถ้าตั้ง จะใช้โมเดลอะไร บน GPU รุ่นใด ด้วยงบเท่าไร และใครเป็นผู้ดูแล บทความนี้ตอบคำถามเหล่านั้นตามลำดับการทำงานจริง
บทความนี้มีข้อเสนอหลักเพียงข้อเดียว ความสำเร็จของ LLM แบบโลคัลไม่ได้ขึ้นอยู่กับประสิทธิภาพของ GPU หรือโมเดล แต่ขึ้นอยู่กับว่าได้ตัดสินใจสามเรื่องต่อไปนี้ไว้ก่อนหรือไม่ ① งานเป้าหมายและการจัดชั้นข้อมูล (ข้อมูลใด และทำไมจึงส่งออกนอกบริษัทไม่ได้ ส่วนงานที่ส่งออกนอกบริษัทได้ให้คงไว้กับ SaaS หรือ API) ② เกณฑ์วัดผลการประเมิน (ชุดข้อมูลประเมินและเกณฑ์ผ่านที่สร้างจากเอกสารของบริษัทเองกับคู่ภาษาที่บริษัทใช้จริง) ③ เจ้าของงานดูแลระบบ (ใครเป็นผู้อัปเดตโมเดล รับมือช่องโหว่ ดูแลล็อก และย้อนกลับระบบเมื่อเกิดเหตุขัดข้อง) GPU และโมเดลควรเลือกหลังจากตัดสินใจสามเรื่องนี้แล้ว โดยคำนวณย้อนกลับหา “โครงสร้างขั้นต่ำที่จำเป็น” ทั้ง “ทุกอย่างเป็นโลคัล” และ “ทุกอย่างเป็น SaaS” ไม่ใช่เป้าหมาย
การตัดสินใจว่าจะเลือกวิธีถือครองแบบใดระหว่าง API การโฮสต์เอง หรือไฮบริด ได้เรียบเรียงไว้ใน การนำ LLM มาใช้ถูกตัดสินด้วยวิธีถือครองโครงสร้างพื้นฐาน – API, การโฮสต์เอง, ไฮบริด บทความนี้เจาะจงเฉพาะการออกแบบและการจัดจ้างเมื่อบริษัทที่เลือกการโฮสต์เอง (LLM แบบโลคัล) หรือให้เป็นตัวเลือกหลัก ลงมือสร้างจริง จำนวนคน ชั่วโมงที่ลดได้ ราคาต่อหน่วย ค่าใช้จ่าย และระยะเวลาคืนทุนของโรงงานจำลองในบทความ ล้วนเป็นตัวเลขสมมติที่ตั้งขึ้นสำหรับบทความนี้ ไม่ใช่ค่าเฉลี่ยของอุตสาหกรรม ไม่ใช่ค่าจากการสำรวจ และไม่ใช่ราคาของผู้จำหน่าย
ทำไมโรงงานผลิตจึงพิจารณาการติดตั้ง LLM แบบโลคัล
การใช้โมเดล Open-weight กำลังขยายตัว
ผลสำรวจของ Enterprise Technology Research (ETR) ที่สื่อในอุตสาหกรรม Techstrong.ai รายงานเมื่อวันที่ 22 กันยายน 2026 (ผู้ตอบ 200 ราย สำรวจในเดือนกันยายน 2026 บทความไม่ได้ระบุประเทศหรือภูมิภาคของผู้ตอบ) ระบุว่า สัดส่วนของโมเดล Open-weight ในการใช้โทเคน AI ขององค์กรอยู่ที่ 34% เพิ่มจาก 23% เมื่อ 1 ปีก่อน และคาดว่าจะเป็น 41% ในอีก 12 เดือนข้างหน้า ผู้ตอบที่ใช้งานจริงในระบบผลิต (Production) มี 42% (การสำรวจเดือนกรกฎาคมอยู่ที่ 31%) และอยู่ในขั้นนำร่อง 43% ด้านโครงสร้างพื้นฐานที่ใช้ติดตั้ง คลาวด์ที่บริหารเองอยู่ที่ 46% และ On-premises อยู่ที่ 42% ในขณะเดียวกัน อุปสรรคต่อการนำขึ้นระบบจริงที่ถูกยกขึ้นมาคือ “การตรวจสอบด้านความปลอดภัยและการปฏิบัติตามข้อกำหนดยังไม่เสร็จ” 62% และต้นทุนของการโฮสต์เอง 50%
บทความของ Constellation Research (26 กันยายน 2026) ที่วิเคราะห์ผลสำรวจเดียวกันรายงานว่า ผู้ใช้งานในระบบจริง 69% ยกการลดต้นทุนเป็นเหตุผล และ 60% ย้ายเวิร์กโหลดบางส่วนออกจากโมเดลแบบ Proprietary อย่างไรก็ตาม บทความเดียวกันระบุว่า 93% ก็เพิ่มการใช้โมเดลแบบ Proprietary ด้วย จึงน่าจะตีความได้อย่างเป็นธรรมชาติว่า สภาพที่แท้จริงคือ “การใช้ร่วมกัน” โดยเลือกใช้ตามลักษณะงาน มากกว่าการย้ายไปสู่โมเดล Open-weight
สิ่งที่บริษัทญี่ปุ่นกังวลมากที่สุดคือข้อมูลรั่วไหล
ในแบบสอบถามบริษัทใน 4 ประเทศที่ปรากฏใน “สมุดปกขาวด้านสารสนเทศและการสื่อสาร ฉบับ Reiwa 8” ของกระทรวงกิจการภายในและการสื่อสารของญี่ปุ่น สัดส่วนที่ยก “มีความเสี่ยงด้านความปลอดภัย เช่น ข้อมูลภายในบริษัทรั่วไหล” เป็นความเสี่ยงที่กังวลในการใช้ Generative AI อยู่ที่ ญี่ปุ่น 46.4% สหรัฐอเมริกา 36.9% เยอรมนี 31.7% และจีน 42.7% ในญี่ปุ่น หัวข้อนี้มีสัดส่วนสูงที่สุด ตามด้วย “ความแม่นยำของผลลัพธ์มีปัญหา” 35.3% และ “อาจละเมิดสิทธิ เช่น ลิขสิทธิ์” 31.3% ส่วนในสหรัฐอเมริกาและจีน ความแม่นยำของผลลัพธ์ (สหรัฐอเมริกา 44.3% จีน 52.1%) และในเยอรมนี ลิขสิทธิ์และสิทธิอื่น ๆ (44.7%) มีสัดส่วนสูงที่สุด สมุดปกขาวฉบับเดียวกันระบุว่า ในด้านมาตรการรับมือความเสี่ยง ญี่ปุ่นมีสัดส่วน “จัดทำแนวทางหรือแนวปฏิบัติระดับทั้งองค์กร” สูงที่สุดที่ 41.1% ขณะที่อีก 3 ประเทศมีแนวโน้มที่สัดส่วนของการตรวจพิจารณาโดยผู้เชี่ยวชาญในขั้นนำมาใช้ และการประเมินและทวนสอบเป็นระยะหลังนำมาใช้ สูงกว่าญี่ปุ่น
เบื้องหลังประการหนึ่งที่ทำให้โรงงานผลิตสัญชาติญี่ปุ่นพิจารณา LLM แบบโลคัล น่าจะเป็นความรู้สึก “กังวลเรื่องข้อมูลรั่วไหล” นี้ อย่างไรก็ตาม ดังที่จะเห็นในภายหลัง การวางระบบไว้แบบโลคัลไม่ได้ทำให้ความเสี่ยงข้อมูลรั่วไหลหายไป แนวโน้มที่สมุดปกขาวแสดงว่า สัดส่วนของญี่ปุ่นในการประเมินและทวนสอบหลังนำมาใช้ต่ำกว่าอีก 3 ประเทศ ก็จะกลายเป็นโจทย์เดียวกันสำหรับ LLM แบบโลคัล
โมเดลภาษาไทยและโครงสร้างพื้นฐานการประมวลผลในประเทศมีมากขึ้น
ในประเทศไทย สวทช. (NSTDA) แนะนำไว้ในบทความลงวันที่ 1 เมษายน 2026 ว่า “ThaiLLM” ซึ่งเป็น LLM ระดับชาติที่กระทรวงดิจิทัลเพื่อเศรษฐกิจและสังคม (MDES) สถาบันข้อมูลขนาดใหญ่ (BDI) กระทรวงการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม (MHESI) และ NECTEC ร่วมกันพัฒนา มี 2 โมเดล คือ 8B (เน้นความเร็ว) และ 30B (เน้นประสิทธิภาพ) ซึ่งเรียนรู้จากข้อมูลภาษาไทยกว่าแสนล้านโทเคน และเปิดให้ใช้ Playground, API และดาวน์โหลดโมเดลได้ฟรี ซีรีส์ Typhoon ของ SCB 10X ก็เผยแพร่โมเดลสำหรับภาษาไทย รวมถึง OCR และการแปล (ตามที่ระบุในเว็บไซต์ของบริษัท)
ในด้านโครงสร้างพื้นฐานการประมวลผล สำนักงานคณะกรรมการส่งเสริมการลงทุน (BOI) ประกาศเมื่อวันที่ 8 กรกฎาคม 2026 ว่าได้อนุมัติการลงทุนรวม 1.99 พันล้านดอลลาร์สหรัฐ (66,300 ล้านบาท) ซึ่งรวมถึงโครงการที่บริษัทลูกในไทยของ Data Section จากญี่ปุ่น จะสร้างโครงสร้างพื้นฐานเซิร์ฟเวอร์ GPU ประสิทธิภาพสูงในกรุงเทพฯ และปทุมธานี มูลค่า 235.2 ล้านดอลลาร์สหรัฐ (7,800 ล้านบาท) ส่วนรายงานข่าวเดือนธันวาคม 2024 ระบุว่า SIAM.AI CLOUD ซึ่งเป็นทุนไทยและประกาศตัวเป็น NVIDIA Cloud Partner ได้เปิดคลัสเตอร์ GPU H100 โดยชูการรักษาอธิปไตยของข้อมูล (การสำรวจของบทความนี้ไม่ได้ยืนยันขนาดการให้บริการ ณ ปี 2026) ทางเลือกที่จะเช่า GPU บนคลาวด์แบบปิดภายในประเทศไทย นอกเหนือจากการวางไว้ในบริษัท จึงเริ่มเป็นจริงได้มากขึ้น
LLM แบบโลคัลคืออะไร: ความแตกต่างระหว่าง Open-weight, On-premises และคลาวด์แบบปิดในไทย
คำว่า “LLM แบบโลคัล” มีขอบเขตแตกต่างกันไปตามผู้พูด ก่อนเริ่มหารือภายในบริษัท การแยก 3 คำต่อไปนี้ให้ชัดจะช่วยให้คุยกันตรงประเด็น
| คำศัพท์ | หมายถึงอะไร | ที่เก็บข้อมูล | ผู้ดูแลระบบ |
|---|---|---|---|
| โมเดล Open-weight | โมเดลที่เปิดเผยค่าน้ำหนัก (พารามิเตอร์ที่ผ่านการเรียนรู้แล้ว) และดาวน์โหลดมารันในสภาพแวดล้อมของตนเองได้ | ตัวโมเดลไม่จำกัดสถานที่ | ผู้ใช้ (ภายในขอบเขตเงื่อนไขไลเซนส์) |
| LLM แบบ On-premises | รูปแบบที่รันโมเดล Open-weight บนเซิร์ฟเวอร์ GPU ที่วางไว้ในโรงงานหรือดาต้าเซ็นเตอร์ของบริษัทเอง | ภายในพื้นที่ของบริษัท | บริษัทเองหรือผู้รับจ้างบำรุงรักษา |
| คลาวด์แบบปิดภายในประเทศไทย | รูปแบบที่เช่า GPU ในดาต้าเซ็นเตอร์ภายในประเทศไทยเป็นพื้นที่เฉพาะหรือผ่านการเชื่อมต่อแบบปิด แล้วรันโมเดล Open-weight | สิ่งอำนวยความสะดวกในประเทศของผู้ให้บริการคลาวด์ที่ทำสัญญา | แบ่งหน้าที่ระหว่างผู้ให้บริการคลาวด์กับบริษัท |
บทความนี้ถือว่าทั้ง On-premises และคลาวด์แบบปิดในประเทศเป็น “LLM แบบโลคัล” จุดร่วมคือ บริษัทเป็นผู้กำหนดเองว่าจะรันโมเดลใด เวอร์ชันใด กับข้อมูลใด และพรอมต์กับคำตอบจะไม่ถูกส่งไปยังผู้ให้บริการโมเดลภายนอก ความแตกต่างอยู่ที่ซื้อหรือเช่า GPU และใครเป็นผู้ซ่อมฮาร์ดแวร์เมื่อเกิดเหตุขัดข้อง
การเปรียบเทียบ 3 รูปแบบ ได้แก่ การควบคุม SaaS ตัวครอบ API และระบบปิดหรือการโฮสต์เอง ในแง่ขอบเขตที่ปกป้องได้และต้นทุนรวม 5 ปี อยู่ใน สภาพแวดล้อม AI ที่ปลอดภัย 2026 – ค่าใช้จ่าย 9 ใน 10 ส่วนไม่ได้อยู่ที่ค่าใช้โมเดล ในที่นี้จะไม่เปรียบเทียบซ้ำ แต่จะลงไปที่รายละเอียดเมื่อสร้างระบบโฮสต์เอง
สิ่งแรกที่ต้องตัดสินใจ: “งานที่จะวางไว้แบบโลคัล” และการจัดชั้นข้อมูล
ในการพิจารณา LLM แบบโลคัล สิ่งแรกที่ต้องตัดสินใจไม่ใช่ GPU หรือโมเดล แต่คือ จะวางงานใดไว้แบบโลคัล
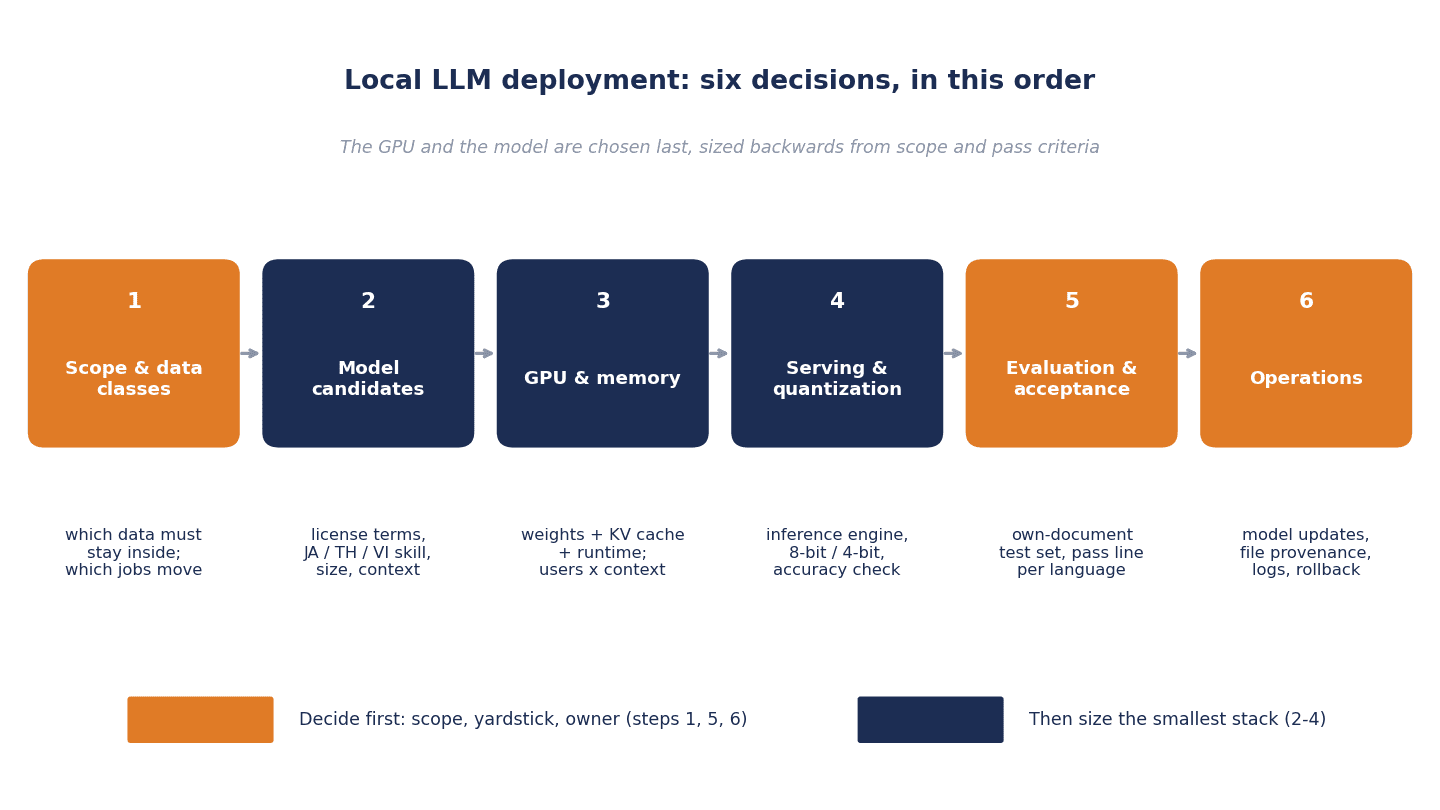
ภาพด้านบนแสดงลำดับการตัดสินใจ 6 ขั้นของ LLM แบบโลคัล ได้แก่ ① งานเป้าหมายและการจัดชั้นข้อมูล ② การคัดเลือกโมเดลที่เป็นตัวเลือก ③ การประมาณ GPU และหน่วยความจำ ④ ซอฟต์แวร์อนุมานและการควอนไทซ์ ⑤ การประเมินและการตรวจรับ ⑥ การดูแลระบบ หากขั้นบนยังไม่ได้ข้อสรุป ขั้นล่างก็ประมาณการไม่ได้ ตัวอย่างเช่น หากเป้าหมายยังเป็นเพียง “ให้พนักงานทุกคนถามอะไรก็ได้” ก็จะไม่รู้ว่ามีกี่คนใช้พร้อมกันและป้อนเอกสารยาวเท่าใด จึงกำหนดจำนวน GPU ไม่ได้
ตัวอย่างการจัดชั้นข้อมูล
ตารางต่อไปนี้แสดงตัวอย่างว่าข้อมูลแต่ละประเภทส่งออกนอกบริษัทได้หรือไม่ และควรวางไว้ที่ใด การจัดชั้นจะเปลี่ยนไปตามระเบียบความปลอดภัยสารสนเทศของบริษัทและสัญญากับลูกค้า จึงเป็นเพียงตัวอย่างของแนวคิดเท่านั้น
| ประเภทข้อมูล | ส่งออกนอกบริษัทได้หรือไม่ (ตัวอย่าง) | ตัวอย่างที่วาง | ตัวอย่างเหตุผล |
|---|---|---|---|
| การเขียนข้อความทั่วไป การสรุปข้อมูลสาธารณะ ร่างคำแปล | ได้ | SaaS หรือ API | ไม่มีข้อมูลลับ ให้ความสำคัญกับประสิทธิภาพและความสะดวกได้ |
| ระเบียบภายในบริษัท มาตรฐานการทำงาน คู่มือขั้นตอนภายใน | ขึ้นกับระเบียบ | SaaS (มีการควบคุม) หรือโลคัล | แยกตามว่าจัดเป็นความลับภายในบริษัทหรือไม่ |
| แบบงานของลูกค้า ข้อกำหนดของลูกค้า ข้อกำหนดคุณภาพที่ได้รับจากลูกค้า | ขึ้นกับสัญญา (ส่วนใหญ่ส่งออกไม่ได้) | โลคัล | สัญญารักษาความลับอาจจำกัดการส่งไปยังเซิร์ฟเวอร์ของบุคคลที่สาม |
| สูตรผสม เงื่อนไขกระบวนการ ต้นทุน เหตุผลประกอบใบเสนอราคา | ไม่อยากส่งออก | โลคัล | เป็นความสามารถในการแข่งขันของบริษัทโดยตรง |
| บันทึกคุณภาพ บันทึกของเสีย บันทึกข้อร้องเรียนจากลูกค้า | ไม่อยากส่งออก | โลคัล | มีชื่อลูกค้าและรายละเอียดของปัญหา |
| ข้อมูลส่วนบุคคลของพนักงาน (งานบุคคล สุขภาพ การประเมินผล) | โดยหลักไม่ส่งออก | โลคัล หรือไม่นำมาใช้กับ LLM | อยู่ภายใต้ PDPA และมีประเด็นการโอนข้อมูลข้ามพรมแดน |
ให้แต่ละฝ่ายกรอกคอลัมน์ที่ 2 จากขวาของตาราง หัวใจคือ จำกัดงานที่จะวางไว้แบบโลคัลให้แคบ หากดึงแม้แต่การเขียนข้อความทั่วไปมาไว้แบบโลคัล ผู้ใช้จะเพิ่มขึ้นจน GPU ไม่พอ และในด้านประสิทธิภาพก็อาจด้อยกว่า SaaS การเริ่มจากฝ่ายที่จัดการข้อมูลลับเป็นประจำ เช่น ฝ่ายออกแบบ ฝ่ายประกันคุณภาพ ฝ่ายวางแผนการผลิต และฝ่ายจัดซื้อ จึงเป็นแนวทางที่สมจริง
เขียน “ทำไมจึงส่งออกไม่ได้” ไว้ในหนึ่งบรรทัด
เมื่อจัดชั้นข้อมูล ให้เขียนเหตุผลที่ “ส่งออกไม่ได้” ไว้หนึ่งบรรทัด หากเขียนได้ เช่น “สัญญากับลูกค้าบริษัท A ห้ามจัดเก็บบนเซิร์ฟเวอร์ของบุคคลที่สาม” หรือ “สูตรผสมจัดเป็นความลับภายในตามชั้นความลับของสำนักงานใหญ่” ก็จะนำไปใช้ได้ทันทีเมื่อเขียน RFP ออกแบบการทดสอบรับมอบ และอธิบายต่อผู้ตรวจสอบ ข้อมูลที่เขียนเหตุผลไม่ได้ อาจจริง ๆ แล้วใช้ SaaS ก็เพียงพอ ข้อกำหนดและการทดสอบรับมอบของมาตรการป้องกันข้อมูลรั่วไหลจาก Generative AI โดยตรง อธิบายไว้อย่างละเอียดใน การป้องกันข้อมูลรั่วไหลจาก Generative AI – RFP และการทดสอบรับมอบสำหรับโรงงานไทย
การเลือกโมเดล Open-weight: ไลเซนส์ ภาษา ขนาด และความยาวบริบท
เมื่อกำหนดงานเป้าหมายได้แล้ว ก็คัดเลือกโมเดลที่เป็นตัวเลือก ตารางต่อไปนี้รวบรวมโมเดลที่การสำรวจของบทความนี้ยืนยันได้จาก Model Card ทางการหรือหน้าเว็บของผู้พัฒนา โดยจัดเป็น “ตัวอย่างตัวเลือก” ไม่ใช่คำแนะนำ ประสิทธิภาพและข้อมูลจำเพาะทั้งหมดเป็นข้อมูลที่ผู้พัฒนาระบุ (คำกล่าวอ้างของผู้จำหน่าย)
| โมเดล (ผู้พัฒนา) | ขนาด | ความยาวบริบท | ไลเซนส์และเงื่อนไขการใช้งาน | ภาษาที่ระบุ |
|---|---|---|---|---|
| gpt-oss-20b และ 120b (OpenAI) | 20b มีทั้งหมด 21B และแอคทีฟ 3.6B ส่วน 120b มีทั้งหมด 117B และแอคทีฟ 5.1B | 128K ตามที่ระบุในเวอร์ชันที่เผยแพร่ผ่าน Ollama | Apache 2.0 | — |
| Qwen3-30B-A3B-Instruct-2507 (Qwen / Alibaba) | ทั้งหมด 30.5B แอคทีฟ 3.3B | Native 262,144 โทเคน | apache-2.0 | — |
| Llama 4 Scout และ Maverick (Meta) | Scout แอคทีฟ 17B ทั้งหมด 109B, Maverick แอคทีฟ 17B ทั้งหมด 400B | Scout 10M, Maverick 1M โทเคน | Llama 4 Community License Agreement (ผู้ใช้งานรายเดือนที่แอคทีฟเกิน 700 ล้านรายต้องยื่นขอต่อ Meta) | 12 ภาษา รวมภาษาไทย เวียดนาม อินโดนีเซีย ภาษาญี่ปุ่นไม่อยู่ในรายการภาษาที่รองรับอย่างเป็นทางการ |
| Gemma 4 (Google) | 5 แบบ ได้แก่ E2B, E4B, 12B, 26B A4B (MoE), 31B (dense) | ขนาดเล็ก 128K ขนาดกลาง 256K | ระบุว่าใช้เชิงพาณิชย์ได้ ต้องตรวจสอบเงื่อนไขการใช้โมเดลในหน้าข้อกำหนดการใช้งานทางการ (Gemma terms) | — |
| Mistral-Small-3.2-24B-Instruct-2506 (Mistral AI) | 24B | — | apache-2.0 | รองรับ 24 ภาษา |
| DeepSeek-V3.2 (DeepSeek) | ทั้งหมด 685B | — | ในรีโพสิทอรีระบุ MIT License | — |
| GPT-OSS Swallow 20B และ 120B (โครงการ Swallow) | พัฒนาบนฐาน gpt-oss | — | Apache 2.0 (ใช้ได้ทั้งเชิงพาณิชย์และงานวิจัย) | เฉพาะทางภาษาญี่ปุ่น |
| Typhoon2.1-Gemma3-12B (SCB 10X) | 12B (บนฐาน Gemma3 12B) | 128K | Gemma License การใช้งานต้องยอมรับข้อกำหนดการใช้งานและประกาศความเป็นส่วนตัวของ OpenTyphoon | ภาษาไทยและอังกฤษ |
| ThaiLLM (MDES, BDI, MHESI, NECTEC และอื่น ๆ) | 8B และ 30B | — | การสำรวจของบทความนี้ยังไม่ได้ยืนยันชื่อไลเซนส์ | ภาษาไทย (เรียนรู้จากข้อมูลภาษาไทยกว่าแสนล้านโทเคน) |
เครื่องหมาย “—” ในตาราง หมายถึงรายการที่ไม่พบข้อมูลในขอบเขตที่การสำรวจของบทความนี้ตรวจสอบ
อ่านไลเซนส์จาก “เงื่อนไข” ไม่ใช่จาก “ชื่อ”
แม้จะเรียกว่า “เปิด” เหมือนกัน แต่เงื่อนไขต่างกัน มีโมเดลที่ระบุ Apache 2.0 หรือ MIT ขณะที่ Llama 4 ใช้ไลเซนส์ชุมชนเฉพาะของตน และระบุว่าผลิตภัณฑ์หรือบริการที่มีผู้ใช้งานรายเดือนที่แอคทีฟเกิน 700 ล้านรายต้องยื่นขอต่อ Meta ส่วน Typhoon2.1-Gemma3-12B นอกจาก Gemma License แล้วยังต้องยอมรับข้อกำหนดการใช้งานของ OpenTyphoon หน้าภาพรวมทางการของ Gemma 4 ระบุว่าใช้เชิงพาณิชย์ได้ และโมเดลอยู่ภายใต้ข้อกำหนดการใช้งานของ Gemma 4 แต่รายละเอียดของเงื่อนไขควรตรวจสอบจากหน้าข้อกำหนดการใช้งานโดยตรง สำหรับ ThaiLLM การสำรวจของบทความนี้ยังยืนยันชื่อไลเซนส์ไม่ได้ เมื่อได้โมเดลที่จะนำมาใช้แล้ว ให้ถือเป็นหลักว่าต้องอ่านต้นฉบับข้อกำหนดการใช้งาน ณ เวลานั้นร่วมกับฝ่ายกฎหมาย
ดูภาษาทั้งจาก “รายการภาษาที่รองรับ” และ “การวัดจริงกับเอกสารของบริษัท”
ในโรงงานที่มีภาษาญี่ปุ่น ไทย และเวียดนามปะปนกัน การจัดการภาษาเป็นจุดชี้ขาดของการคัดเลือก Model Card ของ Llama 4 ระบุ 12 ภาษารวมภาษาไทยและเวียดนามเป็นภาษาที่รองรับ แต่ภาษาญี่ปุ่นไม่อยู่ในรายการทางการ ในด้านโมเดลเฉพาะทางภาษาญี่ปุ่น โครงการ Swallow ของ Institute of Science Tokyo และหน่วยงานอื่นได้เผยแพร่ GPT-OSS Swallow 20B และ 120B (v0.1 เมื่อ 20 กุมภาพันธ์ 2026 และเวอร์ชัน MXFP4 เมื่อ 28 พฤษภาคม 2026) และระบุว่าในเบนช์มาร์ก JamC-QA ซึ่งวัดความรู้เกี่ยวกับญี่ปุ่น 20B ทำคะแนนดีขึ้นจาก gpt-oss ต้นแบบ 13.0 จุด และ 120B ดีขึ้น 11.4 จุด (ตามประกาศของผู้พัฒนา) สำหรับภาษาไทย มี ThaiLLM และ Typhoon2.1-Gemma3-12B ที่กล่าวไปแล้ว
อย่างไรก็ตาม รายการภาษาที่รองรับหรือเบนช์มาร์กไม่ได้รับประกันว่าจะใช้ได้กับหมายเหตุในแบบงานหรือบันทึกคุณภาพของบริษัท จำเป็นต้องวัดจริงด้วย คู่ภาษาที่บริษัทใช้จริง เช่น สรุปมาตรฐานการทำงานที่เขียนเป็นภาษาไทยเป็นภาษาญี่ปุ่น หรือถ่ายทอดสาระสำคัญของข้อกำหนดลูกค้าภาษาญี่ปุ่นเป็นภาษาไทยให้หน้างาน วิธีสร้างการประเมินงานภาษาไทยได้เรียบเรียงไว้ใน Generative AI ภาษาไทย – คู่มือ RFP และการทดสอบรับมอบงาน
ขนาดและความยาวบริบท
โมเดลยิ่งใหญ่ยิ่งคาดหวังความแม่นยำได้มาก แต่หน่วยความจำ GPU และต้นทุนก็เพิ่มขึ้น โมเดลอย่าง gpt-oss, Qwen3-30B-A3B และ Llama 4 ที่เขียนแยก “พารามิเตอร์ทั้งหมด” กับ “พารามิเตอร์แอคทีฟ” คือโมเดลที่มีโครงสร้างแบบ MoE (Mixture of Experts) แม้การคำนวณแต่ละครั้งจะใช้พารามิเตอร์เพียงบางส่วน แต่ ค่าน้ำหนักทั้งหมดต้องโหลดไว้ในหน่วยความจำ การประมาณหน่วยความจำ GPU จึงต้องใช้พารามิเตอร์ทั้งหมด
ความยาวบริบทคือความยาวของบริบทที่โหลดได้ในครั้งเดียว ดังตาราง มีตั้งแต่ 128K ถึง 10M โทเคน แต่ยิ่งใช้บริบทยาวเท่าไร หน่วยความจำของ KV cache ก็ยิ่งเพิ่มขึ้น ประเด็นนี้จะกล่าวในบทถัดไป
การเลือก GPU สำหรับ LLM: วิธีคำนวณหน่วยความจำที่ต้องใช้
หน่วยความจำของค่าน้ำหนัก = จำนวนพารามิเตอร์ × จำนวนไบต์
การประมาณหน่วยความจำ GPU เริ่มจากค่าน้ำหนักก่อน บล็อกเทคนิคของ NVIDIA (17 พฤศจิกายน 2023) แสดงสูตรพื้นฐานในการหาหน่วยความจำของค่าน้ำหนักว่า “จำนวนพารามิเตอร์ × จำนวนไบต์ต่อ 1 พารามิเตอร์” และยกตัวอย่างว่าหากโหลด Llama 2 7B ที่ 16 บิต (FP16 หรือ BF16) จะใช้ประมาณ 14GB จำนวนไบต์ต่อ 1 พารามิเตอร์คือ 2 ไบต์ที่ 16 บิต 1 ไบต์ที่ 8 บิต และ 0.5 ไบต์ที่ 4 บิต
เมื่อใช้สูตรนี้ประมาณหน่วยความจำของค่าน้ำหนักตามขนาดโมเดลและความละเอียด จะได้ดังนี้ (ประมาณโดยถือว่า 1GB = 1,000 ล้านไบต์ เป็นค่าของค่าน้ำหนักเท่านั้น)
| ขนาดโมเดล | 16 บิต | 8 บิต | 4 บิต |
|---|---|---|---|
| 8B (8,000 ล้าน) | 16 GB | 8 GB | 4 GB |
| 32B (32,000 ล้าน) | 64 GB | 32 GB | 16 GB |
| 70B (70,000 ล้าน) | 140 GB | 70 GB | 35 GB |
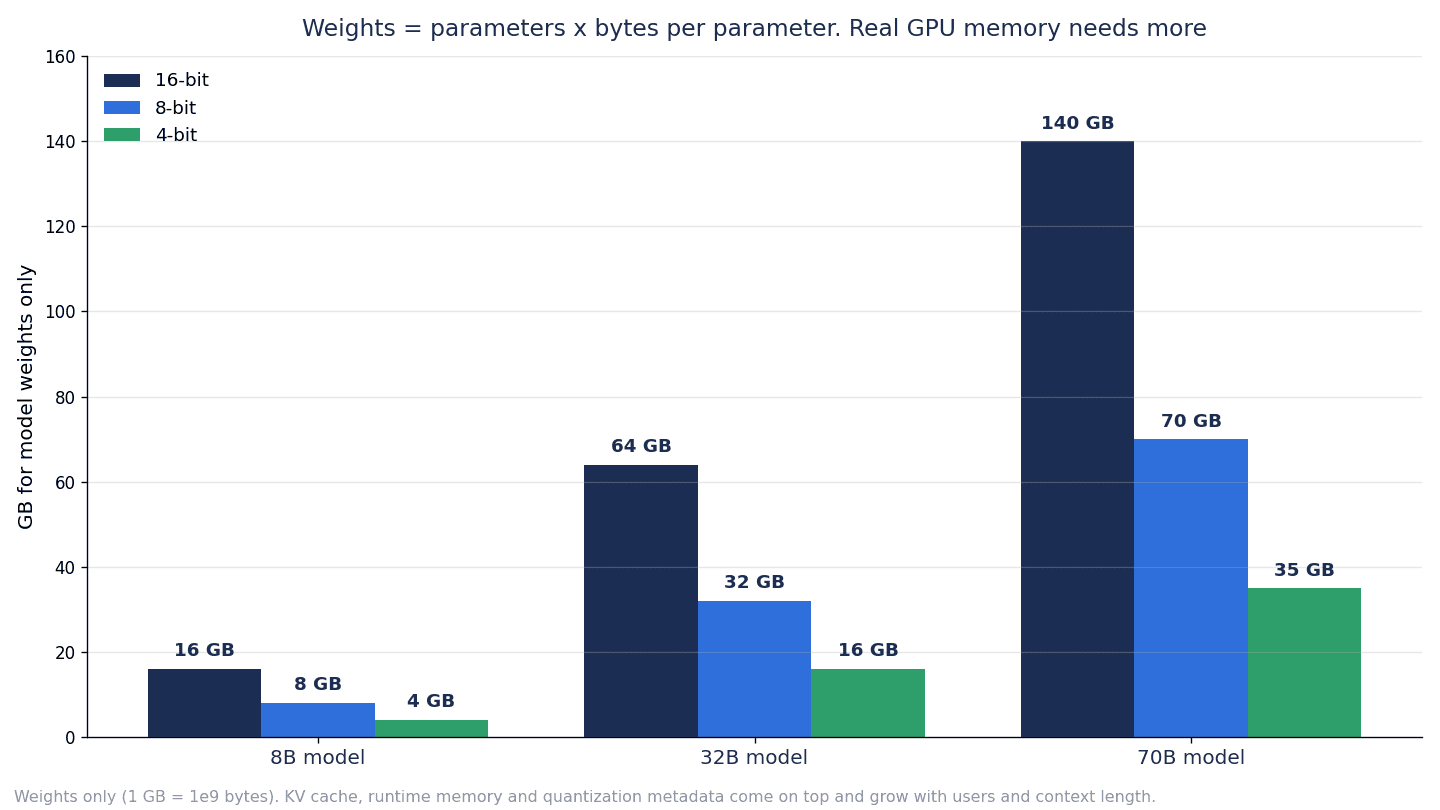
ตารางนี้ไม่รวม KV cache พื้นที่ขณะรันของซอฟต์แวร์อนุมาน และข้อมูลประกอบของการควอนไทซ์ หน่วยความจำ GPU ที่ต้องใช้จริงจะมากกว่านี้ มากกว่าเท่าใดขึ้นอยู่กับจำนวนการเชื่อมต่อพร้อมกัน ความยาวบริบท และซอฟต์แวร์อนุมาน
มาดูค่าที่ผู้พัฒนาเผยแพร่ด้วย Google แสดงค่าประมาณหน่วยความจำที่จำเป็นสำหรับการโหลดค่าน้ำหนักเพียงอย่างเดียวของ Gemma 4 ไว้ในตารางทางการ (คำกล่าวอ้างของผู้จำหน่าย)
| โมเดล Gemma 4 | BF16 | SFP8 | Q4_0 |
|---|---|---|---|
| 31B | 69.9GB | 34.9GB | 17.5GB |
| 26B A4B | 57.7GB | 28.8GB | 14.4GB |
| 12B | 26.7GB | 13.4GB | 6.7GB |
| E4B | 17.9GB | 8.9GB | 4.5GB |
| E2B | 11.4GB | 5.7GB | 2.9GB |
Google หมายเหตุว่าตารางนี้แสดงเฉพาะหน่วยความจำที่ต้องใช้โหลดค่าน้ำหนักแบบคงที่ของโมเดล ไม่รวมหน่วยความจำเพิ่มเติมสำหรับซอฟต์แวร์หรือหน้าต่างบริบท (KV cache) และยังระบุว่าการใช้หน่วยความจำจะเพิ่มขึ้นแบบไดนามิกตามจำนวนโทเคนรวมของพรอมต์และคำตอบที่สร้างขึ้น ค่าที่ได้จากสูตรอย่างง่ายกับค่าในตารางของผู้พัฒนาอาจไม่ตรงกันในบางโมเดล เมื่อได้โมเดลที่เป็นตัวเลือกแล้ว ให้ตรวจสอบด้วยค่าในตารางของผู้พัฒนาหรือ Model Card
Model Card อื่นก็มีค่าประมาณเช่นกัน Model Card ของ Mistral-Small-3.2-24B-Instruct-2506 ระบุว่าที่ bf16 หรือ fp16 ต้องใช้ GPU RAM ประมาณ 55GB บน GPU ส่วน Model Card ของ gpt-oss ระบุว่าเมื่อใช้การควอนไทซ์ MXFP4 กับค่าน้ำหนักของ MoE แล้ว 120b จะบรรจุลงใน GPU 80GB เพียงตัวเดียวได้ (ตัวอย่างเช่น NVIDIA H100 หรือ AMD MI300X) และ 20b ทำงานได้ภายในหน่วยความจำ 16GB และมีการระบุว่า Llama 4 Scout บรรจุลงใน GPU H100 ตัวเดียวได้ด้วยการควอนไทซ์ int4 แบบ On-the-fly ทั้งหมดนี้เป็นคำกล่าวอ้างของผู้พัฒนา เงื่อนไขด้านจำนวนการเชื่อมต่อพร้อมกันและความยาวบริบทต้องตรวจสอบแยกต่างหาก
KV cache เพิ่มขึ้นตามจำนวนการเชื่อมต่อพร้อมกันและความยาวบริบท
สิ่งที่มีผลรองจากค่าน้ำหนักคือ KV cache ซึ่งเป็นพื้นที่เก็บบริบทของบทสนทนาหรือเอกสารไว้ในหน่วยความจำ GPU บล็อกเทคนิคของ NVIDIA ที่กล่าวไปแล้วแสดงปริมาณรวมด้วยสูตรต่อไปนี้
KV cache = ขนาดแบตช์ × ความยาวลำดับ × 2 × จำนวนชั้น × hidden size × จำนวนไบต์ของ FP16
ตัวอย่างในบล็อกเดียวกัน หากรัน Llama 2 7B ที่แบตช์ 1 ความยาวลำดับ 4096 32 ชั้น hidden size 4096 และ FP16 จะได้ KV cache ประมาณ 2GB ตามสูตร KV cache เพิ่มขึ้นตามสัดส่วนของขนาดแบตช์ (จำนวนคำขอที่ประมวลผลพร้อมกัน) และความยาวลำดับ (ความยาวบริบท) ในงานที่ป้อนบันทึกคุณภาพหรือคำอธิบายแบบงานยาว ๆ ผ่าน RAG และมีหลายคนใช้พร้อมกัน ส่วนนี้อาจไม่ได้จบเพียงไม่กี่สิบเปอร์เซ็นต์ของค่าน้ำหนัก
มีข้อควรระวังหนึ่งข้อ สูตรนี้ใช้ hidden size แต่ในโมเดลที่ใช้ GQA (Grouped Query Attention) KV cache จะคำนวณจากจำนวน KV head × มิติของ head ตัวอย่างเช่น Qwen3-30B-A3B-Instruct-2507 ที่กล่าวไปแล้วมี KV head เท่ากับ 4 หากใช้สูตรนี้ตรง ๆ จะได้ค่าประมาณที่สูงเกินจริง ค่าที่แม่นยำควรตรวจสอบจากโครงสร้างของโมเดลที่เลือกใช้และการวัดจริงด้วยซอฟต์แวร์อนุมาน
ฝั่งซอฟต์แวร์อนุมานก็มีการตั้งค่าที่ช่วยลด KV cache ตาม FAQ ของ Ollama การตั้งค่าการควอนไทซ์ KV cache (OLLAMA_KV_CACHE_TYPE) มีค่าเริ่มต้นเป็น f16 หากตั้งเป็น q8_0 จะใช้หน่วยความจำประมาณครึ่งหนึ่งของ f16 และ q4_0 ประมาณหนึ่งในสี่ (ตามที่ผู้พัฒนาระบุ) ประเด็นที่ต้องตรวจสอบผลต่อความแม่นยำแลกกับหน่วยความจำที่ลดลง ก็เหมือนกับการควอนไทซ์ค่าน้ำหนัก
ข้อมูลจำเพาะทางการของผลิตภัณฑ์ GPU
ตารางต่อไปนี้รวบรวมความจุหน่วยความจำและข้อมูลอื่นที่ระบุในหน้าเว็บทางการของผลิตภัณฑ์ GPU ทั้งหมดเป็นข้อมูลที่ผู้ผลิตระบุ และเนื่องจากหน้าเว็บทางการไม่ได้ระบุราคา บทความนี้จึงไม่กล่าวถึงราคา
| ผลิตภัณฑ์ (NVIDIA) | หน่วยความจำ GPU | แบนด์วิดท์หน่วยความจำ | กำลังไฟสูงสุด | หมายเหตุ |
|---|---|---|---|---|
| L4 | 24GB | 300GB/s | 72W (TDP) | 1 สล็อต PCIe แบบ Low-profile |
| L40S | 48GB GDDR6 (ECC) | 864GB/s | 350W | Dual-slot |
| RTX PRO 6000 Blackwell Server Edition | 96GB GDDR7 (ECC) | 1597GB/s | 600W (ปรับตั้งค่าได้) | แบ่งเป็นอินสแตนซ์อิสระได้สูงสุด 4 ชุดด้วย MIG |
| H200 | 141GB HBM3e | 4.8TB/s | SXM สูงสุด 700W, NVL สูงสุด 600W (ปรับตั้งค่าได้) | มี 2 รูปแบบ คือ SXM และ NVL |
| DGX Spark | หน่วยความจำรวม 128GB LPDDR5x (มีแบบ 64GB ผ่าน OEM) | — | — | ระบุว่ารองรับการอนุมานโมเดลสูงสุด 200,000 ล้านพารามิเตอร์ และการ Fine-tuning โมเดลสูงสุด 70,000 ล้านพารามิเตอร์ เชื่อมต่อได้สูงสุด 4 เครื่อง |
ลำดับการเลือกคือ ① ใช้ตารางค่าน้ำหนักคัดคู่ของโมเดลตัวเลือกกับความละเอียด ② เผื่อพื้นที่ KV cache จากจำนวนการเชื่อมต่อพร้อมกันและความยาวบริบท ③ ตัดสินว่าจะบรรจุใน GPU การ์ดเดียวได้หรือต้องแบ่งไปหลายการ์ด กำลังไฟและการระบายความร้อน พื้นที่ว่างในแร็ก และความจุแหล่งจ่ายไฟ เป็นข้อจำกัดที่มักถูกมองข้ามในห้องเซิร์ฟเวอร์ของโรงงาน ควรตรวจสอบเงื่อนไขของสถานที่ติดตั้งกับฝ่ายอาคารและสิ่งอำนวยความสะดวกก่อนเลือก GPU
ซอฟต์แวร์อนุมานและการควอนไทซ์: เลือกอะไรแล้วอะไรเปลี่ยน
ระหว่างโมเดลกับ GPU จะมีซอฟต์แวร์อนุมาน (Inference engine หรือซอฟต์แวร์ Serving) คั่นอยู่ สิ่งที่เลือกจะเปลี่ยนความสามารถรองรับการเชื่อมต่อพร้อมกัน รูปแบบการควอนไทซ์ที่รองรับ และฮาร์ดแวร์ที่รันได้ ข้อมูลต่อไปนี้ทั้งหมดเป็นข้อมูลที่ผู้พัฒนาหรือผู้ดูแลโครงการระบุ
| ซอฟต์แวร์อนุมาน | สถานะ (คำอธิบายของผู้พัฒนา) | คุณลักษณะหลัก | API | ตัวอย่างสถานการณ์ที่เหมาะ |
|---|---|---|---|---|
| vLLM | ไลบรารีที่รวดเร็วและใช้งานง่ายสำหรับการอนุมานและการให้บริการ LLM | การจัดการหน่วยความจำ KV ด้วย PagedAttention, Continuous batching, Prefix caching รองรับการควอนไทซ์ เช่น FP8, MXFP4, INT8, INT4, GPTQ และ AWQ, GGUF | API ที่เข้ากันได้กับ OpenAI, Anthropic Messages API, gRPC | เซิร์ฟเวอร์ภายในองค์กรที่หลายคนใช้พร้อมกัน |
| SGLang | เฟรมเวิร์กการให้บริการประสิทธิภาพสูงสำหรับ LLM และโมเดลมัลติโมดัล (ดำเนินการโดย LMSYS) | RadixAttention, Prefix caching, การประมวลผลขนานหลาย GPU รองรับ BF16, FP8, NVFP4 และอื่น ๆ รองรับ NVIDIA, AMD, Intel Xeon, Google TPU และอื่น ๆ | — | การให้บริการระบบจริงบนหลาย GPU |
| llama.cpp | ทำให้การอนุมาน LLM เป็นไปได้บนฮาร์ดแวร์หลากหลายด้วยการตั้งค่าน้อยที่สุด | การควอนไทซ์แบบจำนวนเต็ม 1.5 บิตถึง 8 บิต รูปแบบ GGUF รองรับ Apple Silicon, CUDA, HIP, Vulkan, CPU | llama-server ให้บริการ API ที่เข้ากันได้กับ OpenAI | การทดสอบขนาดเล็ก สภาพแวดล้อมที่มี GPU จำกัด |
| Ollama | สภาพแวดล้อมสำหรับรันโมเดลที่ทำงานแบบโลคัล | ค่าเริ่มต้นผูกกับ 127.0.0.1:11434 จำนวนการประมวลผลพร้อมกันต่อโมเดล (OLLAMA_NUM_PARALLEL) มีค่าเริ่มต้นเป็น 1 หน้าต่างบริบทเริ่มต้นเป็น 4096 โทเคนตามที่ระบุใน FAQ ณ เวลาที่ตรวจสอบ | — | การทดลองโดยบุคคลหรือคนจำนวนน้อย ช่วงต้นของ PoC |
เครื่องหมาย “—” ในตาราง หมายถึงรายการที่ไม่พบข้อมูลในขอบเขตที่การสำรวจของบทความนี้ตรวจสอบ
แยกการทดลองโดยคนจำนวนน้อยออกจากการใช้งานจริงระดับฝ่าย
การทดลองอย่างรวดเร็วด้วย Ollama หรือ llama.cpp ในช่วงต้นของ PoC เป็นเรื่องสมเหตุสมผล อย่างไรก็ตาม Ollama โดยค่าเริ่มต้นผูกกับ localhost เท่านั้น การเปิดให้เข้าถึงผ่านเครือข่ายต้องตั้งค่า OLLAMA_HOST อย่างชัดแจ้ง และจำนวนการประมวลผลพร้อมกันต่อโมเดลก็มีค่าเริ่มต้นเป็น 1 หากจะใช้ร่วมกันในฝ่ายเป็นเซิร์ฟเวอร์ภายในองค์กร จำเป็นต้องออกแบบการตั้งค่าการเชื่อมต่อพร้อมกัน และการยืนยันตัวตนกับการควบคุมการเข้าถึงแยกต่างหาก หน้าต่างบริบทเริ่มต้นก็ระบุไว้ใน FAQ ณ เวลาที่ตรวจสอบว่าเป็น 4096 โทเคน ในงานที่ป้อนเอกสารยาวจึงต้องตรวจสอบการตั้งค่า (ค่าเริ่มต้นนี้เป็นการตั้งค่าที่เปลี่ยนไปตามเวอร์ชัน)
ในระบบจริงที่หลายคนในฝ่ายใช้พร้อมกัน ซอฟต์แวร์ Serving ที่มี Continuous batching และการจัดการ KV cache อย่าง vLLM หรือ SGLang จะเป็นตัวเลือก ดังที่ Model Card ของ Qwen3-30B-A3B-Instruct-2507 ระบุ vLLM 0.8.5 ขึ้นไป และ SGLang 0.4.6.post1 ขึ้นไป เป็นการ Serving ที่แนะนำ บางโมเดลมีการระบุซอฟต์แวร์อนุมานและเวอร์ชันที่แนะนำไว้ ควรเลือกโมเดลและซอฟต์แวร์อนุมานเป็นคู่กัน
การควอนไทซ์ลดหน่วยความจำได้ แต่ความแม่นยำต้องตรวจสอบเอง
การควอนไทซ์คือเทคนิคที่ย่อค่าน้ำหนักจาก 16 บิตเป็น 8 บิตหรือ 4 บิตเพื่อลดหน่วยความจำ ดังที่เห็นในตารางค่าน้ำหนัก หากเป็น 4 บิตจะเหลือหนึ่งในสี่ของ 16 บิต อย่างไรก็ตาม ความแม่นยำจะลดลงเท่าใดขึ้นอยู่กับโมเดล วิธีควอนไทซ์ และลักษณะงาน ในงานที่การเสื่อมลงเพียงเล็กน้อยอาจนำไปสู่ความผิดพลาดทางธุรกิจ เช่น การอ่านตัวเลข การคัดลอกรหัสรุ่นหรือค่ามาตรฐาน หรือชื่อเฉพาะภาษาไทย ให้ใส่ การเปรียบเทียบเวอร์ชัน 16 บิตกับเวอร์ชันควอนไทซ์ด้วยชุดข้อมูลประเมินเดียวกัน ไว้ในการทดสอบรับมอบ
รูปแบบการควอนไทซ์ที่รองรับยังเปลี่ยนไปตามรุ่นของ GPU ด้วย ในตารางความเข้ากันได้ด้านการควอนไทซ์ของ vLLM ระบุว่า AWQ รองรับบน GPU ของ NVIDIA ตั้งแต่รุ่น Turing ขึ้นไป (Volta ไม่อยู่ในขอบเขต) เป็นต้น และ FP8 (W8A8) ของ llm-compressor รองรับบนรุ่น Ada และ Hopper และ GPU ของ AMD โดยมีหมายเหตุว่าตารางความเข้ากันได้อาจเปลี่ยนแปลงในอนาคต ควรตรวจสอบคู่ของ GPU กับรูปแบบการควอนไทซ์จากตารางความเข้ากันได้ล่าสุดของซอฟต์แวร์อนุมานก่อนสั่งซื้อ
โครงสร้างโดยรวมของการสร้างเซิร์ฟเวอร์ LLM ภายในองค์กร: การยืนยันตัวตน RAG ล็อก และการเฝ้าระวัง
LLM แบบโลคัลยังใช้ในงานจริงไม่ได้ หากเพียงแค่ติดตั้งโมเดลบนเซิร์ฟเวอร์ GPU โครงสร้างโดยรวมเมื่อสร้างเป็นเซิร์ฟเวอร์ภายในองค์กร แบ่งได้คร่าว ๆ เป็นชั้นต่อไปนี้
- ช่องทางเข้าของผู้ใช้: หน้าจอแชตภายในองค์กร หรือการฝังเข้าไปในระบบจัดการเอกสารหรือพอร์ทัลเดิม เชื่อมกับบัญชีพนักงานด้วย Single Sign-On
- การยืนยันตัวตนและการควบคุมการเข้าถึง: กำหนดว่าใครค้นหาเอกสารใดได้ ให้ตรงกับสิทธิ์ของเอกสารเดิม หลุมพรางใหญ่อย่างหนึ่งของ LLM แบบโลคัลคือ ผู้ที่ไม่มีสิทธิ์สามารถอ่านบันทึกคุณภาพหรือต้นทุนที่ตามปกติไม่ควรเห็นได้ผ่าน RAG
- RAG (การค้นหาเอกสารภายในองค์กร): ชั้นที่ค้นหาหมายเหตุในแบบงาน ข้อกำหนดของลูกค้า บันทึกคุณภาพ และระเบียบภายใน แล้วส่งให้ LLM การจัดการเวอร์ชันเอกสาร ภาษาที่ปะปนกัน และการจัดการตารางและภาพ เป็นตัวกำหนดความแม่นยำ ภาพรวมของการสร้างและประเมิน RAG อยู่ใน การนำ RAG มาใช้ในองค์กร – คู่มือการพัฒนา ต้นทุน และการประเมินที่ช่วยลดความเสี่ยง และมาตรการรับมือปัญหาที่ระบบตอบจากเอกสารฉบับเก่า อยู่ใน จัดการเวอร์ชันเอกสารใน RAG โรงงาน – ข้อกำหนดติดตั้งและเกณฑ์ตรวจรับ
- เซิร์ฟเวอร์อนุมาน: ซอฟต์แวร์อนุมานและ GPU ในบทก่อนหน้า หากใช้หลายโมเดลแยกตามลักษณะงาน การสลับโมเดลก็จัดการที่ชั้นนี้
- ล็อกและการเฝ้าระวัง: บันทึกว่าใคร เมื่อใด ถามอะไร และได้คำตอบอะไรโดยอ้างอิงเอกสารใด รวมถึงการเฝ้าระวังอัตราการใช้ GPU เวลาตอบสนอง และข้อผิดพลาด ตัวล็อกเองก็มีข้อมูลลับ จึงต้องกำหนดที่เก็บล็อกและสิทธิ์การเข้าดูด้วย
- ขอบเขตกับระบบเดิม: หากให้ LLM อ้างอิงข้อมูลจาก MES หรือ ERP ต้องกำหนดว่าจะให้อ่านอย่างเดียว หรืออนุญาตให้เขียน และจะส่งข้อมูลถึงรายการใด การออกแบบเพื่อเชื่อม MES และ ERP ของโรงงานเข้ากับ AI Agent อย่างปลอดภัย ดูได้ที่ สร้าง MCP Server สำหรับโรงงาน – เชื่อม MES และ ERP เข้ากับ AI Agent อย่างปลอดภัย
เมื่อวาดแผนภาพโครงสร้าง ให้ระบุว่า “แต่ละชั้นอยู่บนสิ่งอำนวยความสะดวกของใคร ในประเทศใด” แม้จะวางเฉพาะเซิร์ฟเวอร์อนุมานไว้ในบริษัท แต่หากวางระบบค้นหาของ RAG หรือล็อกไว้บน SaaS ในต่างประเทศ ข้อมูลก็ออกนอกบริษัทอยู่ดี
ความปลอดภัย: ความเสี่ยงที่ไม่หายไปแม้เป็นแบบโลคัล
การวางระบบแบบโลคัลมีข้อดีที่พรอมต์และคำตอบไม่ถูกส่งไปยังผู้ให้บริการโมเดลภายนอก แต่ความเสี่ยงเฉพาะของแอปพลิเคชัน LLM ส่วนใหญ่ยังคงอยู่ไม่ว่าจะวางไว้ที่ใด ตารางต่อไปนี้เรียบเรียงหัวข้อที่ควรใส่ใจเป็นพิเศษสำหรับ LLM แบบโลคัล จาก “OWASP Top 10 for LLM Applications 2025” ที่ OWASP (ชุมชนด้านมาตรฐานที่ไม่แสวงหากำไร) เผยแพร่ในเดือนมีนาคม 2025 และ “NIST AI 600-1” ซึ่งเป็นการเรียบเรียงความเสี่ยงสำหรับ Generative AI ที่ NIST เผยแพร่ในเดือนกรกฎาคม 2024
| ความเสี่ยง (หัวข้อตามแหล่งที่มา) | สิ่งที่เกิดขึ้นกับ LLM แบบโลคัล | ตัวอย่างมาตรการ |
|---|---|---|
| ห่วงโซ่อุปทาน (OWASP LLM03) การผนวกองค์ประกอบของบุคคลที่สาม (NIST) | นำไฟล์โมเดลที่ไม่ทราบที่มาหรือไฟล์ที่ถูกดัดแปลงเข้ามาใช้ | จำกัดแหล่งที่มาไว้ที่รีโพสิทอรีทางการของผู้พัฒนา ให้ความสำคัญกับรูปแบบ safetensors บันทึกค่าแฮช |
| Prompt Injection (OWASP LLM01) | LLM ทำตามคำสั่งที่ถูกฝังไว้ในเอกสารที่ RAG อ่านเข้ามา | จำกัดแหล่งที่นำเอกสารเข้า จำกัดสิทธิ์ที่ให้กับ LLM |
| การเปิดเผยข้อมูลที่ละเอียดอ่อน (OWASP LLM02) | ผู้ใช้ที่ไม่มีสิทธิ์อ่านเอกสารลับของฝ่ายอื่นได้ผ่าน RAG | ตรวจสอบสิทธิ์ของเอกสารทุกครั้งขณะค้นหา ใส่คำถามที่เกินสิทธิ์ไว้ในการทดสอบรับมอบ |
| สิทธิ์เกินจำเป็น (OWASP LLM06) | LLM สามารถเขียนข้อมูลลงใน MES หรือ ERP ได้ | เริ่มจากอ่านอย่างเดียว การเขียนต้องผ่านการอนุมัติของคน |
| จุดอ่อนของเวกเตอร์และ Embedding (OWASP LLM08) | เนื้อหาของเอกสารลับถูกอนุมานได้จากฐานข้อมูลเวกเตอร์สำหรับการค้นหา | ใช้การควบคุมการเข้าถึงแบบเดียวกับเอกสารกับฐานข้อมูลเวกเตอร์ด้วย |
| ข้อมูลผิด (OWASP LLM09) การสร้างข้อมูลเท็จ (NIST) | คัดลอกคำตอบผิดที่ดูน่าเชื่อลงในแบบงานหรือรายงานโดยตรง | แสดงเอกสารอ้างอิง กำหนดวิธีปฏิบัติให้ตรวจตัวเลขและค่ามาตรฐานกับต้นฉบับ |
| การใช้ทรัพยากรไม่จำกัด (OWASP LLM10) | การป้อนเอกสารยาวจำนวนมากทำให้ GPU ถูกยึดครองจนผู้ใช้อื่นใช้ไม่ได้ | กำหนดเพดานต่อผู้ใช้ และเพดานความยาวบริบท |
ตรวจสอบแหล่งที่มาของไฟล์โมเดล
ประเด็นเฉพาะของ LLM แบบโลคัลคือความปลอดภัยของไฟล์โมเดล เอกสารของ Hugging Face อธิบายว่า pickle ซึ่งเป็นรูปแบบค่าน้ำหนักเริ่มต้นของ PyTorch มีความเสี่ยงที่จะรันโค้ดใด ๆ ได้ขณะโหลด และยกมาตรการไว้ ได้แก่ การดาวน์โหลดจากองค์กรที่เชื่อถือได้ การตรวจสอบ Commit ที่มีลายเซ็น (แต่ลายเซ็นรับประกันแหล่งที่มา ไม่ได้รับประกันความปลอดภัย) และรูปแบบทางเลือกอย่าง safetensors โดยอธิบายว่า safetensors เป็นรูปแบบที่จัดเก็บเทนเซอร์ได้อย่างปลอดภัยต่างจาก pickle Hugging Face Hub สแกนไฟล์ที่อัปโหลด แต่ระบุชัดว่า “ไม่ได้แน่นอน 100%” และ “การยืนยันความปลอดภัยเป็นความรับผิดชอบของผู้ใช้”
ในฐานะกฎการดำเนินงานภายในบริษัท หลักพื้นฐานคือ บันทึกว่านำไฟล์จากรีโพสิทอรีใด เวอร์ชันใด เข้ามาโดยใครเป็นผู้อนุมัติ และทำตามขั้นตอนเดียวกันทุกครั้งที่อัปเดตโมเดล
อย่าอธิบายว่า “ปลอดภัยเพราะเป็นโลคัล”
เมื่ออธิบายต่อผู้บริหารหรือลูกค้า ควรหลีกเลี่ยงการยืนยันว่า “ข้อมูลไม่รั่วไหลเพราะเป็นโลคัล” การที่ข้อมูลไม่ถูกส่งไปยังผู้ให้บริการโมเดลภายนอก กับการที่ไม่เกิดการเข้าถึงเกินสิทธิ์ภายในบริษัทหรือการนำผลลัพธ์ไปใช้ผิด เป็นคนละเรื่องกัน NIST AI 600-1 ก็ยกความเสี่ยงที่เกิดเฉพาะหรือถูกขยายโดย Generative AI เช่น การสร้างข้อมูลเท็จ ความเป็นส่วนตัวของข้อมูล ความปลอดภัยสารสนเทศ และการผนวกองค์ประกอบของบุคคลที่สามอย่างไม่โปร่งใส ส่วน “แนวปฏิบัติสำหรับผู้ประกอบการ AI (AI Guidelines for Business)” ของญี่ปุ่น ได้เผยแพร่ฉบับที่ 1.2 ในเดือนมีนาคม 2026 พร้อมเช็กลิสต์และเวิร์กชีต ซึ่งใช้อ้างอิงเป็นกรอบการประเมินความเสี่ยงภายในบริษัทได้
ข้อควรระวังเมื่อดำเนินการในไทยและอาเซียน
การโอนข้อมูลข้ามพรมแดนตาม PDPA
ภายใต้พระราชบัญญัติคุ้มครองข้อมูลส่วนบุคคลของไทย (PDPA) ประกาศของคณะกรรมการคุ้มครองข้อมูลส่วนบุคคล (PDPC) 2 ฉบับเกี่ยวกับการโอนข้อมูลข้ามพรมแดนตามมาตรา 28 และมาตรา 29 ได้ประกาศเมื่อวันที่ 25 ธันวาคม 2023 และมีผลบังคับใช้ตั้งแต่วันที่ 24 มีนาคม 2024 ตามคำอธิบายของสำนักงานกฎหมาย มาตรา 28 กำหนดให้ประเทศหรือองค์การระหว่างประเทศปลายทางต้องมีมาตรฐานการคุ้มครองที่เพียงพอ และมาตรา 29 กำหนดการโอนภายใต้มาตรการคุ้มครองที่เหมาะสม เช่น นโยบายคุ้มครองข้อมูลส่วนบุคคลภายในกลุ่มกิจการ (BCR) หรือข้อสัญญามาตรฐาน การส่งพรอมต์ที่มีข้อมูลส่วนบุคคลไปยัง LLM หรือ API แบบ SaaS ในต่างประเทศ อาจเข้าข่ายการโอนข้ามพรมแดนนี้ จะเข้าข่ายหรือไม่ ควรสอบถามฝ่ายกฎหมายหรือผู้เชี่ยวชาญภายนอก LLM แบบโลคัลเป็นทางเลือกหนึ่งเมื่อต้องการเก็บงานที่มีข้อมูลส่วนบุคคลไว้ภายในประเทศ
สถานะของกฎหมาย AI
ในประเทศไทย สำนักงานพัฒนาธุรกรรมทางอิเล็กทรอนิกส์ (ETDA) เผยแพร่ร่างกฎหมาย AI เมื่อวันที่ 9 กรกฎาคม 2026 และเปิดรับฟังความคิดเห็นสาธารณะถึงวันที่ 14 สิงหาคม 2026 ตามคำอธิบายของสำนักงานกฎหมาย ร่างนี้เป็นกรอบที่อิงความเสี่ยง โดยให้หน่วยงานกำกับดูแลรายสาขาเป็นผู้กำหนดข้อกำหนด ไม่ใช่หน่วยงานกำกับดูแลเดียว ณ วันที่ 10 ตุลาคม 2026 ยังอยู่ในขั้นร่าง และมีความเห็นว่าหลังคณะรัฐมนตรีอนุมัติหลักการแล้ว อาจใช้เวลา 6 ถึง 24 เดือนกว่าจะตราและมีผลบังคับใช้
ในเวียดนาม กฎหมาย AI ได้รับการรับรองในเดือนธันวาคม 2025 และมีผลบังคับใช้ตั้งแต่วันที่ 1 มีนาคม 2026 ตามพอร์ทัลของรัฐบาลเวียดนาม กฎหมายนี้มีทั้งหมด 35 มาตรา มีคำอธิบายว่าใช้การจัดระดับความเสี่ยง 3 ระดับ คือ สูง กลาง และต่ำ และมีมาตรการเฉพาะกาลสำหรับระบบ AI ที่มีอยู่แล้ว (การแพทย์ การศึกษา และการเงิน 18 เดือน อื่น ๆ 12 เดือน)
ผลกระทบของแนวโน้มกฎระเบียบในไทยและเวียดนามต่อการตัดสินใจโฮสต์เอง ได้กล่าวไว้ใน การนำ LLM มาใช้ถูกตัดสินด้วยวิธีถือครองโครงสร้างพื้นฐาน ในที่นี้ขอเพียงแนะนำว่า บนพื้นฐานที่สถานะของกฎระเบียบแตกต่างกันในแต่ละประเทศและกำลังเปลี่ยนแปลง ควรวางโครงสร้างให้เก็บบันทึกล็อกและผลการประเมินไว้ได้
การจัดการภาษาไทยและภาษาเวียดนาม
ที่ฐานการผลิตในไทย มักมีภาษาญี่ปุ่น ไทย และอังกฤษปะปนอยู่ในเอกสารเดียว บริษัทที่มีฐานการผลิตในเวียดนามก็จะมีภาษาเวียดนามเพิ่มเข้ามา ดังที่เห็นในบทการคัดเลือกโมเดล สถานะการรองรับภาษาแตกต่างกันไปตามโมเดล ควรเปรียบเทียบโมเดลเฉพาะทางภาษาไทย (ThaiLLM, Typhoon) โมเดลเฉพาะทางภาษาญี่ปุ่น (GPT-OSS Swallow) และโมเดลหลายภาษา ด้วยคู่ภาษาที่บริษัทใช้จริง ปัญหาที่ความแม่นยำภาษาเวียดนามพังลงในขั้นเตรียมข้อมูล อธิบายไว้ใน ความแม่นยำ Generative AI ภาษาเวียดนาม – สิ่งที่พังไม่ใช่โมเดลแต่เป็นการเตรียมข้อมูล
การคำนวณต้นทุนและผลตอบแทนด้วยแบบจำลอง (ตัวเลขสมมติ)
ต่อจากนี้เป็นการคำนวณด้วยแบบจำลองเพื่อแสดง “โครงสร้าง” ของการประมาณการ ตัวเลขต่อไปนี้ทั้งหมดเป็นตัวเลขสมมติที่ตั้งขึ้นสำหรับบทความนี้ ไม่ใช่ค่าเฉลี่ยของอุตสาหกรรม ไม่ใช่ตัวเลขของบริษัทสำรวจ และไม่ใช่ราคาของผู้จำหน่าย โปรดแทนที่ด้วยตัวเลขของบริษัทท่านเอง
สมมติฐานของโรงงานจำลอง
สมมติเป็นฐานการผลิต 1 แห่งของผู้ผลิตชิ้นส่วนสัญชาติญี่ปุ่นในไทย พนักงาน 120 คนจากฝ่ายออกแบบ ฝ่ายประกันคุณภาพ ฝ่ายวางแผนการผลิต และฝ่ายจัดซื้อ ใช้ LLM แบบโลคัลสำหรับการค้นหาเอกสารภายในองค์กร (RAG) และการร่างหรือสรุปเอกสาร โดยมีเป้าหมายคือหมายเหตุในแบบงาน ข้อกำหนดของลูกค้า บันทึกคุณภาพ และระเบียบภายใน สกุลเงินคือบาท (THB)
| รายการ | ค่าสมมติ |
|---|---|
| ผู้ใช้ U | 120 คน |
| ชั่วโมงที่ลดได้ต่อคนต่อเดือน h | กรณีหลัก 3 ชั่วโมง/เดือน |
| ค่าแรงต่อชั่วโมง W | 400 THB/ชั่วโมง |
| ค่าใช้จ่ายเริ่มต้น I | 2,400,000 THB (ฮาร์ดแวร์ เช่น เซิร์ฟเวอร์ GPU 1,500,000 + การสร้างระบบ 900,000 [การเชื่อมต่อการยืนยันตัวตน, RAG, ล็อก, การสร้างชุดข้อมูลประเมิน, PoC]) |
| ค่าใช้จ่ายดำเนินงานต่อปี L | 780,000 THB/ปี (ไฟฟ้าและสถานที่ติดตั้ง 120,000 + การบำรุงรักษาและการสนับสนุนจากภายนอก 360,000 + ผู้รับผิดชอบดูแลระบบภายในบริษัท 0.3 คน × 1,000,000 = 300,000) |
| อายุการใช้งานฮาร์ดแวร์ | สมมติ 5 ปี |
กรณีหลัก (h = 3 ชั่วโมง/เดือน)
| รายการ | กรณีหลัก (h = 3 ชั่วโมง/เดือน) | การคำนวณ |
|---|---|---|
| ชั่วโมงที่ลดได้ต่อปี | 4,320 ชั่วโมง/ปี | 120 × 3 × 12 |
| มูลค่าเป็นเงินของชั่วโมงที่ลดได้ | 1,728,000 THB/ปี | 4,320 × 400 |
| ค่าใช้จ่ายดำเนินงานต่อปี | −780,000 THB/ปี | ค่าสมมติ |
| ผลตอบแทนสุทธิต่อปี | 948,000 THB/ปี | 1,728,000 − 780,000 |
| ระยะเวลาคืนทุนอย่างง่าย | ประมาณ 2.5 ปี | 2,400,000 ÷ 948,000 = 2.53 |
เมื่อเขียนเป็นสูตรทั่วไป จะได้ดังนี้
ผลตอบแทนสุทธิต่อปี = 576,000 × h − 780,000
576,000 คือมูลค่าเป็นเงินต่อปีที่เพิ่มขึ้นทุกครั้งที่ชั่วโมงที่ลดได้ต่อคนต่อเดือนเพิ่มขึ้น 1 ชั่วโมง (120 × 400 × 12)
ผลลัพธ์เปลี่ยนอย่างไรเมื่อเปลี่ยนชั่วโมงที่ลดได้
ลองเปลี่ยนเฉพาะชั่วโมงที่ลดได้ต่อคนต่อเดือน h
| h (ชั่วโมง/เดือน) | มูลค่าเป็นเงินของชั่วโมงที่ลดได้ | ผลตอบแทนสุทธิต่อปี | ระยะเวลาคืนทุนอย่างง่าย |
|---|---|---|---|
| 1 | 576,000 THB | −204,000 THB | ไม่คืนทุน (ไม่พอชดเชยค่าใช้จ่ายดำเนินงานต่อปี) |
| 2 | 1,152,000 THB | 372,000 THB | ประมาณ 6.5 ปี (2,400,000 ÷ 372,000 = 6.45) เกินอายุการใช้งานที่สมมติไว้ 5 ปี |
| 3 | 1,728,000 THB | 948,000 THB | ประมาณ 2.5 ปี (2,400,000 ÷ 948,000 = 2.53) |
| 5 | 2,880,000 THB | 2,100,000 THB | ประมาณ 1.1 ปี (2,400,000 ÷ 2,100,000 = 1.14) |
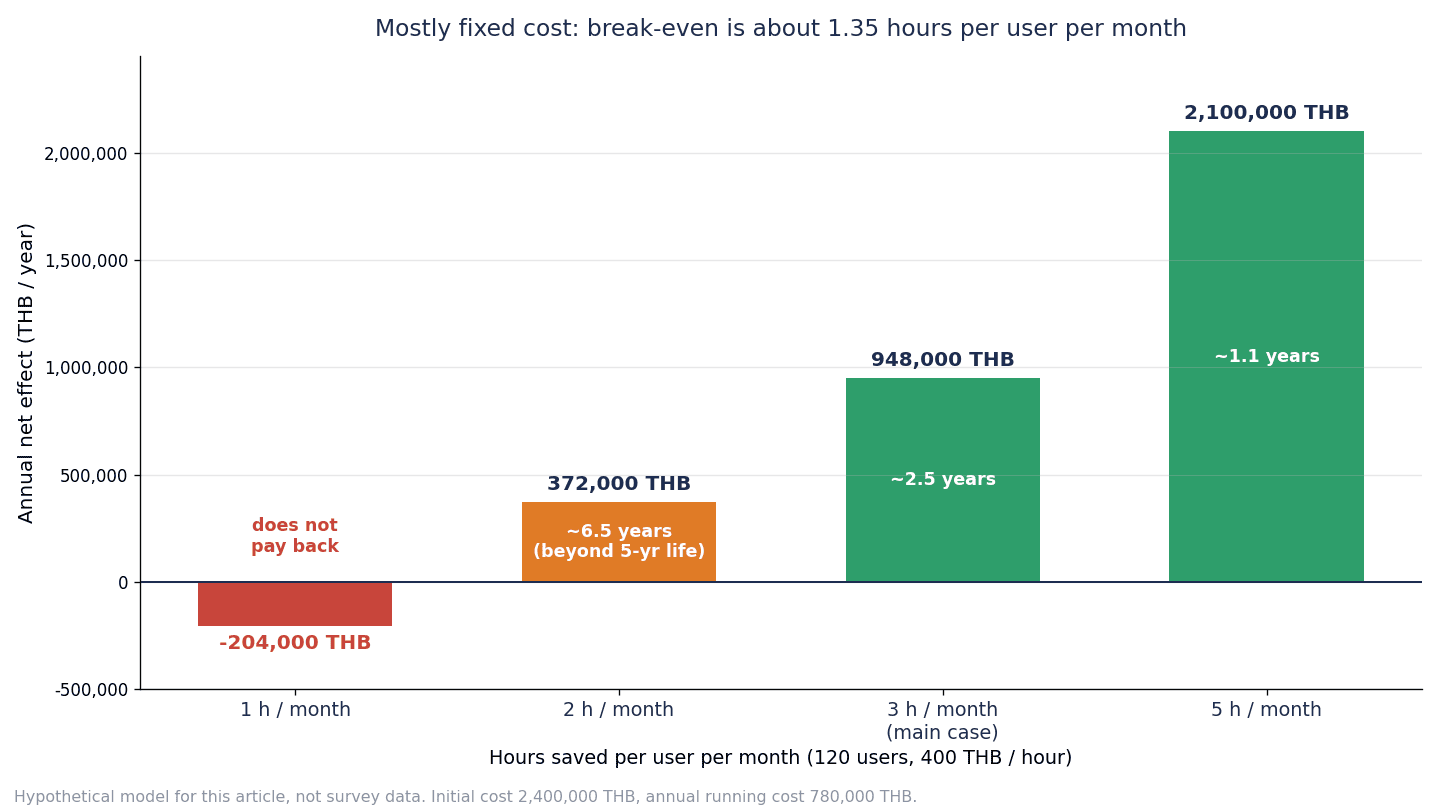
ค่า h ที่ทำให้ผลตอบแทนสุทธิต่อปีเป็น 0 คำนวณจาก 576,000 × h = 780,000 ได้ h ≈ 1.35 ชั่วโมง/เดือน หากต่ำกว่านี้ มูลค่าเป็นเงินของชั่วโมงที่ลดได้จะไม่พอแม้แต่ชดเชยค่าใช้จ่ายดำเนินงานต่อปี นอกจากนี้ หากจะคืนทุนค่าใช้จ่ายเริ่มต้นภายในอายุการใช้งานฮาร์ดแวร์ 5 ปี ต้องมีผลตอบแทนสุทธิต่อปีอย่างน้อย 480,000 THB (2,400,000 ÷ 5) จาก 576,000 × h ≥ 1,260,000 เงื่อนไขคือ h ≈ 2.19 ชั่วโมง/เดือนขึ้นไป ที่ h = 2 ชั่วโมง/เดือน แม้ผลตอบแทนสุทธิต่อปีจะเป็นบวก แต่ใช้เวลาคืนทุนประมาณ 6.5 ปี ซึ่งเกินอายุการใช้งานที่สมมติไว้ 5 ปี
กล่าวคือ ภายใต้สมมติฐานนี้ จุดแบ่งอยู่ที่ประมาณ 2 ชั่วโมงต่อคนต่อเดือน และหากต่ำกว่าประมาณ 1.35 ชั่วโมงต่อเดือน จะไม่พอแม้แต่ชดเชยค่าใช้จ่ายต่อปี ค่าใช้จ่ายส่วนใหญ่เป็นต้นทุนคงที่ เช่น เซิร์ฟเวอร์ GPU การบำรุงรักษา และผู้รับผิดชอบดูแลระบบ หากผู้ใช้น้อยหรือเวลาที่ใช้งานสั้น ก็จะไม่คืนทุน
แยกดูการลดเงินสดกับการลดเวลา
มูลค่าเป็นเงินของชั่วโมงที่ลดได้ จะไม่กลายเป็นการลดเงินสด หากไม่นำเวลาที่ว่างขึ้นไปใช้กับงานอื่น เงินสดที่จ่ายออกไปจริงคือค่าใช้จ่ายเริ่มต้น I และค่าใช้จ่ายดำเนินงานต่อปี L การที่เวลาที่ว่างขึ้นจะนำไปใช้กับการดูแลลูกค้า การปรับปรุงคุณภาพ หรือการพัฒนาครั้งถัดไปได้หรือไม่ จะเปลี่ยนความหมายของการลงทุนอย่างมาก
สิ่งที่ไม่ได้รวมไว้ในการประมาณการนี้
รายการต่อไปนี้เปลี่ยนแปลงได้มากตามเงื่อนไข จึงไม่ได้คิดเป็นจำนวนเงิน
- ส่วนที่ลดได้ของค่าใช้ SaaS หรือ API จากส่วนที่ย้ายมาเป็นแบบโลคัล (เพราะขึ้นอยู่กับว่ามีสัญญาเดิมหรือไม่)
- ผลด้านการตรวจประเมินของลูกค้าและด้านสัญญา จากการไม่ส่งข้อมูลลับออกนอกบริษัท
- การหลีกเลี่ยงเหตุข้อมูลรั่วไหล
- ค่าใช้จ่ายในการเปลี่ยน GPU (ตั้งแต่ปีที่ 6 เป็นต้นไป)
โปรดประเมินรายการเหล่านี้แยกต่างหาก แนวคิดในการบริหารต้นทุนของ Generative AI ตามหน่วยของผลลัพธ์ได้เรียบเรียงไว้ใน AI FinOps – จัดการต้นทุน Generative AI ต่อผลลัพธ์ที่ตรวจรับ
สิ่งที่บอกได้จากการประมาณการ
ชั่วโมงที่ลดได้ h ห้ามใช้ค่าที่คาดเดา ใน PoC ให้วัดเวลาทำงานของงานเป้าหมายจริงทั้งก่อนและหลังนำมาใช้ แล้วแทนที่ด้วยค่านั้น จากนั้นสิ่งที่บอกได้คือลำดับการดำเนินงานว่า แทนที่จะเริ่มจาก “สำหรับพนักงานทั้งบริษัท” ให้เริ่มจำกัดที่ “ฝ่ายที่จัดการข้อมูลลับเป็นประจำ” วัดชั่วโมงที่ลดได้จริงใน PoC แล้วจึงตัดสินใจโครงสร้าง GPU สำหรับระบบจริง
สำหรับฝ่ายที่มีผู้ใช้น้อย ยังมีทางเลือกที่จะเช่า GPU บนคลาวด์แบบปิดในประเทศไทยเป็นรายเดือนเพื่อทำ PoC ก่อน แล้วค่อยตัดสินใจซื้อฮาร์ดแวร์หลังวัดผลจริง ค่าบริการ GPU บนคลาวด์เปลี่ยนไปตามผู้ให้บริการและเงื่อนไขสัญญา จึงควรตรวจสอบจากใบเสนอราคา
รายการที่ต้องเขียนใน RFP ของ LLM แบบโลคัล
เมื่อเขียน RFP (เอกสารขอข้อเสนอ) สำหรับการจัดซื้อเซิร์ฟเวอร์ GPU หรือการว่าจ้างสร้างและดูแลระบบ ให้ใส่รายการต่อไปนี้ RFP ที่เขียนเพียง “โมเดลและรุ่นของ GPU” จะเปรียบเทียบข้อเสนอไม่ได้
| ลำดับ | รายการ | เนื้อหาที่ต้องเขียน |
|---|---|---|
| 1 | งานเป้าหมายและการจัดชั้นข้อมูล | ฝ่ายเป้าหมาย งานเป้าหมาย ข้อมูลที่จะวางไว้แบบโลคัลและเหตุผล การจัดการงานที่ส่งออกนอกบริษัทได้ |
| 2 | ขนาดการใช้งาน | จำนวนผู้ใช้ จำนวนการเชื่อมต่อพร้อมกันที่คาดไว้ ความยาวของเอกสารที่ป้อนต่อครั้ง ช่วงเวลาที่ใช้งานสูงสุด |
| 3 | โมเดลตัวเลือกและไลเซนส์ | โมเดลและเวอร์ชันที่เสนอ เงื่อนไขของไลเซนส์และข้อกำหนดการใช้งาน การรองรับภาษา การเปลี่ยนโมเดลได้หรือไม่ |
| 4 | เหตุผลประกอบด้าน GPU และหน่วยความจำ | รายละเอียดของค่าน้ำหนัก KV cache และพื้นที่ขณะรัน การควอนไทซ์หรือไม่ เหตุผลการคำนวณพื้นที่เผื่อเมื่อเชื่อมต่อพร้อมกัน |
| 5 | ซอฟต์แวร์อนุมาน | ซอฟต์แวร์อนุมานและเวอร์ชัน การตั้งค่าการเชื่อมต่อพร้อมกันและคิว ความเข้ากันได้ระหว่างรูปแบบการควอนไทซ์กับ GPU |
| 6 | การประเมินและเกณฑ์ตรวจรับ | จำนวนรายการและวิธีสร้างชุดข้อมูลประเมินจากเอกสารของบริษัท เกณฑ์ผ่านแยกตามภาษา การเปรียบเทียบก่อนและหลังควอนไทซ์ เวลาตอบสนอง |
| 7 | การยืนยันตัวตนและการควบคุมการเข้าถึง | Single Sign-On ความสอดคล้องกับสิทธิ์ของเอกสาร พฤติกรรมเมื่อได้รับคำถามที่เกินสิทธิ์ |
| 8 | ล็อกและการตรวจสอบ | รายการที่บันทึก ที่เก็บและระยะเวลาเก็บ สิทธิ์การเข้าดู รูปแบบการส่งให้ผู้ตรวจสอบ |
| 9 | การได้มาและการอัปเดตโมเดล | แหล่งที่มาของไฟล์โมเดล รูปแบบ (เช่น safetensors) ขั้นตอนอนุมัติการนำเข้า การประเมินซ้ำเมื่ออัปเดต |
| 10 | การดูแลระบบและการรับมือเหตุขัดข้อง | รายการที่เฝ้าระวัง ขั้นตอนย้อนกลับเมื่อเกิดเหตุขัดข้อง การบำรุงรักษาและเปลี่ยน GPU ทีมสนับสนุนในไทย การส่งต่องานดูแลระบบ |
| 11 | เงื่อนไขการติดตั้ง | สถานที่ติดตั้ง (ห้องเซิร์ฟเวอร์ของบริษัท ดาต้าเซ็นเตอร์ในประเทศ คลาวด์แบบปิด) ความจุแหล่งจ่ายไฟ การระบายความร้อน แร็ก |
| 12 | รายละเอียดค่าใช้จ่าย | ค่าใช้จ่ายเริ่มต้น (ฮาร์ดแวร์ การสร้างระบบ การสร้างชุดข้อมูลประเมิน PoC) และค่าใช้จ่ายต่อปี (ไฟฟ้า การบำรุงรักษา การสนับสนุนจากภายนอก) เงื่อนไขที่ทำให้ค่าใช้จ่ายเปลี่ยน |
โดยเฉพาะข้อ 4 และข้อ 6 เป็นรายการที่ใช้แยกคุณภาพของข้อเสนอ ข้อเสนอที่แจกแจงเหตุผลประกอบด้านหน่วยความจำไม่ได้ หรือเขียนเกณฑ์ตรวจรับเพียงว่า “ได้คะแนนสูงในเบนช์มาร์กทั่วไป” มีความเสี่ยงที่จะไม่เพียงพอเมื่อเข้าสู่การดูแลระบบจริง
สิ่งที่ต้องตรวจสอบใน PoC: 5 กรณีที่ตั้งใจทดสอบ
ใน PoC การยืนยันเพียงว่าระบบทำงานได้กับคำถามที่ตอบได้ดีนั้นไม่เพียงพอ ต้องตรวจสอบว่า เมื่อให้เงื่อนไขที่ยากโดยเจตนา ระบบสามารถตรวจจับคำตอบผิดได้หรือไม่ รักษาสิทธิ์ได้หรือไม่ และเวลาตอบสนองยังรับได้หรือไม่
| กรณี | ทำอะไร | สิ่งที่ตรวจสอบ |
|---|---|---|
| ① คำตอบผิดกับเอกสารของบริษัท | ปะปนคำถามที่ไม่มีคำตอบในเอกสาร และคำถามที่มีรหัสรุ่นใกล้เคียงหรือค่ามาตรฐานจากฉบับเก่า | ตอบว่า “ไม่ทราบ” หรือไม่ แสดงเอกสารอ้างอิงได้ถูกต้องหรือไม่ |
| ② ความแม่นยำแยกตามภาษา | รันชุดข้อมูลประเมินเดียวกันด้วยคู่ภาษาที่บริษัทใช้จริง เช่น ถามเป็นภาษาไทยกับเอกสารภาษาญี่ปุ่น หรือสรุปมาตรฐานการทำงานภาษาไทยเป็นภาษาญี่ปุ่น | อัตราผ่านแยกตามคู่ภาษา การสับสนชื่อเฉพาะและตัวเลข |
| ③ เวลาตอบสนองเมื่อเชื่อมต่อพร้อมกัน | ส่งคำขอที่ป้อนเอกสารยาวพร้อมกันตามจำนวนการเชื่อมต่อพร้อมกันที่คาดไว้ | เวลาตอบสนองอยู่ในช่วงที่งานรับได้หรือไม่ เกิดข้อผิดพลาดจากหน่วยความจำ GPU ไม่พอหรือไม่ |
| ④ คำถามที่เกินสิทธิ์ | ใช้บัญชีของผู้ใช้ที่ไม่มีสิทธิ์พยายามถามหาบันทึกคุณภาพหรือต้นทุนของฝ่ายอื่น | สิทธิ์ถูกตรวจสอบตั้งแต่ขั้นค้นหา และไม่ปรากฏในคำตอบหรือไม่ |
| ⑤ การเปลี่ยนโมเดล | เปลี่ยนเป็นเวอร์ชันควอนไทซ์หรือโมเดลอื่น แล้วรันชุดข้อมูลประเมินเดิมซ้ำ | อัตราผ่านเปลี่ยนไปเท่าใด การประเมินซ้ำใช้เวลากี่วัน |
KPI ที่วัด
- เวลาทำงานของงานเป้าหมาย (วัดจริงก่อนและหลังนำมาใช้ ใช้เป็นค่าแทน h ในการคำนวณด้วยแบบจำลอง)
- อัตราผ่านของชุดข้อมูลประเมิน (แยกตามคู่ภาษา และแยก 16 บิตกับเวอร์ชันควอนไทซ์)
- เวลาตอบสนองเมื่อเชื่อมต่อพร้อมกัน
- จำนวนครั้งที่ข้อมูลรั่วไหลจากคำถามที่เกินสิทธิ์ (ต้องเป็น 0 ครั้ง)
- ชั่วโมงงานที่ใช้ในการประเมินซ้ำ
กรณี ⑤ การเปลี่ยนโมเดล มักถูกมองข้ามแต่สำคัญ โมเดล Open-weight อาจมีเวอร์ชันใหม่หรือโมเดลอื่นเผยแพร่ออกมา และเป็นไปได้มากที่หลังเข้าสู่การดูแลระบบจริงแล้วจะอยากเปลี่ยนโมเดล หากไม่มีกลไกที่รันชุดข้อมูลประเมินซ้ำได้ทุกครั้ง ก็จะเหลือเพียงสองทาง คือใช้โมเดลเก่าต่อไป หรือเปลี่ยนโดยไม่ประเมิน โปรดตรวจสอบขั้นตอนและเวลาที่ใช้ในการประเมินซ้ำไว้ตั้งแต่ขั้น PoC เกณฑ์ในการตัดสินใจยุติ PoC และย้ายขึ้นระบบจริง รวมถึงการออกแบบการตรวจรับและการส่งต่องานดูแลระบบ อธิบายไว้ใน เกณฑ์ยุติโครงการทดลองปัญญาประดิษฐ์ เพื่อขึ้นระบบจริงและส่งมอบงาน
คำถามที่พบบ่อย
LLM แบบโลคัลคืออะไร?
คือรูปแบบที่รันโมเดล Open-weight (โมเดลที่เปิดเผยค่าน้ำหนักและดาวน์โหลดมารันได้) ในสภาพแวดล้อมที่บริษัทดูแลเอง เช่น เซิร์ฟเวอร์ของบริษัทหรือคลาวด์แบบปิดภายในประเทศไทย ความแตกต่างจาก Generative AI แบบ SaaS คือ บริษัทเป็นผู้กำหนดเองว่าจะรันโมเดลใด เวอร์ชันใด กับข้อมูลใด และพรอมต์กับคำตอบจะไม่ถูกส่งไปยังผู้ให้บริการโมเดลภายนอก
LLM แบบโลคัลต้องใช้ GPU แบบใด?
ขึ้นอยู่กับขนาดและความละเอียดของโมเดล จำนวนการเชื่อมต่อพร้อมกัน และความยาวบริบท หน่วยความจำของค่าน้ำหนักประมาณได้จาก “จำนวนพารามิเตอร์ × จำนวนไบต์ต่อ 1 พารามิเตอร์” ดังตารางในบทความ สมมติว่าเป็นโมเดล 32B จะใช้ 64GB ที่ 16 บิต และ 16GB ที่ 4 บิต ซึ่งเป็นค่าประมาณของค่าน้ำหนักเท่านั้น และยังต้องบวก KV cache กับพื้นที่ขณะรันของซอฟต์แวร์อนุมานเข้าไปด้วย อย่าเลือกจากชื่อผลิตภัณฑ์ GPU แต่ให้กำหนดงานเป้าหมายและจำนวนการเชื่อมต่อพร้อมกันก่อน แล้วคำนวณย้อนกลับหาหน่วยความจำที่ต้องใช้
LLM แบบ On-premises มีค่าใช้จ่ายเท่าไร?
หน้าเว็บทางการไม่ได้ระบุราคา GPU และค่าใช้จ่ายเปลี่ยนไปมากตามโครงสร้างระบบและใบเสนอราคา ในด้านโครงสร้างต้นทุน ควรขอใบเสนอราคาโดยแยกเป็นค่าใช้จ่ายเริ่มต้น (ฮาร์ดแวร์ การสร้างระบบ การสร้างชุดข้อมูลประเมิน PoC) และค่าใช้จ่ายต่อปี (ไฟฟ้าและสถานที่ติดตั้ง การบำรุงรักษาและการสนับสนุนจากภายนอก ผู้รับผิดชอบดูแลระบบภายในบริษัท) ในการคำนวณด้วยแบบจำลองของบทความ (ค่าสมมติ) เนื่องจากค่าใช้จ่ายส่วนใหญ่เป็นต้นทุนคงที่ หากชั่วโมงที่ลดได้ต่อคนต่อเดือนต่ำกว่าประมาณ 1.35 ชั่วโมง จะไม่พอแม้แต่ชดเชยค่าใช้จ่ายต่อปี และหากจะคืนทุนใน 5 ปี ต้องลดได้ประมาณ 2.19 ชั่วโมงขึ้นไป
LLM แบบโลคัลใช้กับภาษาญี่ปุ่นและภาษาไทยได้หรือไม่?
ขึ้นอยู่กับโมเดล ตัวอย่างเช่น Model Card ของ Llama 4 ระบุภาษาไทยและภาษาเวียดนามเป็นภาษาที่รองรับ แต่ภาษาญี่ปุ่นไม่อยู่ในรายการทางการ นอกจากนี้ยังมีโมเดลอย่าง GPT-OSS Swallow ที่เฉพาะทางภาษาญี่ปุ่น และ ThaiLLM หรือ Typhoon2.1-Gemma3-12B สำหรับภาษาไทย อย่างไรก็ตาม รายการภาษาที่รองรับหรือเบนช์มาร์กไม่ได้รับประกันความแม่นยำกับเอกสารของบริษัท ควรวัดจริงด้วยชุดข้อมูลประเมินที่สร้างจากคู่ภาษาที่บริษัทใช้จริง
ถ้าใช้ LLM แบบโลคัลจะไม่เกิดข้อมูลรั่วไหลหรือไม่?
ได้เปรียบในแง่ที่พรอมต์และคำตอบไม่ถูกส่งไปยังผู้ให้บริการโมเดลภายนอก แต่ความเสี่ยงข้อมูลรั่วไหลไม่ได้หมดไป ความเสี่ยงอย่างพนักงานที่ไม่มีสิทธิ์อ่านเอกสารลับของฝ่ายอื่นได้ผ่าน RAG การนำไฟล์โมเดลที่ไม่ทราบที่มาเข้ามาใช้ และตัวล็อกเองที่มีข้อมูลลับ ยังคงอยู่แม้เป็นแบบโลคัล จำเป็นต้องออกแบบการตรวจสอบสิทธิ์ของเอกสาร การจัดการแหล่งที่มาของไฟล์โมเดล และการเก็บรักษากับสิทธิ์การเข้าดูล็อก
เลือกโมเดล Open-weight อย่างไร?
คัดตัวเลือกด้วย 4 ประเด็น ได้แก่ เงื่อนไขของไลเซนส์และข้อกำหนดการใช้งาน การรองรับภาษาที่บริษัทใช้ ขนาดของโมเดล (บรรจุในหน่วยความจำ GPU ได้หรือไม่) และความยาวบริบท แล้วสุดท้ายเปรียบเทียบด้วยชุดข้อมูลประเมินจากเอกสารของบริษัท ไลเซนส์ให้อ่านจากเงื่อนไข ไม่ใช่จากคำว่า “เปิด” และก่อนนำมาใช้ควรตรวจสอบต้นฉบับข้อกำหนดการใช้งานร่วมกับฝ่ายกฎหมาย
สรุป
หากเริ่มการติดตั้ง LLM แบบโลคัลจากการเปรียบเทียบรุ่น GPU หรือเบนช์มาร์กของโมเดล อาจจบลงด้วยการซื้อเซิร์ฟเวอร์ราคาแพงแต่ไม่มีคนใช้ ให้กำหนดก่อนว่าจะวางงานใดไว้แบบโลคัลโดยอิงการจัดชั้นข้อมูล และคงงานที่ส่งออกนอกบริษัทได้ไว้กับ SaaS หรือ API จากนั้นสร้างชุดข้อมูลประเมินและเกณฑ์ผ่านจากเอกสารของบริษัทกับคู่ภาษาที่บริษัทใช้จริง แล้วกำหนดว่าใครรับผิดชอบการอัปเดตโมเดล การจัดการแหล่งที่มาของไฟล์โมเดล ล็อก และการย้อนกลับระบบเมื่อเกิดเหตุขัดข้อง GPU และโมเดลควรเลือกหลังจากตัดสินใจสามเรื่องนี้แล้ว โดยรวมค่าน้ำหนัก KV cache และพื้นที่เผื่อสำหรับการเชื่อมต่อพร้อมกัน เพื่อคำนวณย้อนกลับหาโครงสร้างขั้นต่ำที่จำเป็น
ในการคำนวณด้วยแบบจำลอง (ค่าสมมติ) เนื่องจากค่าใช้จ่ายส่วนใหญ่เป็นต้นทุนคงที่ หากชั่วโมงที่ลดได้ต่อคนต่อเดือนต่ำกว่าประมาณ 1.35 ชั่วโมง จะไม่พอแม้แต่ชดเชยค่าใช้จ่ายต่อปี และหากจะคืนทุนใน 5 ปี ต้องลดได้ประมาณ 2.19 ชั่วโมงขึ้นไป ด้วยเหตุนี้ ควรเริ่มโดยจำกัดที่ฝ่ายที่จัดการข้อมูลลับเป็นประจำ วัดชั่วโมงที่ลดได้จริงใน PoC แล้วจึงตัดสินใจโครงสร้าง GPU สำหรับระบบจริง ขณะที่ผู้ใช้ยังมีน้อย ก็มีทางเลือกที่จะเช่า GPU บนคลาวด์แบบปิดในประเทศเพื่อทดลองก่อน
TOMAS TECH ช่วยจัดเตรียมเอกสารภายในองค์กร การใช้ Generative AI และการเชื่อมต่อกับระบบเดิม ให้เหมาะกับงานของโรงงานในไทย ท่านสามารถปรึกษาเราได้แม้ในขั้นที่ยังไม่ได้กำหนดโมเดลหรือ GPU เช่น ขั้นคัดเลือกงานเป้าหมายหรือขั้นจัดชั้นข้อมูล ติดต่อเราได้ที่ แบบฟอร์มนี้
ข้อมูลอ้างอิง
- Hugging Face: openai/gpt-oss-120b model card
- Ollama Library: gpt-oss
- Hugging Face: Qwen/Qwen3-30B-A3B-Instruct-2507 model card
- Hugging Face: meta-llama/Llama-4-Scout-17B-16E-Instruct model card
- Google AI for Developers: Gemma models overview
- Hugging Face: deepseek-ai/DeepSeek-V3.2 model card
- Hugging Face: mistralai/Mistral-Small-3.2-24B-Instruct-2506 model card
- Swallow LLM project: GPT-OSS Swallow
- Hugging Face: scb10x/typhoon2.1-gemma3-12b model card
- vLLM documentation
- vLLM documentation: Quantization
- GitHub: ggml-org/llama.cpp
- Ollama Docs: FAQ
- SGLang Documentation
- NVIDIA: L4 Tensor Core GPU
- NVIDIA: L40S GPU
- NVIDIA: H200 Tensor Core GPU
- NVIDIA: RTX PRO 6000 Blackwell Server Edition
- NVIDIA: DGX Spark
- NVIDIA Technical Blog: Mastering LLM Techniques – Inference Optimization (17 พฤศจิกายน 2023)
- OWASP GenAI Security Project: OWASP Top 10 for LLM Applications 2025
- NIST: AI 600-1 Artificial Intelligence Risk Management Framework – Generative Artificial Intelligence Profile
- Hugging Face Hub docs: Pickle Scanning
- Hugging Face docs: Safetensors
- กระทรวงกิจการภายในและการสื่อสารของญี่ปุ่น: สมุดปกขาวด้านสารสนเทศและการสื่อสาร ฉบับ Reiwa 8 แผนภาพ I-2-1-8 (CSV) (ภาษาญี่ปุ่น)
- กระทรวงกิจการภายในและการสื่อสารของญี่ปุ่น: สมุดปกขาวด้านสารสนเทศและการสื่อสาร ฉบับ Reiwa 8 ภาค I บทที่ 2 (ภาษาญี่ปุ่น)
- Techstrong.ai: Open-Weight AI Models Expected to Capture 41% of Enterprise Token Usage (22 กันยายน 2026)
- Constellation Research: Evidence Shows Enterprises Use of Open Weight Models is Mainstream (26 กันยายน 2026)
- Tilleke & Gibbins: Thailand Unveils Regulations for Cross-Border Personal Data Transfer (4 มกราคม 2024)
- Rajah & Tann Asia: Thailand’s Proposed AI Law – Moving Towards a Risk-Based Regulatory Framework (28 กรกฎาคม 2026)
- Baker McKenzie: Vietnam – Artificial Intelligence Law, Foundation and Outlook (24 กุมภาพันธ์ 2026)
- Vietnam Government News: First-ever law on artificial intelligence approved
- NSTDA: ThaiLLM (1 เมษายน 2026)
- BOI: Thailand Approves $1.99 Billion in New Investment, Led by AI and Advanced Electronics (8 กรกฎาคม 2026)
- Kaohoon International: SIAM.AI CLOUD Launches Thailand’s AI Infrastructure (4 ธันวาคม 2024)
- SCB 10X: OpenTyphoon
- กระทรวงกิจการภายในและการสื่อสารของญี่ปุ่น: แนวปฏิบัติสำหรับผู้ประกอบการ AI (ภาษาญี่ปุ่น)


