


ระบบแปลภาษาอัตโนมัติสำหรับองค์กรสำเร็จด้วยการออกแบบงาน ไม่ใช่คะแนนโมเดล บทความนี้แนะนำผู้ผลิตญี่ปุ่นในไทยและอาเซียนให้ควบคุมต้นฉบับ คำศัพท์ ข้อมูลลับ ผู้ตรวจ หลักฐาน RFP และ PoC ตัวอย่างประมาณ 30 วัน
ห้าแกนออกแบบระบบแปลภาษาอัตโนมัติสำหรับองค์กร
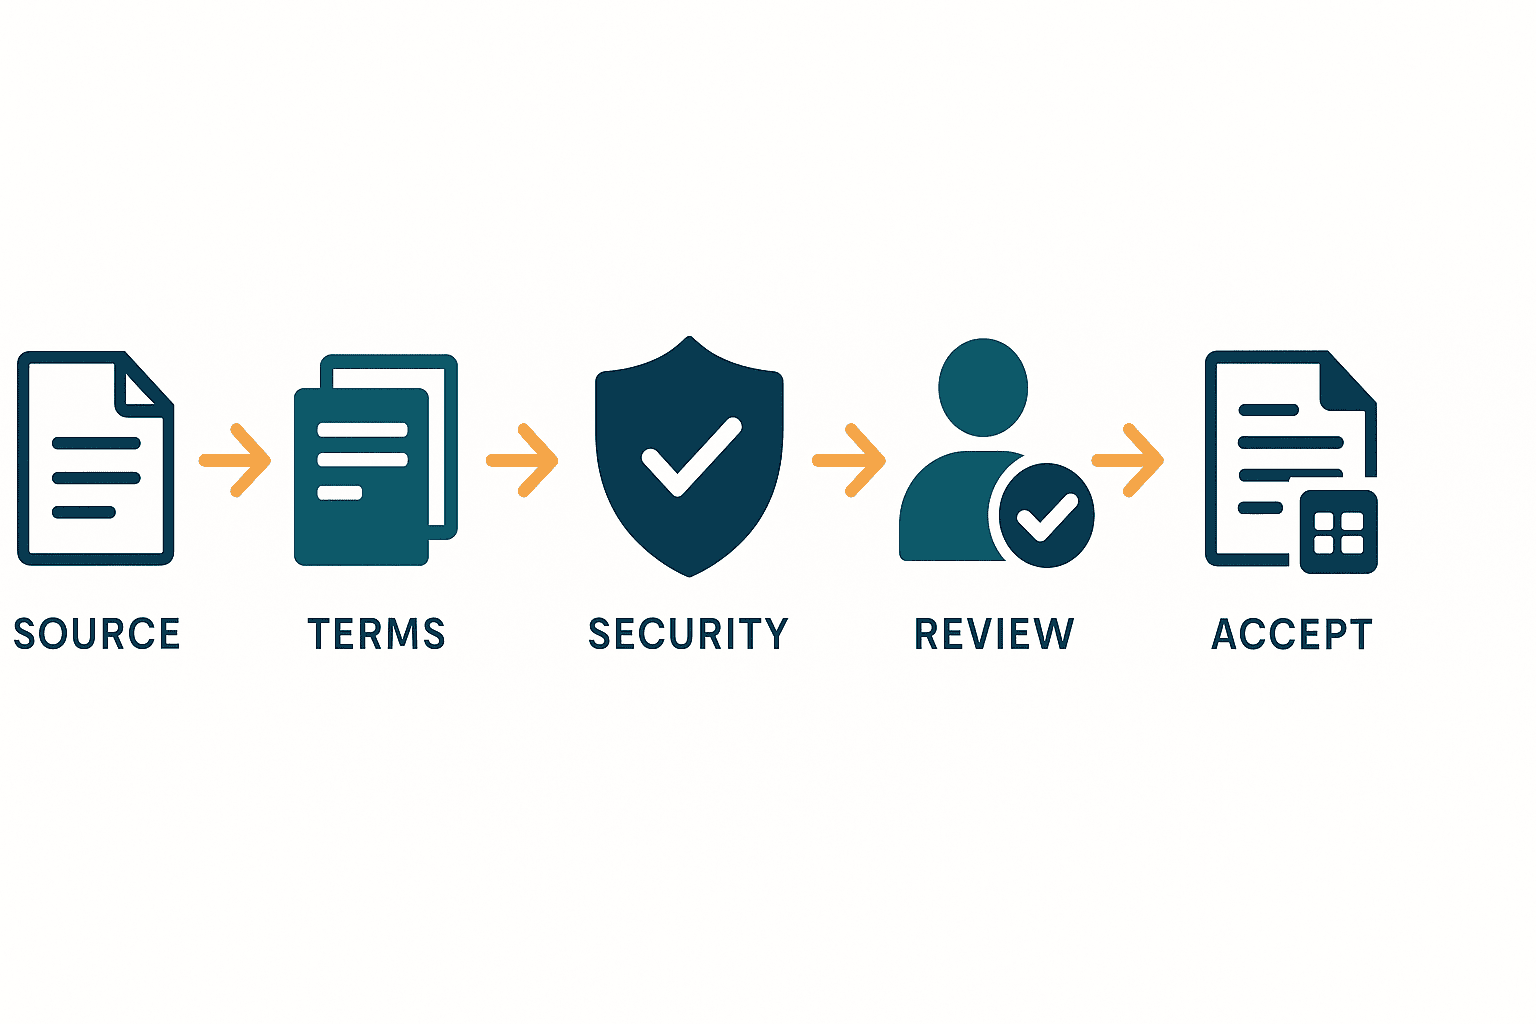
ต้องออกแบบห้าเรื่องต่อไปนี้ร่วมกัน
- การเตรียมต้นฉบับ: เขียนประโยคสั้น ลดความกำกวม ระบุเวอร์ชัน และใช้โครงสร้างเอกสารที่นำกลับมาใช้ได้
- อภิธานศัพท์และหน่วยความจำการแปล: บริหารชื่อผลิตภัณฑ์ ชื่อกระบวนการ คำด้านความปลอดภัย และคู่คำที่อนุมัติแล้วเป็นทรัพย์สินขององค์กร
- ชั้นความลับและเส้นทางส่งข้อมูล: กำหนดว่าเอกสารใดส่งไปบริการ endpoint ภูมิภาค และสัญญาใดได้ ภายใต้เงื่อนไขการเก็บข้อมูลแบบใด
- การตรวจโดยมนุษย์ตามความเสี่ยง: กำหนดผู้ตรวจและผู้อนุมัติตามผลกระทบของคำแปลผิดในงานความปลอดภัย คุณภาพ สัญญา หรือเอกสารลูกค้า
- การรับมอบและประเมินต่อเนื่อง: ตรวจคำบังคับ ตัวเลข คำปฏิเสธ หน่วย เวอร์ชัน และรูปแบบด้วยทั้งระบบและคน
หากเปรียบเทียบเพียงว่า AI ตัวใดเขียนได้เป็นธรรมชาติที่สุด การสาธิตอาจดูดีแต่พังเมื่อใช้งานจริง งานแปลขององค์กรต้องรองรับการแก้ไข เปรียบเทียบ อนุมัติ ตรวจสอบย้อนหลัง ใช้ซ้ำ และเพิกถอนอยู่เสมอ โมเดลเป็นเพียงส่วนหนึ่งของกระบวนการ ไม่ใช่ผู้รับผิดชอบกระบวนการทั้งหมด
เหตุใดการเปรียบเทียบความแม่นยำของโมเดลจึงไม่พอสำหรับการแปลเอกสารหลายภาษา
ภาษาของโรงงานพึ่งพาบริบทสูง คำว่า “line” อาจหมายถึงไลน์ผลิต ท่อ สายไฟ หรือกลุ่มผลิตภัณฑ์ คำญี่ปุ่นที่ใช้ในหน้างาน เช่น *nige*, *atari* หรือ *dandori* อาจมีความหมายเฉพาะโรงงาน ภาษาไทยสามารถละประธานได้อย่างเป็นธรรมชาติ แต่ในมาตรฐานการทำงานต้องรู้ว่าใครเป็นผู้ทำและใครเป็นผู้อนุมัติ ส่วนประโยคญี่ปุ่นที่มีส่วนขยายยาว เมื่อแปลเป็นไทย อังกฤษ หรือเวียดนามอาจทำให้ไม่ชัดว่าเงื่อนไขใดควบคุมการกระทำใด
ข้อกำหนดจำนวนมากไม่ใช่เรื่องความลื่นไหล หมายเลขชิ้นส่วนต้องไม่ถูกแปล หน่วยต้องไม่เปลี่ยน เลขรูปต้องตรงกัน ระดับคำเตือนต้องคงเดิม ประวัติการแก้ไขต้องตรวจสอบได้ และต้องไม่แจกจ่ายฉบับล้าสมัย ต่อให้ประโยคเป็นธรรมชาติมาก หากตัวเลขหนึ่งหลักหรือคำว่า “ห้าม” หายไป เอกสารก็ไม่ผ่าน
ดังนั้น PoC ต้องประเมินทั้งการดึงเนื้อหา การเตรียมต้นฉบับ การแปล การใช้คำศัพท์ การประมวลผลหลังแปล การตรวจ การอนุมัติ การส่งออก การแจกจ่าย และบันทึก ไม่ใช่ดูแต่ข้อความปลายทาง
เลือกวิธีจากความเสี่ยง ปริมาณ และความถี่การแก้ไข
ไม่จำเป็นต้องใช้บริการเดียวกับเอกสารทุกชนิด การแบ่งช่องทางตามวัตถุประสงค์เหมาะกับโรงงานมากกว่า
| ชั้นเอกสาร | ตัวอย่าง | แนวทางอัตโนมัติ | การตรวจโดยมนุษย์ |
|---|---|---|---|
| A: ความปลอดภัย กฎหมาย สัญญา | ขั้นตอนความปลอดภัย สารเคมี สัญญาลูกค้า เงื่อนไขรับประกัน | AI ใช้สำหรับร่างและตรวจคำศัพท์ | ต้องมี หน่วยงานเจ้าของความเสี่ยงอนุมัติสุดท้าย |
| B: คุณภาพและกระบวนการ | มาตรฐานตรวจสอบ การตอบสนองเมื่อผิดปกติ control plan เอกสาร FMEA | แปลด้วยอภิธานศัพท์และตรวจเฉพาะส่วนต่าง | โดยหลักต้องตรวจ เน้นส่วนที่แก้ไข |
| C: การปฏิบัติงานภายใน | รายงานประจำวัน สื่อฝึกอบรม ข้อเสนอไคเซ็น FAQ | ขยายอัตโนมัติในกรอบความเสี่ยงที่อนุมัติ | สุ่มตรวจหรือตรวจข้อยกเว้น |
| D: ค้นคว้าและอ้างอิง | การวิจัยเทคนิค การอ่านอีเมลต่างภาษา | เหมาะกับการแปลอัตโนมัติในวงกว้าง | ผู้ใช้ต้องเปิดต้นฉบับได้ |
ตารางนี้เป็นจุดเริ่มต้น ต้องเพิ่มข้อกำหนดลูกค้า ข้อมูลส่วนบุคคล การควบคุมการส่งออก ทรัพย์สินทางปัญญา แรงงาน และกฎเฉพาะอุตสาหกรรม เอกสารที่เรียกว่า “คู่มือ” เหมือนกันอาจมีความเสี่ยงต่างกันมากระหว่างเอกสารอบรมทั่วไปกับขั้นตอน lockout/tagout
ประกาศตั้งแต่ต้นว่าเอกสารใดห้ามไร้คนตรวจ
อย่าให้ AI เผยแพร่ขั้นตอนความปลอดภัย คำตัดสินคุณภาพ ภาระตามสัญญา หรือเอกสารยื่นลูกค้าและหน่วยงานโดยลำพัง การคงคนอนุมัติเป็นการควบคุมตามสัดส่วน ไม่ใช่ความล้มเหลวของระบบอัตโนมัติ สิ่งที่ควรทำอัตโนมัติคือการพิมพ์ซ้ำ ค้นคำแปลเดิม ตรวจคำศัพท์และตัวเลข ดึงส่วนเปลี่ยน ส่งงานให้ผู้ตรวจ และสร้างหลักฐาน ผู้เชี่ยวชาญจึงใช้เวลากับความหมายและความรับผิดชอบ
ต้นฉบับกำหนดเพดานคุณภาพของ AI แปลภาษาเพื่อธุรกิจ
ก่อนเรียก API ต้องทำให้ต้นฉบับเป็นข้อมูลที่แปลได้ หากต้นฉบับญี่ปุ่นกำกวม โมเดลเก่งเพียงใดก็เพียงย้ายความกำกวมนั้นไปอีกภาษา
หนึ่งประโยค หนึ่งการกระทำ และเงื่อนไขชัดเจน
ข้อความว่า “ตรวจว่าไม่มีความผิดปกติแล้วเริ่มเดินเครื่อง และถ้ามีปัญหาให้รายงานหัวหน้า” ยังไม่บอกว่าใครตรวจ ความผิดปกติคืออะไร และต้องหยุดก่อนรายงานหรือไม่ ควรแยกเป็น:
- Operator ตรวจว่าการ์ดปิดอยู่
- Operator ตรวจว่าปลด emergency stop แล้ว
- หากเงื่อนไขใดไม่ผ่าน ห้ามเริ่มเครื่อง
- Operator รายงานรหัส alarm ต่อ Shift Leader
รูปแบบนี้ทำให้ผู้กระทำ ลำดับ เงื่อนไข และคำปฏิเสธตรวจได้ทั้งด้วยระบบและคน
ระบุส่วนที่ห้ามแปล
แยกหมายเลขชิ้นส่วน ชื่อผลิตภัณฑ์ tag เครื่อง ปุ่มบนจอ ที่อยู่ PLC หมายเลขมาตรฐาน ตัวแปร code และ URL ใช้สถานะเช่น KEEP, LOCKED TERM และ TRANSLATE เพื่อจับการเปลี่ยนโดยไม่ตั้งใจ และกำหนดกฎการดึงข้อมูลแยกตาม Word, Excel, HTML, XML, PDF หรือข้อมูลจาก CAD
ผูกทุกงานกับรหัสเอกสารและ revision
อย่างน้อยต้องมี document ID, revision, ภาษาต้นทาง, ภาษาเป้าหมาย, หน่วยงานเจ้าของ, ผู้อนุมัติ, ชั้นความลับ และวันที่มีผล ชื่อไฟล์อย่างเดียวทำให้ฉบับใหม่ปนกับฉบับเก่า ผลลัพธ์ทุกฉบับต้องย้อนกลับไปยังต้นฉบับเวอร์ชันที่แน่นอนได้
อย่าสับสนอภิธานศัพท์กับหน่วยความจำการแปล
อภิธานศัพท์ควบคุมคำและวลีสั้น ส่วน translation memory เก็บคู่ประโยคหรือ segment ที่อนุมัติแล้ว หน้าที่ต่างกัน จึงควรมีทั้งสองอย่าง
ช่องข้อมูลขั้นต่ำของอภิธานศัพท์องค์กร
| ช่อง | เนื้อหา |
|---|---|
| term_id | รหัสถาวร |
| source_term | คำต้นทาง รวมรูปสะกดและตัวพิมพ์ |
| target_term | คำแปลที่อนุมัติในแต่ละภาษา |
| definition | ความหมายในผลิตภัณฑ์หรือกระบวนการ |
| do_not_use | คำห้ามใช้ ชื่อเก่า หรือคำที่สับสน |
| example | ตัวอย่างที่อนุมัติ |
| scope | ทั้งบริษัท ธุรกิจ โรงงาน ลูกค้า หรือผลิตภัณฑ์ |
| owner | ผู้รับผิดชอบเนื้อหา |
| status | draft, approved, deprecated |
| effective_from | วันเริ่มใช้ |
เอกสาร Azure Translator Document Translation ของ Microsoft ระบุว่าอภิธานศัพท์ในปัจจุบันรองรับทิศทางภาษาต้นทางไปภาษาเป้าหมายแบบหนึ่งต่อหนึ่ง ใช้กำหนดคำตามบริบท ชื่อที่ห้ามแปล และคำกำกวมได้ แนะนำรูปแบบ TSV และโดยค่าเริ่มต้นตัวพิมพ์ใหญ่เล็กมีผลต่อการจับคู่ Google Cloud Translation รองรับทั้งอภิธานศัพท์ทางเดียวและ equivalent term sets หลายภาษา แต่ resource ของอภิธานศัพท์ไม่มี version control เอกสารจึงแนะนำให้เก็บไฟล์ต้นทางไว้เพื่อ rollback ส่วน AWS custom terminology ช่วยเลือกคำแปลได้ แต่ระบุชัดว่าไม่รับประกันการใช้คำเป้าหมายทุกครั้ง เพราะระบบพิจารณาบริบทด้วย
คำว่า “รองรับ glossary” จึงไม่ได้หมายถึงความสามารถเดียวกัน ต้องทดสอบรูปแบบไฟล์ ทิศทาง ตัวพิมพ์ การผันคำ คำประสม การบังคับใช้ เวอร์ชัน region และสิทธิ์ของแต่ละบริการ
เลื่อนเข้า translation memory เฉพาะข้อความที่อนุมัติแล้ว
ถ้านำผลลัพธ์ AI ทุกชิ้นเข้า memory อัตโนมัติ ความผิดก็ถูกนำกลับมาใช้ซ้ำ กำหนดให้ต้องผ่านผู้ตรวจ ผูกกับ revision ที่แน่นอน มีขอบเขตภาษาและโรงงาน และเพิกถอนได้ แยก exact match กับ fuzzy match และเน้นส่วนต่างของ fuzzy match ชื่อเครื่องเก่าหรือขั้นตอนที่เลิกใช้ต้องเป็น deprecated และเตือนเมื่อถูกเรียกใช้
ทดสอบรูปคำญี่ปุ่น ไทย และเวียดนามในประโยคจริง
ภาษาญี่ปุ่นและไทยปกติไม่เว้นช่องว่างระหว่างทุกคำ ระบบที่จับข้อความตรงตัวอาจพลาดเมื่อมีคำช่วย คำนำหน้า คำประสม หรือการขึ้นบรรทัดใหม่ ภาษาเวียดนามมีคำที่ประกอบด้วยหลายพยางค์คั่นด้วยช่องว่าง การตัด token แบบง่ายอาจจับบางส่วนผิด ต้องวัดทั้งอัตราใช้คำถูกและการใช้ผิดในเอกสารจริง ไม่ใช่ทดสอบแต่รายการคำโดดๆ
กฎภาษาสำหรับ AI แปลภาษาไทย–ญี่ปุ่น
โรงงานไทยต้องใช้ทั้งคำสั่งญี่ปุ่นไปไทยและรายงานหน้างานไทยกลับญี่ปุ่น ไม่ควรใช้การตั้งค่าทิศทางเดียวกันโดยไม่ทดสอบอีกทิศทาง
รักษาประธานและผู้รับผิดชอบ
ภาษาไทยละประธานได้ แต่เอกสารควบคุมควรระบุ Operator, Line Leader หรือ QA แทนคำว่า “ตรวจแล้ว” แบบไม่มีผู้ทำ ฝั่งต้นฉบับญี่ปุ่นก็ควรเปลี่ยนคำว่า “ตรวจสอบ” ที่ไม่ระบุผู้รับผิดชอบให้ชัดเจน
ให้ความชัดเจนของงานมาก่อนความสุภาพ
ความเป็นธรรมชาติของการสื่อสารภายในกับความแม่นยำของคำสั่งความปลอดภัยเป็นคนละแกน style guide ต้องแยกคำสั่ง ข้อห้าม การอนุญาต และคำแนะนำ ล็อกคำเตือนที่อนุมัติแล้ว และอย่าให้สีหรือ icon เป็นตัวแบกความหมายเพียงอย่างเดียว
ระบุภาษาต้นทางสำหรับข้อความสั้น
เอกสาร DeepL แนะนำให้ระบุภาษาต้นทางเมื่อทำได้ และอธิบายว่าการตรวจอัตโนมัติไม่น่าเชื่อถือเท่ากันสำหรับคำเดียวหรือประโยคสั้น จึงควรบังคับภาษาต้นทางกับ alarm ปุ่ม ตัวย่อ และชื่อสินค้า ส่วนเอกสารยาวให้ตรวจไฟล์ปน แต่หากทราบภาษาก็ควรระบุโดยตรง
ออกแบบความปลอดภัยจากเส้นทางส่งข้อมูล ไม่ใช่เพียงคำว่า AI
อย่าตัดสินความปลอดภัยจากชื่อผลิตภัณฑ์ ให้วาดเส้นทางตั้งแต่รับข้อมูลจนลบ:
- รับงานจากอุปกรณ์หรือ repository ที่อนุมัติ
- จัดชั้นด้วย DLP หรือกฎที่บันทึกไว้
- mask ชื่อบุคคล ลูกค้า หรือเลข drawing เมื่อจำเป็น
- ส่งผ่าน API, region, network และสัญญาที่อนุมัติเท่านั้น
- เก็บผลลัพธ์ในที่เข้ารหัสและจำกัดสิทธิ์
- บันทึกการตรวจและอนุมัติของคน
- ลบต้นฉบับ คำแปล log และ cache ตามกำหนด
อย่าถือว่า API กับหน้าจอผู้บริโภคเป็นบริการเดียวกัน
สัญญา การใช้ข้อมูล การเก็บ และการควบคุมแตกต่างตามรูปแบบบริการ เอกสารการควบคุมข้อมูล API ของ OpenAI ระบุว่า ข้อมูลที่ส่งผ่าน API จะไม่ใช้ฝึกหรือปรับปรุงโมเดล เว้นแต่ลูกค้าเลือก opt in อย่างชัดแจ้ง เอกสารเดียวกันระบุแยกว่าบันทึก abuse monitoring โดยค่าเริ่มต้นอาจเก็บได้นานสูงสุด 30 วัน เว้นแต่กฎหมายหรือการปกป้องบริการต้องเก็บนานกว่า และ application state กับสิทธิ์ Zero Data Retention แตกต่างตาม endpoint ดังนั้น “ไม่ใช้ฝึก” ไม่เท่ากับ “ไม่เก็บเลย” ต้องตรวจ endpoint, ค่า store, file, cache และบริการภายนอกจริงในสถาปัตยกรรม
ตัวเลข 30 วันไม่ใช่กฎของบริการแปล AI ทุกแห่ง แต่เป็นเงื่อนไขเริ่มต้นของ OpenAI API ตามเอกสาร ณ เวลาตรวจสอบ ซึ่งเปลี่ยนได้ตาม endpoint การตั้งค่า สัญญา และข้อกฎหมาย ต้องยืนยันอีกครั้งใน RFP และสัญญา
ดูรายละเอียดเพิ่มได้จากบทความ การป้องกันข้อมูลรั่วจาก Generative AI ในโรงงานไทย
จับคู่ชั้นความลับกับช่องทางที่อนุญาต
| ชั้น | ตัวอย่าง | ช่องทางตัวอย่าง |
|---|---|---|
| Public | catalog หรือเว็บที่เผยแพร่แล้ว | cloud translation ที่อนุมัติ |
| Internal | ขั้นตอนทั่วไปและสื่ออบรม | enterprise API พร้อม access control และ log |
| Confidential | drawing ลูกค้า ต้นทุน ผลิตภัณฑ์ยังไม่เปิดตัว | mask, environment จำกัด, อนุมัติเฉพาะ |
| Restricted | ข้อมูลควบคุมส่งออก ข้อมูลบุคคลอ่อนไหว NDA เข้ม | ห้ามส่งโดยหลัก หรือ environment เฉพาะพร้อมกฎหมายอนุมัติ |
ใช้ชื่อชั้นตามระเบียบบริษัท สิ่งสำคัญคือระบบต้องหยุดช่องทางต้องห้าม ไม่ใช่เพียงให้ผู้ใช้ติ๊กว่าอ่านนโยบายแล้ว ข้อยกเว้นต้องมีผู้ขอ เหตุผล วันหมดอายุ และผู้อนุมัติ
ออกแบบการตรวจโดยมนุษย์ตามความเสี่ยงและชนิดความผิด
ถ้าตรวจทุกคำสองรอบ ประโยชน์ด้านเวลาก็หายไป แต่ถ้าไม่ตรวจเลย ความเสี่ยงจะไม่ถูกควบคุม จึงควรแบ่งระดับ
ระดับ 1: ตรวจด้วยระบบ
ตรวจคำบังคับ คำห้าม ตัวเลข หน่วย วันที่ part number tag URL คำปฏิเสธ คำเตือน ข้อความไม่แปล สิ่งที่เพิ่มเกิน ตาราง เลขรูป และ link รวมถึงทำ normalization ตัวเต็ม/ครึ่ง ความต่างจุดทศนิยม และเลขไทยก่อนเปรียบเทียบ
ระดับ 2: ตรวจภาษา
ตรวจความหมาย ไวยากรณ์ ความอ่านง่าย และคำที่ใช้จริงในพื้นที่ ไม่ใช่ดูแต่ความเป็นธรรมชาติ แต่ต้องรักษาหน้าที่ เงื่อนไข ข้อห้าม และความไม่แน่นอน ผู้ตรวจเจ้าของภาษาไทยหรือเวียดนามต้องยืนยันว่าคนหน้างานปฏิบัติได้โดยไม่ตีความหลายแบบ
ระดับ 3: ผู้เชี่ยวชาญและหน่วยงานรับผิดชอบอนุมัติ
Safety, QA, Legal, Engineering หรือเจ้าของลูกค้าอนุมัติความถูกต้องทางธุรกิจและการเผยแพร่ อย่าให้ผู้เชี่ยวชาญภาษาแบกรับความถูกต้องวิศวกรรมเพียงคนเดียว หรือให้วิศวกรแบกรับคุณภาพภาษาคนเดียว แยกการตัดสินและหลักฐานตามบทบาท
สร้างคิวข้อยกเว้นก่อนขยายอัตโนมัติ
ส่ง confidence ต่ำ คำศัพท์ชนกัน OCR ไม่ดี ไม่ทราบ revision ตารางเสีย ลายมือ ภาษาปน และชั้นความลับไม่ชัดไปคิวข้อยกเว้น การที่ API ตอบ HTTP 200 ไม่ได้แปลว่างานแปลสำเร็จ
การรับมอบต้องให้ความสำคัญกับความผิดร้ายแรงก่อนความลื่นไหล
สร้าง gold dataset จากเอกสารจริงที่เป็นตัวแทน PoC ที่มีแต่ตัวอย่างง่ายและเปิดเผยจะซ่อน failure mode สำคัญ
ล็อกชุดทดสอบ
- รูปแบบ: Word, Excel, PDF, HTML, email และ OCR
- ทิศทาง: JA→TH, TH→JA, JA→EN และ JA→VI
- ความยาก: ข้อความสั้น/ยาว ตาราง รายการ ภาษาปน ตัวย่อ และต้นฉบับมีข้อผิด
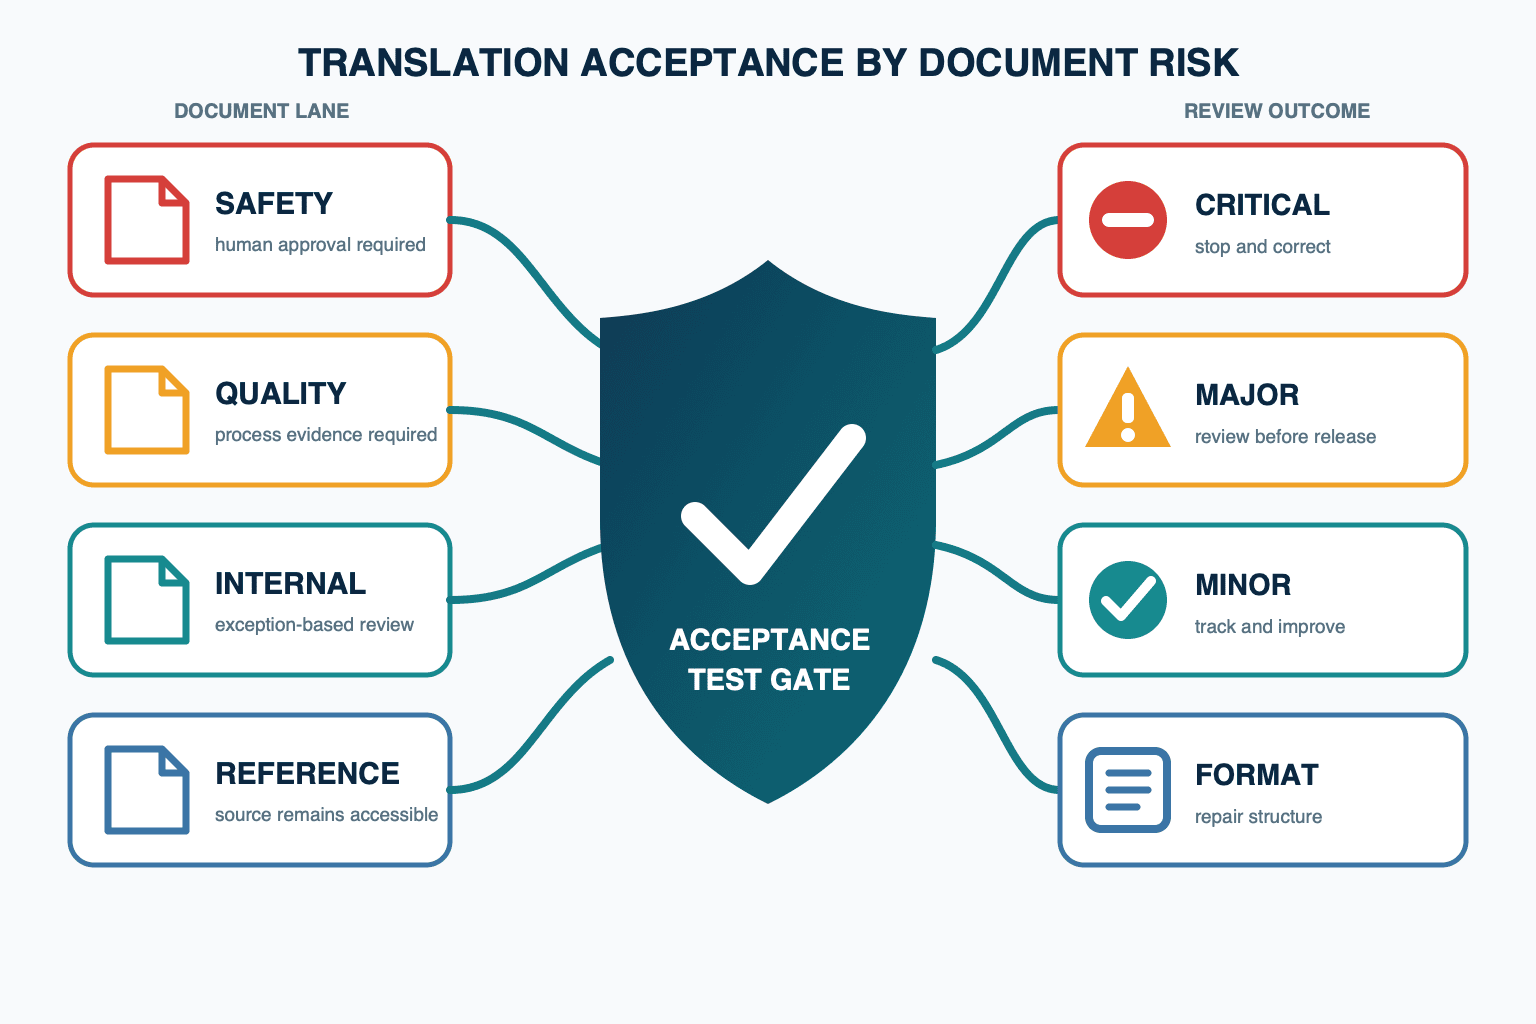
- ความเสี่ยง: ความปลอดภัย คุณภาพ สัญญา ภายใน และอ้างอิง
- วงจร: ใหม่ แก้เล็ก แก้ใหญ่ และถอนฉบับเก่า
กำหนด document ID และ version แยก development set ที่ใช้ปรับระบบออกจาก holdout set ที่ใช้ตัดสินสุดท้ายเท่านั้น
กำหนดผ่าน/ไม่ผ่านตามน้ำหนักความผิด
คะแนนเฉลี่ยซ่อนคำว่า “ห้าม” ที่หายไปได้ อย่างน้อยให้แยก:
- Critical: กลับข้อห้ามเป็นอนุญาต ตัวเลขหรือหน่วยอันตราย หน้าที่กฎหมายผิด สั่งชิ้นส่วนผิด
- Major: คำที่เปลี่ยนกระบวนการ ขาดผู้ทำ เงื่อนไข หรือลำดับ กระทบคำตัดสินคุณภาพ
- Minor: style หรือเครื่องหมายที่ไม่เปลี่ยนความหมาย
- Format: ตาราง เลขรูป link หรือ layout เสีย
เอกสารความปลอดภัย คุณภาพ และสัญญาอาจไม่ผ่านทันทีเมื่อมี Critical เพียงหนึ่งรายการ ให้บริษัทตั้ง gate จาก risk assessment ไม่ใช่คัดลอกค่าเฉลี่ยของ vendor
ทดสอบความทำซ้ำ การอัปเดต และส่วนต่าง
บันทึกความต่างเมื่อใช้อินพุต โมเดล การตั้งค่า และอภิธานศัพท์เดียวกัน ทำ regression test เมื่อโมเดลหรือ API เปลี่ยน และผูกส่วนต่างของต้นฉบับ คำแปล อภิธานศัพท์ และ configuration เพื่อให้ผู้ตรวจมองเฉพาะสิ่งที่เปลี่ยนจริง
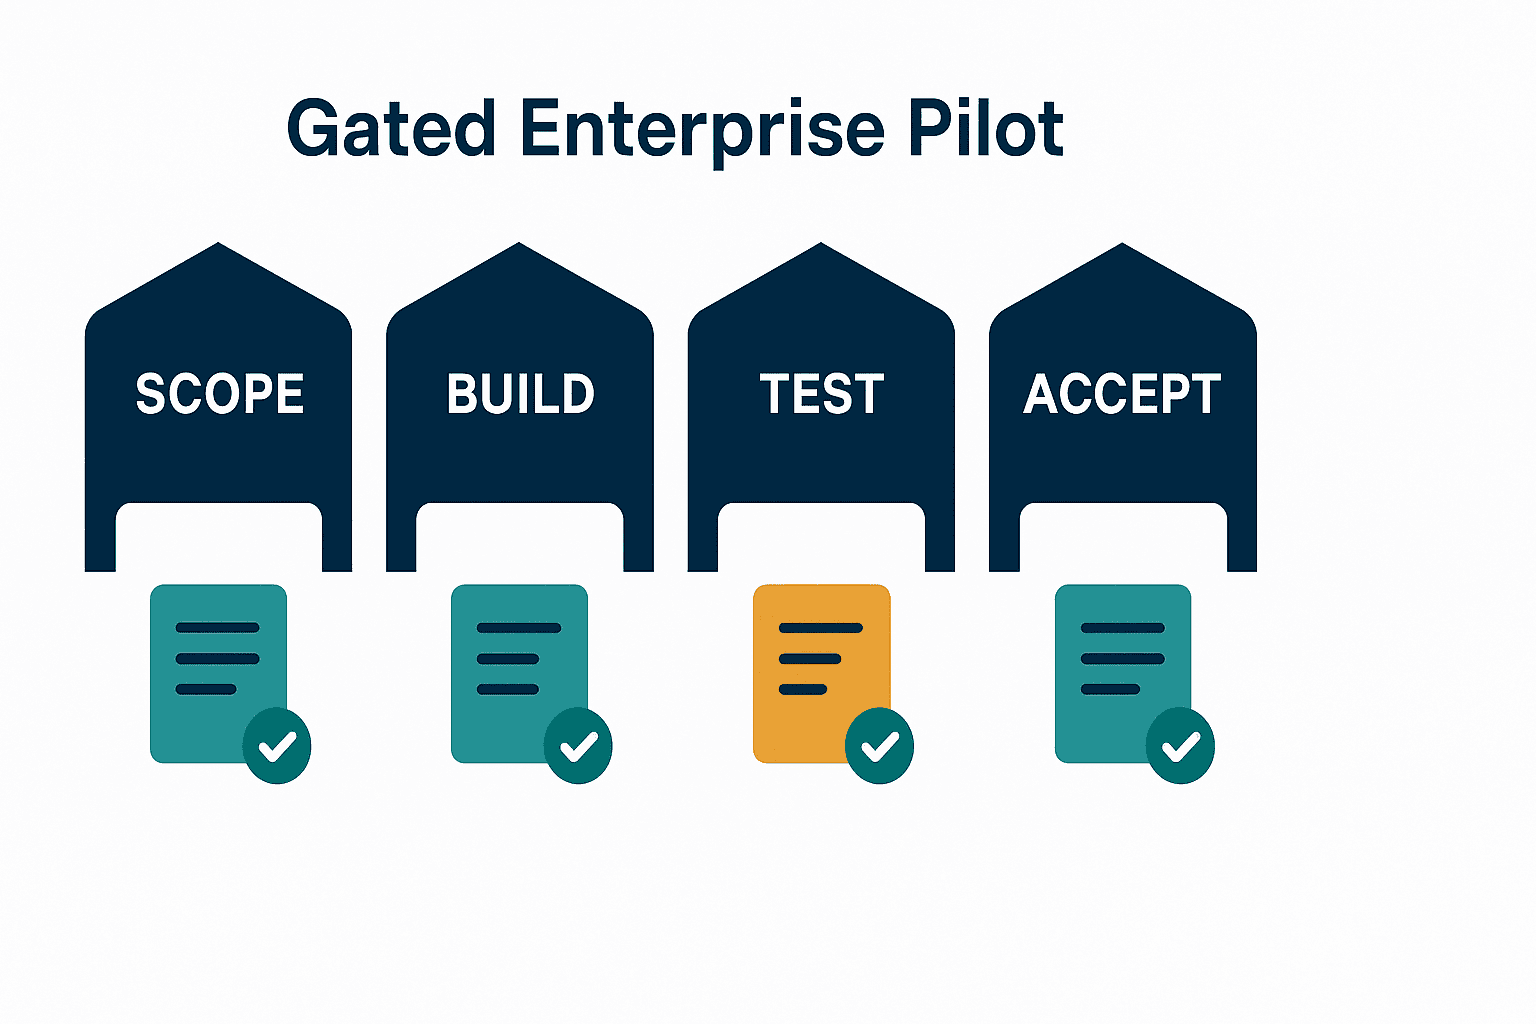
ตัวอย่าง PoC ประมาณ 30 วัน
30 วันเป็นแบบออกแบบ ไม่ใช่สถิติทางการหรือคำรับประกัน ปรับตามปริมาณเอกสาร การตรวจสิทธิ์ และกฎหมาย
สัปดาห์ 1: ขอบเขต ความเสี่ยง และ gold data
- ตกลงงานที่รวมและไม่รวม
- สำรวจชั้นเอกสาร ความลับ ทิศทางภาษา และรูปแบบ
- รวบรวมอภิธานศัพท์ translation memory และ style guide เดิม
- อนุมัติชุดทดสอบและเกณฑ์ผ่าน
- ตั้งเจ้าของด้าน security, legal, IT/OT, quality และ operation
สัปดาห์ 2: pipeline ขั้นต่ำและการควบคุมคำศัพท์
- รับงานพร้อม document ID, revision, ภาษา และชั้น
- ตรวจส่วนห้ามแปล ข้อมูลลูกค้า และข้อมูลบุคคล
- ใช้อภิธานศัพท์กับบริการผู้สมัคร
- บันทึกผล configuration, model, glossary version, เวลา และ error
- เชื่อมคิวข้อยกเว้นกับหน้าตรวจ
สัปดาห์ 3: เอกสารตัวแทนและการจำลองข้อผิดพลาด
- รันเอกสารยากในสัดส่วนเดียวกับเอกสารทั่วไป
- ฉีด glossary miss, language misdetection, OCR หาย, API fail และ timeout
- บันทึกเวลาตรวจและหมวดการแก้
- สืบความผิดร้ายแรงกลับไปที่ต้นฉบับ คำศัพท์ setting model หรือ post-processing
production checklist ของ DeepL แนะนำ exponential backoff สำหรับ error 429 และ 500 ไม่ส่ง authentication key ผ่าน query parameter ให้บริบทกว้างขึ้น และ cache ผลลัพธ์เพื่อลดการประมวลซ้ำ คำแนะนำนี้เฉพาะบริการ แต่ชี้ว่าการ retry การเก็บ secret บริบท และ idempotency ควรอยู่ในแผนทดสอบองค์กร
สัปดาห์ 4: รับมอบด้วย holdout และตัดสินการใช้งาน
- รัน holdout ที่ยังไม่เคยใช้
- อนุมัติผลและ residual risk ตามชั้นเอกสาร
- แยกช่องทาง production, ต้องแก้เพิ่ม และห้ามใช้
- ส่งมอบ operation, monitoring, incident, rollback และ training
- ตั้งวันและเจ้าของ regression test ครั้งถัดไป
คำถามและหลักฐานใน RFP
| ด้าน | คำถาม | หลักฐานที่ต้องการ |
|---|---|---|
| ภาษา/รูปแบบ | รองรับ JA/TH/EN/VI ภาษาปน Word Excel PDF OCR อย่างไร | ผลจากไฟล์จริง |
| คำศัพท์ | ทิศทาง รูปแบบ ตัวพิมพ์ การผัน version และการบังคับใช้เป็นอย่างไร | ทดสอบใช้ถูกและใช้ผิดในบริบท |
| memory | ใช้ซ้ำ ทำ fuzzy diff จำกัด scope ถอน และ rollback ได้หรือไม่ | ประวัติและสาธิต rollback |
| ข้อมูล | การใช้ฝึก log state retention deletion subprocessor เป็นอย่างไร | สัญญา setting และ data flow |
| สิทธิ์ | SSO, MFA, RBAC, service account และ secret จัดการอย่างไร | access matrix, audit log, key rotation |
| ความทนทาน | 429/5xx, timeout, ส่งซ้ำ และผลกลับผิดลำดับทำอย่างไร | fault injection และ recovery log |
| คุณภาพ | วัดความผิดร้ายแรง ตัวเลข คำปฏิเสธ คำศัพท์ และข้อความหายอย่างไร | ผลบน fixed set ที่ตกลง |
| การเปลี่ยน | แจ้งและทดสอบ model, API, glossary update อย่างไร | change notice และ regression procedure |
| การตรวจ | assignment, diff, comment, approve, reject เป็นอย่างไร | สาธิต end-to-end |
| การออก | export ย้าย vendor และลบข้อมูลเมื่อจบสัญญาได้หรือไม่ | export มาตรฐานและหลักฐานลบ |
ใช้ชุดข้อมูลบริษัทเดียวกันกับผู้สมัครทุกเจ้า เปรียบเทียบงานรวมทั้งเตรียมต้นฉบับ แปลซ้ำ ตรวจ ข้อยกเว้น audit และดูแลคำศัพท์ ไม่ใช่เพียงราคาต่อตัวอักษร บทความนี้ไม่สร้างราคาตลาดหรือเปอร์เซ็นต์ประหยัดที่ไม่มีหลักฐาน ให้เก็บ baseline ปัจจุบันแล้วเปรียบเทียบกระบวนการเดียวกันหลัง PoC
สถาปัตยกรรมจริงต้องเปิดทางให้เปลี่ยนผู้ให้บริการ
แยก intake, terminology, translation, check, review, approval และ distribution ออกจากกัน แปลง response ของแต่ละ vendor เป็น job record กลางก่อนลง business database
metadata ที่แนะนำสำหรับ job
- job_id, document_id, source_version
- source_language, target_language, locale
- document_class, confidentiality
- glossary_version, translation_memory_version, style_version
- provider, model, endpoint, request_setting
- source_hash, output_hash
- reviewer, approver, decision, timestamp
- error_code, retry_count, fallback_reason
ข้อมูลนี้รักษา lineage เมื่อเปลี่ยนบริการ ห้ามฝัง API key ในเครื่องผู้ใช้หรือ Excel macro ให้เรียกจาก secret management ฝั่ง server แยก operational metadata ออกจาก log ที่มีข้อความ และอย่าเก็บเนื้อหาเมื่อ monitoring ไม่ต้องใช้
cache ต้องมีเวอร์ชันและขอบเขตความลับ
การใช้ซ้ำลดเวลา แต่ต้องไม่ส่งคำแปลลูกค้าหนึ่งไปอีกลูกค้าหรือเรียกคำเก่ากลับมา cache key ควรรวมภาษา glossary version, style version, model setting และ scope นอกเหนือจาก source hash และ invalidate เมื่อถอนคำหรือ revision
KPI ต้องวัดคุณภาพ เวลา ข้อยกเว้น และการใช้ซ้ำ
ถ้าวัดแต่จำนวน ผู้ใช้อาจหลบเอกสารยากหรือปล่อยความผิด ควรรวม:
- จำนวน Critical/Major/Minor ตามชั้นเอกสาร
- อัตราใช้คำบังคับถูกและใช้ผิด
- ความตรงของตัวเลข หน่วย และ part number
- lead time จากรับงานถึงอนุมัติ
- นาทีตรวจและหมวดการแก้
- สัดส่วนอนุมัติแบบไม่แก้ แก้เล็ก และเขียนใหม่
- การใช้ translation memory และ cache ซ้ำ
- อัตราข้อยกเว้น retry และสาเหตุ failure
- การแจกฉบับเก่า ส่งผิด และขาดอนุมัติ
ตั้ง baseline จากกระบวนการจริง และเปรียบเทียบผู้ให้บริการหรือรุ่นใหม่ด้วย holdout เดิม บทความ การประเมิน Generative AI ภาษาไทย ช่วยออกแบบข้อมูลและผู้ตรวจ หากพิจารณาจ้างภายนอก ดู แนวทางจ้างพัฒนา AI ในประเทศไทย เพิ่มเติม
แปลงทิศทาง AI Governance ของไทยเป็นการควบคุมจริง
ETDA ระบุทิศทางปี 2026 ภายใต้แนวคิด “Driving Trust AI Governance” ซึ่งรวม guideline และ toolkit การใช้งานจริง ความร่วมมือในและต่างประเทศ และการพัฒนาความสามารถ ประกาศนี้ไม่ได้รับรองระบบของบริษัทใดโดยอัตโนมัติ แต่สอดคล้องกับการมองความน่าเชื่อถือของงานแปลว่าเป็นเรื่อง governance, implementation และ training ไม่ใช่เลือกโมเดลอย่างเดียว
ควรเก็บ AI use register, ชั้นเอกสาร, data flow, risk assessment, ผู้อนุมัติ, ผลทดสอบ, incident และ change history ส่วน PDPA ไทย กฎหมายแรงงาน สัญญาลูกค้า และกฎอุตสาหกรรมของกรณีจริงต้องตรวจร่วมกับฝ่ายกฎหมายและผู้เชี่ยวชาญ
คำถามที่พบบ่อย
องค์กรควรเริ่มแปลภาษาอัตโนมัติจากเอกสารใด?
เริ่มจากเอกสารปริมาณมาก ซ้ำ เจ้าของต้นฉบับและผู้อนุมัติชัด และจำกัดผลกระทบคำแปลผิดได้ เช่น FAQ ภายในหรือรายงานมีโครงสร้าง แต่ควรใส่ตัวอย่างคุณภาพและความปลอดภัยใน PoC เพื่อรู้ขีดจำกัด โดยยังห้ามเผยแพร่อัตโนมัติ
มีอภิธานศัพท์แล้ว คุณภาพ AI แปลภาษาเพื่อธุรกิจจะคงที่หรือไม่?
ยังไม่พอ ความกำกวม revision, translation memory, style, setting, post-processing และ review มีผล และแต่ละบริการใช้ glossary ต่างกัน ต้องทดสอบทั้งการจับถูกและจับผิดในประโยคจริง
ควรใช้ translation memory ร่วมกับ Generative AI อย่างไร?
ให้ approved exact match มาก่อน แสดงส่วนต่างของ fuzzy match และให้ AI ร่างเฉพาะส่วนไม่มีคู่เดิม นำผล AI เข้า memory หลังอนุมัติ พร้อม scope, version, owner และสถานะถอน
AI แปลไทย–ญี่ปุ่นตรวจภาษาต้นทางอัตโนมัติได้หรือไม่?
หลายบริการทำได้ แต่ alarm ชื่อสินค้า ตัวย่อ และข้อความปนเป็นกรณียาก หากทราบภาษาควรระบุ และส่งผลตรวจที่ไม่แน่ใจไปคิวข้อยกเว้น
ส่งเอกสารลับไป cloud AI ได้หรือไม่?
ตอบแบบเดียวไม่ได้ ต้องตรวจชั้น สัญญา การใช้ฝึก retention, region, subprocessor, encryption, access, กฎหมาย และข้อตกลงลูกค้า แล้วเลือก mask, dedicated environment หรือห้ามส่ง
ลดการตรวจโดยมนุษย์เมื่อใด?
เมื่อหลักฐานแบบ production แสดงว่าความผิดร้ายแรงถูกควบคุม ระบบตรวจและ exception ทำงาน regression และ rollback ผ่าน และหน่วยงานรับผิดชอบยอมรับ residual risk เอกสาร safety, quality และ contract ยังต้องมีคนอนุมัติ
หลักฐานสำคัญที่สุดใน RFP การแปลเอกสารหลายภาษาคืออะไร?
ผลจาก fixed dataset ของผู้ซื้อที่ใช้ glossary, file, security และ review จริง ข้อความสาธิตหรือคะแนนเฉลี่ยของ vendor ไม่พิสูจน์คำศัพท์ ตาราง version และ recovery ขององค์กร
PoC เสร็จใน 30 วันหรือไม่?
30 วันเป็นตัวอย่าง ขอบเขต ปริมาณ security review, contract และผู้เชี่ยวชาญทำให้เปลี่ยนได้ สิ่งสำคัญคือข้อตกลงเรื่อง holdout, residual risk, owner และช่องทางต้องห้าม
สรุป: ระบบแปลภาษาอัตโนมัติไม่ใช่เพียงการซื้อโมเดล
ระบบแปลภาษาอัตโนมัติสำหรับองค์กรต้องรวมการเตรียมต้นฉบับ อภิธานศัพท์และ translation memory เส้นทางข้อมูลที่ปลอดภัย การตรวจโดยมนุษย์ตามความเสี่ยง และการรับมอบพร้อมประเมินต่อเนื่อง การเทียบโมเดลจำเป็นแต่ไม่ใช่ศูนย์กลางของการตัดสิน
อย่าทำให้เอกสารความปลอดภัย คุณภาพ และสัญญาไร้คนตรวจ ใน PoC ตัวอย่างประมาณ 30 วัน ให้ทดสอบทั้งการแปลปกติ คำศัพท์ชนกัน การตรวจภาษาผิด OCR เสีย API fail และ revision ปน แล้วใช้หลักฐานกำหนดช่องทาง production, review และห้ามใช้
TOMAS TECH สนับสนุนโรงงานในไทยและอาเซียนตั้งแต่สำรวจเอกสาร ออกแบบคำศัพท์ญี่ปุ่น–ไทย–อังกฤษ–เวียดนาม สร้าง pipeline ปลอดภัย ทำ PoC และวางขั้นตอนอนุมัติ สามารถ ติดต่อเรา ได้ตั้งแต่ก่อนเลือกผลิตภัณฑ์หรือออก RFP จุดเริ่มต้นที่ดีคือการระบุเอกสารเป้าหมายและผลกระทบหากแปลผิด
แหล่งข้อมูลทางการ
- OpenAI — Data controls in the OpenAI platform
- Microsoft Azure Translator — Use glossaries with Document translation
- DeepL — Language detection
- DeepL — Pre-production checklist
- Google Cloud Translation — Creating and using glossaries
- Amazon Translate — Custom terminology
- ETDA — Driving Trust AI Governance 2026
- Thailand BOI — บริบทการส่งเสริมการลงทุนครึ่งแรกปี 2026


