


บทนำ: 3 เรื่องที่ต้องตัดสินใจก่อนนำ AI ตรวจจับความผิดปกติการใช้พลังงานในโรงงานมาใช้
ในโรงงานญี่ปุ่นในไทยที่กำลังพิจารณานำ AI ตรวจจับความผิดปกติการใช้พลังงานในโรงงานมาใช้ เราคิดว่าสถานการณ์ต่อไปนี้ไม่ใช่เรื่องแปลก มีหน้าจอมอนิเตอร์ไฟฟ้าแล้ว เก็บค่าได้ทุก 15 นาทีแล้ว แต่เมื่อดูกราฟก็ยังตัดสินไม่ได้ว่า “วันนี้ใช้พลังงานมากหรือน้อย” เพราะปริมาณการใช้ขึ้นลงมากตามปริมาณการผลิตและอุณหภูมิภายนอก หากตั้งค่าเกณฑ์ (threshold) แบบง่าย ๆ ก็จะมีแต่การแจ้งเตือนผิดพลาด จนในที่สุดไม่มีใครดูการแจ้งเตือนอีก
ปี 2026 ยังเป็นปีที่มีหลายเหตุผลซ้อนกันให้ต้องทบทวน “ปริมาณ” การใช้ไฟฟ้า ตามรายงานของ The Nation เมื่อวันที่ 23 กรกฎาคม 2026 คณะกรรมการกำกับกิจการพลังงาน (กกพ. หรือ ERC) อนุมัติค่า Ft สำหรับรอบบิลเดือนกันยายนถึงธันวาคม 2026 ที่ 16.23 สตางค์/kWh และคงค่าไฟฟ้าเฉลี่ยไว้ที่ 3.95 บาท/kWh (ไม่รวม VAT) รายงานของหนังสือพิมพ์ฉบับเดียวกันเมื่อวันที่ 12 สิงหาคม 2026 ระบุว่าค่าไฟเฉลี่ยของรอบบิลเดือนกันยายนจะอยู่ที่ประมาณ 3.89 บาท/kWh (ไม่รวม VAT) จากการตัดค่าใช้จ่ายไฟฟ้าสาธารณะออกจากค่าไฟ อย่างไรก็ตาม การลดนี้ถูกรายงานว่าเป็นค่าไฟของ “ผู้ใช้ไฟทั่วไป” และบทความไม่ได้เขียนถึงการใช้กับผู้ใช้ภาคอุตสาหกรรมหรือการดำเนินการตั้งแต่เดือนตุลาคมเป็นต้นไป นอกจากนี้ ตามรายงานของ The Nation เมื่อวันที่ 1 กรกฎาคม 2026 การใช้ไฟฟ้าทั้งประเทศไทยในเดือนมกราคมถึงมีนาคม 2026 อยู่ที่ 51,127 GWh เพิ่มขึ้น 4.9% จากช่วงเดียวกันของปีก่อน โดยภาคอุตสาหกรรมเพิ่มขึ้น 2.2% และคิดเป็น 42.3% ของทั้งหมด
อีกการเปลี่ยนแปลงหนึ่งคือการยุติบริการ “API ตรวจจับความผิดปกติ” แบบอเนกประสงค์บนคลาวด์ ตามหน้าทางการของ AWS บริการ Amazon Lookout for Equipment สิ้นสุดการสนับสนุนแล้วเมื่อวันที่ 7 ตุลาคม 2026 และตาม Microsoft Learn บริการ Azure AI Anomaly Detector ถูกยุติแล้วเมื่อวันที่ 1 ตุลาคม 2026 หากโรงงานใดสร้างระบบมอนิเตอร์ไว้บนบริการเหล่านี้ ก็จำเป็นต้องสร้างใหม่
ถ้าเช่นนั้น เพียงนำ AI มาใช้ก็จะพบความสูญเปล่าด้านพลังงานได้โดยอัตโนมัติหรือไม่ ในบทความนี้ เราคิดว่าเมื่อจะนำ AI มาใช้ตรวจจับความผิดปกติการใช้พลังงานในโรงงาน สิ่งที่ต้องตัดสินใจก่อนไม่ใช่ชื่ออัลกอริทึม แต่เป็น 3 เรื่องต่อไปนี้
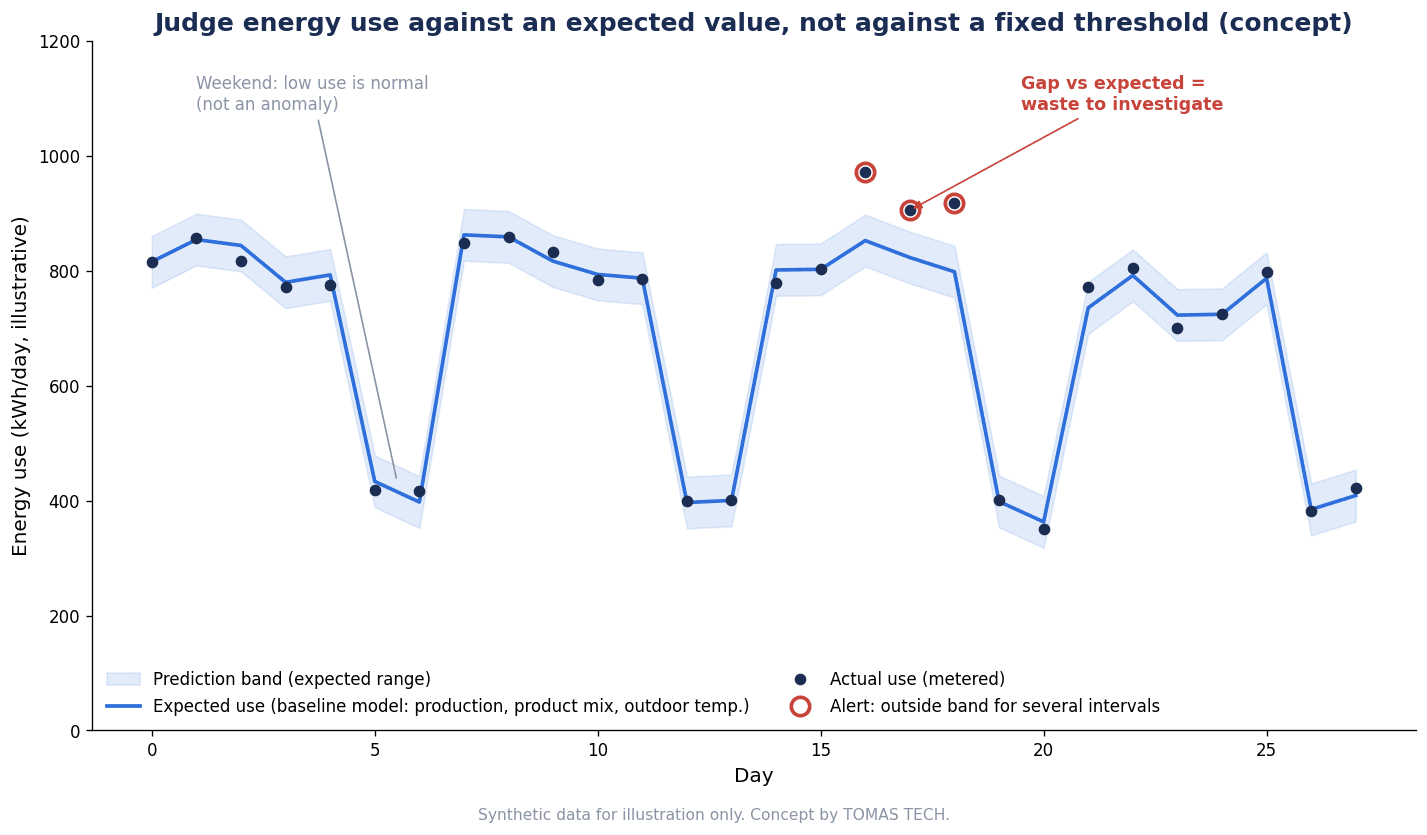
- จะเทียบกับอะไรเพื่อบอกว่าผิดปกติ: ไม่ดูที่ปริมาณการใช้เอง แต่ดูส่วนต่างจาก “ปริมาณการใช้ที่คาดหวัง (เส้นฐาน)” ซึ่งคำนวณจากตัวแปรที่เกี่ยวข้อง เช่น ปริมาณการผลิต ชนิดผลิตภัณฑ์ และอุณหภูมิภายนอก
- แยกเกณฑ์ความแม่นยำของโมเดลออกจากวิธีส่งการแจ้งเตือน: การที่โมเดลทำนายได้แม่นกับการที่การแจ้งเตือนมีประโยชน์เป็นคนละหัวข้อในการออกแบบ ทุกการแจ้งเตือนต้องมีผู้รับผิดชอบที่จะตรวจสอบสาเหตุและมีกำหนดเวลา
- กำหนดการทบทวนและการนำออกไว้ในสัญญา: เขียนเงื่อนไขการทบทวนเส้นฐาน ตัวแปรอธิบาย และวิธีนำข้อมูลกับโมเดลออก ไว้ใน RFP (เอกสารขอข้อเสนอ) แล้วตรวจสอบผ่าน PoC และ FAT/SAT (การทดสอบก่อนส่งออกจากโรงงานผู้ผลิตและการทดสอบรับมอบ ณ หน้างาน)
ต่อไปนี้ เราจะตรวจสอบหลักฐานของ 3 ประเด็นนี้ตามลำดับ ได้แก่ คู่มือ ISO 50001 ของกระทรวงพลังงานสหรัฐฯ (DOE) เอกสารที่อ้างอิง ASHRAE Guideline 14 เกณฑ์มาตรฐานสาธารณะ (public benchmark) เอกสารเผยแพร่ของผลิตภัณฑ์หลัก และระบบกฎหมายของไทย แล้วสรุปลงเป็นรายการใน RFP และการทดสอบรับมอบ
AI ตรวจจับความผิดปกติการใช้พลังงานคืออะไร: สิ่งที่อยากหาคือ “ความสูญเปล่า” มากกว่า “การเสีย”
AI ตรวจจับความผิดปกติการใช้พลังงานคือกลไกที่เฝ้าดูปริมาณการใช้ไฟฟ้า ลมอัด ไอน้ำ ก๊าซ ฯลฯ อย่างต่อเนื่อง และแจ้งเมื่อพบ “การใช้ที่แตกต่างจากปกติ” สิ่งที่บทความนี้เน้นเป็นหลักไม่ใช่สัญญาณบอกล่วงหน้าว่าเครื่องจักรจะเสีย แต่เป็นความสูญเปล่าด้านพลังงานที่แฝงอยู่ในการเดินเครื่องประจำวัน เช่น เครื่องจักรที่ลืมปิดในวันหยุดหรือช่วงพักกลางวัน ไฟฟ้าสแตนด์บายที่ไม่ลดลงแม้การผลิตจบแล้ว การใช้ลมอัดที่ไม่ลดลงแม้ในเวลากลางคืน และการตั้งค่าเครื่องปรับอากาศหรือน้ำหล่อเย็นที่คลาดเคลื่อน
การตรวจจับความผิดปกติเพื่อหาสัญญาณก่อนเครื่องจักรเสีย ใช้สัญญาณเฉพาะของแต่ละเครื่อง เช่น การสั่นสะเทือน อุณหภูมิ และรูปคลื่นกระแส โดยมีเป้าหมายเพื่อ “หยุดเครื่องก่อนที่จะเสีย” ส่วนการตรวจจับความผิดปกติด้านพลังงานจะเทียบปริมาณการใช้ของทั้งโรงงานหรือกลุ่มเครื่องจักรกับ “ปริมาณที่สมเหตุสมผลเมื่อพิจารณาจากการผลิตและอุณหภูมิ” เพื่อค้นหา “ช่วงเวลาและจุดที่ใช้เกินความจำเป็น” แม้จะเรียกว่า “AI ตรวจจับความผิดปกติ” เหมือนกัน แต่ข้อมูลที่ใช้ เกณฑ์การตัดสิน และผู้รับการแจ้งเตือนต่างกัน
ภาพรวมว่าควรเริ่มใช้ AI ตรวจจับความผิดปกติในโรงงานจากด้านใด ได้สรุปไว้ใน AI ตรวจจับความผิดปกติ 2026 | ตัดสินว่าควรเริ่มจากด้านใดใน 5 ด้าน บทความนี้เป็นรายละเอียดการนำไปใช้จริงในด้านพลังงาน สำหรับกลไกพื้นฐานที่เป็นเงื่อนไขก่อนการตรวจจับความผิดปกติ เช่น วิธีเลือกจุดวัดและค่าใช้จ่ายในการทำให้มองเห็นข้อมูล โปรดดู ระบบติดตามการใช้พลังงาน | ค่าใช้จ่ายและขั้นตอนติดตั้ง
แม้ในโลกของงานวิจัย การกำหนดว่า “อะไรคือความผิดปกติ” ก็ไม่ใช่เรื่องง่าย บทความทบทวนวรรณกรรมของ Himeur และคณะ (Applied Energy, ปี 2021) ได้สรุปงานด้านการตรวจจับความผิดปกติของการใช้พลังงานในอาคารด้วย AI อย่างกว้างขวาง และระบุปัญหาที่ยังไม่ได้รับการแก้ไขว่า “ยังไม่มีนิยามที่เคร่งครัดของการใช้ไฟฟ้าที่ผิดปกติ” รวมทั้งยังไม่มีชุดข้อมูลที่ติดป้ายกำกับและตัวชี้วัดการประเมินที่เป็นมาตรฐานเดียวกัน กลุ่มเป้าหมายหลักของบทความทบทวนนี้คือมิเตอร์ย่อยและเซนเซอร์อัจฉริยะในที่อยู่อาศัย แต่เราคิดว่าในโรงงานก็มีสภาพเดียวกัน ด้วยเหตุนี้ ฝ่ายที่นำระบบมาใช้จึงต้องกำหนดนิยามของความผิดปกติก่อน
ในอีกด้านหนึ่ง ก็มีงานวิจัยที่มุ่งเป้าไปที่โรงงาน บทความของ Mendia และคณะ (Expert Systems, กุมภาพันธ์ 2024) รายงานเครื่องมือที่อธิบายลักษณะ “พฤติกรรมการผลิตและพลังงานในสภาวะปกติ” ของโรงงานแบบไม่มีผู้สอน (unsupervised) ในรูปแบบที่คนเข้าใจได้ เฝ้าดูการใช้พลังงานและการผลิตไปพร้อมกันเพื่อตรวจจับความผิดปกติและความไม่มีประสิทธิภาพ และระบุสาเหตุในระดับไลน์ กระบวนการ และเครื่องจักร งานนี้ประเมินด้วยข้อมูลของ GESTAMP ผู้ผลิตชิ้นส่วนยานยนต์ และระบุว่าได้ผลดีกว่าวิธีแบบไม่มีผู้สอนและกึ่งมีผู้สอนที่นำมาเปรียบเทียบ เนื่องจากบทคัดย่อไม่ได้แสดงค่าตัวเลขของประสิทธิภาพ บทความนี้จึงไม่อ้างอิงตัวเลข สิ่งที่เราอยากให้สังเกตคือทิศทางการออกแบบที่ดูพลังงานกับการผลิตไปพร้อมกัน และแสดงสาเหตุในรูปแบบที่คนเข้าใจได้
ทำไมดู “ปริมาณการใช้เอง” แล้วจึงไม่รู้ว่าผิดปกติ: การปรับค่า EnPI ให้เป็นมาตรฐาน
เหตุที่ดูกราฟปริมาณการใช้อย่างเดียวแล้วตัดสินไม่ได้ ก็เพราะปริมาณการใช้ไม่ได้เปลี่ยนแปลงเพราะ “ความสูญเปล่า” เท่านั้น แต่ยังเปลี่ยนตาม “ความยุ่งของการผลิต” และ “ความร้อนของอากาศ” ด้วย วันที่ผลิตมากก็ใช้พลังงานมากขึ้นเป็นเรื่องธรรมดา หากเรียกสิ่งนั้นว่าผิดปกติก็จะกลายเป็นการแจ้งเตือนผิดพลาด ในทางกลับกัน วันที่ผลิตน้อยแต่ปริมาณการใช้ไม่ค่อยลดลงต่างหากที่อาจมีความสูญเปล่าซ่อนอยู่
ISO 50001:2018 เป็นกรอบสำหรับติดตามการปรับปรุงด้วยดัชนีสมรรถนะพลังงาน (EnPI) และเส้นฐานพลังงาน (Energy Baseline: EnB) ตามคู่มือของ “50001 Ready Navigator” ของ DOE สหรัฐฯ ซึ่งสอดคล้องกับ ISO 50001:2018 (เผยแพร่โดย Lawrence Berkeley National Laboratory) EnPI มีได้หลายรูปแบบ ได้แก่ “ตัวชี้วัดเดี่ยว” “อัตราส่วน (การใช้พลังงานต่อหน่วยผลผลิต)” และ “แบบจำลองเชิงตัวเลขที่พิจารณาตัวแปรที่เกี่ยวข้องตั้งแต่ 1 ตัวขึ้นไป” และระบุว่าเมื่อมีตัวแปรที่เกี่ยวข้อง จะใช้ปริมาณการใช้พลังงานเองเป็น EnPI ไม่ได้ และควรปรับค่า EnPI ให้เป็นมาตรฐาน (normalize) ส่วนเกณฑ์ในการตัดสินว่าตัวแปรที่เกี่ยวข้อง “มีผลอย่างมีนัยสำคัญ” หรือไม่นั้น คู่มือระบุว่าองค์กรเป็นผู้กำหนดเอง
การปรับค่าให้เป็นมาตรฐานในที่นี้หมายถึงการทำให้เงื่อนไขที่ต่างกัน เช่น ปริมาณการผลิตและอุณหภูมิภายนอก อยู่บนฐานเดียวกันก่อนนำมาเปรียบเทียบ การใช้พลังงานต่อหน่วยผลผลิต (เช่น kWh/ชิ้น) เป็นการปรับค่าที่ง่ายที่สุด แต่หากมีส่วนที่เกิดขึ้นโดยไม่เกี่ยวกับปริมาณการผลิต เช่น ไฟฟ้าสแตนด์บาย ก็จะมีลักษณะเฉพาะคือ วันที่ผลิตน้อยเท่าไร ค่าต่อหน่วยก็จะดูแย่ลงเท่านั้น แบบจำลองถดถอยที่ใส่ตัวแปรที่เกี่ยวข้องหลายตัวเป็นวิธีหนึ่งในการชดเชยลักษณะนี้
บทบาทของ EnPI และ EnB ใน ISO 50001 และขั้นตอนตั้งแต่การทำให้มองเห็นข้อมูลจนถึงการคืนทุน ได้อธิบายไว้ใน ISO50001 การจัดการพลังงาน 2026 นอกจากนี้ยังมี ISO 50006:2023 (ฉบับที่ 2, พฤษภาคม 2023) เป็นแนวทางการกำหนด การใช้ และการรักษา EnPI และ EnB ซึ่งระบุว่าใช้ได้ไม่ว่าจะมี ISO 50001 หรือไม่ อย่างไรก็ตาม บทความนี้ไม่ได้ตรวจสอบเกณฑ์ทางสถิติที่เป็นรูปธรรมในข้อกำหนดของมาตรฐานนั้น จึงไม่นำมากล่าวถึง
ขอระบุขอบเขตของบทความนี้ไว้ด้วย การวัดและพิสูจน์ว่า “ลดลงได้เท่าไร” หลังดำเนินมาตรการประหยัดพลังงานแล้วตรวจรับผลนั้น เป็นงานของ M&V (Measurement and Verification) ISO 50015:2014 เป็นมาตรฐานที่ให้หลักการทั่วไปและแนวทางสำหรับงานนี้ และระบุว่าใช้ร่วมกับโปรโตคอลอย่าง IPMVP ได้ วิธีตรวจรับยอดประหยัดของมาตรการด้วย M&V ขอยกไปไว้ที่ มาตรการประหยัดพลังงานในโรงงาน: จากการวัดสู่ผลที่พิสูจน์ได้ บทความนี้ไม่ได้พูดถึงการเปรียบเทียบก่อนและหลังมาตรการ แต่เป็นเรื่องของ การค้นหาความสูญเปล่าและความผิดปกติในการเดินเครื่องประจำวัน เครื่องมือที่ใช้ (เส้นฐาน การถดถอย การปรับค่าให้เป็นมาตรฐาน) เหมือนกัน แต่เป้าหมายและความถี่ในการตัดสินต่างกัน
วิธีสร้างโมเดลเส้นฐาน (ปริมาณการใช้ที่คาดหวัง)
หัวใจของการตรวจจับความผิดปกติด้านพลังงานคือโมเดลที่บอกปริมาณการใช้ที่คาดหวังว่า “ภายใต้เงื่อนไขนี้ ควรใช้ประมาณเท่านี้” เมื่อส่วนต่างระหว่างค่าจริงกับปริมาณการใช้ที่คาดหวังมีขนาดใหญ่ และส่วนต่างนั้นเกินช่วงที่เป็นไปได้ทางสถิติ ก็จะถือเป็นรายการที่สงสัยว่าผิดปกติ (candidate)
ตั้งแต่การถดถอยไปจนถึงแมชชีนเลิร์นนิง
รูปแบบพื้นฐานที่สุดคือการถดถอยเชิงเส้นที่ใช้ปริมาณการผลิตและอุณหภูมิภายนอกเป็นตัวแปรอธิบาย แล้วเพิ่มสัดส่วนชนิดผลิตภัณฑ์ กะการทำงาน วันในสัปดาห์ และการแยกวันหยุด เป็นต้น หากความสัมพันธ์ไม่เป็นเชิงเส้น หรือตัวแปรมีความเกี่ยวพันกันซับซ้อน ก็อาจใช้แมชชีนเลิร์นนิง เช่น วิธีตระกูลต้นไม้ตัดสินใจ (decision tree) หรือโครงข่ายประสาทเทียม
บทความทบทวนอย่างเป็นระบบเกี่ยวกับ EnPI ของ ISO 50001 และแบบจำลองเชิงคำนวณ ที่ตีพิมพ์ในวารสาร Algorithms ของ MDPI ได้คัดกรอง 2,691 รายการจาก 5,442 รายการ และวิเคราะห์โดยละเอียด 283 รายการ ตามบทความนี้ แนวโน้มของงานวิจัยกำลังเปลี่ยนจากตัวชี้วัดแบบดั้งเดิมและเส้นฐานที่ปรับค่าให้เป็นมาตรฐาน ไปสู่การสร้างแบบจำลองด้วยการวิเคราะห์ถดถอย แมชชีนเลิร์นนิง และดีปเลิร์นนิง วิธีการอัจฉริยะทำให้เกิด “เส้นฐานแบบพลวัต” และ “การตรวจจับรูปแบบการใช้พลังงานที่ผิดปกติได้แต่เนิ่น ๆ” ได้ แต่ก็มีความท้าทายด้านคุณภาพข้อมูล ความสามารถในการตีความโมเดล และการกำหนดมาตรฐานของระเบียบวิธี ข้อสรุปคือ วิธีการอัจฉริยะไม่ควรมาแทนที่ EnPI แต่ควรเข้ามาเปลี่ยนโฉม EnPI
ในบทความนี้ เราคิดว่าควรให้ความสำคัญกับ การที่คนหน้างานอธิบายได้ว่า “ทำไมค่าคาดหวังจึงเป็นค่านี้” มากกว่าความใหม่ของอัลกอริทึม เพราะหากผู้รับการแจ้งเตือนดูปริมาณการผลิตหรืออุณหภูมิที่เป็นที่มาของค่าคาดหวังแล้วไม่รู้สึกว่า “จริงด้วย วันนี้ควรใช้น้อย” ก็จะไม่นำไปสู่การตรวจสอบหน้างาน
วิธีเลือกตัวแปรอธิบาย
ตัวแปรอธิบายที่เป็นตัวเลือก ได้แก่ ปริมาณการผลิต (จำนวนชิ้น น้ำหนัก จำนวนสโตรก ฯลฯ) ชนิดผลิตภัณฑ์หรือสัดส่วนผลิตภัณฑ์ ชั่วโมงเดินเครื่องหรือกะ อุณหภูมิภายนอก (และความชื้นหากจำเป็น) รวมถึงการแยกวันหยุดหรือการหยุดตามแผน เมื่อเลือกควรตรวจสอบประเด็นต่อไปนี้
- เป็นตัวแปรที่ทำให้ปริมาณการใช้เปลี่ยนไปจริงหรือไม่ โดยตรวจสอบทั้งจากความรู้สึกของหน้างานและจากความสัมพันธ์ในข้อมูล
- เก็บได้ในช่วงเวลาเดียวกันและความละเอียดเดียวกันกับปริมาณการใช้หรือไม่ คู่มือการถดถอยของ BPA (Bonneville Power Administration ของสหรัฐฯ) ก็ระบุว่าควรวัดตัวแปรอธิบายและตัวแปรตามในช่วงเวลาเดียวกัน
- ใครจะส่งข้อมูลจากระบบใด และภายในเมื่อใด หากปริมาณการผลิตอยู่ใน MES หรือ ERP และยืนยันได้เป็นรายวันเท่านั้น การตัดสินความผิดปกติก็จะเป็นรายวันเช่นกัน
ช่วงเวลาของเส้นฐานต้องครอบคลุมสภาวะการเดินเครื่องทั้งหมด
“Regression for M&V: Reference Guide” ของ BPA (ฉบับที่ 3, พฤษภาคม 2024) ระบุว่าข้อมูลในช่วงเวลาของเส้นฐานควร “ครอบคลุม” สภาวะการเดินเครื่องทั้งหมด หากได้รับผลจากสภาพอากาศ โดยทั่วไปจะใช้ 12 เดือนหรือ 24 เดือน และอธิบายว่าข้อมูลเฉพาะเดือนตุลาคมถึงเมษายนไม่ครอบคลุมสภาวะกลางฤดูร้อน ทำให้กลายเป็นการทำนายนอกช่วงข้อมูล คู่มือยังระบุด้วยว่าในสภาพแวดล้อมการผลิต ต้องเลือกช่วงเวลาที่ “การผลิตมีความสม่ำเสมอ”
ในโรงงานไทยที่มีภาระของเครื่องปรับอากาศหรือชิลเลอร์สูง เราคิดว่าหากไม่มีช่วงเวลาที่ครอบคลุมฤดูร้อน ฤดูฝน และฤดูแล้ง เมื่อเปลี่ยนฤดูกาลค่าคาดหวังก็จะคลาดเคลื่อนทันทีและการแจ้งเตือนผิดพลาดจะเพิ่มขึ้น หากต้องการเริ่มใช้งานเร็ว แนวทางที่เป็นไปได้จริงคือระบุให้ชัดว่าโมเดลที่สร้างจากข้อมูลช่วงสั้นเป็น “ฉบับชั่วคราว” และวางแผนไว้ล่วงหน้าว่าจะสร้างใหม่เมื่อครบหนึ่งรอบฤดูกาล
ค่า 15 นาทีและสหสัมพันธ์ในตัว (autocorrelation)
ดังที่จะกล่าวต่อไป ค่าไฟของผู้ใช้ไฟรายใหญ่ในไทยกำหนดจากความต้องการพลังไฟฟ้าเฉลี่ย 15 นาที เราคิดว่าการตั้งความละเอียดในการเก็บข้อมูลไว้ที่ 15 นาทีจะช่วยให้เทียบกับค่าไฟได้ง่ายขึ้น วิธีทำให้การเก็บค่า 15 นาทีเชื่อถือได้ ได้อธิบายไว้ใน การเก็บข้อมูลมิเตอร์ไฟฟ้า: RFP สำหรับข้อมูล 15 นาทีที่เชื่อถือได้
อย่างไรก็ตาม ความละเอียดสูงมีข้อควรระวังทางสถิติ คู่มือของ BPA ระบุว่า ข้อมูลยิ่งถี่ยิ่งช่วยลดความไม่แน่นอนของปริมาณการประหยัดได้ง่ายขึ้น แต่สำหรับข้อมูลรายชั่วโมงหรือละเอียดกว่านั้น สหสัมพันธ์ในตัว (ค่าก่อนและหลังมีลักษณะคล้ายกัน) จะทำให้การคำนวณทางสถิติบิดเบือน จึงต้องมีการจัดการเพิ่มเติม ตามคู่มือดังกล่าว Annex D ของ ASHRAE Guideline 14 ระบุว่าหากสัมประสิทธิ์สหสัมพันธ์ในตัว ρ ต่ำกว่า 0.5 ก็ไม่ต้องคำนึงถึงสหสัมพันธ์ในตัว หากใช้ค่า 15 นาทีในการตัดสินความผิดปกติ ก็อาจใช้แนวทางสองชั้น เช่น คำนวณค่าคาดหวังเป็นหน่วย 15 นาที แต่ประเมินทางสถิติในหน่วยรายวันหรือรายชั่วโมงด้วย
เกณฑ์อ้างอิงความแม่นยำของโมเดล: ควรอ่าน ASHRAE Guideline 14 อย่างไร
สำหรับคำถามว่าโมเดลเส้นฐาน “ทำนายได้แม่นเพียงใด” มีเกณฑ์อ้างอิงทางสถิติที่ใช้กันในวงการ M&V ที่เป็นตัวแทนคือ CV(RMSE) (ขนาดของความคลาดเคลื่อนในการทำนายหารด้วยค่าเฉลี่ย) และ NMBE (ความเอนเอียงของการทำนาย)
| ตัวชี้วัดและเกณฑ์อ้างอิง | เนื้อหา | แหล่งที่มาและเงื่อนไข |
|---|---|---|
| CV(RMSE): ไม่เกิน 20% | ขีดจำกัดบนของเส้นฐานการถดถอยของปริมาณการใช้พลังงาน กรณีข้อมูลช่วงรายงานน้อยกว่า 12 เดือน | ASHRAE Guideline 14-2014 (อ้างอิงโดยบทความ M&V Focus ของ EVO, ตุลาคม 2022) |
| CV(RMSE): ไม่เกิน 25% | ขีดจำกัดบนของปริมาณการใช้พลังงาน กรณีคำนวณปริมาณการประหยัดด้วยข้อมูล 12 ถึง 60 เดือน | เช่นเดียวกับข้างต้น |
| CV(RMSE): น้อยกว่าครึ่งหนึ่งของอัตราการประหยัดที่คาดหวัง | EVO แนะนำสำหรับการถดถอยเชิงเส้น IPMVP กำหนดให้ CV(RMSE) ของแต่ละมิเตอร์น้อยกว่า 50% ของอัตราการประหยัดที่คาดหวัง | บทความเดียวกับข้างต้น |
| ความเอนเอียง (net determination bias error): น้อยกว่า 0.005% | หากผ่านเงื่อนไขนี้จะยอมรับแบบจำลองพลังงาน | ASHRAE Guideline 14-2014 (อ้างอิงโดยคู่มือของ BPA) |
| R²: มากกว่า 0.75 | หลักการจากประสบการณ์ กรณีใช้ข้อมูลบิลรายเดือน | คู่มือของ BPA (เป็นหลักการจากประสบการณ์ ไม่ใช่ข้อกำหนดของมาตรฐาน) |
| สัมประสิทธิ์สหสัมพันธ์ในตัว ρ: ต่ำกว่า 0.5 | ไม่ต้องคำนึงถึงสหสัมพันธ์ในตัว | ASHRAE Guideline 14 Annex D (อ้างอิงโดยคู่มือของ BPA) |
เมื่ออ่านตารางนี้ มีข้อควรระวัง 3 ประการ
ประการแรก ค่า CV(RMSE) 20% และ 25% ที่ยกมานี้เป็น เกณฑ์อ้างอิงความแม่นยำของเส้นฐานการถดถอย ซึ่งเป็นข้อความจาก ASHRAE Guideline 14-2014 ที่ถูกอ้างอิงในบทความของ EVO (Efficiency Valuation Organization) ต้นฉบับของ ASHRAE เป็นเอกสารที่ต้องซื้อ บทความนี้จึงไม่ได้ตรวจสอบต้นฉบับ และตามคู่มือของ BPA ฉบับล่าสุดคือ ASHRAE Guideline 14-2023 ซึ่งเรายังตรวจสอบไม่ได้ว่าตัวเลขในฉบับปี 2023 เปลี่ยนไปหรือไม่
ประการที่สอง ค่าเหล่านี้ ไม่ใช่เกณฑ์ผ่านของ AI ตรวจจับความผิดปกติ เป้าหมายของ M&V คือการประมาณปริมาณการประหยัดในช่วงเวลาหนึ่งให้ถูกต้อง ส่วนเป้าหมายของการตรวจจับความผิดปกติคือการค้นหาความคลาดเคลื่อนขนาดใหญ่ในแต่ละช่วงเวลา แม้ CV(RMSE) ของทั้งโมเดลจะต่ำ ก็ยังอาจมีการแจ้งเตือนมากเกินไป หรือพลาดความผิดปกติที่สำคัญได้ ในทางกลับกัน หากความแม่นยำของโมเดลไม่ผ่านเกณฑ์อ้างอิง (เช่น CV(RMSE) สูงกว่าค่าเกณฑ์) ก็เป็นไปได้ว่าตัวแปรอธิบายยังไม่พอหรือข้อมูลมีปัญหา เราคิดว่าควรแก้ส่วนนั้นก่อนจะเริ่มส่งการแจ้งเตือน
ประการที่สาม ผู้เขียนบทความของ EVO กล่าวว่าผู้เชี่ยวชาญส่วนใหญ่ให้ความสำคัญกับ CV(RMSE) มากกว่า R² เนื่องจาก R² มักออกมาสูงเมื่อปริมาณการใช้มีความผันผวนมาก จึงสำคัญที่จะไม่ตัดสินว่า “โมเดลทำนายได้แม่น” จาก R² เพียงอย่างเดียว
ใน RFP เราแนะนำให้ผู้ขายระบุว่า “จะรายงานตัวชี้วัดใด ด้วยข้อมูลช่วงเวลาใด ในหน่วยใด (15 นาที รายชั่วโมง รายวัน)” และจัดให้อยู่ในรูปแบบที่บริษัทของท่านตรวจสอบค่าเหล่านั้นได้เอง
การเตรียมข้อมูลและคุณภาพข้อมูล: อย่าให้โมเดลเรียนรู้ความผิดปกติว่าเป็นเรื่องปกติ
คุณภาพของโมเดลเส้นฐานขึ้นอยู่กับคุณภาพของข้อมูลที่ใช้เรียนรู้ คู่มือของ BPA แสดงขั้นตอนการทำความสะอาดข้อมูลไว้ดังนี้
- ค่าผิดปกติ (outlier): ตรวจหาสาเหตุ หากเป็นสิ่งที่ผิดปกติจริง เช่น เครื่องจักรเสีย การหยุดทำการที่ผิดปกติ หรือเครื่องวัดขัดข้อง ให้บันทึกไว้แล้วตัดออก
- เหตุการณ์ที่ไม่เป็นประจำ (non-routine event): ปรับค่าสำหรับการปรับปรุง การขยาย การเพิ่มหรือถอดเครื่องจักร การเปลี่ยนตารางเดินเครื่อง ฯลฯ
- ข้อมูลขาดหาย: หากขาดหายเป็นช่วงใหญ่ ให้หาสาเหตุหรือข้อมูลทดแทน (เช่น สถานีตรวจอากาศใกล้เคียง) หากขาดหายเล็กน้อย ให้เติมด้วยค่าเฉลี่ยของค่าก่อนและหลัง เป็นต้น และหากขาดหายหลายจุด ให้ประมาณค่าด้วยแบบจำลองถดถอย
- ข้อมูลซ้ำ: ข้อมูลแบบช่วงเวลา (interval data) มักเกิดข้อมูลซ้ำได้ง่าย จึงต้องตัดข้อมูลซ้ำออก
คู่มือเดียวกันระบุว่าควรทำความสะอาดข้อมูลทั้งในช่วงเส้นฐานและช่วงรายงาน เมื่อนำมาใช้กับการตรวจจับความผิดปกติ เราคิดว่าหากให้โมเดลเรียนรู้โดยไม่ตัดช่วงที่มีลมอัดรั่วหรือคืนที่ลืมปิดเครื่องซึ่งอยู่ในข้อมูลในอดีตออก โมเดลจะจำสิ่งเหล่านั้นว่าเป็น “ปกติ” บทความของ LEAD1.0 ก็บันทึกไว้ว่า ป้ายกำกับค่าผิดปกติที่ผู้เข้าแข่งขันอันดับต้น ๆ ใน Kaggle ตัดออกนั้นไม่สมบูรณ์ งานคัดแยกความผิดปกติในอดีตเป็นงานที่ดูไม่โดดเด่น แต่ข้ามไม่ได้
EVO ผู้ดูแล IPMVP แยกการปรับค่าแบบประจำ (routine adjustment: การทำให้เงื่อนไขเท่ากันด้วยการถดถอยหรือวิธีอื่น สำหรับปัจจัยที่คาดว่าจะเปลี่ยนแปลงเป็นประจำ) ออกจากการปรับค่าแบบไม่เป็นประจำ (non-routine adjustment: การปรับค่าเมื่อปัจจัยที่สมมติว่าไม่เปลี่ยนแปลงกลับส่งผลต่อการใช้พลังงานด้วยเหตุผลอื่นที่ไม่ใช่มาตรการประหยัดพลังงาน) หากแยกไว้ว่าการเปลี่ยนแปลงของปริมาณการผลิตหรืออุณหภูมิเป็น “แบบประจำ” ที่โมเดลรองรับ ส่วนการเพิ่มไลน์หรือการถอดเครื่องจักรเป็น “แบบไม่เป็นประจำ” ที่บันทึกไว้นอกโมเดล ก็จะทำให้การทบทวนเส้นฐานที่จะกล่าวต่อไปจัดระเบียบได้ง่ายขึ้น
วิธีวางแผนพจนานุกรมข้อมูล การซิงโครไนซ์เวลา และการจัดการข้อมูลขาดหาย ได้อธิบายโดยละเอียดใน ระบบการจัดการพลังงาน: แผนข้อมูล ISO/DIS 50012 สำหรับโรงงาน ส่วนวิธีนำข้อมูลขาดหายจากเซนเซอร์หรือการสื่อสารมาใส่ในเกณฑ์รับมอบ โปรดดู การป้องกันข้อมูลเซนเซอร์โรงงานสูญหาย: เกณฑ์รับงาน RFP, FAT และ SAT ในกรณีของการตรวจจับความผิดปกติ ต้องกำหนดไว้ด้วยว่าจะให้การขาดหายของข้อมูลเองเป็นเป้าหมายของการแจ้งเตือนหรือไม่ เพื่อไม่ให้เข้าใจผิดว่าการที่มิเตอร์หยุดทำงานจนปริมาณการใช้เป็นศูนย์คือ “การประหยัดพลังงานได้มาก”
การออกแบบการแจ้งเตือน: กำหนดแยกจากความแม่นยำของโมเดล
เมื่อได้โมเดลแล้ว ขั้นต่อไปคือวิธีส่งการแจ้งเตือน นี่คือประเด็นหลักข้อที่ 2 ของบทความนี้ เกณฑ์ความแม่นยำของโมเดลกับเงื่อนไขการแจ้งเตือนให้กำหนดแยกกันเป็นคนละหัวข้อในการออกแบบ
ใช้ช่วงการทำนายกำหนด “ช่วงที่เป็นไปได้”
ตามคู่มือของ BPA ช่วงการทำนาย (prediction interval) คือ “ช่วงที่ค่าสังเกตหนึ่งค่าควรตกอยู่” และกว้างกว่าช่วงความเชื่อมั่นของค่าเฉลี่ย เราคิดว่าเป็นเรื่องธรรมชาติที่จะใช้ช่วงการทำนายนี้พิจารณาว่าค่าจริงในแต่ละช่วงเวลาต้องห่างจากค่าคาดหวังเพียงใดจึงจะถือว่าผิดปกติ การหลุดออกนอกช่วงการทำนายไม่ได้แปลว่าผิดปกติเสมอไป แต่ก็เป็นรายการที่น่าสงสัยว่าเป็น “ความคลาดเคลื่อนที่อธิบายได้ยากด้วยความคลาดเคลื่อนของโมเดล”
ผสมระยะเวลาต่อเนื่อง มูลค่าเงิน และลำดับความสำคัญ
หากส่งการแจ้งเตือนทันทีที่ค่า 15 นาทีเพียงค่าเดียวหลุดออกนอกช่วงการทำนาย การแจ้งเตือนจะมากเกินไป ในทางปฏิบัติ อาจผสมเงื่อนไขต่อไปนี้เข้าด้วยกัน
| หัวข้อการออกแบบ | สิ่งที่ต้องกำหนด | แนวคิด (มุมมองของบทความนี้) |
|---|---|---|
| ขนาดของความคลาดเคลื่อน | อยู่นอกช่วงการทำนายหรือไม่ ส่วนต่างจากค่าคาดหวังมากเพียงใด | ให้ถือเป็นรายการที่น่าสงสัยเฉพาะความคลาดเคลื่อนที่อธิบายได้ยากด้วยความคลาดเคลื่อนของโมเดล |
| ระยะเวลาต่อเนื่อง | ต่อเนื่องกี่ครั้ง กี่ชั่วโมง จึงจะแจ้งเตือน | ความคลาดเคลื่อนที่ต่อเนื่องมีโอกาสเป็นความสูญเปล่ามากกว่าการหลุดเพียงชั่วขณะ |
| การแปลงเป็นปริมาณหรือมูลค่าเงิน | จะแสดงความคลาดเคลื่อนเป็น kWh หรือมูลค่าเงินหรือไม่ | หน้างานจัดลำดับความสำคัญได้ง่ายขึ้น ราคาต่อหน่วยให้บริษัทกำหนดเองจากสัญญาและใบแจ้งค่าไฟ |
| ลำดับความสำคัญ | แบ่งเป็นเร่งด่วน ภายในวันนั้น และรายสัปดาห์ | ความคลาดเคลื่อนเล็ก ๆ ที่ต่อเนื่องให้รวมไว้ตรวจสอบรายสัปดาห์ |
| ผู้รับการแจ้งเตือน | แจ้งใคร ผ่านช่องทางใด | กำหนดผู้รับผิดชอบตามเครื่องจักรหรือพื้นที่ และรวบรวมไปยัง ผชร. ด้วย |
| กำหนดเวลาตรวจสอบ | ต้องตรวจสอบสาเหตุภายในเมื่อใด | การแจ้งเตือนที่ไม่มีกำหนดเวลาจะไม่มีใครดู |
| เงื่อนไขระงับการแจ้งเตือน | จะหยุดการแจ้งเตือนระหว่างหยุดตามแผน ทดลองเดินเครื่อง หรือเปลี่ยนเครื่องจักรหรือไม่ | ไม่ให้แจ้งเตือนจากเหตุการณ์ที่รู้อยู่แล้ว |
หากแปลงเป็นมูลค่าเงิน โปรดกำหนดราคาต่อหน่วยจากประเภทสัญญาของบริษัทและใบแจ้งค่าไฟจริง ค่าไฟเฉลี่ยที่มีการรายงานในข่าวเป็นค่าเฉลี่ยสำหรับผู้ใช้ทั่วไป ไม่ใช่ค่าไฟของบริษัทท่านเอง
ป้องกันความเหนื่อยล้าจากการแจ้งเตือนด้วยการ “วัดจำนวน”
ในวงการควบคุมกระบวนการ มีมาตรฐานการจัดการสัญญาณเตือน (alarm management) อย่าง ISA-18.2 และ EEMUA 191 และแนวคิดในการกำหนดเกณฑ์อ้างอิงจำนวนสัญญาณเตือนที่ผู้ควบคุมเครื่อง 1 คนได้รับ ถูกแนะนำไว้ในเอกสารทุติยภูมิหลายฉบับ เกณฑ์นี้เป็นเกณฑ์ของสัญญาณเตือนสำหรับผู้ควบคุมเครื่อง ไม่ใช่เกณฑ์ของการแจ้งเตือนความผิดปกติด้านพลังงาน ถึงกระนั้น เราคิดว่าแนวคิด “ออกแบบจำนวนการแจ้งเตือน วัดจำนวนจริง และหากมากเกินไปก็ทบทวนเงื่อนไข” สามารถนำมาใช้ได้โดยตรง
บทความเกณฑ์มาตรฐานสาธารณะก็ระบุเป็นปัญหาว่า เนื่องจากไม่มีข้อมูลที่ติดป้ายกำกับ จึงมีการใช้วิธีแบบไม่มีผู้สอนอย่างแพร่หลาย และทำให้มีการตรวจจับผิดพลาดมาก ABB อธิบายไว้ในบทความข่าวเกี่ยวกับการจัดการพลังงานว่า เนื่องจากประสิทธิภาพของเครื่องจักรเปลี่ยนไปตามอายุการใช้งาน ค่าเกณฑ์การแจ้งเตือนที่ตั้งด้วยมือจึงต้องปรับปรุงอยู่เสมอ ไม่ว่าจะตั้งค่าเกณฑ์ด้วยมือหรือให้ AI สร้างช่วงที่คาดหวัง ก็ต้องมีกลไกทบทวนจำนวนและเนื้อหาของการแจ้งเตือนทุกสัปดาห์
กำหนดผู้รับผิดชอบตรวจสอบสาเหตุและกำหนดเวลา
การแจ้งเตือนความผิดปกติด้านพลังงานโดยตัวมันเองเป็นเพียง “สิ่งที่อาจเป็นความสูญเปล่า” ต้องไปที่หน้างานเพื่อตรวจสอบว่าเกิดอะไรขึ้นจึงจะรู้ว่าเป็นความสูญเปล่า เป็นการใช้ที่มีเหตุผลอันสมควร หรือเป็นปัญหาของการวัด ในบทความนี้ เราแนะนำให้ทุกการแจ้งเตือนมี “ผู้รับผิดชอบตรวจสอบ” และ “กำหนดเวลาตรวจสอบ” และบันทึกผลการตรวจสอบไว้ เราคิดว่าการแจ้งเตือนที่ไม่มีผู้รับผิดชอบ ไม่ว่าจะแม่นยำเพียงใดก็ไม่นำไปสู่ผลลัพธ์
สิ่งที่เรียนรู้ได้จากเกณฑ์มาตรฐานสาธารณะ: ทายถูกมาก แต่ก็พลาดมาก
วิธี AI สำเร็จรูปใช้ตรวจจับความผิดปกติด้านพลังงานได้ดีเพียงใด เกณฑ์มาตรฐานสาธารณะหนึ่งคือ LEAD1.0 (Gulati & Arjunan, arXiv 2203.17256, 30 มีนาคม 2022) ขอยืนยันเงื่อนไขก่อน
- ข้อมูลที่ใช้คือ มิเตอร์ไฟฟ้าของอาคารพาณิชย์ (อาคารที่ไม่ใช่ที่อยู่อาศัย) 1,413 ตัว ค่ารายชั่วโมงตลอด 1 ปีของปี 2016 ไม่ใช่ข้อมูลของโรงงาน
- ใช้ข้อมูลจาก ASHRAE Great Energy Predictor III (Kaggle, ปี 2019) แล้วให้คนติดป้ายกำกับความผิดปกติแบบจุดและความผิดปกติแบบต่อเนื่อง (แบบกลุ่ม) (ประมาณ 100 ชั่วโมงคน) ความผิดปกติมี 199,640 จุดจาก 12,060,910 จุด (ไม่นับข้อมูลขาดหาย)
- การประเมินคือ “ช่วง 24 ชั่วโมงผิดปกติหรือไม่” วิธีที่ใช้คือ วิธีสำเร็จรูปแบบไม่มีผู้สอน 8 วิธี ของ PyOD ตัวชี้วัดคือ Precision (ความแม่นยำ: สัดส่วนที่ผิดปกติจริงในบรรดาที่ตัดสินว่าผิดปกติ) Recall (ความครบถ้วน: สัดส่วนที่จับได้ในบรรดาความผิดปกติจริง) และ F1 (ค่าเฉลี่ยฮาร์มอนิกของทั้งสอง)
ผลลัพธ์เป็นดังนี้ (ตารางที่ 1 ของบทความ)
| วิธี | F1 | Precision | Recall |
|---|---|---|---|
| KNN | 0.431 | 0.902 | 0.284 |
| LOF | 0.426 | 0.900 | 0.281 |
| CBLOF | 0.425 | 0.900 | 0.277 |
| Feature Bagging | 0.424 | 0.899 | 0.279 |
| MCD | 0.422 | 0.901 | 0.276 |
| OCSVM | 0.421 | 0.899 | 0.276 |
| Isolation Forest | 0.413 | 0.895 | 0.270 |
| HBOS | 0.397 | 0.896 | 0.258 |
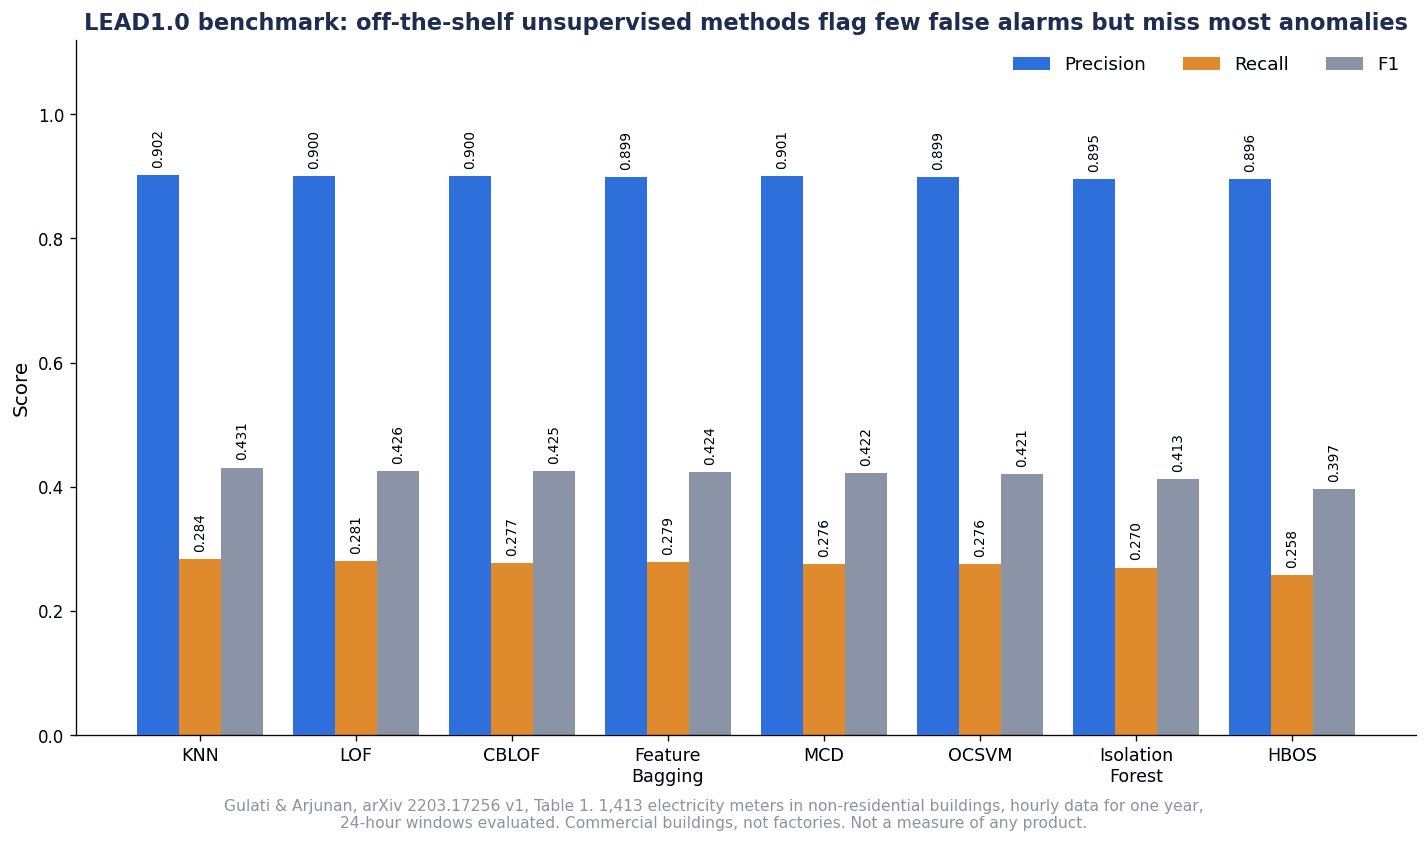
ภายใต้เงื่อนไขนี้ ทั้ง 8 วิธีมี Precision สูงที่ 0.895 ถึง 0.902 แต่ Recall อยู่เพียง 0.258 ถึง 0.284 และ F1 แม้แต่ KNN ที่สูงที่สุดก็อยู่ที่ 0.431 กล่าวคือ ผลลัพธ์คือ “ช่วงที่ตัดสินว่าผิดปกติส่วนใหญ่ถูกต้อง แต่จับความผิดปกติที่คนติดป้ายกำกับไว้ไม่ได้เป็นส่วนมาก” ผู้เขียนเองก็ระบุไว้ว่านี่เป็นเกณฑ์มาตรฐานที่มีข้อจำกัด
สิ่งที่บทความนี้สรุปจากผลลัพธ์นี้มี 2 ประการ
ประการแรก อย่าประเมิน AI ด้วยตัวเลขเพียงตัวเดียว แม้จะได้ยินว่า “ความแม่นยำสูง” ความหมายก็ต่างกันโดยสิ้นเชิงว่าเป็น Precision, Recall หรือ F1 หากสับสน Precision กับ F1 ก็จะประเมินผิดไปมาก
ประการที่สอง การนำวิธีสำเร็จรูปแบบไม่มีผู้สอนมาใช้ตรง ๆ อาจทำให้เกิดการตรวจจับพลาดมาก หลังจาก LEAD1.0 ก็มีงานวิจัยที่ใช้ข้อมูลชุดเดียวกันทดลอง GAN หรือโมเดลแยกตามคลัสเตอร์ แต่จำนวนอาคารที่ศึกษา หน่วยการประเมิน และเงื่อนไขว่ามีผู้สอนหรือไม่แตกต่างกัน จึงนำค่ามาวางเทียบกันไม่ได้ เราคิดว่าเมื่อใช้ในโรงงาน เงื่อนไขพื้นฐานคือการผสมเส้นฐานที่ใส่ตัวแปรอธิบายเฉพาะของโรงงาน เช่น ปริมาณการผลิตและชนิดผลิตภัณฑ์ เข้ากับการดำเนินงานที่ให้คนตรวจสอบ
ค่ารายชั่วโมงของอาคารพาณิชย์กับค่า 15 นาทีของโรงงานมีลักษณะการเปลี่ยนแปลงของปริมาณการใช้ต่างกันโดยสิ้นเชิง โปรดอย่าอ่านค่าในตารางนี้ว่าเป็นค่าที่คาดหวังได้ในโรงงาน การตรวจสอบด้วยข้อมูลของบริษัทเองโดยใช้เหตุการณ์ในอดีตที่บริษัทรู้อยู่แล้ว คือบทบาทของ PoC ที่จะกล่าวในบทต่อ ๆ ไป
ผลิตภัณฑ์หลักอธิบายไว้อย่างไร
ต่อไปนี้สรุปว่าเอกสารเผยแพร่ของผลิตภัณฑ์หลักอธิบายฟังก์ชันเกี่ยวกับค่าคาดหวังของพลังงานและการแจ้งเตือนไว้อย่างไร เรียงตามลำดับตัวอักษรของชื่อบริษัท ตารางนี้ไม่ใช่การเปรียบเทียบข้อดีข้อเสียหรือการแนะนำ แต่เพื่อดูว่า “ได้รับการอธิบายว่าเป็นกลไกแบบใด” สำหรับราคาที่เปิดเผยต่อสาธารณะ เราตรวจสอบไม่พบสำหรับทุกผลิตภัณฑ์
| บริษัทและผลิตภัณฑ์ (แหล่งที่มา) | ฟังก์ชันหลักตามคำอธิบายของบริษัท | ข้อควรระวังในการตรวจสอบ |
|---|---|---|
| ABB (บทความข่าวเกี่ยวกับ AI/ML สำหรับการจัดการพลังงาน) | ตามคำอธิบายของบริษัท AI ตรวจจับความผิดปกติจะสร้างช่วงการใช้พลังงานที่คาดหวังจากประวัติ และเรียนรู้ใหม่ทุกครั้งที่มีข้อมูลใหม่เข้ามา | ตรวจสอบจากข้อความที่ตัดตอนในผลการค้นหา ยังไม่ได้ยืนยันชื่อผลิตภัณฑ์และวันที่เผยแพร่ |
| Mitsubishi Electric EcoAdviser (หน้าผลิตภัณฑ์ทางการ) | ตามคำอธิบายของบริษัท มี 2 แบบ คือ “รุ่นฟังก์ชันจำกัด” (การจัดการ) และ “รุ่นวินิจฉัยด้วย AI” (การวิเคราะห์ การวินิจฉัย การพิสูจน์ผล และการเฝ้าติดตาม) ใช้ AI ของบริษัทเองดึงการสูญเสียพลังงานออกมาโดยอัตโนมัติจาก “5 มุมมองหลักในการประหยัดพลังงาน” (การสูญเสียเวลาในการเริ่มเดินและหยุดเครื่องจักร การสูญเสียเวลาของระบบสาธารณูปโภค การใช้พลังงานต่อหน่วยผลผลิต และสัดส่วนเวลาสูญเสียในการผลิต) ตัดสินปัจจัยโดยอัตโนมัติ เช่น วันในสัปดาห์ เวลาเริ่มเดินเครื่อง และจำนวนผลิต การเฝ้าติดตามการสูญเสียพลังงานโดยอัตโนมัติมีทั้งการเฝ้าติดตามด้วย AI และการเฝ้าติดตามแบบคงที่ตามค่าเป้าหมาย | การเฝ้าติดตามด้วย AI ต้องใช้ข้อมูลย้อนหลังประมาณ 30 วัน แผงเฝ้าติดตามบนแดชบอร์ดรองรับ 10 จุดวัดและอัปเดตวันละ 1 ครั้ง |
| Schneider Electric EcoStruxure Power Monitoring Expert (เอกสารช่วยเหลือของผลิตภัณฑ์) | ตามคำอธิบายของบริษัท สร้างโมเดลของเครื่องจักรหรือกระบวนการ แล้วแสดงปริมาณการใช้ที่คาดหวังตามโมเดล ค่าจริง และส่วนต่างระหว่างทั้งสอง (delta) สำหรับแนวโน้มการใช้พลังงานต่อหน่วยผลผลิต จะนำเข้าข้อมูลสำหรับปรับค่าให้เป็นมาตรฐาน เช่น ปริมาณการผลิตและอุณหภูมิ ผ่าน ETL, OPC หรือ CSV | ไม่สามารถดึงเนื้อหาของเอกสารช่วยเหลือได้ จึงตรวจสอบจากข้อความที่ตัดตอนในผลการค้นหา |
| Siemens SIMATIC Energy Manager PRO / Energy Analytics (ภาคผนวกของใบรับรองจากการตรวจประเมินโดยบุคคลที่สาม) | ตามภาคผนวก มีการยืนยันการตั้งค่า EnPI การวิเคราะห์ความสัมพันธ์และการวิเคราะห์ถดถอย การตั้งค่าเกณฑ์เพื่อการเตือนล่วงหน้า การกำหนดตัวแปรที่เกี่ยวข้องและปัจจัยคงที่ (static factor) และการจัดการมาตรการปรับปรุง | ไม่พบคำอธิบายอย่างเป็นทางการของฟังก์ชันตรวจจับความผิดปกติด้วย AI โดยตรง |
ขอเสริมจากตาราง ตามหน้าทางการของ Mitsubishi Electric ระบบ EcoAdviser จัดการไฟฟ้า น้ำ ลมอัด ก๊าซ และน้ำมันเตาไว้ในที่เดียว และจัดการการใช้พลังงานต่อหน่วยผลผลิตได้ ในการวินิจฉัย ระบบจะแสดงประมาณการผลการปรับปรุงเป็นมูลค่าเงิน และนำการประเมินของผู้ใช้ไปสะท้อนในครั้งต่อ ๆ ไป แอปที่เกี่ยวข้องของ Schneider Electric (Energy Modeling & Verification) ได้รับการอธิบายว่าวิเคราะห์การใช้พลังงานโดยเทียบกับเส้นฐานที่พิจารณาตัวขับ (driver) เช่น อุณหภูมิภายนอก จำนวนผู้อยู่ในอาคาร และผลิตภาพ ตามภาคผนวกของใบรับรองของ Siemens ส่วนประกอบที่อยู่ในขอบเขตของใบรับรองช่วยสนับสนุนการปฏิบัติตามข้อกำหนดของ ISO 50001 เช่น ข้อ 6.4 (EnPI) และ 6.5 (EnB) และ SIMATIC Energy Manager PRO กับ Energy Analytics ช่วยสนับสนุนการปฏิบัติตามข้อกำหนดของ ISO 50006 ข้อ 4.2.4 และข้ออื่น ๆ
สิ่งที่เห็นได้จากตารางคือโครงร่างที่เหมือนกันในคำอธิบายของทุกบริษัท คือ นำเข้าตัวแปรที่เกี่ยวข้อง (ตัวขับ) สร้างค่าคาดหวัง แสดงส่วนต่างจากค่าจริง และแจ้งด้วยค่าเกณฑ์หรือช่วงที่คาดหวัง เราคิดว่าไม่ว่าจะชื่อว่า “AI” หรือ “การถดถอย” แนวคิด “ดูส่วนต่างจากปริมาณการใช้ที่คาดหวัง” ตามประเด็นหลักข้อที่ 1 ของบทความนี้ก็เหมือนกัน ความแตกต่างอยู่ที่ว่าจะนำเข้าตัวแปรใดได้ในความถี่เท่าใด แสดงที่มาของค่าคาดหวังได้ละเอียดเพียงใด และควบคุมการเรียนรู้ใหม่ได้อย่างไร เรื่องเหล่านี้ตัดสินจากเอกสารของแต่ละบริษัทอย่างเดียวไม่ได้ จึงต้องตรวจสอบผ่าน RFP และ PoC ทั้งนี้ โปรดสอบถามแต่ละบริษัทเป็นรายกรณีเกี่ยวกับระบบสนับสนุนในประเทศและภาษาบนหน้าจอด้วย
บริการตรวจจับความผิดปกติบนคลาวด์ที่ยุติแล้ว
สิ่งที่ไม่ได้ยกมาไว้ในตารางคือบริการคลาวด์ที่ยุติไปในปี 2026 บริการเหล่านี้ไม่ใช่ตัวเลือกในปัจจุบัน แต่ขอนำเสนอเป็นกรณีตัวอย่างว่า “จะเกิดอะไรขึ้นเมื่อบริการยุติ”
ตามหน้าทางการของ AWS บริการ Amazon Lookout for Equipment สิ้นสุดการสนับสนุนเมื่อวันที่ 7 ตุลาคม 2026 และหลังจากนั้นไม่สามารถเข้าถึงคอนโซลและทรัพยากรได้ ตามประวัติเอกสารของคู่มือผู้ใช้ บริการนี้หยุดรับลูกค้าใหม่ตั้งแต่วันที่ 17 ตุลาคม 2024
ตาม Microsoft Learn บริการ Azure AI Anomaly Detector ไม่สามารถสร้างทรัพยากรใหม่ได้ตั้งแต่วันที่ 20 กันยายน 2023 และถูกยุติเมื่อวันที่ 1 ตุลาคม 2026 ทางเลือกในการย้ายระบบที่แนะนำไว้คือ Microsoft Fabric ซึ่งผสาน microsoft/anomaly-detector แบบโอเพนซอร์สไว้ หรือเวอร์ชันโอเพนซอร์ส
ทั้งสองบริการมีระยะเวลาหลายปีตั้งแต่หยุดรับลูกค้าใหม่จนถึงยุติบริการ ถึงกระนั้น โรงงานที่สร้างระบบมอนิเตอร์ไว้บนบริการเหล่านี้ก็ต้องย้ายโมเดล ข้อมูลที่ใช้เรียนรู้ และเงื่อนไขการแจ้งเตือนไปที่อื่น นี่คือเหตุผลที่ประเด็นหลักข้อที่ 3 ของบทความนี้แนะนำให้เขียน “การนำข้อมูลและโมเดลออกเมื่อบริการยุติ” ไว้ใน RFP
เงื่อนไขและการบันทึกการทบทวนเส้นฐาน (การเรียนรู้ใหม่)
เส้นฐานไม่ได้สร้างครั้งเดียวแล้วจบ เมื่อมีการเปลี่ยนเครื่องจักร ระดับของปริมาณการใช้เองก็เปลี่ยนไป นี่คือครึ่งแรกของประเด็นหลักข้อที่ 3
ตามคู่มือของ DOE ให้ทบทวน EnB ในกรณีต่อไปนี้ (1) เมื่อ EnPI ไม่สะท้อนสมรรถนะพลังงานขององค์กรได้อย่างถูกต้องอีกต่อไป (2) เมื่อมีการเปลี่ยนแปลงที่สำคัญในปัจจัยคงที่ กระบวนการ รูปแบบการเดินเครื่อง หรือระบบพลังงาน (3) เมื่อเป็นไปตามวิธีที่กำหนดไว้ล่วงหน้า และต้องเก็บรักษาบันทึกการเปลี่ยนแปลงหรือการปรับปรุง EnB ไว้
เมื่อแปลงเป็นตัวอย่างในโรงงาน สถานการณ์ต่อไปนี้จะเป็นจุดเริ่มต้นของการทบทวน
- มาตรการประหยัดพลังงาน เช่น การเปลี่ยนเป็นคอมเพรสเซอร์หรือชิลเลอร์ประสิทธิภาพสูง และการเปลี่ยนหลอดไฟเป็น LED
- การเพิ่มหรือถอดไลน์ การขยายอาคาร
- การเปลี่ยนแปลงครั้งใหญ่ของสัดส่วนชนิดผลิตภัณฑ์ (เช่น ผลิตภัณฑ์ที่ใช้พลังงานสูงเพิ่มขึ้นหรือลดลง)
- การเปลี่ยนระบบกะหรือปฏิทินวันหยุด
- การเพิ่มจุดวัด หรือการเปลี่ยนมิเตอร์หรือ CT
ในอีกด้านหนึ่ง ABB อธิบายวิธีที่ AI เรียนรู้ใหม่ทุกครั้งที่มีข้อมูลใหม่เข้ามาเพื่อให้เส้นฐานปรับตามไป หากปรับตามโดยอัตโนมัติ ก็จะรองรับการเปลี่ยนแปลงตามอายุของเครื่องจักรได้ง่ายขึ้น แต่เราคิดว่าก็อาจเสี่ยงที่จะรับความสูญเปล่าที่ค่อย ๆ เพิ่มขึ้น (เช่น ลมอัดรั่วที่เพิ่มขึ้นทีละน้อย หรือการสะสมของคราบในเครื่องแลกเปลี่ยนความร้อน) เข้ามาเป็น “ปกติแบบใหม่” ด้วย นี่ไม่ใช่ข้อกล่าวอ้างที่ตรวจสอบจากแหล่งที่มา แต่เป็นการอนุมานของบทความนี้ และด้วยเหตุนี้เอง การบันทึกว่า “เรียนรู้ใหม่เมื่อใด จากเหตุการณ์ใด และใครเป็นผู้อนุมัติ” จึงสำคัญ
ในบทความนี้ เราแนะนำให้แยกการเรียนรู้ใหม่ออกเป็น 2 แบบต่อไปนี้
- การเรียนรู้ใหม่ตามรอบ: ทำตามรอบที่กำหนดไว้ล่วงหน้า เช่น ทุกครั้งที่ครบหนึ่งรอบฤดูกาล ตรงกับข้อ (3) “วิธีที่กำหนดไว้ล่วงหน้า” ในคู่มือของ DOE
- การทบทวนจากเหตุการณ์: ทำเมื่อเกิดการเปลี่ยนแปลงที่ยกมาข้างต้น ตรงกับข้อ (2)
ไม่ว่ากรณีใด ให้เปรียบเทียบความแม่นยำของโมเดล (ตัวชี้วัดในบทก่อน) ก่อนและหลังการเรียนรู้ใหม่ และบันทึกเหตุผลของการเปลี่ยนแปลงและผู้อนุมัติ หากเปลี่ยนเส้นฐานของการตรวจจับความผิดปกติโดยพลการในระหว่างที่กำลังประเมินผลของมาตรการประหยัดพลังงานด้วย M&V ก็อาจเกิดความขัดแย้งกับการประเมินยอดประหยัดได้ เราคิดว่าแนวทางที่ปลอดภัยคือให้ทีมเดียวกันดูแลทั้งสองเรื่อง หรืออย่างน้อยก็มีกลไกแบ่งปันข้อมูลการเปลี่ยนแปลง
ขั้นตอนตรวจสอบสาเหตุ: จากการแจ้งเตือนสู่มาตรการและการบันทึก
สิ่งที่เปลี่ยนการแจ้งเตือนให้เป็นผลลัพธ์คือขั้นตอนตรวจสอบสาเหตุ ในบทความนี้ เราจัดเป็น 6 ขั้นตอนดังนี้
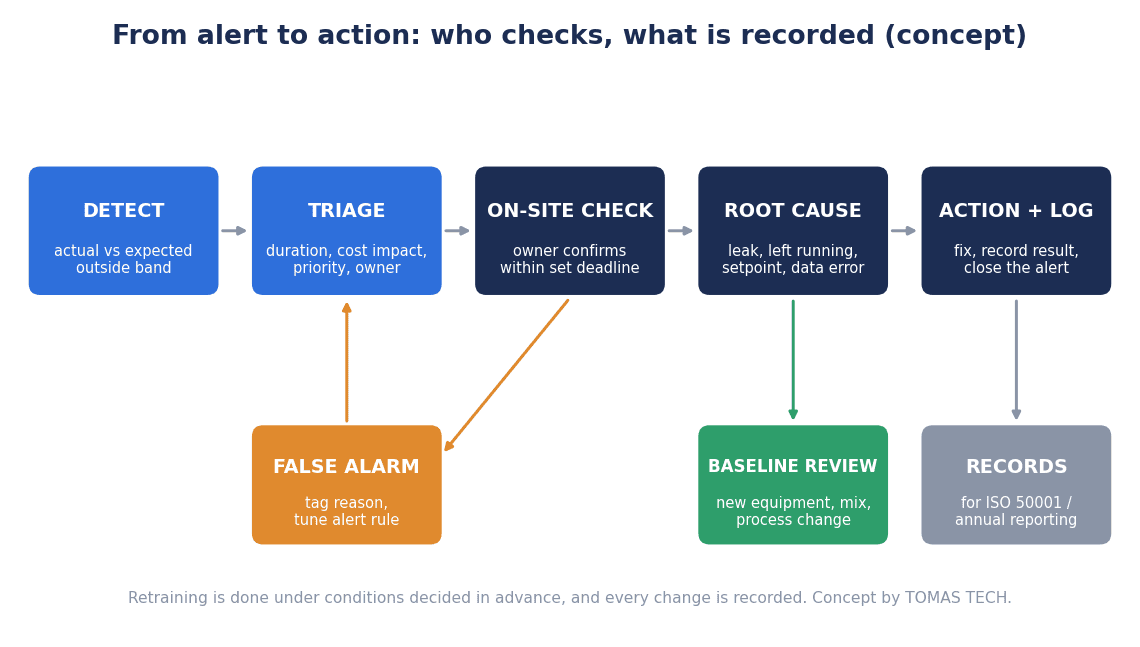
- ตรวจจับ (DETECT): ส่วนต่างจากค่าคาดหวังเกินเงื่อนไขที่กำหนด (ช่วงการทำนาย ระยะเวลาต่อเนื่อง ฯลฯ)
- คัดแยก (TRIAGE): ตัดสินเบื้องต้นบนหน้าจอว่าเป็นเหตุการณ์ที่รู้อยู่แล้ว เช่น การหยุดตามแผนหรือการทดลองเดินเครื่อง เป็นความขัดข้องของการวัด (ข้อมูลขาดหาย ค่าเป็นศูนย์ ข้อมูลซ้ำ) หรือเป็นความผิดปกติของการเดินเครื่องจริง
- ตรวจสอบหน้างาน (ON-SITE CHECK): ผู้รับผิดชอบตรวจสอบที่หน้างานภายในกำหนดเวลา
- จำแนกสาเหตุ (ROOT CAUSE): จำแนกเป็นการลืมปิด การตั้งค่าคลาดเคลื่อน การรั่ว การเสื่อมสภาพของเครื่องจักร ข้อมูลการผลิตผิดพลาด โมเดลผิดพลาด ฯลฯ
- มาตรการ (ACTION): สิ่งที่แก้ได้ทันทีก็แก้ สิ่งที่ต้องลงทุนเครื่องจักรให้ลงทะเบียนเป็นโครงการปรับปรุง
- บันทึกและตัดสินเรื่องการเรียนรู้ใหม่ (LOG / RETRAIN?): บันทึกผล และตัดสินว่าจำเป็นต้องทบทวนเส้นฐานหรือไม่
จุดที่ต้องไปตรวจสอบสาเหตุจะแตกต่างกันไปตามระบบที่เกิดการแจ้งเตือน เช่น หากปริมาณการใช้ของระบบลมอัดไม่ลดลงในเวลากลางคืนหรือวันหยุด จุดที่ต้องตรวจสอบคือลมอัดรั่วหรือการควบคุมจำนวนคอมเพรสเซอร์ที่เดิน การทบทวนการควบคุมจำนวนเครื่องได้กล่าวไว้ใน AI จัดลำดับการเดินคอมเพรสเซอร์ในโรงงานไทย: วิธีเลือกและตรวจรับ หากปริมาณการใช้ของระบบปรับอากาศหรือระบบทำความเย็นสูงเมื่อเทียบกับอุณหภูมิภายนอก จุดที่ต้องตรวจสอบคือสภาพการเดินเครื่องของชิลเลอร์ สำหรับจุดวัดและแนวคิดการเฝ้าติดตามชิลเลอร์ โปรดดู ติดตั้งระบบตรวจชิลเลอร์โรงงาน: จุดวัด kW/ton และ FAT/SAT
สิ่งสำคัญในขั้นตอนนี้คือ ต้องใส่ “โมเดลผิดพลาด” และ “ข้อมูลการผลิตผิดพลาด” ไว้ใน “การจำแนกสาเหตุ” ข้อที่ 4 เสมอ เราคิดว่าเมื่อใช้งานการตรวจจับความผิดปกติจริง การแจ้งเตือนส่วนหนึ่งจะไม่ใช่ความสูญเปล่า แต่มาจากการกรอกปริมาณการผลิตตกหล่นหรือสภาวะการเดินเครื่องที่โมเดลไม่รู้จัก หากบันทึกไว้ก็จะนำไปสู่การเพิ่มตัวแปรอธิบายหรือการปรับปรุงการเชื่อมต่อข้อมูลได้ ในทางกลับกัน หากไม่บันทึก การแจ้งเตือนผิดพลาดแบบเดิมก็จะเกิดซ้ำและหน้างานจะหมดความเชื่อถือ
เราแนะนำให้บันทึกอย่างน้อย “วันเวลาและระบบที่เกิดการแจ้งเตือน” “ส่วนต่างระหว่างค่าคาดหวังกับค่าจริง” “ผู้ตรวจสอบและวันที่ตรวจสอบ” “การจำแนกสาเหตุ” “มาตรการและวันที่เสร็จ” และ “ความจำเป็นในการเรียนรู้ใหม่” ดังที่จะกล่าวต่อไป ในโรงงานควบคุมของไทย ผู้รับผิดชอบด้านพลังงาน (ผชร.) มีบทบาทในการเฝ้าติดตามประสิทธิภาพของเครื่องจักรเป็นประจำ และเราคิดว่าบันทึกนี้จะเป็นหลักฐานสนับสนุนกิจกรรมดังกล่าวได้ด้วย
ประเด็นเฉพาะของไทย: โรงงานควบคุม ดีมานด์ 15 นาที และค่า Ft
เกณฑ์ของโรงงานควบคุมและหน้าที่ของ ผชร.
ภายใต้พระราชบัญญัติการส่งเสริมการอนุรักษ์พลังงาน (ENCON Act) ของไทย โรงงานที่มีขนาดตั้งแต่ระดับหนึ่งขึ้นไปจะถูกจัดเป็น “โรงงานควบคุม” ตามเอกสารเผยแพร่ของกรมพัฒนาพลังงานทดแทนและอนุรักษ์พลังงาน (พพ. หรือ DEDE) ลงวันที่ 28 กุมภาพันธ์ 2023 โรงงานควบคุมกลุ่มที่ 1 คือโรงงานที่มีขนาดมิเตอร์ไฟฟ้าตามสัญญา 1,000 ถึง 3,000 kW หรือหม้อแปลง 1,175 ถึง 3,530 kVA หรือใช้พลังงานต่อปี 20 ถึง 60 TJ ส่วนกลุ่มที่ 2 คือโรงงานที่เกินกว่านั้น โรงงานที่มีมิเตอร์ไฟฟ้าต่ำกว่า 1,000 kW หม้อแปลงต่ำกว่า 1,175 kVA และใช้พลังงานต่อปีต่ำกว่า 20 TJ จัดอยู่ในกลุ่มที่ไม่ใช่โรงงานควบคุม (SME)
ตามเอกสารเดียวกัน โรงงานควบคุมต้องแต่งตั้งผู้รับผิดชอบด้านพลังงาน (ผชร. หรือ PRE: Person Responsible for Energy) กลุ่มที่ 1 อย่างน้อย 1 คน (C-PRE) กลุ่มที่ 2 อย่างน้อย 2 คน โดย 1 คนเป็นผู้รับผิดชอบด้านพลังงานอาวุโส (S-PRE) ต้องดำเนินระบบการจัดการพลังงานตามกฎระเบียบ และส่งรายงานประจำปีที่ผ่านการตรวจสอบและรับรองโดยผู้ตรวจสอบพลังงานให้ DEDE ภายในเดือนมีนาคมของทุกปี หน้าที่ของ ผชร. รวมถึงการบำรุงรักษาและเฝ้าติดตามประสิทธิภาพของเครื่องจักรและอุปกรณ์เป็นประจำ การปรับปรุงตามมาตรการอนุรักษ์พลังงาน และการช่วยเจ้าของในการดำเนินระบบการจัดการพลังงาน
เมื่อพิจารณาว่าใครควรรับการแจ้งเตือนความผิดปกติด้านพลังงาน เราคิดว่า ผชร. เป็นผู้รับที่เหมาะสมโดยธรรมชาติคนหนึ่ง อย่างไรก็ตาม หากรวมการแจ้งเตือนทั้งหมดไว้ที่ ผชร. คนเดียว การตรวจสอบหน้างานจะทำไม่ทัน การแบ่งงานที่เป็นไปได้จริงคือ ให้ ผชร. ดูแลการสรุปและตรวจสอบแนวโน้ม ส่วนการตรวจสอบหน้างานแต่ละรายการให้เป็นของผู้รับผิดชอบเครื่องจักรในแต่ละพื้นที่
ค่าไฟกำหนดจากความต้องการพลังไฟฟ้าเฉลี่ย 15 นาที
ตามตารางอัตราค่าไฟฟ้าของ PEA (ภาษาอังกฤษ ฉบับแปลไม่เป็นทางการ ฉบับเดือนพฤษภาคม 2023) ประเภทกิจการขนาดใหญ่ (Schedule 4 Large General Service) คือผู้ประกอบการหรือโรงงานที่มีค่าสูงสุดของความต้องการพลังไฟฟ้าเฉลี่ย 15 นาทีตั้งแต่ 1,000 kW ขึ้นไป หรือมีปริมาณการใช้เฉลี่ย 3 เดือนล่าสุดเกิน 250,000 kWh ต่อเดือน ส่วนประเภทกิจการขนาดกลาง (Schedule 3) คือ 30 kW ขึ้นไปแต่ต่ำกว่า 1,000 kW เนื่องจากค่าความต้องการพลังไฟฟ้ากำหนดจากค่าสูงสุดของค่า 15 นาที เราคิดว่าการตั้งความละเอียดต่ำสุดของการตรวจจับความผิดปกติไว้ที่ค่า 15 นาทีจะช่วยให้เทียบกับค่าไฟได้ง่าย ทั้งนี้ ราคาต่อหน่วยในตารางอัตราค่าไฟฟ้าเป็นค่าของฉบับปี 2023 และยังไม่สะท้อนการปรับปรุงหลังจากนั้น บทความนี้จึงไม่อ้างอิง แนวคิดในการควบคุมเพื่อกดความต้องการพลังไฟฟ้าสูงสุด ได้อธิบายไว้ใน ควบคุมพีคดีมานด์ 2026: ในไทยยอดพีควัดที่ 15 นาที ไม่ใช่ 30 นาที
ตรวจสอบค่า Ft และค่าไฟตามค่าที่รายงานในข่าวตามที่เป็น
ดังที่กล่าวไว้ในบทนำ มีรายงานว่าค่า Ft สำหรับรอบบิลเดือนกันยายนถึงธันวาคม 2026 อยู่ที่ 16.23 สตางค์/kWh และค่าไฟเฉลี่ยคงไว้ที่ 3.95 บาท/kWh (ไม่รวม VAT) ค่าประมาณ 3.89 บาทของรอบบิลเดือนกันยายนถูกรายงานว่าเป็นค่าสำหรับผู้ใช้ไฟทั่วไป และเรายังตรวจสอบไม่ได้ว่าใช้กับผู้ใช้ภาคอุตสาหกรรมหรือตั้งแต่เดือนตุลาคมเป็นต้นไปหรือไม่ หากแปลงความคลาดเคลื่อนของความผิดปกติเป็นมูลค่าเงิน โปรดใช้ประเภทสัญญาของบริษัทและค่าจริงจากใบแจ้งค่าไฟ ไม่ใช่ค่าเฉลี่ยในข่าว เราคิดว่าแม้ราคาต่อหน่วยจะเปลี่ยนแปลง หากดูความคลาดเคลื่อนของ “ปริมาณ” kWh จากส่วนต่างกับค่าคาดหวังไว้ ก็จะแยกการเปลี่ยนแปลงของค่าไฟออกจากการเกิดความสูญเปล่าได้
เงินอุดหนุนและสิทธิประโยชน์ต้องตรวจสอบเป็นรายกรณี
สำหรับเงินอุดหนุนอุปกรณ์ประหยัดพลังงานและสิทธิประโยชน์การลงทุนของ BOI จากการสำรวจของบทความนี้ ไม่พบเอกสารที่ยืนยันได้ว่าซอฟต์แวร์เฝ้าติดตามพลังงานหรือตรวจจับความผิดปกติอยู่ในขอบเขตที่ได้รับสิทธิ์ ระบบเหล่านี้อาจมีการแก้ไข ดังนั้นหากพิจารณาจะใช้ จำเป็นต้องตรวจสอบเงื่อนไขล่าสุดกับ DEDE หรือ BOI
รายการที่ต้องเขียนใน RFP
ต่อไปจะนำประเด็นทั้งหมดที่กล่าวมาสรุปลงเป็นรายการใน RFP นี่คือครึ่งหลังของประเด็นหลักข้อที่ 3 วิธีจัดทำ RFP และ FAT/SAT สำหรับระบบเฝ้าติดตามพลังงานโดยรวม ได้อธิบายไว้ใน ระบบติดตามพลังงานโรงงานไทย: RFP และการตรวจรับ FAT/SAT ในที่นี้จะเน้นรายการที่เฉพาะสำหรับการตรวจจับความผิดปกติ
| รายการ | เนื้อหาที่เขียนใน RFP | เหตุผลที่ต้องตรวจสอบ |
|---|---|---|
| ขอบเขตและจุดวัด | อาคาร ไลน์ และระบบสาธารณูปโภคที่อยู่ในขอบเขต รายการจุดวัด และรวมพลังงานอื่นนอกจากไฟฟ้า (ลมอัด ไอน้ำ ก๊าซ น้ำ) หรือไม่ | เป็นตัวกำหนดว่าจะระบุสาเหตุของความผิดปกติได้ถึงระดับระบบหรือไม่ |
| ความละเอียด | ความละเอียดในการเก็บข้อมูล (เช่น 15 นาที) ความละเอียดในการคำนวณค่าคาดหวัง และความละเอียดในการตัดสินการแจ้งเตือน | ทำให้แนวคิดเรื่องค่าไฟสอดคล้องกับการจัดการทางสถิติ |
| ตัวแปรอธิบาย | ตัวแปรที่นำเข้า เช่น ปริมาณการผลิต ชนิดผลิตภัณฑ์ ชั่วโมงเดินเครื่อง อุณหภูมิภายนอก และการแยกวันหยุด แหล่งนำเข้า (MES, ERP, ข้อมูลอุตุนิยมวิทยา) และความถี่ในการนำเข้า | เป็นที่มาของปริมาณการใช้ที่คาดหวัง |
| ช่วงเวลาของเส้นฐานและเงื่อนไขการทบทวน | ช่วงเวลาที่ใช้เรียนรู้ ขอบเขตสภาวะการเดินเครื่องที่ครอบคลุม รอบการเรียนรู้ใหม่ตามรอบ เงื่อนไขการทบทวนจากเหตุการณ์ และขั้นตอนการอนุมัติ | รองรับการทบทวน EnB และการเก็บรักษาบันทึก |
| การรายงานความแม่นยำ | ตัวชี้วัด เช่น CV(RMSE) ความเอนเอียง และ R² ช่วงเวลาและหน่วยในการคำนวณ และความถี่ในการรายงาน | ให้บริษัทตรวจสอบสถานะของโมเดลได้เอง |
| การทำความสะอาดข้อมูล | การจัดการค่าผิดปกติ เหตุการณ์ที่ไม่เป็นประจำ ข้อมูลขาดหาย และข้อมูลซ้ำ และการบันทึกช่วงเวลาที่ตัดออก | ไม่ให้โมเดลเรียนรู้ความผิดปกติว่าเป็นเรื่องปกติ |
| เงื่อนไขการแจ้งเตือนและผู้รับ | ช่วงการทำนาย ระยะเวลาต่อเนื่อง การแปลงเป็นมูลค่าเงิน ลำดับความสำคัญ เงื่อนไขระงับการแจ้งเตือน ช่องทางและผู้รับการแจ้งเตือน และผู้ที่มีสิทธิ์เปลี่ยนเงื่อนไข | จัดการจำนวนและเนื้อหาของการแจ้งเตือน |
| ผู้รับผิดชอบตรวจสอบและเวิร์กโฟลว์ | ผู้รับผิดชอบตรวจสอบและกำหนดเวลา รายการการจำแนกสาเหตุ บันทึกมาตรการและการเสร็จสิ้น และการสรุปจำนวนรายเดือน | ทำให้การดำเนินงานที่ให้คนตรวจสอบสาเหตุเป็นระบบ |
| คำอธิบายค่าคาดหวัง | แสดงค่าของตัวแปรที่เป็นที่มาของค่าคาดหวังสำหรับแต่ละการแจ้งเตือนได้หรือไม่ | หน้างานยอมรับและลงมือตรวจสอบได้ |
| ความเป็นเจ้าของและการนำข้อมูลและโมเดลออก | ผู้เป็นเจ้าของข้อมูลการวัด โมเดลที่เรียนรู้แล้ว การตั้งค่าโมเดลและนิยามของตัวแปรอธิบาย และประวัติการแจ้งเตือนและการตรวจสอบ รูปแบบไฟล์และกำหนดเวลาในการส่งออกเมื่อสิ้นสุดสัญญาหรือเมื่อบริการยุติ | เตรียมรับมือการยุติบริการคลาวด์ |
| ระยะเวลาเก็บรักษา | ระยะเวลาเก็บรักษาข้อมูลดิบ ค่าคาดหวัง การแจ้งเตือน และบันทึกการตรวจสอบ | ใช้สำหรับรายงานประจำปีและการเปรียบเทียบกับอดีต |
| รายละเอียดค่าใช้จ่าย | ค่าใช้จ่ายในการสร้างระบบเริ่มต้น อุปกรณ์วัด ไลเซนส์ การใช้คลาวด์ การเรียนรู้ใหม่และการบำรุงรักษา และค่าใช้จ่ายต่อจุดวัดที่เพิ่ม | ไม่มองข้ามค่าใช้จ่ายในช่วงการใช้งาน |
ประเด็นที่ควรระวังเป็นพิเศษคือ “ความเป็นเจ้าของและการนำข้อมูลและโมเดลออก” ดังที่เห็นในบทก่อน บริการตรวจจับความผิดปกติบนคลาวด์อาจยุติได้ โมเดลที่เรียนรู้แล้วอาจไม่สามารถนำไปรันในสภาพแวดล้อมอื่นได้เสมอไป แต่อย่างน้อยหากมีนิยามของตัวแปรอธิบาย ข้อมูลและช่วงเวลาที่ใช้เรียนรู้ ช่วงเวลาที่ตัดออก เงื่อนไขการแจ้งเตือน และประวัติการตรวจสอบ ก็จะสร้างใหม่บนระบบอื่นได้ เราแนะนำให้จัดสิ่งเหล่านี้ให้อยู่ในรูปแบบที่บริษัทรับมอบเป็นของตนเองได้ตามสัญญา
การออกแบบ PoC และการทดสอบรับมอบ (FAT/SAT)
เมื่อกำหนดข้อกำหนดใน RFP แล้ว ก็ตรวจสอบผ่าน PoC และการทดสอบรับมอบ หลักการในที่นี้ก็คือ “บริษัทกำหนดเกณฑ์ผ่านเอง” จากการสำรวจของบทความนี้ ไม่พบเกณฑ์สาธารณะที่กำหนดผลผ่านหรือไม่ผ่านของการตรวจจับความผิดปกติใน FAT/SAT เป็นตัวเลข ต่อไปนี้เป็นตัวอย่างของแนวคิด
การตรวจสอบด้วยข้อมูลในอดีต
PoC แรกควรทำด้วยข้อมูลในอดีตจึงจะมีประสิทธิภาพ สร้างโมเดลด้วยข้อมูลในช่วงที่ครอบคลุมฤดูกาล แล้วนำไปใช้กับอีกช่วงเวลาหนึ่งเพื่อดูว่าการแจ้งเตือนเกิดขึ้นที่ใด ในขั้นนี้ต้องรวม เหตุการณ์ในอดีตที่บริษัทรู้อยู่แล้ว ไว้เสมอ เช่น ช่วงที่พบลมอัดรั่วและซ่อมแล้ว ช่วงที่ตั้งค่าเครื่องปรับอากาศผิด และวันหยุดที่ลืมปิดไลน์ แล้วบันทึกเป็นจำนวนครั้งว่าเหตุการณ์เหล่านี้ถูกตรวจจับได้หรือไม่ (มีการตรวจจับพลาดหรือไม่) และในช่วงอื่นมีการแจ้งเตือนเกิดขึ้นเท่าใด (มีการแจ้งเตือนผิดพลาดเท่าใด)
ดังที่ผลของ LEAD1.0 แสดง Precision และ Recall เปลี่ยนแปลงแยกกัน ใน PoC เราแนะนำให้นับทั้ง “การแจ้งเตือนที่ตรวจสอบแล้วมีความหมาย” และ “เหตุการณ์ที่รู้อยู่แล้วที่จับได้” จะให้น้ำหนักด้านใดมากกว่าขึ้นอยู่กับกำลังคนที่ใช้ตรวจสอบได้และความสูญเสียเมื่อตรวจจับพลาด สิ่งสำคัญคือต้องกำหนดเกณฑ์ผ่านก่อนเริ่ม PoC และไม่ขยับเกณฑ์ตามความสะดวกหลังจบ วิธีดำเนิน PoC การตรวจจับความผิดปกติของเครื่องจักร ดูเพิ่มเติมได้ที่ การตรวจจับความผิดปกติของเครื่องจักร PoC: เกณฑ์รับมอบ 90 วันสำหรับโรงงานไทย
การทดสอบที่รวมการดำเนินงาน
ไม่ใช่เฉพาะประสิทธิภาพเท่านั้น ขั้นตอนการดำเนินงานก็เป็นเป้าหมายของการทดสอบด้วย ใน FAT ให้ตรวจสอบว่าการนำเข้าตัวแปรอธิบาย การคำนวณค่าคาดหวัง การตั้งค่าและเปลี่ยนเงื่อนไขการแจ้งเตือน การแจ้งเตือน การกรอกบันทึกการตรวจสอบ และการส่งออกข้อมูลและโมเดล ทำงานตามข้อกำหนดหรือไม่ ใน SAT ให้ตรวจสอบในสภาพที่เชื่อมต่อกับจุดวัดจริง ทั้งพฤติกรรมของระบบเมื่อเวลาคลาดเคลื่อนหรือข้อมูลขาดหาย การระงับการแจ้งเตือนระหว่างหยุดตามแผน และการแจ้งเตือนถึงผู้รับผิดชอบตรวจสอบได้ตรงตามกำหนดเวลาหรือไม่
นอกจากนี้ เราแนะนำให้ ลองทบทวนเส้นฐานจริงหนึ่งครั้ง ระหว่างการทดสอบ หากตรวจสอบไว้ว่าตัวชี้วัดความแม่นยำเปลี่ยนไปอย่างไรก่อนและหลังการทบทวน และมีการบันทึกเหตุผลของการเปลี่ยนแปลงและผู้อนุมัติหรือไม่ เมื่อเปลี่ยนเครื่องจักรในการใช้งานจริงก็จะไม่ต้องตื่นตระหนก ในทำนองเดียวกัน แนวทางที่ปลอดภัยคือตรวจสอบหนึ่งครั้งในขั้นรับมอบว่าส่งออกข้อมูลและโมเดลในรูปแบบที่กำหนดไว้ในสัญญาได้หรือไม่
คำถามที่พบบ่อย
ตรวจจับความผิดปกติด้านพลังงานจำเป็นต้องใช้ AI ไหม ใช้ค่าเกณฑ์ไม่ได้หรือ?
สำหรับเครื่องจักรที่ปริมาณการใช้ไม่ค่อยเปลี่ยนตามปริมาณการผลิตหรืออุณหภูมิภายนอก ค่าเกณฑ์แบบคงที่ก็อาจใช้ได้ในบางกรณี อย่างไรก็ตาม ตามที่คู่มือของ DOE ระบุ เมื่อมีตัวแปรที่เกี่ยวข้องจะประเมินด้วยปริมาณการใช้เองไม่ได้ และจำเป็นต้องปรับค่าให้เป็นมาตรฐาน ABB ก็อธิบายว่าค่าเกณฑ์ที่ตั้งด้วยมือต้องปรับปรุงอยู่เสมอตามอายุของเครื่องจักร เราคิดว่าสิ่งสำคัญไม่ใช่ชื่อว่าเป็น AI หรือการถดถอย แต่อยู่ที่ว่าได้เปรียบเทียบกับค่าคาดหวังที่ใส่ตัวแปรที่เกี่ยวข้องไว้หรือไม่
ควรสร้างเส้นฐานจากข้อมูลช่วงเวลานานเท่าไร?
ตามคู่มือของ BPA หากได้รับผลจากสภาพอากาศ โดยทั่วไปจะใช้ 12 เดือนหรือ 24 เดือน และต้องครอบคลุมสภาวะการเดินเครื่องทั้งหมด ในสภาพแวดล้อมการผลิต ให้เลือกช่วงเวลาที่การผลิตมีความสม่ำเสมอ หากเริ่มจากช่วงเวลาสั้น เราแนะนำให้ถือเป็นโมเดลชั่วคราว และวางแผนไว้ล่วงหน้าว่าจะสร้างใหม่เมื่อครบหนึ่งรอบฤดูกาล ทั้งนี้ Mitsubishi Electric อธิบายว่าการเฝ้าติดตามด้วย AI ของ EcoAdviser ต้องใช้ข้อมูลย้อนหลังประมาณ 30 วัน ช่วงเวลาที่จำเป็นแตกต่างกันไปตามผลิตภัณฑ์และวัตถุประสงค์ จึงต้องตรวจสอบใน RFP
การปรับค่า EnPI ให้เป็นมาตรฐานคืออะไร?
คือการเปรียบเทียบสมรรถนะพลังงานหลังจากทำให้ความแตกต่างของตัวแปรที่เกี่ยวข้อง เช่น ปริมาณการผลิตและอุณหภูมิภายนอก อยู่บนฐานเดียวกันแล้ว ตามคู่มือของ DOE EnPI มีได้ในรูปแบบตัวชี้วัดเดี่ยว อัตราส่วน (การใช้พลังงานต่อหน่วยผลผลิต) และแบบจำลองเชิงตัวเลขที่พิจารณาตัวแปรที่เกี่ยวข้อง และเมื่อมีตัวแปรที่เกี่ยวข้องก็ควรปรับค่าให้เป็นมาตรฐาน กล่าวได้ว่าเส้นฐานของการตรวจจับความผิดปกติคือการนำแนวคิดการปรับค่าให้เป็นมาตรฐานนี้มาใช้กับการเฝ้าติดตามประจำวัน
ถ้ามีการแจ้งเตือนผิดพลาดมากควรทำอย่างไร?
ขั้นแรก ให้บันทึกจำนวนการแจ้งเตือนและผลการตรวจสอบ แล้วจำแนกสาเหตุ จุดที่ต้องแก้ไขจะต่างกันไปตามว่าสาเหตุของการแจ้งเตือนผิดพลาดคือการกรอกข้อมูลการผลิตตกหล่น สภาวะการเดินเครื่องที่โมเดลไม่รู้จัก หรือความขัดข้องของการวัด มาตรการที่เป็นไปได้ เช่น เพิ่มตัวแปรอธิบาย เพิ่มเงื่อนไขระงับการแจ้งเตือนระหว่างหยุดตามแผน และทบทวนเงื่อนไขระยะเวลาต่อเนื่อง หากเปลี่ยนเงื่อนไข ให้บันทึกเหตุผลและวันที่ของการเปลี่ยนแปลงไว้
ถ้าบริการคลาวด์ยุติจะเกิดอะไรขึ้น?
Amazon Lookout for Equipment สิ้นสุดการสนับสนุนเมื่อวันที่ 7 ตุลาคม 2026 และ Azure AI Anomaly Detector ถูกยุติเมื่อวันที่ 1 ตุลาคม 2026 หลังการยุติจะไม่สามารถรันโมเดลบนบริการนั้นได้อีก หากบริษัทถือนิยามของตัวแปรอธิบาย ข้อมูลและช่วงเวลาที่ใช้เรียนรู้ เงื่อนไขการแจ้งเตือน และประวัติการตรวจสอบไว้เอง ก็จะสร้างใหม่บนระบบอื่นได้ เราแนะนำให้กำหนดความเป็นเจ้าของและรูปแบบการส่งออกของสิ่งเหล่านี้ไว้ใน RFP
สรุป
- เมื่อจะนำ AI มาใช้ตรวจจับความผิดปกติการใช้พลังงานในโรงงาน สิ่งที่ต้องตัดสินใจก่อนไม่ใช่ชื่ออัลกอริทึม แต่เป็น 3 เรื่อง ได้แก่ (1) จะเทียบกับอะไรเพื่อบอกว่าผิดปกติ (2) แยกเกณฑ์ความแม่นยำของโมเดลออกจากวิธีส่งการแจ้งเตือน และดำเนินงานโดยให้คนตรวจสอบสาเหตุ (3) เขียนเงื่อนไขการทบทวนและการนำข้อมูลกับโมเดลออกไว้ใน RFP แล้วตรวจสอบผ่าน PoC และ FAT/SAT
- ตามคู่มือของ DOE เมื่อมีตัวแปรที่เกี่ยวข้อง จะใช้ปริมาณการใช้พลังงานเองเป็น EnPI ไม่ได้ และจำเป็นต้องปรับค่าให้เป็นมาตรฐาน จุดเริ่มต้นคือการดูส่วนต่างจากปริมาณการใช้ที่คาดหวัง (เส้นฐาน)
- เกณฑ์อ้างอิงของเส้นฐานการถดถอยตาม ASHRAE Guideline 14-2014 (อ้างอิงโดยบทความของ EVO: CV(RMSE) 20% หากข้อมูลช่วงรายงานน้อยกว่า 12 เดือน และ 25% หากเป็น 12 ถึง 60 เดือน) เป็นเกณฑ์อ้างอิงความแม่นยำของโมเดล ไม่ใช่เกณฑ์ผ่านของการแจ้งเตือน
- ใน LEAD1.0 ซึ่งประเมินวิธีสำเร็จรูปแบบไม่มีผู้สอน 8 วิธีด้วยค่ารายชั่วโมงตลอด 1 ปีจากมิเตอร์ของอาคารพาณิชย์ 1,413 ตัว Precision สูงที่ 0.895 ถึง 0.902 แต่ Recall อยู่ที่ 0.258 ถึง 0.284 อย่าประเมิน AI ด้วยตัวเลขเพียงตัวเดียว และให้นับการตรวจจับพลาดกับการแจ้งเตือนผิดพลาดแยกกัน
- การทบทวนเส้นฐานต้องกำหนดเงื่อนไขและบันทึกไว้ บริการตรวจจับความผิดปกติบนคลาวด์ยุติลงต่อเนื่องกันในปี 2026 การกำหนดเรื่องการนำข้อมูลและโมเดลออกไว้ในสัญญาจึงมีความสำคัญ
แม้อยู่ในขั้นสำรวจข้อมูลการวัดที่มีอยู่ หรือกำลังพิจารณาว่าจะสร้างเส้นฐานจากตัวแปรใดได้บ้าง ก็สามารถปรึกษา TOMAS TECH ได้ ติดต่อเราได้ที่นี่
แหล่งอ้างอิง
- DEDE “Thailand’s Energy Efficiency” 28 กุมภาพันธ์ 2023 (เผยแพร่บนเว็บไซต์ NEDO, PDF) https://www.nedo.go.jp/content/100959493.pdf
- The Nation “Power tariff held at 3.95 baht through year-end” 23 กรกฎาคม 2026 https://www.nationthailand.com/news/general/40068945
- The Nation “Thailand cuts September power tariff, caps first 200 units at 3 baht” 12 สิงหาคม 2026 https://www.nationthailand.com/news/general/40069705
- The Nation “Thailand’s energy consumption rises 2.1% on 2.8% GDP growth” 1 กรกฎาคม 2026 https://www.nationthailand.com/business/economy/40068117
- PEA “Electricity Tariffs” ฉบับพฤษภาคม 2023 (ภาษาอังกฤษ ฉบับแปลไม่เป็นทางการ, PDF) https://www.pea.co.th/sites/default/files/documents/tariff/EN_Electricity_Tariffs_May_2023.pdf
- ISO “ISO 50001:2018” https://www.iso.org/standard/69426.html
- U.S. DOE 50001 Ready Navigator “Task 11: Energy Performance Indicators and Energy Baselines” https://navigator.lbl.gov/guidance/task/11
- DIN Media “DIN ISO 50006” https://www.dinmedia.de/de/norm/din-iso-50006/384067911
- ISO “ISO 50015:2014” https://www.iso.org/standard/60043.html
- EVO M&V Focus Issue #10, John Avina “Relaxing CV(RMSE) requirements for Option C M&V regressions” ตุลาคม 2022 https://evo-world.org/en/m-v-community/mv-focus/903-m-v-focus-issue-no-10/1338-relaxing-cv-rmse-requirements-for-option-c-m-v-regressions
- Bonneville Power Administration “Regression for M&V: Reference Guide” Version 3.0, พฤษภาคม 2024 (PDF) https://www.bpa.gov/-/media/Aep/energy-efficiency/measurement-verification/3-bpa-mv-regression-reference-guide.pdf
- EVO “NRA / NRE” หน้าคณะกรรมการ IPMVP https://evo-world.org/en/about-en/organization/ipmvp-committee/nra-nre
- Schneider Electric “EcoStruxure Power Monitoring Expert 2023” Use Model Report https://product-help.schneider-electric.com/EcoStruxure/Power-Monitoring-Expert-2023/content/6_operating/webapps/reports/energyanalysis/usemodel_report.htm
- Schneider Electric “EcoStruxure Power Monitoring Expert 2023” Create Model Report https://product-help.schneider-electric.com/EcoStruxure/Power-Monitoring-Expert-2023/content/6_operating/webapps/reports/energyanalysis/createmodel_report.htm
- Siemens “SIMATIC Energy Manager PRO / Energy Analytics” ภาคผนวกของใบรับรอง (PDF) https://assets.new.siemens.com/siemens/assets/api/uuid:90799adf-4e2c-42fa-885c-082bc7cabe74/certificate-no–c-09-2020-21250307.pdf
- AWS “Amazon Lookout for Equipment” https://aws.amazon.com/lookout-for-equipment/
- AWS “Amazon Lookout for Equipment” ประวัติเอกสารของคู่มือผู้ใช้ https://docs.aws.amazon.com/lookout-for-equipment/latest/ug/doc-history.html
- Microsoft Learn “Azure AI Anomaly Detector” หน้าภาพรวม https://learn.microsoft.com/en-us/azure/ai-services/anomaly-detector/overview
- ABB “Celebrating Earth Day with AI/ML energy management innovation” https://new.abb.com/news/detail/124636/celebrating-earth-day-with-aiml-energy-management-innovation
- Mitsubishi Electric แอปพลิเคชันสนับสนุนการประหยัดพลังงาน “EcoAdviser” (ภาษาญี่ปุ่น) https://www.mitsubishielectric.co.jp/fa/products/software/ems/eap/index.html
- Gulati, Arjunan “LEAD1.0” arXiv 2203.17256, 30 มีนาคม 2022 https://arxiv.org/abs/2203.17256
- Himeur และคณะ (บทความทบทวนการตรวจจับความผิดปกติของการใช้พลังงานในอาคารด้วย AI) arXiv 2010.04560, Applied Energy Vol.287, ปี 2021 https://arxiv.org/abs/2010.04560
- Iturralde Carrera และคณะ “Intelligent Computational Modeling of ISO 50001 Energy Performance Indicators for Sustainable Energy Management Systems: A Systematic Review” (DOI 10.3390/a19070533) https://www.citedrive.com/en/discovery/intelligent-computational-modeling-of-iso-50001-energy-performance-indicators-for-sustainable-energy-management-systems-a-systematic-review/
- Mendia, Gil-Lopez, Grau, Del Ser “A novel approach for the detection of anomalous energy consumption patterns in industrial cyber-physical systems” Expert Systems 41(2), กุมภาพันธ์ 2024 https://dsp.tecnalia.com/items/f7c96e3b-ba08-4afd-9af0-19f4e6074604/full
- Emerson “Alarm Management by the Numbers” (PDF) https://d1-live.emerson.com/documents/automation/article-alarm-management-by-numbers-deltav-en-38292.pdf


