


เมื่อต้องการ “นำ AI มาใช้วิเคราะห์สัญญาณเตือนอุปกรณ์” ในภาคการผลิต ประเด็นแรกที่ต้องเผชิญไม่ใช่การทำนายความเสียหายล่วงหน้า แต่คือ ปริมาณสัญญาณเตือนจำนวนมากที่แสดงก่อนและหลังหยุดเครื่อง ซึ่งหน้างานมักยากที่จะวินิจฉัยได้ภายในเวลาสั้นๆ ว่าอันไหนเป็นต้นเหตุ อันไหนเป็นผลตามมา บทความนี้จะอธิบายวิธีการนำ AI มาประยุกต์ใช้อย่างเป็นรูปธรรม โดยเชื่อมโยงประวัติสัญญาณเตือน สถานะอุปกรณ์ และบันทึกการทำงาน พร้อมแนะแนวทางเสนอ “สาเหตุที่ควรตรวจสอบ” และลำดับการตรวจสอบโดย AI ทุกการตัดสินใจด้านความปลอดภัยยังคงต้องอิงกฎการออกแบบสัญญาณเตือนและขั้นตอนปฏิบัติเดิม AI มีบทบาทเพียงช่วยในการสอบสวนข้อเท็จจริงเท่านั้น
ปัญหาที่ AI วิเคราะห์สัญญาณเตือนอุปกรณ์ต้องแก้
เมื่ออุปกรณ์หยุดทำงาน จะมีการแจ้งเตือนต่างๆ เช่น มอเตอร์กระแสสูง การขนย้ายติดขัด การรอด้านปลายน้ำ หรือปัญหาการสื่อสาร ขึ้นที่ HMI พร้อมกัน หากอ่านแค่จากบนลงล่างและเลือกอันแรกที่เห็นมาเป็น “สาเหตุ” อาจทำให้เข้าใจผิดโดยเลือกสัญญาณเตือนรองตามหลังเหตุการณ์จริง ในทางกลับกัน ถ้าเลือกแต่สัญญาณที่เกิดขึ้นแรกสุดตามเวลาอย่างเดียวก็ไม่ปลอดภัย เพราะอาจมีปัญหาอย่างเช่น เวลาของแต่ละอุปกรณ์ไม่ตรงกัน เกิดดีเลย์ในการบันทึกข้อมูล หรืออีเวนต์ที่เกิดเป็นสัญญาณล่วงหน้าอาจต่างจากปัจจัยที่ทำให้หยุดจริง
วิธีแก้คือเปลี่ยนหน่วยในการวิเคราะห์จาก “สัญญาณเตือนเดี่ยว” ไปเป็น “กลุ่มเหตุการณ์ของอุปกรณ์” โดยคงสถานะ เช่น เริ่มต้น-กลับสู่ปกติ-ผ่านการตรวจสอบ-รีเซ็ต และจัดกลุ่มเหตุการณ์ก่อนและหลังหยุดโดยอิงระบบอุปกรณ์และกระบวนการ AI จะเปรียบเทียบกับเคสใกล้เคียงในอดีต ดูลำดับการเกิดสัญญาณเตือน ค่าเซ็นเซอร์ ข้อมูลที่ป้อนในใบงาน และเสนอ “สาเหตุที่ควรตรวจสอบ” พร้อมเหตุผลแนบ ผู้รับผิดชอบหน้างานยังต้องเป็นผู้ยืนยันสาเหตุสุดท้าย ดำเนินการแก้ไข และตัดสินใจรีสตาร์ทไลน์
การใช้งานนี้ต่างจาก Predictive Maintenance และ Anomaly Detection โดยสิ้นเชิง Predictive Maintenance คือการคาดคะเนความเสียหายในอนาคต ส่วน Anomaly Detection คือการหาพฤติกรรมที่ผิดปกติจากปกติ ขณะที่การวิเคราะห์สัญญาณเตือนนี้คือการ “ถอดรหัส” เหตุการณ์ที่เกิดขึ้นแล้วหรือกำลังเกิดขึ้น และจัดลำดับการดำเนินการ ไม่ใช่การแทนที่ AI เข้ากับการตั้งค่า Alarm/Interlock เพื่อความปลอดภัยแต่อย่างใด
HSE สหราชอาณาจักรได้กล่าวว่า สัญญาณเตือนควรดึงความสนใจผู้ปฏิบัติไปยังสถานะที่ถูกต้อง และแจ้งให้รู้การกระทำที่จำเป็น ขณะที่ ISA-18.2 ก็ระบุให้จัดหมวดหมู่ความสำคัญ ประวัติ ขั้นตอนปฏิบัติ การอบรม การประเมินผล และการเปลี่ยนแปลง เป็นกระบวนการต่อเนื่อง เหตุผลที่ก่อนนำ AI เข้ามา ต้องยืนยันว่าสัญญาณเตือนเหล่านั้นมีความหมายต่อหน้างานจึงเป็นจุดสำคัญตรงนี้เอง
ในภาวะ Alarm Flooding เน้นลำดับตรวจสอบ ไม่ใช่แค่ลดจำนวนแจ้งเตือน
ในสถานการณ์ที่เกิดสัญญาณเตือนถี่จำนวนมากในช่วงเวลาสั้น (Alarm Flooding) เป้าหมายไม่ควรเป็นแค่ลดจำนวนที่แสดงบนจอจนเกินจริง เพราะถ้าไปกลบสัญญาณเตือนที่สำคัญ แม้ตัวเลขดูดีขึ้น แต่ความเสี่ยงจริงก็เพิ่มแทน เบื้องต้นควรใช้ Priority เดิมและ Safety Classification เดิมเป็นเงื่อนไขตายตัว จากนั้นค่อยจัดการซ้ำซ้อน การเชื่อมต่อ และความแตกต่างระหว่างสภาวะการผลิต การกดหรือเปลี่ยนลำดับความสำคัญของสัญญาณด้านความปลอดภัยต้องผ่านการควบคุมเปลี่ยนแปลงตามขั้นตอนที่ผู้ดูแลอุปกรณ์กำหนด
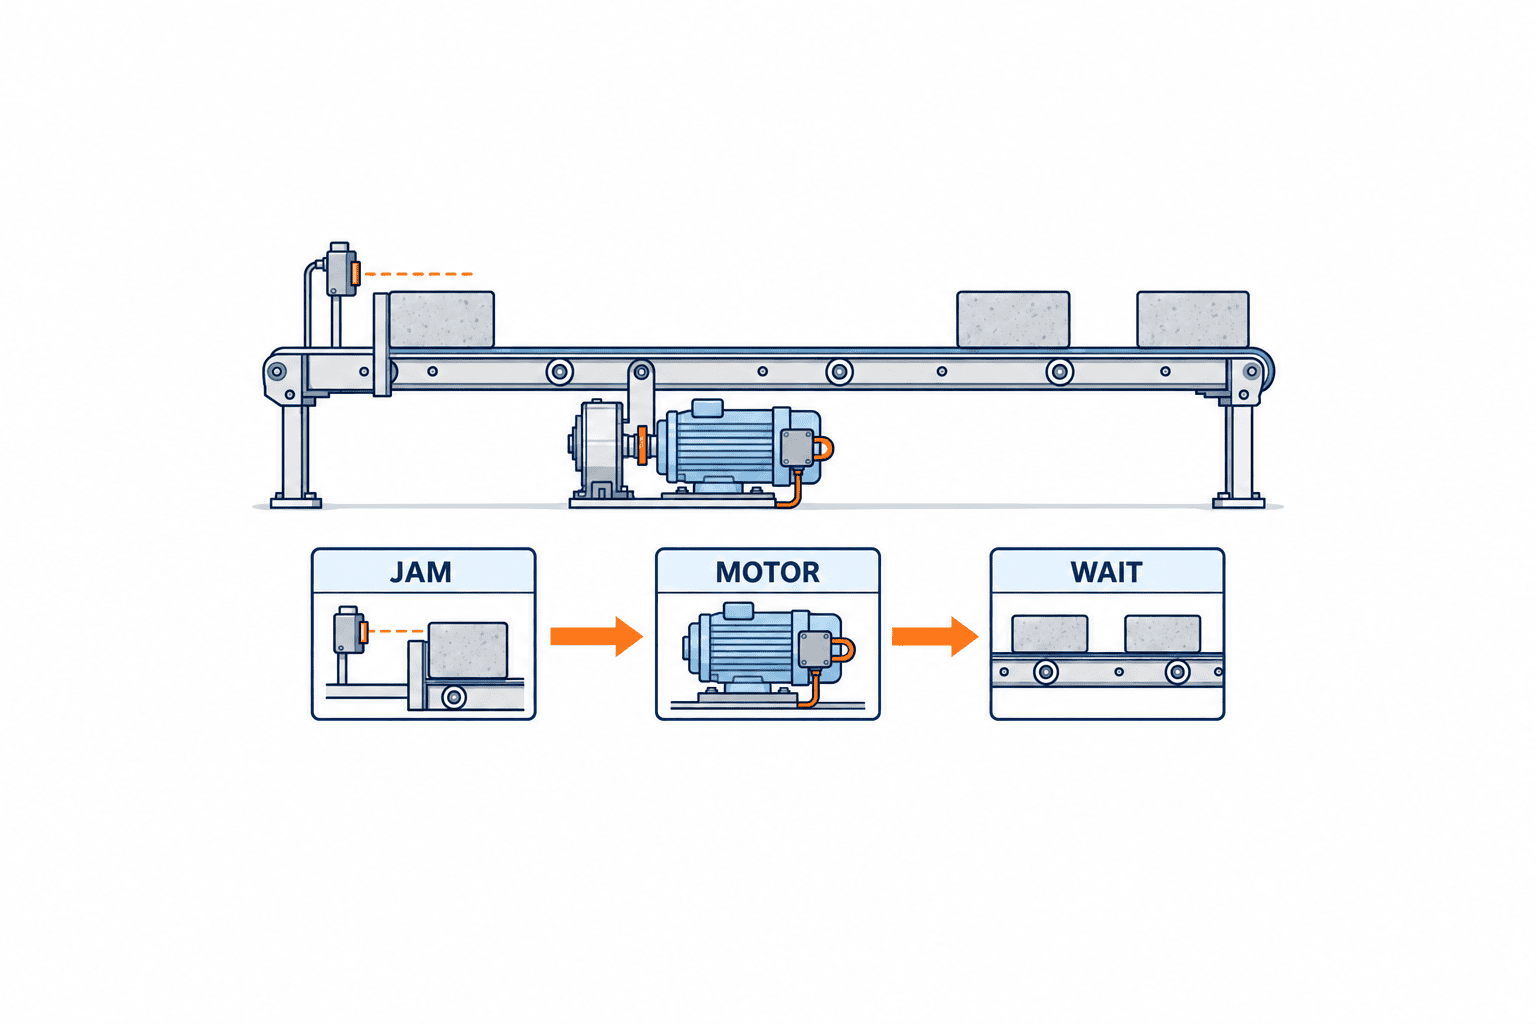
ขอยกตัวอย่าง กรณีที่เซ็นเซอร์ตรวจจับคอนเวเยอร์ต้นทางพบงานสะสม หลังจากนั้นไม่กี่วินาทีมี Overload มอเตอร์ และในด้านปลายน้ำมี “รอการขนย้าย” ปรากฏขึ้นติดต่อกัน แม้ AI จะเห็นสัญญาณสามรายการติดกัน ก็ยังไม่ควรสรุปว่าเซ็นเซอร์ต้นทางเป็นสาเหตุเด็ดขาด เพราะอาจมีต้นเหตุจากเซ็นเซอร์สกปรก งานติดขัดจริง ข้อผิดพลาดในชุดขับเคลื่อน หรือความคลาดเคลื่อนเวลาระบบ ต้องกระจายให้เห็นเป็น “งานติดขัดที่ต้นทาง” “เซ็นเซอร์ผิดพลาด และ “ความผิดปกติที่ชุดขับเคลื่อน” แล้วระบุจุดควรสังเกตแต่ละกรณี เช่น วิเคราะห์กราฟเซ็นเซอร์ตอนหยุด กระแสมอเตอร์ หรือให้พนักงานตรวจสอบของจริง
บริเวณหน้าคำแนะนำแต่ละสาเหตุ ควรระบุ “เหตุผลสนับสนุน” และ “ข้อมูลที่อาจเป็นข้อโต้แย้ง” ด้วย เหตุผลอาจเช่น “เคยเกิดลำดับนี้กับอุปกรณ์และผลิตภัณฑ์เดียวกันในอดีต” ข้อโต้แย้งอาจเช่น “ถ้ากระแสมอเตอร์ขณะหยุดปกติ ต้องทบทวนสมมติฐาน Overload” วิธีนี้ทำให้ผู้ใช้ประเมินข้อเสนอ AI แบบวิพากษ์วิจารณ์ได้ภายในเวลาสั้น
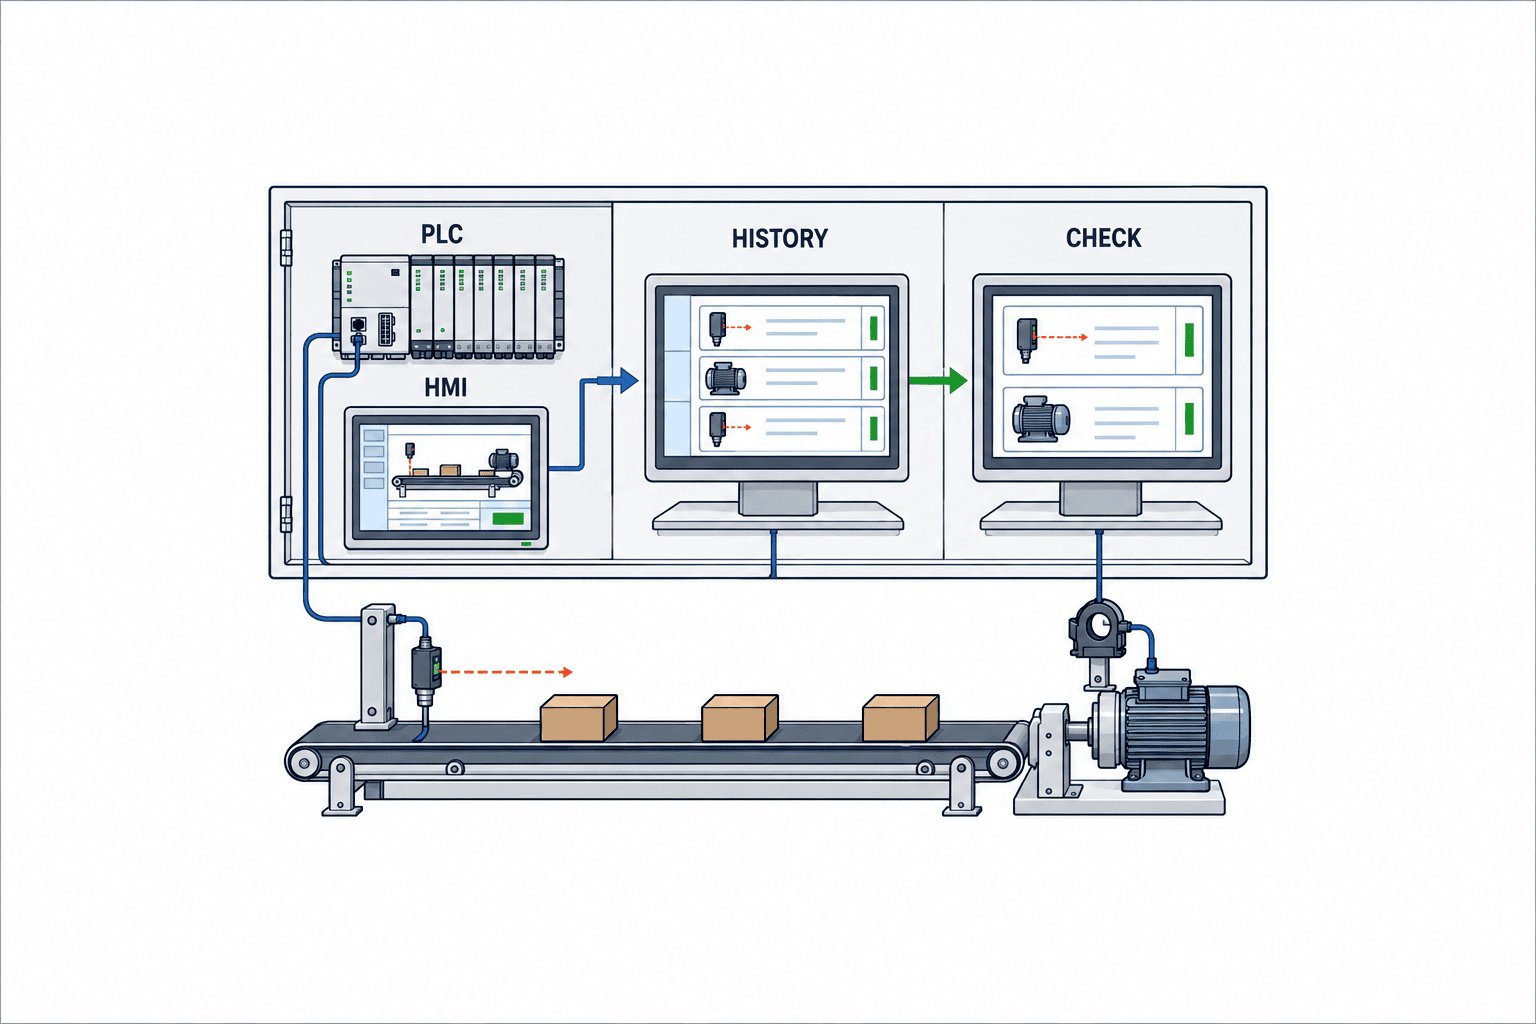
ข้อมูลประวัติสัญญาณเตือนที่ควรตรวจสอบก่อนเริ่มใช้งาน AI
สิ่งแรกที่ควรตรวจสอบไม่ใช่แค่ถ่ายภาพหน้าจอ HMI ได้หรือไม่ แต่คือสามารถดึงประวัติเหตุการณ์ย้อนหลังมาวิเคราะห์ซ้ำได้หรือเปล่า ข้อมูลขั้นต่ำที่ควรมี ได้แก่ รหัสอุปกรณ์ รหัสสัญญาณเตือน เวลาที่เกิด-กลับสู่ปกติ สถานะ ความสำคัญ ข้อความแจ้ง โหมดการทำงาน หมายเลขผลิตภัณฑ์หรือล็อต กะงาน Event ID ของการหยุด ถ้าจะใช้ในเชิงวิเคราะห์ ควรมีข้อมูลเวลาตรวจสอบและผู้ตรวจสอบ รายการรีเซ็ต หยุดด้วยมือ รายงานบำรุงรักษา เวลาเริ่มทำงานใหม่ด้วย หากมีข้อมูลส่วนบุคคลต้องพิจารณาให้เหมาะสมเรื่องความจำเป็นและสิทธิ์เข้าถึง
มาตรฐาน OPC UA เรื่อง Alarms & Conditions ได้จัดรูปแบบ Condition ที่มี State และ Event ที่เกิดจาก State Change รวมถึง OPC UA Part 11 ที่นิยามการจัดการ Event ประวัติ อย่างไรก็ตาม นั่นไม่ได้หมายความว่า OPC UA จะเก็บประวัติระยะยาวให้อัตโนมัติ OPC Foundation ระบุไว้ชัดว่าการเก็บ Log อะลาร์มเป็นหน้าที่ของฝั่ง Client Field ที่ใช้งานในประวัติจะขึ้นกับการตั้งค่าบันทึก ต้องตรวจสอบทั้งเรื่อง Protocol ที่เชื่อมต่อและความพร้อมของข้อมูลประวัติที่จำเป็นแยกจากกัน
คุณภาพของเวลา (Timestamp) สำคัญอย่างยิ่ง ถ้าเวลา PLC, HMI, SCADA, MES, ระบบบำรุงรักษา ไม่ตรงกัน “สัญญาณเตือนแรก” ที่เห็นอาจคลาดเคลื่อน ควรแยกแสดงเวลาต้นทางและเวลาที่บันทึก รับรอง Time Zone และสถานะการ Synchronize เวลา ขณะวิเคราะห์ อีเวนต์ที่ไม่อาจเรียงลำดับเวลาชัดเจนควรแสดงเป็น “เกิดพร้อมกันหรือไม่สามารถระบุลำดับได้” จะปลอดภัยกว่าการสร้างความสัมพันธ์เหตุผลผิดพลาด อย่านำลำดับ Millisecond มาวิเคราะห์เชิงสาเหตุหากไม่ได้ตรวจสอบ Time Accuracy ก่อน
อย่าพยายามใช้แค่ชื่อสัญญาณเตือนเพื่อระบุผล รวบรวมข้อมูลโครงสร้างอุปกรณ์ วิธีเชื่อมโยงอุปกรณ์หลัก ต้นทาง-ปลายน้ำ เซ็นเซอร์-แอคชูเอเตอร์ จุดเข้า-ออก กระบวนการ อินเตอร์ล็อกที่เกี่ยวข้อง กรณีปรับปรุงอุปกรณ์จนเปลี่ยน Tag Name ต้องกำหนดช่วงเวลาเพื่อความถูกต้อง ถ้าไม่สามารถอ้างอิง Tag เช่น “ALM_003” กับโครงสร้าง ณ เวลานั้น การเปรียบเทียบเคสอดีตจะไม่น่าเชื่อถือ
เช็กลิสต์ตรวจสอบคุณภาพข้อมูลล่วงหน้า
| ข้อควรพิจารณา | รายการที่ควรตรวจสอบ | วิธีการดำเนินการเมื่อพบปัญหา |
|---|---|---|
| เวลา | ความแตกต่างของเวลาระหว่าง PLC, HMI, ฐานข้อมูลประวัติ, Timezone | แสดงค่าความเชื่อมั่นลำดับเวลาลดลง |
| สถานะ | ข้อมูลการเกิด-กลับ-ตรวจสอบ-รีเซ็ต หากขาดข้อมูล | แบ่ง “ยังไม่กลับปกติ” หรือ “ข้อมูลขาด” ให้เห็นชัด |
| ID | ประวัติการเปลี่ยนแปลงรหัสอุปกรณ์, Tag, ข้อความ | ใช้ดิกชันนารีแบบระบุช่วงเวลาเพื่อแมปข้อมูล |
| บริบท | โหมดเดินเครื่อง, ประเภทผลิตภัณฑ์, ล็อต, กะงาน | อย่าเติมค่าที่ไม่รู้เองโดยพลการ |
| การดำเนินการ | การแมปใบงานกับผลการรีสตาร์ทเครื่อง | จำกัดขอบเขตเฉพาะกรณีศึกษาแบบที่มี Label ชัด |
ตารางนี้ยกตัวอย่างรายการเช็คในช่วงเริ่มนำเข้า ไม่จำเป็นที่ทุกอุปกรณ์ต้องมีข้อมูลครบทุกช่อง แต่สิ่งที่ควรเหมือนกันคือ “อย่าใช้ข้อมูลไม่ครบแสดงผลเป็นระบุสาเหตุเด็ดขาด”
AI ช่วยคัดกรองสาเหตุที่เป็นไปได้อย่างไร
การทำ AI ในเรื่องนี้ ควรแยกใช้ Rule base สถิติ และภาษา เป็นบทบาทเฉพาะ ทางปฏิบัติจริง
ขั้นที่ 1 ใช้ Rule รักษา Priority อะลาร์ม, คลาสความปลอดภัย, โหมดเดินเครื่อง, Interlock ที่รู้จัก
ขั้นที่ 2 ใช้วิเคราะห์อีเวนต์ที่เกิดพร้อมกันบ่อยใน Time window เดียวกัน ความยาวตั้งแต่เกิด-กลับปกติ ความสัมพันธ์ตำแหน่งระบบ สร้างกลุ่มกรณีที่เป็นผู้ต้องสงสัย
ขั้นที่ 3 ค้นหาจากใบงานและบันทึกในอดีต แสดงเคสคล้ายและแตกต่างในอดีต
กรณี Model ภาษา ใช้อ่านชื่อ Tag ใบงาน คำอธิบายผู้ผลิต โน้ตจากหน้างาน เพื่อนำมาอธิบายเป็นข้อความที่ผู้ปฏิบัติเข้าใจ แต่อย่างไรก็ดี ถึงแม้ระบบจะสร้างคำอธิบายที่ดูน่าเชื่อถือ ก็ไม่ได้หมายถึงการสังเกตสถานะจริงโดยตรง จึงไม่ควรสรุปเช่น “ต้นเหตุคือแบริ่งสึกหรอ” แต่ควรเขียนว่า “ในอดีตเคสคล้ายกันแก้โดยเปลี่ยนแบริ่ง ในครั้งนี้ต้องวิเคราะห์ค่าการสั่นและตรวจสอบของจริง” แสดง Event ID และเวอร์ชั่นของเอกสารที่อ้างอิง ช่วงไหนที่เป็นแค่ข้อสันนิษฐานที่ไม่มีหลักฐาน ก็ควรระบุชัดว่าคือข้อสันนิษฐาน
ถ้าจะนำผลการฟื้นฟูในอดีตมาเป็นข้อมูลสอน (Teacher Data) ต้องระวัง เช่น เวลาที่ใบงานเขียนแค่ว่า “ทำความสะอาดแล้วใช้ได้” ไม่ใช่ข้อพิสูจน์ว่าสกปรกคือสาเหตุสุดท้ายเสมอ อาจมีเหตุบังเอิญหรือปรับแต่งอื่นที่เกิดขึ้นพร้อมกัน ต้องแยก Label ว่า “ยืนยันสาเหตุแล้ว” “สมมติฐานมีน้ำหนัก” “แค่ลงมือแก้ไข” หรือ “ยังไม่พบสาเหตุแน่ชัด” ถ้านำ Case ที่ยังไม่ได้คำตอบแน่ชัดไปสอน AI จะกลายเป็นจำลองสมมติฐานหรือความเข้าใจผิดในหน้างานซ้ำ
ตอนเรียงลำดับผู้ต้องสงสัย ต้องประเมินผสมกัน ทั้งจำนวนการเกิด ลำดับเวลา การเชื่อมโยงกันของอุปกรณ์ โหมดทำงาน การเกิดซ้ำหลังแก้ไข ฯลฯ แต่สุดท้ายจะนำเสนอเป็น “ลำดับการสอบสวน” เท่านั้น ความสำคัญด้านความปลอดภัยคงต้องแยกกับคะแนนความคล้ายโดย AI ไม่ให้ AI Override ลำดับ Safety
5 ขั้นตอนในการเริ่มใช้ AI ในการวิเคราะห์สัญญาณเตือนอุปกรณ์
1. ระบุขอบเขตอุปกรณ์และสถานการณ์ที่จะทดลอง
ถ้าเริ่มจากอะลาร์มทั้งหมดของทั้งโรงงาน Tags และใบงานอาจไม่มีมาตรฐานเดียว ประเมินลำบาก แนะนำว่าควรคัดเลือกกลุ่มอุปกรณ์หรือกระบวนการที่ปัญหาหยุดเครื่องซ้ำเดิมเกิดบ่อย ใช้เวลานานสอบสวนหลังหยุด เช่น ระบบขนส่ง สายแพ็คกิ้ง กลุ่มปั๊ม ระบบปรับอากาศ และต้องชี้วัดเป้าชัด “ลดเวลาหาสาเหตุเบื้องต้น” “ลดเวลารวบรวมประวัติที่ต้องตรวจ” ไม่ใช่ “คาดการณ์ล่วงหน้าก่อนหยุด”
ผู้บริหารงานเครื่องจักร ผลิต บำรุงรักษา และคุณภาพต้องตั้งเป้าร่วมกรณีเป็นอะลาร์มเกี่ยวข้องกับคุณภาพ อย่าถือว่าการรีสตาร์ทเครื่องคือสำเร็จ ควรพ่วงการกักแยกล็อต สอบทานของเสีย ถ้าเป็นกระบวนการต่อเนื่องควรพิจารณาทั้งต้นน้ำ-ปลายน้ำ ตั้งแต่กำหนดขอบเขต
2. ตรวจสอบทะเบียนอะลาร์มและเกณฑ์ตัดสินใจ
เช็กข้อมูลในทะเบียนเช่น ID อุปกรณ์ Tag คำอธิบาย Priority กิจกรรมที่ขอให้ Operator ทำ กำหนดเส้นตาย นัดหมายการแก้ไข แยกประเภทสัญญาณเตือนที่สัมพันธ์กับความปลอดภัย สิ่งแวดล้อม คุณภาพ เป็นกรณีพิเศษที่ต้องมาก่อนทุกแนว AI เอกสารการจัดการอะลาร์มของ ISA จะพูดถึงลำดับความสำคัญ ขั้นตอนปฏิบัติ การฝึกอบรม การเก็บประวัติ audit ตาม Lifecycle ถ้าโปรเจ็กต์ AI พบข้อบกพร่องในทะเบียน อย่านำโมเดลกลบปัญหา ต้องย้อนกลับไปปรับแก้อุปกรณ์
ในกรณีที่ไม่มีการระบุกิจกรรมที่ต้องทำชัดเจนในสัญญาณนั้น ถึงแม้จะนำมาใช้งานวิเคราะห์ได้ แต่ก็จะยังไม่รองรับการแนะ Action หน้างาน ต้องจัดทำคู่มือปฏิบัติ “ต้องเช็คอะไร แจ้งใคร ห้ามทำอะไร” ให้เสร็จก่อน และยืนยันชัดว่า AI ไม่สามารถตัดสินใจยกเลิก Interlock หรืองานความปลอดภัยโดยอัตโนมัติ
3. รวบรวมเคสในอดีตและแบ่งชั้นความถูกต้องของตัวอย่าง
ใช้ Stop Event ID เป็นแกนผูกโยงสัญญาณก่อน-หลังหยุด ค่าสถานะอุปกรณ์ ใบงาน ผลตัดสิน สาเหตุ การดำเนินการ ผลรีสตาร์ท ถ้ามีแต่จำนวนเคสแต่ในใบงานเขียนแค่ “อุปกรณ์เสีย” จะไม่ช่วยอะไร ควรจัดกลุ่มตัวอย่างแยกตามความมั่นใจ เลือกเฉพาะที่มีผู้รับผิดชอบยืนยันเหตุผล แนวทางที่ดีไม่ควรตั้ง Threshold จำนวน 20 หรือ 100 เคส แต่ดูว่าพฤติกรรมผิดปกติทั่วไปของอุปกรณ์นั้นๆ ครอบคลุมหรือยัง
ต้องจงใจเลือกตัวอย่างที่ “ลำดับสัญญาณคล้ายกันแต่สาเหตุจริงต่างกัน” เพื่อทดสอบโมเดลกับความเชื่อผิดๆ ถ้าบันทึกเคสในอดีตไม่พอชี้ชัดสาเหตุ อย่าฝืนติดป้าย Label ให้ ระบุว่า “ตัดสินไม่ได้” ข้อมูลอีเวนต์ต้นฉบับและโน้ตจากคนต้องแยกจัดเก็บเพื่อป้องกันการแก้ไขย้อนหลัง
4. ทดสอบกับข้อมูลอดีตก่อนนำขึ้นหน้างานจริง
แบ่งกรณีหยุดในอดีตเป็นช่วงเวลา ใช้ช่วงแรกสำหรับตั้งค่า ช่วงหลังเป็นทดสอบ ห้ามนำข้อมูลจาก Stop Event เดียวกันไปอยู่ทั้งฝั่งทดลองและทดสอบ เพราะจะทำให้ดูเหมือนโมเดลแม่นมากโดยที่จริง Overfit จุดสำคัญคือตรวจว่า “สาเหตุที่ถูกต้องติด Top List” หรือไม่ ไม่ใช่แค่ความถูกต้องรวม ต้องติดตามต่อว่า Alarm ด้าน Safety/Quality ถูก bỏ/drop บ้างหรือเปล่า เหตุผลที่แนะถูกต้องตามเหตุการณ์ไหม กรณีแปลกที่ไม่รู้จักแนะนำว่า “ไม่ทราบ” ได้หรือไม่
ต้องใช้หลายตัวชี้วัด รายการเช่น อัตราที่สาเหตุจริงอยู่อันดับต้น ระยะเวลาตั้งแต่เริ่มสอบสวนจนสรุป เครื่องไหนผู้ปฏิบัติเข้าดูเหตุผลประกอบ สำรวจจำนวนกรณีที่โมเดลชี้นำผิด เกณฑ์ตัวเลขควรกำหนดหลังสำรวจสถานการณ์จริงโรงงาน “AI ต้องลดเวลา downtime ลงครึ่ง” เป็นเป้าสากลไม่ได้ ต้องมี baseline จากการแก้ปัญหาวิธีเดิมเปรียบเทียบด้วย
5. เริ่มจากใช้งานเงาและขยายด้วยขั้นตอนการเปลี่ยนแปลง
ระยะแรก แค่แสดงข้อเสนอของ AI ข้างๆ งานจริง โดยที่คนหน้างานยังทำตามปกติ บันทึกข้อผิดพลาด ปรับปรุงวิธีแสดงสาเหตุ เพิ่มขอบเขตฐานข้อมูลอุปกรณ์ และใบงาน ตรวจปรับขอบเขตการค้นหา ขั้นถัดไปจึงนำใช้งานแค่กลุ่มอุปกรณ์หรือกะงานที่ได้รับอนุญาตไว้ อย่างไรก็ตาม การแก้ไขขั้นตอนปฏิบัติ การเปลี่ยน priority หรือการเชื่อมต่อคุมเครื่องอัตโนมัติ ต้องมีขั้นตอนอนุมัติแยก Design/Management ตามที่แนว EEMUA 191 หรือ NIST AI RMF แนะนำคือ เน้นการแปลงระบบแบบค่อยเป็นค่อยไป รับรองการตรวจทานโดยมนุษย์และติดตามประเมินผลงานอย่างต่อเนื่อง
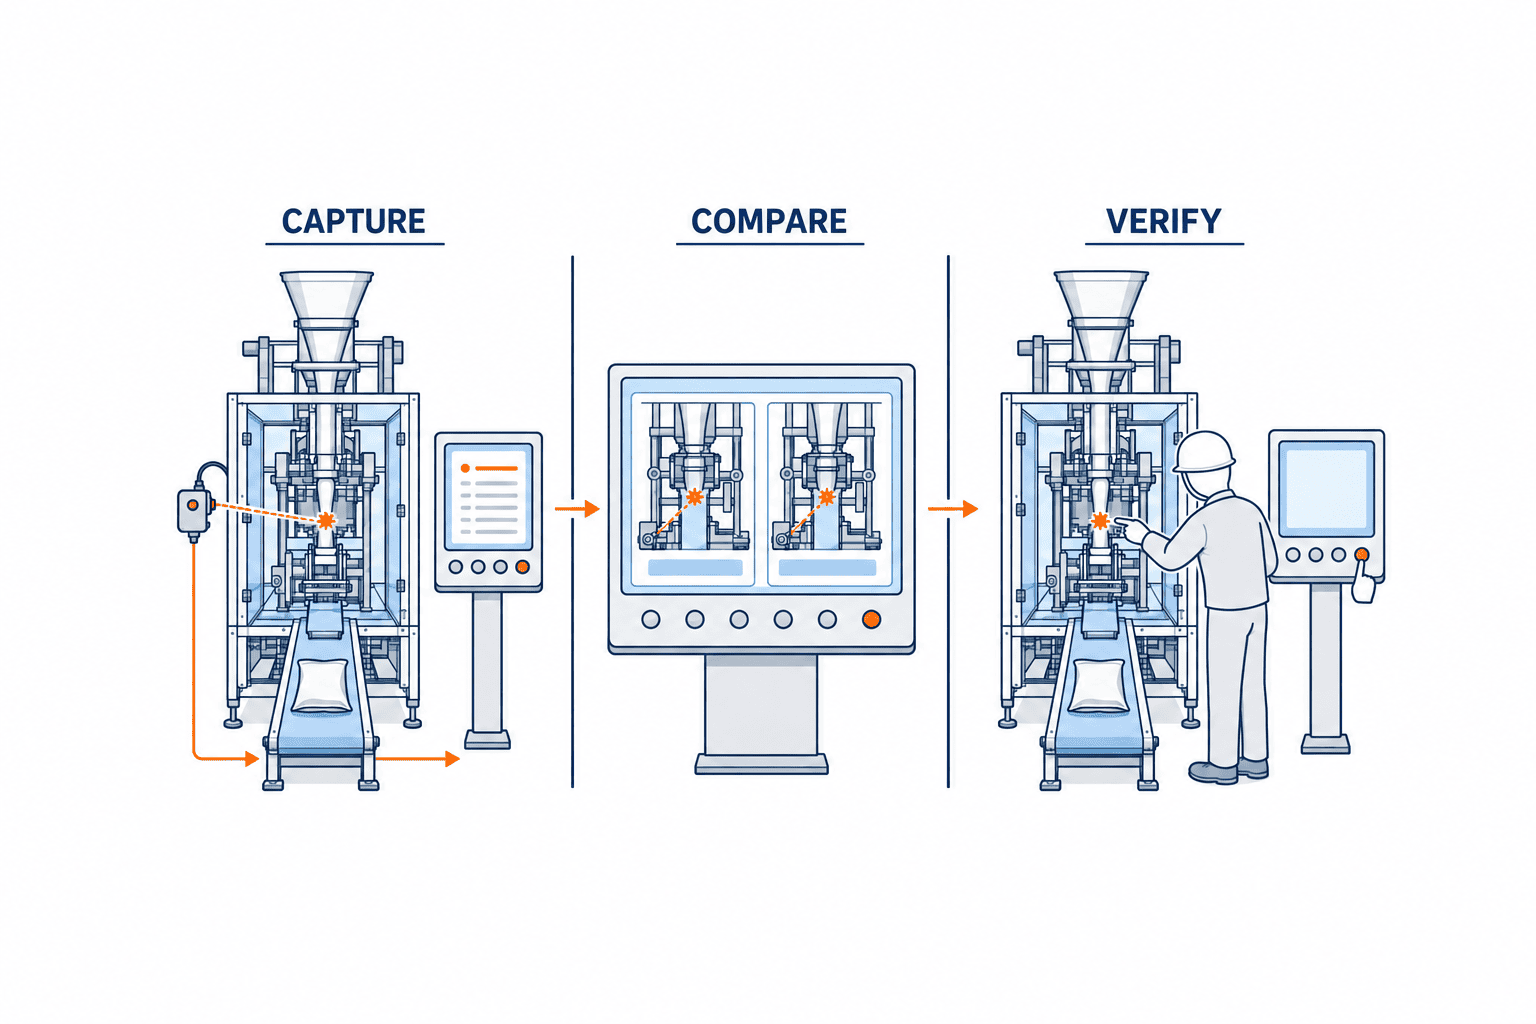
หน้าจอควรแสดง “ตัวเลือกอันดับต้น” พร้อมขั้นตอนการตรวจสอบ
หน้าจอที่ใช้งานง่ายไม่ใช่หน้าจอที่ AI แสดงคำอธิบายยาว ๆ แต่เป็นหน้าจอที่พนักงานเดินเครื่องสามารถตัดสินใจได้อย่างรวดเร็วว่า “ตอนนี้ต้องตรวจสอบอะไร” ด้านบนสุด แสดงแจ้งเตือนสำคัญเกี่ยวกับความปลอดภัยและคุณภาพตามลำดับความสำคัญเดิม ถัดลงมา แสดงเหตุการณ์หยุดเครื่องกรณีนี้เป็นกลุ่มเดียวกัน สำหรับแต่ละสาเหตุที่เป็นไปได้ ให้แสดงเหตุการณ์ที่อาจเป็นต้นตอ ค่าของเครื่องจักรที่เกี่ยวข้อง กรณีในอดีต รายการที่ต้องตรวจสอบ และข้อมูลที่ยังไม่สามารถตรวจสอบได้
ตัวอย่างเช่น กรณีเสนอ “ติดขัดที่ทางเข้าขนส่ง” ไม่ควรแสดงแค่ “ความน่าจะเป็น 80%” แต่ควรแสดงเหตุผล เช่น “เซ็นเซอร์ทางเข้า ON ต่อเนื่อง”, “กระแสไฟฟ้าของมอเตอร์เพิ่มขึ้น”, “เคยเกิดติดขัดกับรุ่นเดียวกันในอดีต” หากใช้การแสดงผลแบบเปอร์เซ็นต์ก่อนที่โมเดลจะถูกปรับเทียบ อาจทำให้ตัวเลขดูคล้ายเป็นโอกาสเสียหายที่เป็นกลางแต่อาจไม่จริง ดังนั้นควรเริ่มจากการแสดงแบบจัดลำดับ “สูง-กลาง-ต่ำ” หรืออื่น ๆ และนำค่าเปอร์เซ็นต์ที่ผ่านการยืนยันด้วยการตรวจสอบมาใช้
สำหรับแต่ละตัวเลือก ควรแนบวิธีพิสูจน์แย้งด้วย เช่น “หากไม่มีชิ้นงานติดอยู่จริง ให้ตรวจสอบเซ็นเซอร์สกปรกและชุดขับเคลื่อน”, “เนื่องจากไม่มีประวัติกระแสไฟฟ้า กรณีนี้ถือว่าความน่าเชื่อต่ำ” ความสามารถที่ AI ต้องแสดงสถานะที่ยังไม่รู้เป็นจุดสำคัญในการนำมาใช้งานครั้งแรก หากบันทึกเหตุผลที่พนักงานเดินเครื่องปฏิเสธตัวเลือกกับแนวทางที่ใช้ดำเนินการจริง จะนำไปแก้ไขและปรับปรุงในอนาคตได้
การคำนวณค่าใช้จ่าย แยกขอบเขตการเชื่อมต่อกับภาระการใช้งาน
ต้นทุนของ AI วิเคราะห์อุปกรณ์แจ้งเตือนไม่ได้ขึ้นกับค่าใช้ AI อย่างเดียว ต้องพิจารณาด้วยว่าสามารถดึงเหตุการณ์จากอุปกรณ์เดิมได้หรือไม่ ระยะเวลาการเก็บประวัติพอเพียงหรือไม่ ระบบเวลาสัมพันธ์เหมาะสมหรือยัง ระบบพจนานุกรมเครื่องจักรกับใบงานเชื่อมโยงกันได้หรือไม่ ซึ่งมีผลต่อการเตรียมการในเฟสเริ่มต้น ถึงแม้จะดึงข้อมูลย้อนหลังจาก HMI หรือ SCADA ได้ แต่อาจต้องปรับปรุงการบันทึกหรือล็อกในกรณีที่ไม่มีสถานะการคืนค่า-การยืนยัน นอกจากนี้ยังมีค่าใช้จ่ายต่อเนื่อง เช่น การอัปเดตแท็กเมื่อมีการดัดแปลงเครื่องจักร การตรวจทานหน้างาน การจัดการสิทธิ์ และการประเมินผลของโมเดล
ตอนเปรียบเทียบใบเสนอราคา ให้ระบุไม่ใช่แค่จำนวนอุปกรณ์ แต่รวมถึงจำนวนแท็กที่ใช้ เก็บข้อมูลอะไร ระยะเวลาที่เก็บข้อมูล วิธีการเชื่อมต่อ การปรับปรุงระบบเดิม การทำความเข้าใจหน้าจอกับฝึกอบรม และขอบเขตการตรวจทานแต่ละเดือน ควรระบุเงื่อนไขรับงานว่าสามารถตรวจสอบย้อนกลับเหตุผลได้ ไม่ปกปิดแจ้งเตือนสำคัญ และมีระบบรายงานข้อเสนอผิดพลาด อย่านำแค่ความแม่นยำของ AI มาเป็นข้อตกลงเดียว
การตรวจสอบใน PoC ไม่ใช่แค่ “เดโมให้คำอธิบายตรง” แต่ดูว่าข้อมูลจริงช่วยลดเวลาสืบสวนโดยไม่เพิ่มจำนวนข้อผิดพลาดหรือไม่ แทนที่จะเสนอราคาขยายทั้งโรงงานตั้งแต่แรก ควรเริ่มจากอุปกรณ์ชุดเล็ก ๆ เพื่อตรวจสอบคุณภาพข้อมูล วิธีประเมินผล และขั้นตอนการทำงานก่อน แล้วจึงประเมินค่าขยายในลำดับถัดไป เพื่อความชัดเจนของเงื่อนไข
ข้อผิดพลาดในการออกแบบที่พบบ่อยและแนวทางแก้ไข
ข้อผิดพลาดแรก คือสับสนระหว่างการรวบรวมแจ้งเตือนขนาดใหญ่บนหน้าจอ กับการวิเคราะห์หาสาเหตุจริง การรวมแจ้งเตือนคล้ายกันช่วยให้อ่านได้ง่าย แต่ไม่ได้พิสูจน์ต้นตอของปัญหา หลังรวบรวมควรตรวจสอบย้อนกลับเหตุการณ์ต้นฉบับ ดูลำดับและสถานะได้ ข้อผิดพลาดที่สอง คือสอน AI ด้วยชื่อแท็กหรือใบงานที่เป็นภาษาโดยตรงโดยไม่คำนึงถึงการเปลี่ยนแปลงเครื่องจักร หรือบันทึกผิดพลาด ดังนั้นควรกำหนดรุ่นพจนานุกรมและช่วงเวลาที่ข้อมูลมีผลใช้งาน
ข้อผิดพลาดที่สาม คือใช้คำตอบของ AI เป็นคำสั่งปฏิบัติงานโดยตรง โดยเฉพาะในประเด็นที่เกี่ยวกับความปลอดภัย คุณภาพ หรือสิ่งแวดล้อม ควรยึดแนวปฏิบัติเก่า AI เพียงเสนอแนะสาเหตุและจุดที่ควรตรวจสอบ ให้พนักงานเดินเครื่องตรวจสอบกับเครื่องจริง คู่มือการปฏิบัติงาน หรือปรึกษาผู้รับผิดชอบ ข้อผิดพลาดที่สี่ คือเลือกประเมินผลเฉพาะกรณีสำเร็จเท่านั้น ต้องรวมกรณีสาเหตุไม่ชัดเจน ข้อมูลขาดหาย หลายสาเหตุ หรือข้อมูลเวลาไม่ตรงและตรวจสอบได้ว่าระบบสามารถพักค้างได้เหมาะสมหรือไม่
ข้อผิดพลาดที่ห้า คือไม่ทบทวนหลังเริ่มใช้งานจริง การดัดแปลงเครื่องจักร การเปลี่ยนรุ่นสินค้า เปลี่ยนฤดูกาล เปลี่ยนวิธีซ่อมบำรุง อาจทำให้ความหมายของชุดแจ้งเตือนชุดเดียวกันเปลี่ยนแปลงไป ดังนั้นต้องมีผู้รับผิดชอบเก็บรวบรวมข้อเสนอผิดพลาด อัปเดตพจนานุกรมเครื่องจักรและกรณีศึกษาเป็นประจำ ตามแนวคิดการตรวจสอบ/ปรับปรุงตาม ISA และแนวทางการประเมินต่อเนื่องของ NIST AI RMF
การเชื่อมโยงกับระบบเฝ้าระวังหยุดเครื่องหรือเทรซอะบิลิตี้คุณภาพ
ระบบเฝ้าระวังหยุดเครื่องเป็นพื้นฐานสำหรับตรวจสอบ “เมื่อไรและหยุดนานเท่าไหร่” การวิเคราะห์แจ้งเตือนคือการเข้าใจเพิ่มเติมว่า “ก่อน/หลังหยุดเครื่องเกิดอะไรขึ้น ควรตรวจสอบอะไรก่อน” คีย์เชื่อมทั้งสองระบบ คือ ID เหตุการณ์หยุดเครื่อง, ID อุปกรณ์ และเวลา ต้องจับคู่ประเภทการหยุดกับกลุ่มแจ้งเตือน เพื่อไม่ให้นับซ้ำ หากวางแผนสร้างระบบเฝ้าระวังหยุดเครื่องให้พิจารณาอ่านเพิ่มเติมที่ บทความการลด Minor Stop และการเฝ้าระวังอุปกรณ์
ส่วนระบบเทรซอะบิลิตี้คุณภาพ จะติดตามความสัมพันธ์ระหว่างล็อตหรือเงื่อนไขกระบวนการกับของเสีย ในการวิเคราะห์แจ้งเตือน หากสามารถตรวจสอบได้ว่าล็อตไหนได้รับผลกระทบจากแจ้งเตือนที่ส่งผลต่อคุณภาพ จะสามารถตัดสินใจได้รวดเร็วขึ้น อย่างไรก็ตาม การแจ้งเตือนเพียงอย่างเดียวไม่ได้สรุปความเสียหาย ต้องรวมผลตรวจสอบ, ขอบเขตล็อต และการเปลี่ยนแปลงกระบวนการมาประเมินร่วมกัน การบูรณาการข้อมูลข้ามระบบสำหรับการสืบหาสาเหตุกรุณาอ่าน บทความการเชื่อมโยงสาเหตุของเสียและระบบเทรซอะบิลิตี้
ในห้องคลีนรูมหรือระบบเฝ้าระวังสิ่งแวดล้อม แจ้งเตือนของอุปกรณ์อาจเกี่ยวข้องกับอุณหภูมิ-ความชื้น ความดัน หรือเงื่อนไขแวดล้อม ถ้าเป็นเช่นนั้น ต้องแยกความผิดปกติของค่าที่เฝ้าระวัง, เซ็นเซอร์เสีย, กับความเสียหายของอุปกรณ์ บทความนี้เน้นส่วนของการจับคู่เหตุการณ์ข้ามระบบและแนะนำลำดับการตรวจสอบ
การกำหนดเงื่อนไขรับมอบงาน PoC
ก่อนสั่ง PoC ควรกำหนดเงื่อนไขสำเร็จเป็นลายลักษณ์อักษร เช่น “สำหรับไลน์บรรจุภัณฑ์เป้าหมาย ให้แยกกรณีหยุดเครื่องล่าสุดตามช่วงเวลา และสำหรับแต่ละกรณีประเมินให้แสดงรายชื่อตัวเลือกอันดับ 3 อันดับแรก, ID ของแจ้งเตือนที่ใช้เป็นหลักฐาน, ข้อมูลหรือชิ้นงานที่ควรตรวจสอบ” พร้อมยอมรับ “ยืนยันสาเหตุไม่ได้” สำหรับกรณีที่แม้แต่หน้างานยังไม่สามารถพิสูจน์ได้จริง และให้แน่ใจว่าแจ้งเตือนสำคัญด้านความปลอดภัย/คุณภาพ ไม่จมหายไปจากลำดับการนำเสนอ กำหนดช่วงเวลาหรือจำนวนกรณีเท่าที่มีข้อมูลประวัติหยุดเครื่องจริง
นอกจากนี้ เงื่อนไขการใช้งานหน้าจอในหน้างานก็เป็นประเด็นสำคัญ ทดสอบกระบวนการตั้งแต่ค้นหาเหตุการณ์หยุดจนเปิดแจ้งเตือนที่เกี่ยวข้อง ย้อนกลับไปหลักฐานในล็อกต้นทาง การป้อนข้อมูลปฏิเสธตัวเลือก และวิธีมอบหมาย-โอนผลให้แต่ละกะ หากต้องเปลี่ยนหน้าจอหลายครั้งกว่าจะตรวจสอบเสร็จ ประสิทธิภาพที่คาดหวังในหน้างานก็จะต่ำลง ทดสอบว่าระบบระบุ “ไม่สามารถวิเคราะห์ได้” เมื่อเกิดช่วงเวลาไม่มีข้อมูลจากเครื่องจักร, เครือข่ายขาด หรือเพิ่งเปลี่ยนแท็กใหม่ และสามารถกลับไปใช้วิธีเดิมได้
ต้องรวมวิธีรายงานข้อผิดพลาดและการทบทวนซ้ำในการรับมอบผลงานด้วย เก็บข้อเสนอตัวเลือกผิดพลาด ข้อเสนอที่ไม่มีหลักฐาน และการซ่อมแซมที่ไม่ได้บันทึกจากการทบทวนรายเดือน แล้วใช้ในการอัปเดตพจนานุกรมหรือเอกสารที่ใช้ค้นหา หลังอัปเดตแล้วต้องตรวจสอบกรณีเดิมที่เคยทำได้ถูกต้องซ้ำอีกครั้ง รวมทั้งจดวันที่เปลี่ยนแปลงโมเดลหรือ Prompt, ขอบเขตข้อมูล, และผลประเมิน เพื่อให้สามารถตรวจสอบย้อนหลังได้ว่า “แต่ละเวอร์ชันของ AI เสนออะไร”
สิ่งที่ต้องระวังเมื่อใช้ในโรงงานไทยหรือหลายภาษา
โรงงานที่ใช้เอกสารภาษาญี่ปุ่นจากสำนักงานใหญ่, คู่มือเครื่องจักรภาษาอังกฤษ, และใบงานภาษาไทยหรือเวียดนาม ไม่สามารถใช้การแปลเพียงคำศัพท์แท็กเครื่องจักรมาสื่อความหมายเหมือนกันได้ เช่นแม้แต่ “ติดขัด” เองยังมีชื่อเรียกต่างกันในแต่ละฝั่ง เช่นของขาด, ติดขัดทางออก, หรือตำแหน่งเซ็นเซอร์ ดังนั้น Equipment ID กับ Event ID ต้องใช้เป็นคีย์กลางไม่ขึ้นกับภาษา ส่วนชื่อที่แสดงและคำอธิบาย ควรแยกแปลโดยเก็บต้นฉบับไว้ และให้หัวหน้างานตรวจสอบคำเทคนิคที่ใช้ตัดสินใจ
สำหรับการส่งต่อเวรระหว่างกะ ควรบันทึกเหตุการณ์ต้นทาง, สภาพจริงที่ตรวจสอบแล้ว, จุดที่ยังไม่ยืนยัน, และแนวทางการจัดการ ในรูปแบบที่มีโครงสร้าง ไม่ใช่แค่ข้อความ AI เพียงอย่างเดียว เช่น หากเวรก่อนเขียนว่า “ทำความสะอาดเซ็นเซอร์” เวรถัดไปควรเห็นค่าก่อน-หลังทำความสะอาดและมีข้อมูลว่าเกิดซ้ำอีกหรือไม่ การบันทึกเช่นนี้สะสมมากขึ้นจะนำไปสู่การประเมินประสิทธิผลของวิธีต่าง ๆ จากข้อมูลแจ้งเตือนไม่ใช่แค่จำนวนเหตุการณ์
การแบ่งหน้าที่รับผิดชอบในการจัดการข้อเสนอ AI ในพื้นที่ปฏิบัติงาน
ผลการวิเคราะห์สัญญาณเตือนของอุปกรณ์จะถูกตีความแตกต่างกันตามฝ่ายที่เกี่ยวข้อง เช่น ฝ่ายการผลิต ฝ่ายบำรุงรักษา ฝ่ายคุณภาพ และฝ่ายระบบสารสนเทศ ฝ่ายผลิตจะให้ความสำคัญกับการหยุดงานอย่างปลอดภัยและตรวจสอบของจริงเป็นหลัก ฝ่ายบำรุงรักษาจะตรวจสอบโครงสร้างอุปกรณ์และประวัติการซ่อมบำรุง ฝ่ายคุณภาพจะตรวจสอบล็อตที่อาจได้รับผลกระทบและเงื่อนไขการทดสอบ ส่วนฝ่ายระบบสารสนเทศจะจัดการกับปัญหาข้อมูลขาดหาย การซิงโครไนซ์เวลา และสิทธิ์ในการเข้าถึง แม้ว่า AI จะรวบรวมข้อมูลทุกอย่างไว้ในหน้าจอเดียว แต่สิ่งที่สำคัญคือไม่ทำให้ความรับผิดชอบในการตัดสินใจของแต่ละฝ่ายเกิดความคลุมเครือ ต้องตกลงล่วงหน้าว่า ใครจะเป็นผู้บันทึกการคัดเลือกหรือปฏิเสธข้อเสนอ การดำเนินการที่ได้ทำไปแล้ว และการอนุมัติให้เริ่มงานใหม่
หลังจากแสดงสาเหตุที่เป็นไปได้แล้ว ต้องบันทึกประวัติการดำเนินงานด้วย โดยเชื่อมโยงเวอร์ชันของ AI ขอบเขตของเหตุการณ์ที่อ้างอิง ข้อเสนอที่แสดง เหตุผลที่พนักงานนำไปพิจารณาหรือปฏิเสธสาเหตุ และหลักฐานที่ผู้ปฏิบัติงานเปิดดูกับเหตุการณ์หยุดงาน เพื่อให้สามารถแยกแยะในภายหลังว่า “AI อ้างอิงอะไรมากำหนดข้อเสนอ และมนุษย์ได้ยืนยันอะไรเพื่อการกู้คืน” ฟีดแบ็คที่ใช้สำหรับการเรียนรู้ของ AI ก็จะต้องเชื่อมโยงกับการยืนยันของจริงหรือผลของการบำรุงรักษา ไม่ใช่แค่การกดปุ่มเห็นด้วยหรือไม่เห็นด้วย เพราะจะไม่ถือว่าการปฏิเสธหรือการยอมรับที่ไม่มีหลักฐานเป็นป้ายคำตอบที่ถูกต้อง
ต้องเตรียมวิธีดำเนินการหากไม่สามารถใช้บริการ AI ในพื้นที่ปฏิบัติงานได้ด้วย หากเครือข่ายหรือเซิร์ฟเวอร์บันทึกประวัติหยุดทำงาน ต้องไม่แสดงข้อเสนอเก่าราวกับว่าเป็นสถานะปัจจุบัน แต่ควรระบุเวลาล่าสุดที่ข้อมูลถูกจัดเก็บได้และข้อมูลที่ขาดหาย ควรรักษาสถานะที่สามารถใช้งาน HMI เดิมและคู่มือปฏิบัติงานทั้งแบบกระดาษหรืออิเล็กทรอนิกส์ได้ เพื่อไม่ให้กระบวนการตรวจสอบความปลอดภัยล่าช้าเนื่องจากรอการกู้คืนของ AI หลังจากกลับมาเชื่อมต่ออีกครั้ง ต้องระบุช่วงเวลาที่ข้อมูลขาดหาย และตรวจสอบกรณีที่เกิดในช่วงเวลาดังกล่าวแยกต่างหากจากการประเมินความแม่นยำตามปกติ การปฏิบัติงานในกรณีฉุกเฉินเช่นนี้เป็นหนึ่งในประเด็นที่ควรทดลองใน PoC เช่นเดียวกัน
การพิจารณาผลลัพธ์หลังจากการนำ AI เข้ามาใช้
หลังจากนำ AI เข้ามาใช้แล้ว ไม่ควรประเมินผลแค่เพียงอัตราความถูกต้องของคำตอบเท่านั้น อันดับแรกควรบันทึกแยกกันระหว่างระยะเวลาจากเหตุการณ์หยุดเครื่องจนถึงเริ่มต้นการตรวจสอบ ระยะเวลาที่ใช้เตรียมข้อมูลล็อกและใบงานที่จำเป็น ตลอดจนเวลาที่ใช้จนเสร็จสิ้นการตรวจสอบหน้างาน เพื่อประเมินบทบาทของ AI ควรเปรียบเทียบกับข้อมูลในช่วงเวลาเดิมที่มีสภาพแวดล้อมเครื่องจักรและเงื่อนไขการเดินเครื่องที่ใกล้เคียงกัน หรือเทียบกับช่วงทดลองใช้งานแบบเงา หากนำกรณีที่มีระดับความรุนแรงของการหยุดเครื่องหรือชนิดสินค้าแตกต่างกันมาคำนวณค่าเฉลี่ยรวมกัน แม้จะดูเหมือนดีขึ้น แต่จะไม่สามารถอธิบายได้ นอกจากนี้ เวลาหยุดเครื่องยังขึ้นอยู่กับแผนการผลิตหรือการรออะไหล่ ดังนั้นจึงไม่ควรจำกัดการประเมิน AI ไว้แค่เวลาหยุดเครื่องเพียงอย่างเดียว
ถัดไป จะต้องติดตามความปลอดภัยของข้อเสนอและวิธีการใช้งาน AI โดยบันทึกจำนวนกรณีที่พลาดการตรวจจับสัญญาณเตือนสำคัญ อัตราส่วนที่ข้อเสนอมีเหตุผลสนับสนุน อัตราส่วนที่เปิดข้อมูลล็อกต้นฉบับเพื่อตรวจสอบ อัตราส่วนที่แนะนำให้ระงับข้อเสนอที่ไม่ทราบสาเหตุอย่างเหมาะสม และจำนวนกรณีที่ข้อเสนอผิดพลาดนำไปสู่การเสียเวลา หากมี “จำนวนครั้งที่แนะนำข้อเสนอ” เยอะ แต่พนักงานปฏิเสธโดยไม่ตรวจสอบเหตุผล แสดงว่าต้องพิจารณาออกแบบหน้าจอหรือคุณภาพข้อมูลใหม่ ตรงข้าม ถ้าสัดส่วนข้อเสนอที่ถูกนำไปใช้สูงแต่ข้ามกระบวนการตรวจสอบหน้างาน แปลว่ามีปัญหาในด้านการปฏิบัติงาน ควรเก็บข้อมูลตัวอย่างข้อเสนอผิดพลาดควบคู่กับความคิดเห็นจากหน้างานไว้ด้วยเสมอ
ในการทบทวนรายเดือน ต้องตรวจสอบการปรับปรุงเครื่องจักร การเพิ่มแท็ก การเปลี่ยนชนิดสินค้าหรือเงื่อนไขการเดินเครื่อง หากมีการเปลี่ยนแปลงที่ทำให้ความหมายของสัญญาณเตือนเดียวกันเปลี่ยนไป ต้องอัปเดตเงื่อนไขการค้นหาและชุดประเมินของกรณีในอดีตด้วย อย่าเลือกนำเสนอเฉพาะผลลัพธ์ที่ดีในข้อมูลเก่า เพียงเพื่อเร่งแสดงความสำเร็จ ต้องประเมินซ้ำในช่วงเวลาใหม่และพิจารณาจากเงื่อนไขการยอมรับที่กำหนดไว้เมื่อนำเข้าใช้ว่าจะขยายขอบเขตการใช้ จำกัดขอบเขต หรือหยุดใช้งานก่อนชั่วคราวเสมอ อย่าใช้ตัวชี้วัดเป็น “ใบรายงานผลของ AI” แต่ให้ถือเป็นข้อมูลสำหรับการปรับปรุงขั้นตอนการตรวจสอบของหน้างาน
คำถามที่พบบ่อย
AI วิเคราะห์แจ้งเตือนอุปกรณ์คืออะไร?
เป็นระบบที่อ่านบันทึกแจ้งเตือนที่เกิดขึ้นกับเครื่องจักร โดยรวมกับสถานะเดินเครื่อง โครงสร้างอุปกรณ์ และประวัติการดำเนินงาน เพื่อนำเสนอ “สาเหตุที่เป็นไปได้” และข้อมูลที่ควรตรวจสอบ แตกต่างกับระบบทำนายความเสียหายล่วงหน้า (Predictive Maintenance) และแม้จะแสดงสาเหตุที่คาดว่าเป็นไปได้ก็ไม่ได้หมายความว่าจะยืนยันสาเหตุหรือแก้ไขโดยอัตโนมัติ
จำเป็นต้องเปลี่ยน PLC หรือ HMI เดิมหรือไม่?
ไม่จำเป็นเสมอไป หากสามารถดึงข้อมูลบันทึกที่ต้องการได้จาก HMI, SCADA หรือฮิสโตเรียนเดิม แต่หากบันทึกมีแค่เวลาที่แจ้งเตือน ไม่มีสถานะการคืนค่าหรือยืนยัน แล้วต้องปรับตั้งค่าล็อกหรือการเชื่อมต่อใหม่ ขึ้นกับรุ่นและสถานะข้อมูลในแต่ละโรงงาน
การควบคุมและลด Flood จากแจ้งเตือนโดย AI ปลอดภัยหรือไม่?
ไม่ควรตั้งสมมติฐานว่าจะลด Flood โดยอัตโนมัติในทุกกรณี ต้องปฏิบัติตามลำดับความสำคัญ การจำแนกความปลอดภัย และมาตรการที่ระบุในคู่มือของแต่ละเครื่องจักร แม้ AI จะรวมแจ้งเตือนซ้ำหรือต่อเนื่องให้อ่านง่ายบนหน้าจอ แต่ต้องเชื่อมโยงกลับไปแจ้งเตือนสำคัญต้นฉบับได้ การปรับเปลี่ยนหรือปรับตั้งค่าต้องเป็นไปโดยผู้ดูแลหรือเจ้าหน้าที่ที่รับผิดชอบเท่านั้น
ค่าใช้จ่ายของ AI วิเคราะห์แจ้งเตือนอุปกรณ์คิดอย่างไร?
ขึ้นกับจำนวนอุปกรณ์, จำนวนแท็ก, คุณภาพข้อมูล ประวัติ, วิธีเชื่อมต่อ, การเชื่อมกับใบงาน, หน้าจอหน้างาน, การฝึกอบรม และขอบเขตการทบทวนต่อเนื่อง เปรียบเทียบเฉพาะค่า AI อย่างเดียวไม่เพียงพอ แนะนำคัดเลือกรายการทดลองกับอุปกรณ์เดียว ตรวจข้อมูลและเงื่อนไขรับงานให้ชัดเจนก่อนสอบราคา
จะตรวจสอบความถูกต้องของสาเหตุที่ AI แนะนำได้อย่างไร?
ใช้กรณีในอดีตที่หน้างานยืนยันแน่ชัด แยกตามช่วงเวลาและประเมินแบบเป็นชุด ดูไม่เฉพาะตัวเลือกถูก/ผิด แต่รวมถึงว่าแจ้งเตือนสำคัญด้านความปลอดภัย/คุณภาพหายไปหรือไม่, การย้อนตรวจสอบหลักฐาน, กรณีพักค้างเมื่อไม่ทราบสาเหตุ, เวลาที่ใช้ในการสอบสวน, และการแนะนำผิด ตลอดจนการปรับปรุงโดยใช้ข้อเสนอจากหน้างานและข้อมูลอัปเดตเมื่อเครื่องจักรเปลี่ยนแปลง
สรุป
วัตถุประสงค์ของการนำ AI มาวิเคราะห์แจ้งเตือนเครื่องจักรในอุตสาหกรรม ไม่ใช่เพื่อให้ตัดสินสาเหตุเด็ดขาดจากแจ้งเตือนจำนวนมาก แต่เพื่อจัดลำดับความสัมพันธ์ของเหตุการณ์และชัดเจนว่าแต่ละเวรต้องตรวจสอบจุดใดก่อน จุดเริ่มต้นคือบันทึกแจ้งเตือน รายละเอียดเวลาที่แม่นยำ โครงสร้างเครื่องจักร และข้อมูลการดำเนินงาน ต้องยึดลำดับความสำคัญด้านความปลอดภัยและวิธีการปฏิบัติงานเดิมไว้ ตรวจสอบจอแสดงผลและข้อมูลย้อนหลังแบบเงาคู่ขนานก่อนขยายขอบเขตใช้งาน
แม้อยู่ในขั้นที่ยังเลือกไม่ได้ว่าจะใช้อุปกรณ์ใด หรือข้อมูลประวัติช่วยได้แค่ไหน สามารถสอบถามได้ที่ TOMAS TECH ติดต่อเรา โดยจะช่วยตรวจสอบโครงสร้างเครื่องจักรและขั้นตอนสอบสวนปัจจุบัน เพื่อตีกรอบข้อมูลที่จำเป็นสำหรับการเริ่มต้นแบบขนาดย่อม
ข้อมูลอ้างอิง
- ISA, ISA-18 Series of Standards: วงจรชีวิตระบบแจ้งเตือน ลำดับความสำคัญ การเฝ้าระวังสมรรถนะ
- ISA, Alarm management life cycle: การจัดหมวดหมู่ การบันทึก การฝึกอบรม การเปลี่ยนแปลง
- OPC Foundation, OPC UA Part 9: Alarms & Conditions: โมเดล Condition กับ Event
- OPC Foundation, OPC UA Part 11: Historical Access: ข้อกำหนดเหตุการณ์ในประวัติ
- UK Health and Safety Executive, Alarm management: หลักการแจ้งเตือนที่จำเป็นแก่พนักงานเดินเครื่อง
- EEMUA, Publication 191: แนวปฏิบัติออกแบบ/บริหารระบบแจ้งเตือน
- NIST, AI RMF Core: หลักการกำกับดูแล ประเมินความเสี่ยง และการควบคุมด้วยมนุษย์


