


Bạn đã bắt đầu PoC “phát hiện bất thường thiết bị”, nhưng sau 90 ngày thứ còn lại chỉ là một bảng điều khiển và hàng loạt cảnh báo—để tránh thất bại này tại nhà máy ở Thái Lan, cần xác định tiêu chí nghiệm thu trước cả khi lựa chọn công nghệ. Bài viết không lặp lại những kiến thức chung về hệ thống phát hiện bất thường thiết bị hay cách chọn cảm biến, mà chỉ tập trung vào thiết kế một PoC 90 ngày cho thiết bị quay, đủ rõ để kết luận “Đạt”, “Đạt có điều kiện” hoặc “Không đạt”. Thời gian phát hiện sớm, cảnh báo sai và bỏ sót, cảnh báo 4 cấp, mất kết nối và thiếu dữ liệu cảm biến, lệnh công việc bảo trì trên CMMS, ranh giới trách nhiệm, FAT/SAT và điều kiện kết thúc đều được tích hợp vào một đặc tả nghiệm thu thống nhất.
Ngoại trừ các số liệu công khai có ghi nguồn, mọi số ngày, số trường hợp, tỷ lệ và chi phí trong bài đều là “mô hình giả định”. Giá trị tiêu chuẩn thực tế phải được xác định theo chế độ hư hỏng của thiết bị, mô hình vận hành, yêu cầu an toàn, cơ cấu bảo trì và chất lượng mạng của từng nhà máy.
Vì sao không thể đánh giá PoC phát hiện bất thường thiết bị chỉ bằng câu hỏi “có phát hiện được hay không?”
Một hệ thống giám sát tình trạng có thể nhanh chóng đi đến bước lấy dữ liệu từ cảm biến và vẽ biểu đồ. Tuy nhiên, thứ nhà máy muốn mua không phải là biểu đồ, mà là năng lực bảo trì: “Ai sẽ đưa ra quyết định gì, vào lúc nào, và tạo công việc nào để tránh dừng máy ngoài kế hoạch?”. Vì vậy, đối tượng nghiệm thu PoC không chỉ là thuật toán, mà là toàn bộ chuỗi sau:
- Tình trạng thiết bị thay đổi.
- Cảm biến thu được tín hiệu hợp lệ.
- Thiết bị edge xử lý, đồng thời phân biệt thiếu dữ liệu với mất kết nối.
- Hệ thống phát hiện bất thường thiết bị hiển thị tình trạng theo từng cấp.
- Người phụ trách nhận thông báo và xác nhận tính hợp lý.
- Lệnh công việc được tạo trên CMMS hoặc sổ quản lý bảo trì.
- Kết quả kiểm tra, sửa chữa được phản hồi về sự kiện bất thường.
- Cảnh báo sai, bỏ sót và thời gian phát hiện sớm được tính lại.
ISO 17359:2018 đưa ra quy trình chung cần xem xét khi thiết lập chương trình giám sát tình trạng máy móc, bao gồm khung đánh giá thiết bị, mức độ quan trọng, chế độ hư hỏng và phương pháp giám sát. Bộ tiêu chuẩn ISO 13374 đề cập đến xử lý, truyền thông và trình bày thông tin giám sát tình trạng. Các tiêu chuẩn này không đưa ra ngưỡng đạt cho một sản phẩm cụ thể, nhưng phù hợp với tư duy đặc tả toàn bộ luồng thông tin đến quyết định, thay vì chỉ nghiệm thu độ chính xác cảm biến rồi kết thúc.
Ngày 2 tháng 9 năm 2026, NTN công bố hệ thống CMS cho thiết bị công nghiệp. Theo mô tả của hãng, hệ thống thu thập, phân tích dữ liệu rung và hiển thị theo 4 cấp: “Bình thường”, “Hư hỏng ban đầu”, “Chú ý”, “Cảnh báo”. Hệ thống cũng hỗ trợ ổ bi không do NTN sản xuất, đồng thời NTN cho biết họ hỗ trợ từ khảo sát thiết bị, đánh giá thử nghiệm đến triển khai và vận hành. Về đợt đánh giá thử nghiệm kéo dài 6 tháng trước đó tại một doanh nghiệp tái chế tài nguyên, NTN báo cáo rằng hệ thống đã phát hiện sớm dấu hiệu như vết nứt trên trục quay băng tải, từ đó dẫn đến triển khai chính thức. Đây là thông cáo sản phẩm của chính nhà cung cấp và không bảo đảm kết quả giống nhau tại mọi nhà máy. Tuy nhiên, đây là ví dụ gần đây cho thấy tầm quan trọng của việc đưa “hiển thị đa cấp” và “kết nối từ thử nghiệm đến vận hành” vào thiết kế nghiệm thu.
Tương tự, trong thông cáo sản phẩm ngày 8 tháng 9 năm 2026, Emerson cho biết đã tăng cường truyền dữ liệu liên tục từ hệ thống bảo vệ máy tuabin sang nền tảng phân tích, hỗ trợ phân tích quá trình khởi động và dừng máy kéo dài từ vài giờ đến vài ngày. Nếu chỉ đánh giá PoC trong trạng thái vận hành ổn định, sẽ không thể kiểm tra các giai đoạn dễ phát sinh cảnh báo sai như khởi động, dừng máy, đổi mã hàng, vệ sinh hay thay đổi tốc độ. Trong PoC 90 ngày, cần xác nhận phán đoán có còn đúng khi chuyển qua các trạng thái vận hành khác nhau, chứ không chỉ xem “biểu đồ có ổn định khi vận hành bình thường hay không”.
“Đặc tả nghiệm thu PoC” cần được chốt trong 5 ngày đầu
Nếu thay đổi điều kiện đạt sau khi PoC đã bắt đầu, kết quả đánh giá sẽ bị thiên lệch theo hướng thuận lợi. Trong Ngày 1–5, nhà máy, bộ phận bảo trì, bộ phận IT/OT và bên cung cấp hệ thống phải phê duyệt đặc tả nghiệm thu; mọi thay đổi đều phải có quản lý phiên bản và lý do. Tối thiểu, cần tổng hợp các mục sau trong một bảng truy xuất nguồn gốc duy nhất.
| ID yêu cầu | Đối tượng nghiệm thu | Chỉ số | Ví dụ mô tả điều kiện đạt | Bằng chứng | Người chịu trách nhiệm |
|---|---|---|---|---|---|
| ACC-01 | Phát hiện | Thời gian phát hiện sớm | Xác định số phút từ lúc sự kiện chuẩn bắt đầu đến khi hiển thị Watch theo từng chế độ hư hỏng | Dạng sóng thô, thời điểm sự kiện, nhật ký thao tác | Phụ trách bảo trì |
| ACC-02 | Chất lượng | Tỷ lệ cảnh báo sai | Cố định số cảnh báo được đánh giá, mẫu số và điều kiện loại trừ | Sổ cảnh báo, trạng thái vận hành | Phụ trách dữ liệu |
| ACC-03 | Chất lượng | Tỷ lệ bỏ sót | Cố định định nghĩa sự kiện chuẩn và phương pháp rà soát | Kết quả kiểm tra, hồ sơ hư hỏng | Phụ trách độ tin cậy |
| ACC-04 | Vận hành | Cảnh báo 4 cấp | Xác định người nhận, thời hạn phản hồi và hành động ở mỗi cấp | Lịch sử thông báo, nhật ký phản hồi | Bộ phận bảo trì |
| ACC-05 | Tính sẵn sàng | Mất kết nối, thiếu dữ liệu | Xác định phát hiện, lưu giữ, gửi lại, phục hồi và hiển thị phần thiếu | Nhật ký gateway/edge | Phụ trách OT/IT |
| ACC-06 | Kết nối nghiệp vụ | Lệnh công việc | Tạo lệnh trên CMMS ở cấp mục tiêu, kế thừa ID thiết bị và bằng chứng | Lịch sử CMMS | Phụ trách kế hoạch bảo trì |
| ACC-07 | Lắp đặt | FAT/SAT | Kiểm tra I/O, đồng bộ thời gian, ánh xạ tag, quyền truy cập và phục hồi | Phiếu thử nghiệm đã ký | Nhà máy + bên cung cấp |
| ACC-08 | Kết thúc | Lối ra PoC | Quy tắc quyết định Đạt, Đạt có điều kiện, Không đạt | Biên bản họp đánh giá | Nhà tài trợ |
Một cụm từ như “độ chính xác từ 90% trở lên” không đủ để trở thành tiêu chí nghiệm thu. Chỉ khi quy định rõ sự kiện nào được coi là đáp án đúng, ai xác nhận nhãn, mẫu số gồm những gì, xử lý thời gian thiếu dữ liệu ra sao và có gộp chuỗi cảnh báo liên tiếp từ cùng một sự kiện thành một trường hợp hay không, kết quả mới có thể so sánh được.
Giới hạn ở 3–5 thiết bị và 1–3 chế độ hư hỏng cho mỗi thiết bị
Sau đây là mô hình giả định. Một PoC 90 ngày tại nhà máy Thái Lan theo dõi 4 thiết bị: động cơ, bơm, quạt hút và trục dẫn động băng tải. Với mỗi thiết bị, không giám sát “mọi bất thường”, mà giới hạn các chế độ hư hỏng có thể theo dõi.
| Thiết bị | Chế độ hư hỏng cần theo dõi (giả định) | Tín hiệu chính | Bối cảnh vận hành | Ví dụ loại khỏi PoC |
|---|---|---|---|---|
| Trục dẫn động băng tải | Suy giảm ổ bi, mất cân bằng | Rung, nhiệt độ | Tốc độ, tải, có/không có vật liệu | Lệch băng, kẹt dị vật |
| Bơm nước làm mát | Suy giảm ổ bi, dấu hiệu xâm thực | Rung, áp suất, dòng điện | Lưu lượng, độ mở van | Bản thân hiện tượng rò rỉ đường ống |
| Quạt hút | Mất cân bằng, lỏng cơ khí | Rung, tốc độ quay | Độ mở damper | Bất thường chênh áp bộ lọc |
| Động cơ trục chính | Suy giảm ổ bi, xu hướng quá tải | Rung, nhiệt độ, dòng điện | Chủng loại sản phẩm, tốc độ | Hư hỏng bên trong biến tần |
Những gì cảm biến rung có thể và không thể đo được được trình bày chi tiết trong Hướng dẫn thực hành chẩn đoán thiết bị bằng cảm biến rung. Để tìm hiểu về các lớp cảm biến, thu thập và chẩn đoán của toàn hệ thống, cùng các hạng mục chi phí, hãy tham khảo Hướng dẫn triển khai hệ thống bảo trì dự đoán. Bài viết này tập trung vào bước tiếp theo: “nghiệm thu hệ thống ứng viên như thế nào”.
Chia 90 ngày thành 6 giai đoạn
Nếu chỉ mô tả PoC là “tích lũy dữ liệu trong 90 ngày”, những vấn đề quan trọng có thể không được phát hiện cho đến tuần cuối. Hãy chia PoC thành 6 giai đoạn tương ứng với các hạng mục nghiệm thu và đặt cổng phê duyệt trước khi chuyển sang giai đoạn tiếp theo.
| Thời gian | Giai đoạn | Công việc chính | Cổng phê duyệt |
|---|---|---|---|
| Ngày 1–5 | Định nghĩa | Chốt thiết bị, chế độ hư hỏng, chỉ số, vai trò và điều kiện an toàn | Phê duyệt đặc tả nghiệm thu |
| Ngày 6–15 | FAT, chuẩn bị lắp đặt | Thử mô phỏng tag, thời gian, cảnh báo, buffer và kết nối CMMS | FAT đạt |
| Ngày 16–30 | SAT, baseline | Lắp đặt tại hiện trường, nhận diện trạng thái vận hành, xác nhận phạm vi dữ liệu bình thường | SAT đạt |
| Ngày 31–60 | Vận hành đánh giá | Đánh giá thử nghiệm kịch bản, thông báo, thiếu dữ liệu, mất kết nối và tạo lệnh | Đánh giá giữa kỳ |
| Ngày 61–80 | Điều chỉnh, thử lại | Chỉ điều chỉnh ngưỡng và quy tắc trong phạm vi được phê duyệt trước | Phát hành phiên bản đóng băng |
| Ngày 81–90 | Đánh giá nghiệm thu | Đối chiếu nhãn độc lập, tổng hợp KPI, tồn đọng và bàn giao vận hành | Go/Conditional/No-Go |
Không được điều chỉnh mô hình không giới hạn sau Ngày 61. Nếu liên tục chỉnh ngưỡng trong khi xem dữ liệu đánh giá, hệ thống có thể bị quá khớp và chỉ trông tốt trong phạm vi PoC. Cần quy định đối tượng điều chỉnh, số lần và người phê duyệt, rồi đóng băng cấu hình vào Ngày 80. Trên thực tế, nên dùng Ngày 81–90 như một “giai đoạn chưa từng xem” để đánh giá cuối cùng.
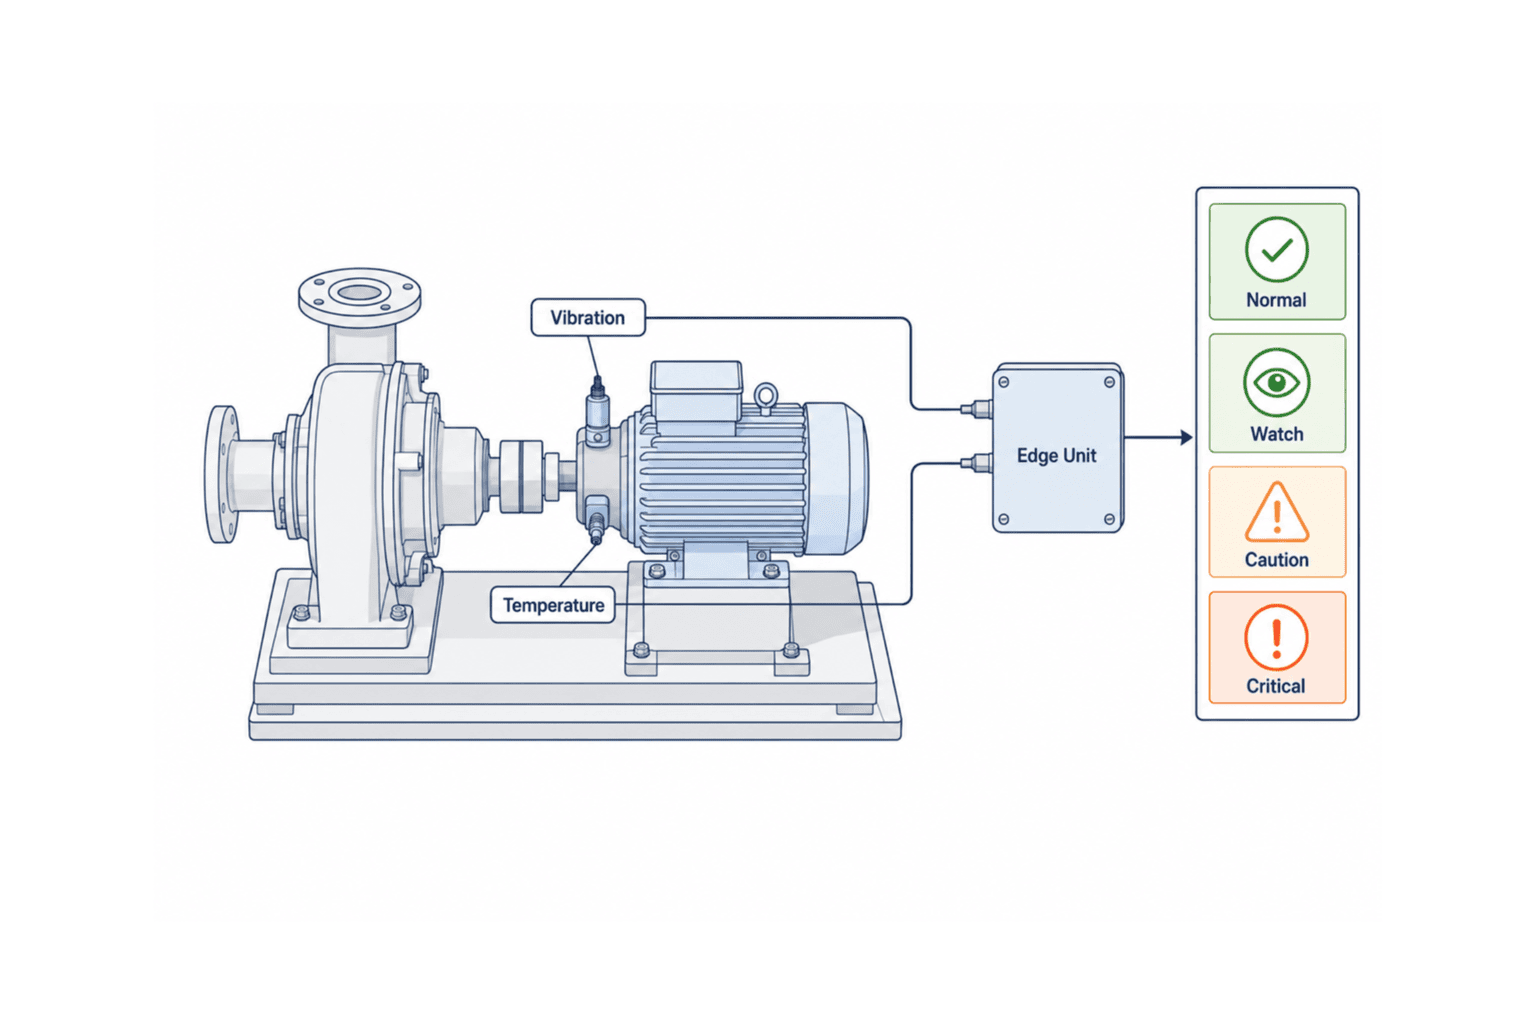
Lấy thời gian phát hiện sớm làm KPI trung tâm của hệ thống phát hiện bất thường thiết bị
Thời gian phát hiện sớm không đơn giản là “bao nhiêu ngày trước khi hỏng”. Nếu mốc thời gian của sự kiện chuẩn không rõ ràng, không thể đo lường. Với mỗi chế độ hư hỏng, cần xác định ba thời điểm sau:
T_signal: Thời điểm chuyên gia đánh giá rằng tín hiệu bắt đầu thay đổi liên tục.T_alert: Thời điểm hệ thống lần đầu tạo cảnh báo hợp lệ từ cấp Watch trở lên.T_action: Thời điểm nhân viên bảo trì xác nhận thông báo và tiếp nhận việc kiểm tra hoặc lệnh công việc.
Độ trễ phát hiện kỹ thuật là T_alert − T_signal, còn độ trễ phản ứng nghiệp vụ là T_action − T_alert. Nếu gọi thời điểm sửa chữa hoặc dừng máy thực tế là T_event, khoảng thời gian có thể hành động là T_event − T_action. Chỉ “phát hiện sớm” chưa đủ, vì có thể đơn giản là cảnh báo sai xuất hiện sớm. Cần đánh giá liệu có đủ thời gian để chuẩn bị phụ tùng, đưa công việc vào kế hoạch dừng máy và thực hiện chẩn đoán thứ cấp hay không.
Không có gì bảo đảm một hư hỏng tự nhiên sẽ xảy ra trong 90 ngày. Vì vậy, cần phân loại riêng các loại bằng chứng sau:
- Sự kiện thực tế: Suy giảm hoặc bất thường thực tế được xác nhận qua kiểm tra hay linh kiện thay thế. Đây là bằng chứng mạnh nhất.
- Phát lại dữ liệu quá khứ: Nạp dạng sóng cũ theo đúng thứ tự thời gian và phát hiện mà không dùng thông tin tương lai.
- Thử nghiệm kịch bản an toàn: Tháo cảm biến, mô phỏng đầu vào, ngắt kết nối, đổi tốc độ và các thử nghiệm không làm hại thiết bị.
- Dấu hiệu qua phân tích: Chuyên gia nhận thấy tín hiệu thay đổi nhưng không thể xác nhận tình trạng linh kiện.
Không được trộn các loại này thành cùng một “ca phát hiện thành công”. Báo cáo PoC phải trình bày kết quả theo từng cấp bằng chứng. Nếu không có sự kiện thực tế nào, không được mô tả là “đã chứng minh hiệu quả dự báo hư hỏng”, mà chỉ nên giới hạn ở “đã xác minh việc thu tín hiệu, đánh giá trạng thái và quy trình vận hành”.
Tính ngược ngưỡng đạt về thời gian phát hiện từ quy trình bảo trì
Trong mô hình giả định, hãy xét một thiết bị cần 4 giờ để sắp xếp kiểm tra, 1 ngày làm việc để xác nhận phụ tùng thay thế và 2 ngày làm việc để điều phối dừng máy có kế hoạch. Khi đó, cảnh báo Critical chỉ xuất hiện ngay trước lúc dừng máy sẽ không hữu ích. Watch hoặc Caution phải tạo đủ thời gian để bắt đầu chẩn đoán thứ cấp, còn Critical được quản lý riêng như giai đoạn cuối theo quy trình vận hành an toàn.
| Cấp | Mục đích | Phản hồi trong mô hình giả định | Bằng chứng nghiệm thu |
|---|---|---|---|
| Normal | Liên tục xác nhận phạm vi bình thường | Rà soát định kỳ | Baseline và trạng thái vận hành |
| Watch | Theo dõi thay đổi ban đầu | Xác nhận xu hướng trong vòng 1 ngày làm việc | Người xác nhận, nhận xét |
| Caution | Quyết định kiểm tra có kế hoạch | Chẩn đoán thứ cấp trong vòng 4 giờ, tạo lệnh nếu cần | Dạng sóng, chẩn đoán, số WO |
| Critical | Đánh giá rủi ro ngay lập tức | Xác nhận ngay theo quy trình an toàn và dừng máy của nhà máy | Thông báo, xác nhận, lịch sử thao tác |
Tên các cấp này chỉ là ví dụ thiết kế trong bài. Dù gần với khái niệm “Bình thường, Hư hỏng ban đầu, Chú ý, Cảnh báo” trong thông cáo của NTN, chúng không đại diện cho logic đánh giá hay hiệu năng sản phẩm của hãng. Nếu xung đột với tên andon hoặc cảnh báo hiện có của nhà máy, hãy ưu tiên xác định “ai phải làm gì trong bao nhiêu phút” hơn là tên gọi.
Quản lý cảnh báo sai và bỏ sót trong cùng một bảng
Trong phát hiện bất thường, giảm cảnh báo sai có thể làm tăng bỏ sót, còn giảm bỏ sót có thể làm tăng cảnh báo sai. Nếu chỉ đưa một phía vào điều kiện đạt, cấu hình có thể bị đẩy đến cực đoan. Tối thiểu phải báo cáo đồng thời các chỉ số sau:
- Dương tính thật (TP): Có cảnh báo hợp lệ trong khoảng thời gian cho phép đối với sự kiện chuẩn.
- Dương tính giả (FP): Có cảnh báo cần xử lý dù không có sự kiện chuẩn.
- Âm tính giả (FN): Có sự kiện chuẩn nhưng không có cảnh báo hợp lệ trong khoảng thời gian cho phép.
- Âm tính thật (TN): Không có sự kiện chuẩn và cũng không có cảnh báo cần xử lý trong cửa sổ đánh giá.
Tuy nhiên, nếu trong chuỗi thời gian liên tục coi “mỗi giây” là một trường hợp, số TN sẽ cực lớn và độ chính xác bề ngoài sẽ gần 100%. Với PoC tại nhà máy, thực tế hơn là xác định mẫu số theo sự kiện hoặc theo ngày-thiết bị. Ví dụ, có thể đặt trước quy tắc chống lặp rằng các thông báo liên tiếp trong vòng 30 phút đối với cùng thiết bị và cùng chế độ hư hỏng được gộp thành một sự kiện.
| Chỉ số | Ví dụ định nghĩa | Lưu ý khi diễn giải |
|---|---|---|
| Độ nhạy theo sự kiện | TP ÷ (TP + FN) | Độ bất định lớn nếu có ít sự kiện chuẩn |
| Độ chính xác cảnh báo | TP ÷ (TP + FP) | Gần với độ tin cậy của thông báo mà hiện trường phải xử lý |
| Tải cảnh báo sai | Số FP ÷ số ngày-thiết bị giám sát | Liên quan trực tiếp đến tải nhân sự và dễ giải thích |
| Số trường hợp bỏ sót | Số tuyệt đối và mức độ nghiêm trọng của FN | Không làm loãng sự cố an toàn hoặc dừng máy nghiêm trọng bằng tỷ lệ |
| Tỷ lệ tuân thủ phản hồi | Số trường hợp xác nhận đúng hạn ÷ số trường hợp cần xử lý | Bao gồm cả năng lực vận hành, không chỉ hệ thống |
Không để riêng bên cung cấp hệ thống quyết định “đáp án đúng”
Cuộc họp xác nhận nhãn cần có bảo trì hiện trường, kỹ thuật thiết bị, vận hành và khi cần là chuyên gia chẩn đoán của bên cung cấp. Để tránh tự chấm điểm, hãy ẩn điểm số của hệ thống và xác định sự kiện chuẩn dựa trên dạng sóng, nhiệt độ, tải, kết quả kiểm tra, linh kiện thay thế và nhật ký vận hành. Những trường hợp còn bất đồng được phân loại là “không chắc chắn”, tách khỏi KPI chính và đưa vào phân tích độ nhạy.
Các điều kiện được phép loại khỏi cảnh báo sai cũng phải được xác định trước, ví dụ giai đoạn chạy rà ngay sau lắp cảm biến, va đập trong bảo trì định kỳ, thi công khi máy dừng hoặc vận hành ngoài dải tốc độ. Nếu về sau mới loại trừ với lý do “đó là vận hành đặc biệt”, kết quả có thể bị cải thiện một cách tùy tiện. Ngược lại, khởi động, dừng máy và chuyển đổi chủng loại hằng ngày không phải là tình huống đặc biệt. Như thông cáo năm 2026 của Emerson tập trung vào dữ liệu dài hạn trong quá trình khởi động và dừng máy, các trạng thái chuyển tiếp cần được đưa vào thiết kế giám sát.
Chuyển cảnh báo 4 cấp từ “màu sắc” thành hành động
Ngay cả khi màn hình giám sát tình trạng hiển thị màu xanh, vàng, đỏ, PoC vẫn chưa thành công nếu quy trình bảo trì không thay đổi. Mỗi cấp trong 4 cấp phải có điều kiện đánh giá, thông báo, thời hạn, thẩm quyền và điều kiện giải trừ.
| Hạng mục | Normal | Watch | Caution | Critical |
|---|---|---|---|---|
| Đánh giá | Trong baseline bình thường | Thay đổi ban đầu kéo dài | Nhiều chỉ số hoặc chẩn đoán cho thấy cần kiểm tra | Trạng thái nghiêm trọng hoặc biến đổi đột ngột |
| Thông báo | Không / báo cáo ngày | Dashboard + người phụ trách | Nhóm bảo trì + giám sát viên | Mạng liên lạc khẩn cấp của nhà máy |
| Thời hạn | Định kỳ | 1 ngày làm việc (ví dụ) | 4 giờ (ví dụ) | Quy trình ngay lập tức |
| Hành động | Tiếp tục giám sát | Xác nhận xu hướng và trạng thái vận hành | Đo thứ cấp, tạo lệnh CMMS | Xác nhận an toàn; người có thẩm quyền quyết định dừng máy |
| Giải trừ | Tiếp tục | Bình thường trong khoảng nhất định hoặc được phê duyệt | Kết quả kiểm tra và phê duyệt | Phê duyệt khởi động lại sau khi xử lý nguyên nhân |
Điều quan trọng là không để hệ thống phát hiện bất thường tự động quyết định dừng thiết bị. Phải phân tách vai trò giữa hệ thống bảo vệ và hệ thống giám sát tình trạng; quyết định dừng máy tuân theo thiết kế an toàn và hệ thống thẩm quyền hiện có. Không được hiểu cảnh báo giám sát tình trạng là sự thay thế cho hệ thống an toàn hoặc rơ-le bảo vệ.
Việc tăng và giảm cấp cảnh báo cần có hysteresis, thời gian duy trì và điều kiện ức chế. Ví dụ, không tăng ngay lên Caution chỉ vì vượt ngưỡng một lần; chỉ tăng cấp nếu trạng thái kéo dài trong một khoảng thời gian nhất định ở điều kiện vận hành cụ thể. Khi giảm cấp, không dùng cùng ranh giới với lúc tăng mà dùng ngưỡng phục hồi thấp hơn và thời gian xác nhận để tránh dao động qua lại. Các giá trị cụ thể này cũng là mô hình giả định, được thử bằng tín hiệu đưa vào ở FAT và xác nhận với tín hiệu hiện trường ở SAT.
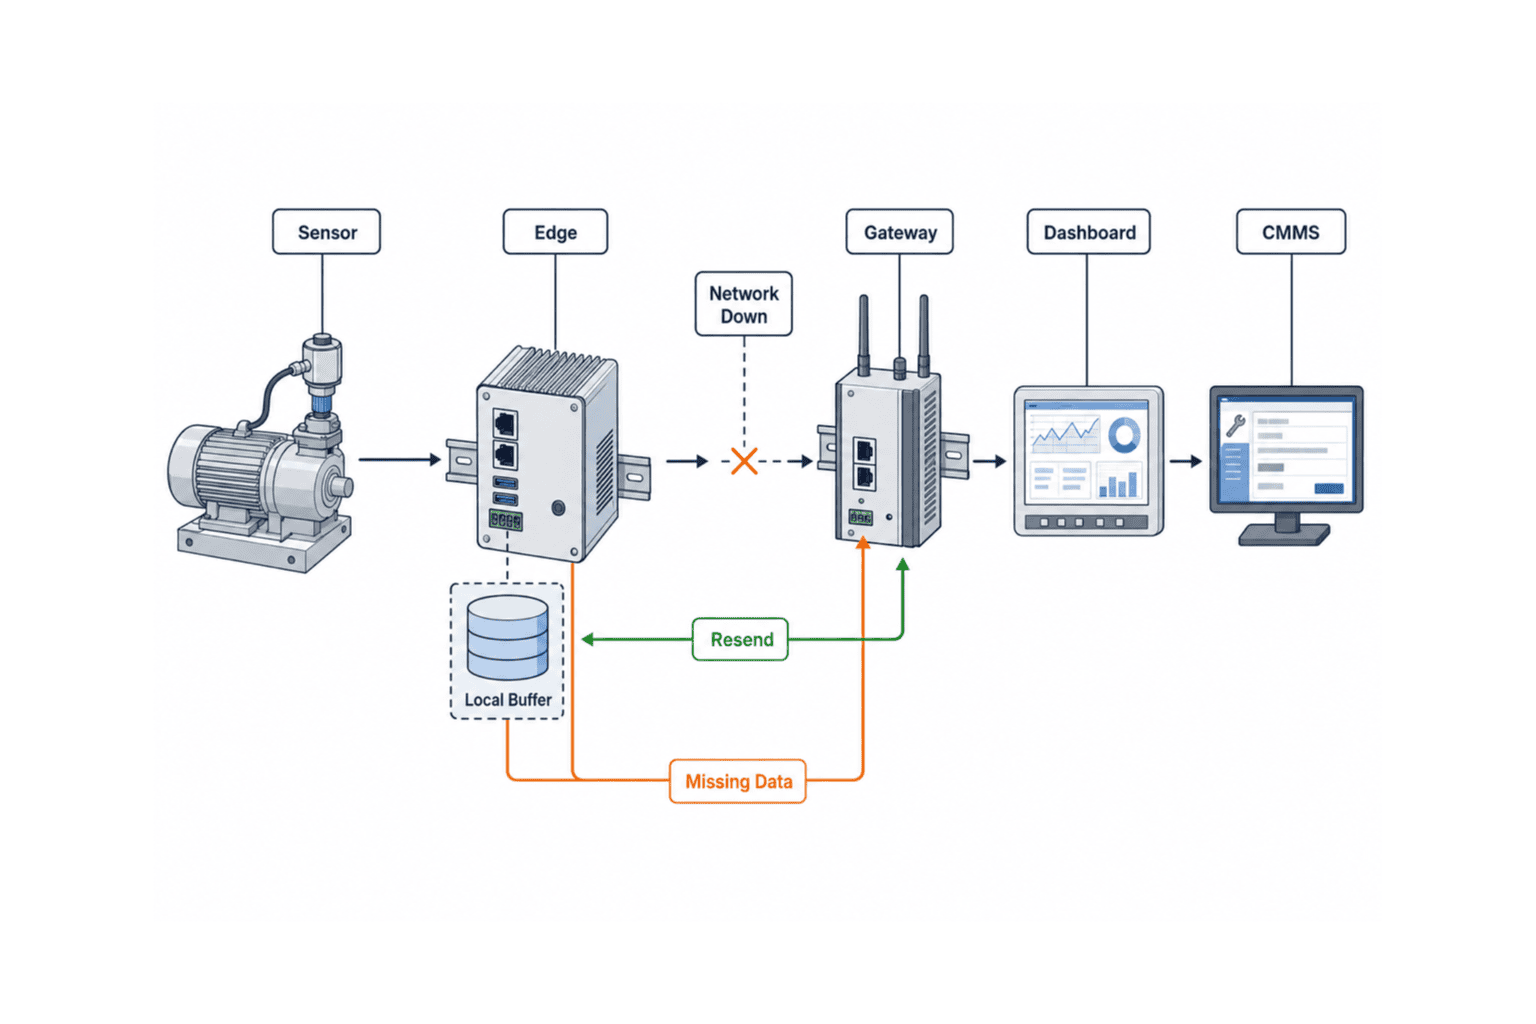
Không hiển thị mất kết nối và thiếu dữ liệu cảm biến là “bình thường”
Một trong những hiểu lầm nguy hiểm nhất trong PoC là coi khoảng thời gian không có dữ liệu là không có bất thường. Mất kết nối, hỏng cảm biến, hết pin, gateway dừng, sai cấu hình tag hay lệch đồng bộ thời gian đều không phải bằng chứng thiết bị bình thường. Cần có trạng thái chất lượng dữ liệu tách biệt với giá trị trạng thái thiết bị.
| Chất lượng dữ liệu | Hiển thị | Đánh giá cảnh báo | Hành động bắt buộc |
|---|---|---|---|
| Good | Thời điểm mới nhất và chu kỳ cập nhật bình thường | Đánh giá bình thường | Tiếp tục |
| Delayed | Trễ quá thời gian quy định | Không coi giá trị cuối là bình thường | Thông báo trễ, kiểm tra buffer |
| Missing | Tỷ lệ thiếu vượt mức cho phép | Đặt đánh giá trạng thái thành “không rõ” | Kiểm tra cảm biến, nguồn và đường truyền |
| Invalid | Ngoài phạm vi, giá trị cố định, thời gian đảo ngược… | Loại khỏi đánh giá | Kiểm tra hiệu chuẩn, tag và thời gian |
| Recovering | Đang gửi lại và đối soát sau kết nối lại | Phân biệt dữ liệu mới và cũ | Loại bỏ trùng lặp, sắp đúng thứ tự, thông báo hoàn tất |
Nghiệm thu buffer và cơ chế gửi lại ở phía edge
Trong PoC 90 ngày, chủ động ngắt mạng để kiểm tra các nội dung sau:
- Gateway phát hiện mất kết nối trong thời gian quy định.
- Thiết bị edge giữ dữ liệu cục bộ.
- Dashboard không đứng yên ở “Normal” mà hiển thị trễ hoặc không rõ.
- Sau khi phục hồi, dữ liệu được gửi lại với thông tin thời gian được giữ nguyên.
- Không tạo sự kiện trùng lặp và hiển thị rõ khoảng dữ liệu bị thiếu.
- Nếu cần đánh giá cục bộ trong thời gian mất kết nối, đường thông báo thay thế phải hoạt động.
Trong mô hình giả định, nếu thiết kế lưu đặc trưng theo phút trong 72 giờ, FAT phải xác nhận tính toán dung lượng và hành vi khi đầy; SAT phải xác nhận việc ngắt kết nối có kế hoạch khoảng 2 giờ và gửi lại. “72 giờ” không phải giá trị khuyến nghị, mà là tham số được quyết định từ mục tiêu phục hồi, chất lượng truyền thông và độ chi tiết dữ liệu của nhà máy.
Trong thông cáo ngày 8 tháng 9 năm 2026, SKF mô tả Insight bearing của hãng, lấy tải, tốc độ, nhiệt độ và rung từ bên trong ổ bi, cùng một nền tảng phần cứng tích hợp cảm biến, xử lý và truyền thông. Đây phải được đọc như thông cáo sản phẩm của SKF, không phải bảo đảm hiệu năng chung. Mặt khác, cảm biến, xử lý và truyền thông càng tích hợp, càng quan trọng phải xác định trong thử nghiệm nghiệm thu dữ liệu bị thiếu ở lớp nào. Trong thông cáo ngày 10 tháng 9 năm 2026, Telit Cinterion cũng thông báo sẽ trình diễn phát hiện và phục hồi lỗi ở edge trên dây chuyền robot đang hoạt động. Ngay cả khi áp dụng phục hồi tự động, sự kiện phục hồi, thời gian dừng, dữ liệu bị mất và biện pháp đã thực hiện vẫn phải có khả năng kiểm toán.
Kết nối hệ thống giám sát tình trạng với lệnh công việc bảo trì
Nếu IoT chẩn đoán thiết bị dừng ở dashboard, nhân viên hiện trường phải xem một màn hình riêng rồi nhập tay. Hãy đưa vào phạm vi nghiệm thu PoC đường tạo lệnh công việc CMMS hoặc yêu cầu kiểm tra từ các sự kiện cấp Caution trở lên. Nếu khó tự động tạo lệnh hoàn toàn, có thể dùng nút phê duyệt để tạo bản nháp.
Tối thiểu cần chuyển tiếp các trường sau:
- ID duy nhất của nhà máy, dây chuyền và thiết bị
- ID cảm biến và vị trí đo
- Cấp cảnh báo, thời gian bắt đầu và thời lượng
- Chế độ hư hỏng nghi vấn và độ tin cậy (nếu có)
- Liên kết đến dạng sóng, xu hướng và điều kiện vận hành
- Nội dung xác nhận tiếp theo được khuyến nghị (hạng mục kiểm tra, không phải lệnh dừng máy)
- ID sự kiện nguồn
- Người phụ trách, thời hạn và mức ưu tiên
Khi hoàn tất, kết quả công việc phải được trả ngược lại. Sử dụng mã kết quả được quản lý như “không có bất thường”, “siết lại”, “bôi trơn”, “thay ổ bi”, “lỗi cảm biến”, “biến động do điều kiện vận hành”, thay vì chỉ nhập tự do. Nếu không có vòng kín này, sau 90 ngày hệ thống vẫn không học được từ cảnh báo sai và ban lãnh đạo cũng không thể giải thích thời gian dừng đã tránh được hay hiệu quả bảo trì.
Kịch bản nghiệm thu kết nối lệnh công việc
| Kịch bản | Đầu vào | Kết quả kỳ vọng |
|---|---|---|
| Caution lần đầu | Sự kiện thiết bị hợp lệ | 1 bản nháp WO, kèm ID thiết bị và liên kết bằng chứng |
| Cùng sự kiện tiếp diễn | Cùng chế độ hư hỏng trong 30 phút (giả định) | Không tạo hàng loạt lệnh mới, cập nhật sự kiện hiện có |
| Tăng lên Critical | Tăng từ Caution | Cập nhật WO hiện có lên ưu tiên cao, thông báo giám sát viên |
| Xác nhận cảnh báo sai | Kiểm tra thấy thiết bị bình thường, xác định được nguyên nhân | Trả mã kết quả về sự kiện bất thường |
| Gửi lại sau khi phục hồi kết nối | Sự kiện có thời điểm quá khứ đến hệ thống | Tách thời điểm phát sinh và thời điểm nhận, không tạo lệnh trùng |
| Không khớp danh mục thiết bị | ID thiết bị chưa đăng ký | Không tự động tạo lệnh; cách ly và thông báo lỗi cấu hình |
Phân định trách nhiệm đến cả “hành động đầu tiên khi xảy ra sự cố”, không chỉ RACI
Một tình huống điển hình khiến PoC đình trệ là khi dữ liệu cảm biến biến mất, bộ phận bảo trì, IT, SIer và nhà cung cấp thiết bị đều chờ bên khác xử lý. Bảng phân định trách nhiệm không chỉ cần người sở hữu, mà phải gồm phát hiện, phân loại ban đầu, bằng chứng, mục tiêu phục hồi và nâng cấp xử lý.
| Lớp | Trách nhiệm chính (ví dụ) | Kiểm tra ban đầu | Bằng chứng phải cung cấp |
|---|---|---|---|
| Cảm biến, lắp đặt | Bộ phận bảo trì + bên cung cấp thiết bị | Nguồn, cố định, hướng, hiệu chuẩn, hư hỏng | Ảnh lắp đặt, model, hiệu chuẩn, điểm đo |
| Edge | SIer / bên cung cấp hệ thống | Tiến trình, dung lượng, thời gian, buffer | Nhật ký edge, phiên bản cấu hình, lịch sử khởi động lại |
| Mạng OT | OT/IT nhà máy | Switch, VLAN, FW, chất lượng không dây | Nhật ký kết nối, lịch sử thay đổi |
| Phân tích, cảnh báo | Bên cung cấp hệ thống + phụ trách độ tin cậy | Phiên bản mô hình, ngưỡng, ức chế, chất lượng đầu vào | Nhật ký suy luận, chênh lệch cấu hình |
| Thông báo, CMMS | IT / kế hoạch bảo trì | API, xác thực, danh mục thiết bị, hàng đợi | Phản hồi API, ID sự kiện, số WO |
| Hành động bảo trì | Bộ phận bảo trì nhà máy | Tiếp nhận, kiểm tra, quy trình an toàn, hoàn tất | Thời điểm phản hồi, nhận xét, kết quả công việc |
Cũng phải phân biệt phát hiện bất thường an ninh mạng với phát hiện bất thường tình trạng thiết bị. NIST IR 8219 đề cập đến phát hiện bất thường mạng dựa trên hành vi trong ICS sản xuất và đánh giá nhiều kỹ thuật nhận diện hành vi bất thường trên mạng. Mục tiêu này khác với chẩn đoán thiết bị bằng rung và nhiệt độ trong bài. Tuy nhiên, khi bổ sung thiết bị giám sát vào mạng OT, không nên loại quản lý tài sản, đường truyền, nhật ký, quyền truy cập và quản lý thay đổi khỏi phạm vi nghiệm thu. Không gộp “bất thường thiết bị” và “bất thường truyền thông” vào cùng một đèn đỏ; cần tách người phụ trách và quy trình xử lý.
Dùng FAT để loại lỗi trước khi mang hệ thống vào nhà máy
FAT (Factory Acceptance Test) được thực hiện bằng đầu vào mô phỏng và môi trường thử nghiệm trước khi lắp đặt tại hiện trường. Ngay cả khi chưa có cảm biến thực, nhiều hạng mục vẫn có thể kiểm tra bằng phát lại dữ liệu hoặc bộ mô phỏng tín hiệu.
Danh sách kiểm tra FAT
- Tag và đơn vị: ID thiết bị, điểm đo, hướng, đơn vị và điều kiện lấy mẫu khớp với từ điển dữ liệu.
- Thời gian: Xác nhận múi giờ và đồng bộ thời gian của edge, gateway, server và CMMS. Chốt quy tắc như hiển thị theo ICT và lưu theo UTC.
- Chuyển đổi 4 cấp: Tái hiện Normal→Watch→Caution→Critical và quá trình phục hồi bằng tín hiệu mô phỏng.
- Hysteresis: Cảnh báo không dao động quanh ranh giới.
- Thiếu dữ liệu: Đưa vào null, giá trị cố định, ngoài phạm vi và thời gian đảo ngược; xác nhận trạng thái “không rõ” hoặc Invalid.
- Mất kết nối: Xác nhận ngắt kết nối, buffer, đầy bộ nhớ, phục hồi, gửi lại và loại bỏ trùng lặp.
- Thông báo: Tên người phụ trách và thiết bị gồm tiếng Thái, tiếng Anh, tiếng Nhật không bị lỗi; người nhận và cơ chế ức chế đúng.
- CMMS: Xác nhận tạo, cập nhật, thất bại, thử lại, chống trùng và trường hợp không khớp danh mục thiết bị.
- Quyền: Tách quyền xem, xác nhận, thay đổi ngưỡng và quản trị viên.
- Kiểm toán: Có thể truy vết ai đã thay đổi cấu hình, xác nhận và giải trừ cảnh báo vào thời điểm nào.
- Quản lý phiên bản: Ghi lại phiên bản mô hình, quy tắc, firmware, cấu hình và từ điển dữ liệu.
- Tệp xuất: Có thể lấy dữ liệu thô, đặc trưng, sự kiện và kết quả công việc theo định dạng đã thỏa thuận.
FAT đạt không có nghĩa là “sẽ đạt hiệu năng tại hiện trường”. Đây là cổng bảo đảm hệ thống có thể thử theo đặc tả và không mang các lỗi giao diện đã biết vào nhà máy. Mọi hạng mục chưa giải quyết phải có mức độ nghiêm trọng, biện pháp tạm thời, thời hạn và người sở hữu. Không chuyển sang lắp đặt nếu còn vấn đề nghiêm trọng về an toàn, tính toàn vẹn dữ liệu hoặc tạo lệnh trùng.
Dùng SAT để nghiệm thu điều kiện hiện trường và vận hành nghiệp vụ
SAT (Site Acceptance Test) được thực hiện sau khi lắp đặt, trên thiết bị và mạng thực tế. Giai đoạn này xác nhận những điều kiện khó tái hiện trên bàn thử như hướng lắp cảm biến, cáp, nguồn, không dây, ID thiết bị, tốc độ quay, tải, rung môi trường, vệ sinh và nhiệt độ.
Danh sách kiểm tra SAT
- Đối chiếu vị trí, hướng, mô-men siết và nhãn nhận dạng cảm biến với bản vẽ.
- Lấy nền nhiễu khi máy dừng và baseline bình thường ở tốc độ, tải đại diện.
- Ghi riêng khởi động, dừng máy, đổi chủng loại, vệ sinh và chạy không tải như các trạng thái vận hành khác nhau.
- Kiểm tra màn hình từ thiết bị tại hiện trường, văn phòng bảo trì và kết nối từ xa được phép.
- Thực hiện ngắt kết nối có kế hoạch; xác nhận hiển thị, lưu cục bộ, phục hồi và gửi lại.
- Chạy xuyên suốt từ sự kiện Watch/Caution mô phỏng đến xác nhận thông báo, tạo lệnh CMMS và phản hồi hoàn tất.
- Thử danh sách liên lạc và cơ chế nâng cấp cho ca đêm, ngày nghỉ.
- Xác nhận người dùng thực tế, bao gồm người nói tiếng Thái, có thể giải thích lý do cảnh báo và hành động tiếp theo.
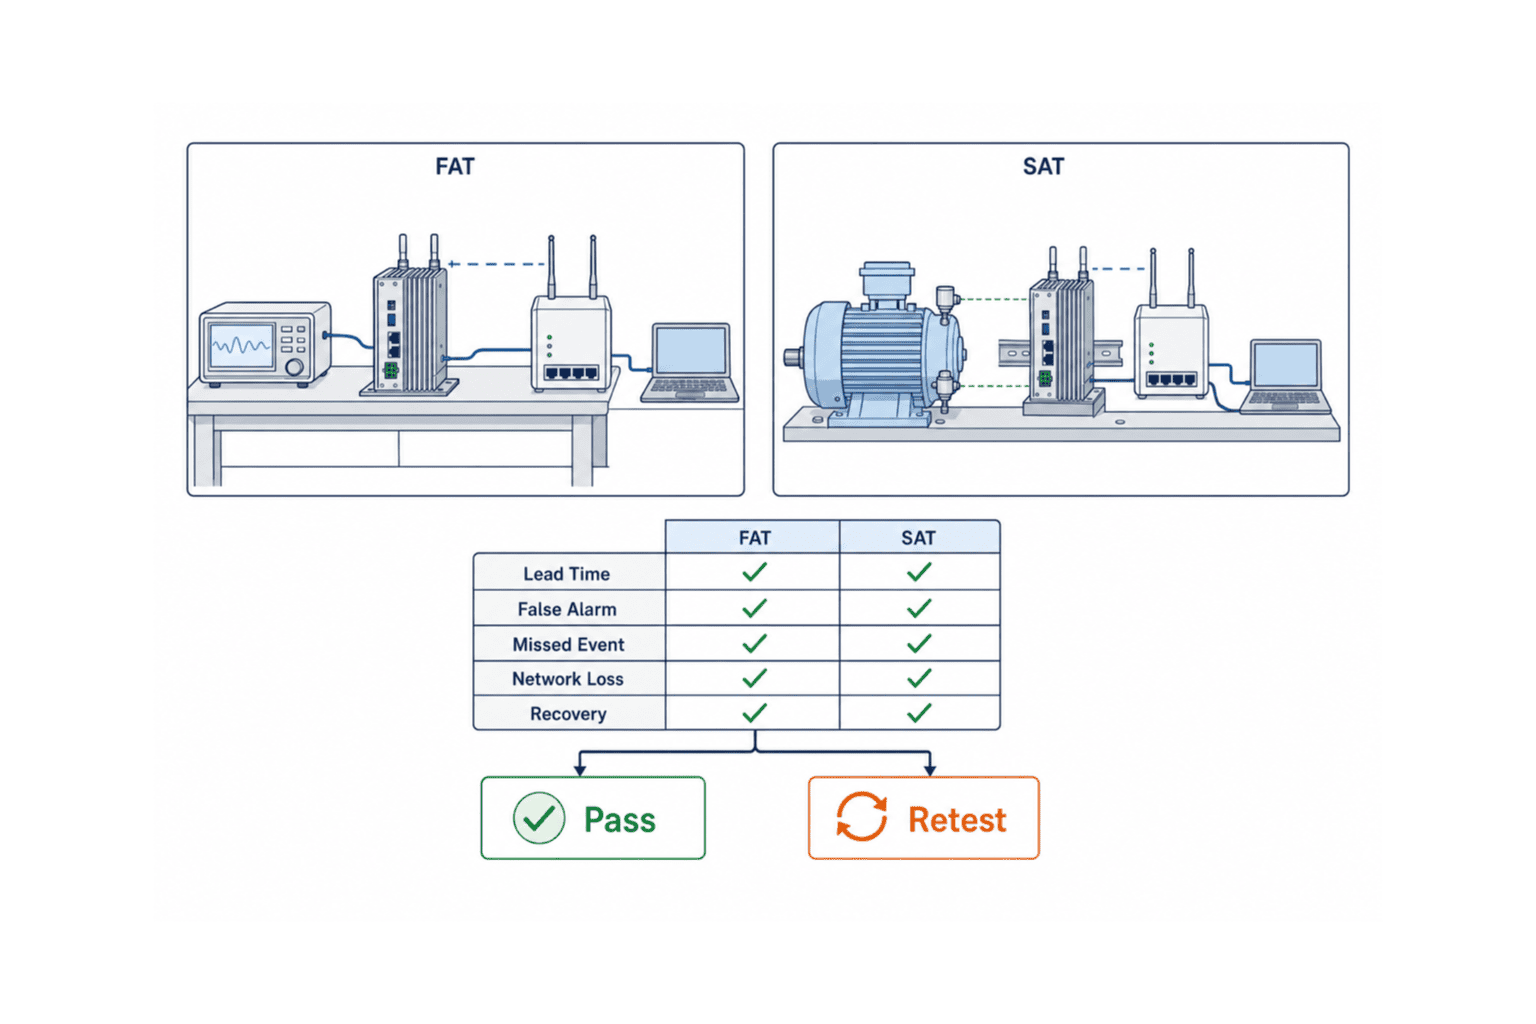
Bằng chứng FAT và SAT không nên chỉ là một tập ảnh chụp màn hình. Phải liên kết ID yêu cầu, quy trình thử, kết quả kỳ vọng, kết quả thực tế, thời gian, tệp dữ liệu, người thực hiện, người phê duyệt và ID lỗi. Tương tự như ISO 13374-3 đề cập đến truyền thông tin giám sát tình trạng giữa các hệ thống, còn ISO 13374-4 đề cập đến việc trình bày thông tin chẩn đoán, tiên lượng và khuyến nghị, điều quan trọng không chỉ là dữ liệu đến được màn hình mà còn phải giữ nguyên ý nghĩa và khả năng hỗ trợ quyết định.
Mô hình tính toán PoC bảo trì dự đoán: thể hiện giá trị quyết định thay vì chỉ chi phí
Sau đây không phải trường hợp khách hàng thực tế mà là mô hình giả định. Giả định theo dõi 4 thiết bị quay quan trọng trong 90 ngày để thu thập bằng chứng cần thiết cho quyết định triển khai. Vì chi phí thay đổi đáng kể theo điều khoản hợp đồng, số cảm biến, phương thức kết nối, công việc tại chỗ và đặc tả CMMS, bảng chỉ trình bày công sức và cấu trúc đánh giá, không đưa số tiền.
| Công việc | Công sức giả định | Sản phẩm bàn giao chính |
|---|---|---|
| Đánh giá thiết bị, xác định chế độ hư hỏng | 4 ngày-người | Bảng đối tượng, điểm đo, phạm vi loại trừ |
| Đặc tả nghiệm thu, phân định trách nhiệm | 3 ngày-người | KPI, RACI, điều kiện kết thúc |
| FAT | 4 ngày-người | Phiếu thử nghiệm đã ký, danh sách lỗi |
| Lắp đặt, SAT | 6 ngày-người | Hồ sơ lắp đặt, baseline, phiếu SAT |
| Giám sát, đánh giá hằng tuần | 12 ngày-người | Sổ sự kiện, lịch sử thay đổi cấu hình |
| Kết nối CMMS, thử vận hành | 5 ngày-người | Bảng ánh xạ API, bằng chứng tạo lệnh |
| Đánh giá cuối, bàn giao | 4 ngày-người | Báo cáo quyết định, kế hoạch mở rộng, tồn đọng |
| Tổng | 38 ngày-người (giả định) | Bộ PoC 90 ngày hoàn chỉnh |
Không khẳng định “đã ngăn một lần dừng máy”; hiệu quả cũng cần được trình bày theo kịch bản.
Tổn thất kỳ vọng tránh được hằng năm = Số lần hư hỏng mục tiêu mỗi năm × Ảnh hưởng dừng máy mỗi lần × Tỷ lệ có thể tránh sau khi phát hiện
Đặt khoảng giá trị cho từng biến và so sánh kịch bản thấp, trung bình, cao. Ngay cả khi không xảy ra hư hỏng trong PoC, vẫn có thể xác nhận thời gian phát hiện sớm và kết nối lệnh công việc có đáp ứng thời gian cần thiết trong kịch bản hay không. Tuy nhiên, khi chưa có bằng chứng hư hỏng tự nhiên, tỷ lệ tránh được vẫn là giả định và không được viết như sự thật trong hồ sơ phê duyệt đầu tư.
Ngược lại, tải cảnh báo sai là chỉ số tương đối dễ đo.
Công sức xử lý cảnh báo sai hằng tháng = Số thiết bị giám sát × FP mỗi thiết bị mỗi ngày × Số ngày vận hành × Thời gian xác nhận mỗi trường hợp
Trong mô hình giả định với 4 thiết bị, 0,1 trường hợp/ngày-thiết bị, 26 ngày vận hành và 15 phút mỗi trường hợp, kết quả là 2,6 giờ/tháng. Phép tính là 4 × 0,1 × 26 × 0,25 = 2,6. Với cùng điều kiện nhưng 1,0 trường hợp/ngày-thiết bị, con số sẽ là 26 giờ/tháng và rất khó duy trì tại hiện trường. Chuyển độ chính xác thành công sức xử lý giúp đánh giá khả năng vận hành dễ hơn so với tranh luận các chữ số thập phân.
Quyết định điều kiện kết thúc PoC trước khi bắt đầu
Đến Ngày 90 mà tự động gia hạn với lý do “hãy thu thập thêm dữ liệu” không còn là PoC, mà là kéo dài trạng thái chưa quyết định. Hãy xác định trước ba lối ra.
Go (tiến tới triển khai chính thức)
- Không còn điểm không phù hợp nghiêm trọng trong FAT/SAT; tồn đọng có thời hạn và người sở hữu.
- Với mỗi chế độ hư hỏng được đánh giá, có kết quả phát hiện ở cấp bằng chứng đã thỏa thuận.
- Tải cảnh báo sai và số bỏ sót nằm trong phạm vi thống nhất trước.
- Khi mất kết nối hoặc thiếu dữ liệu, trạng thái “không rõ” được hiển thị đúng, quá trình phục hồi và gửi lại hoạt động.
- Có thể truy vết từ cảnh báo mục tiêu đến lệnh công việc bảo trì và phản hồi kết quả.
- Phía nhà máy có thể tiếp quản vận hành hằng ngày.
Conditional Go (triển khai có điều kiện)
Chỉ áp dụng khi còn các vấn đề nhỏ không ảnh hưởng an toàn hoặc tính toàn vẹn dữ liệu, đồng thời đã thống nhất thời hạn, bên chịu chi phí, việc thử lại và người chịu trách nhiệm. Ví dụ: cách ghi tên trong danh mục thiết bị chưa thống nhất ở một số thiết bị không quan trọng, hoặc dự kiến sửa cách diễn đạt tiếng Thái trong báo cáo. Không được coi việc bỏ sót phát hiện, che giấu thiếu dữ liệu, tạo lệnh trùng hay sai quyền truy cập là vấn đề có thể “bù bằng vận hành” để cho đạt có điều kiện.
No-Go (dừng hoặc thiết kế lại)
- Chế độ hư hỏng mục tiêu không phù hợp với tín hiệu thu được.
- Không tách được vận hành bình thường khỏi trạng thái chuyển tiếp hằng ngày, khiến tải cảnh báo sai vượt mức cho phép.
- Bỏ sót sự kiện nghiêm trọng và chưa hoàn tất thử lại sau khi xác định, khắc phục nguyên nhân.
- Hiển thị bình thường khi mất kết nối và không truy vết được phần dữ liệu thiếu.
- Không ngăn được tạo lệnh trùng hoặc nhầm thiết bị trong kết nối CMMS.
- Không thống nhất được ai sở hữu thay đổi cấu hình và quyết định cảnh báo.
No-Go không phải là thất bại. Nếu có thể thu hẹp khoản đầu tư tiếp theo—chẳng hạn đổi thiết bị mục tiêu, bổ sung tín hiệu, chuyển sang đo định kỳ hoặc hoàn thiện kết nối CMMS trước—PoC đã hoàn thành vai trò của mình.
Sản phẩm bàn giao cần đưa vào đặc tả mua sắm
Nếu chỉ đặt hàng PoC bảo trì dự đoán như “mượn cảm biến + dùng màn hình”, khi kết thúc có thể không còn dữ liệu hay cấu hình. Tối thiểu phải xác nhận các sản phẩm bàn giao và quyền sử dụng sau trước khi ký hợp đồng.
- Danh sách thiết bị, điểm đo và chế độ hư hỏng
- Bản vẽ lắp cảm biến, model, cấu hình và thông tin hiệu chuẩn
- Từ điển dữ liệu, thời gian, đơn vị và mã thiếu dữ liệu
- Dữ liệu thô hoặc dữ liệu xuất ở độ chi tiết đã thỏa thuận
- Đặc trưng, cảnh báo, thay đổi cấu hình và lịch sử xác nhận
- Phiên bản mô hình, quy tắc, ngưỡng và lý do thay đổi
- Quy trình FAT/SAT và kết quả đã ký
- Đặc tả API/kết nối CMMS và bảng ánh xạ ID thiết bị
- Ranh giới hỗ trợ, xử lý sự cố, sao lưu và phục hồi
- Quy trình tháo dỡ, lưu giữ dữ liệu và xóa tài khoản sau PoC
- Cấu trúc phí giấy phép, truyền thông, bảo trì và đơn giá thiết bị bổ sung khi triển khai chính thức
- Tài liệu đào tạo và quy trình vận hành phía nhà máy
ISO 13374-1 đưa ra hướng dẫn chung về đặc tả phần mềm xử lý, truyền thông và trình bày thông tin giám sát, chẩn đoán tình trạng; Part 3 đề cập trao đổi thông tin giữa các hệ thống, còn Part 4 đề cập trình bày phục vụ phân tích kỹ thuật và hỗ trợ quyết định. Thay vì tùy tiện tuyên bố tuân thủ tiêu chuẩn, cách thực tế là chuyển khả năng di chuyển dữ liệu, giữ nguyên ngữ nghĩa, cách hiển thị và cung cấp thông tin theo từng vai trò thành các câu hỏi mua sắm cụ thể.
FAQ: PoC 90 ngày cho hệ thống phát hiện bất thường thiết bị
Có thể chứng minh độ chính xác của hệ thống phát hiện bất thường thiết bị trong 90 ngày không?
Với thiết bị có tần suất hư hỏng thấp, có thể không xảy ra đủ hư hỏng thực tế trong 90 ngày để chứng minh thống kê độ chính xác dự báo hư hỏng. Những nội dung cần xác nhận trong 90 ngày là chất lượng tín hiệu, nhận diện trạng thái vận hành, khả năng phát hiện bằng dữ liệu đã biết hoặc kịch bản an toàn, tải cảnh báo sai, xử lý thiếu dữ liệu, thông báo, kết nối CMMS và trách nhiệm vận hành. Khi có ít hư hỏng thực, cần nêu rõ cấp bằng chứng và không phóng đại là “đã chứng minh độ chính xác”.
Tỷ lệ cảnh báo sai bao nhiêu phần trăm thì hệ thống giám sát tình trạng đạt?
Không có một đáp án chung. Ngưỡng chấp nhận thay đổi theo mức độ nghiêm trọng, số thiết bị giám sát, công sức xác nhận và mô hình vận hành. Ngoài tỷ lệ, hãy quy đổi thành “cảnh báo sai cần xử lý trên mỗi ngày-thiết bị” và “công sức xác nhận hằng tháng”, đồng thời kiểm tra số trường hợp và mức độ nghiêm trọng của bỏ sót. Phải chốt mẫu số, cách gộp sự kiện và điều kiện loại trừ trước khi bắt đầu.
Cần làm gì khi IoT chẩn đoán thiết bị bị mất kết nối?
Không để giá trị cuối tiếp tục hiển thị Normal. Hãy hiển thị riêng chất lượng dữ liệu như Delayed, Missing hoặc Invalid và đặt tình trạng thiết bị thành “không rõ”. Kiểm tra buffer ở edge, gửi lại có dấu thời gian sau phục hồi, loại bỏ trùng lặp, khoảng thiếu dữ liệu và thông báo thay thế trong FAT/SAT. Thời gian lưu cần thiết phải được thiết kế riêng cho từng nhà máy dựa trên mục tiêu phục hồi và lượng dữ liệu.
PoC bảo trì dự đoán có cần cả FAT và SAT không?
Hai thử nghiệm có vai trò khác nhau. FAT kiểm tra tag, thời gian, chuyển cấp cảnh báo, thiếu dữ liệu, mất kết nối, CMMS và quyền trong môi trường mô phỏng trước khi mang vào nhà máy. SAT kiểm tra lắp đặt, tải thực tế, nhiễu môi trường, mạng, người dùng thực tế và ca đêm tại hiện trường. Ngay cả với PoC nhỏ, tách phiếu thử giúp phân biệt lỗi phần mềm với điều kiện hiện trường.
Cảnh báo 4 cấp có quá nhiều không?
Nếu mỗi cấp không có hành động khác nhau thì đúng là quá nhiều. Trong ví dụ Normal, Watch, Caution, Critical, các cấp tách biệt việc theo dõi, chẩn đoán thứ cấp, kiểm tra có kế hoạch và quyết định khẩn cấp. Nếu quy tắc hiện tại của nhà máy có 3 cấp, không cần ép đổi thành 4 màu. Điều quan trọng là trạng thái, chất lượng dữ liệu, thời hạn thông báo, hành động và điều kiện giải trừ phải rõ ràng, duy nhất.
PoC có không đạt nếu không xảy ra hư hỏng tự nhiên nào không?
Không nhất thiết. Vẫn có thể đánh giá việc phát lại dữ liệu quá khứ, mô phỏng đầu vào an toàn, mất kết nối, thiếu dữ liệu cảm biến, kết nối lệnh công việc và phản hồi vận hành. Tuy nhiên, không thể nói “đã dự báo hư hỏng thành công”. Hãy triển khai theo giai đoạn và đặt cổng đánh giá lại khi đã tích lũy đủ số sự kiện thực tế.
Kết luận: PoC 90 ngày là dự án nghiệm thu, không phải buổi trình diễn sản phẩm
Trong PoC phát hiện bất thường thiết bị tại nhà máy Thái Lan, mục tiêu không phải là cảm biến đưa ra giá trị hay màn hình hiển thị điểm AI. Hãy chốt đặc tả nghiệm thu trong Ngày 1–5 và kết nối thời gian phát hiện sớm, cảnh báo sai và bỏ sót, cảnh báo 4 cấp, chất lượng dữ liệu, phục hồi kết nối, lệnh công việc CMMS và ranh giới trách nhiệm thành một hệ thống thử nghiệm duy nhất. FAT loại bỏ lỗi giao diện và tình huống bất thường; SAT xác nhận điều kiện hiện trường và hành động con người; cấu hình được đóng băng vào Ngày 80. Đến Ngày 90, quyết định một trong ba kết quả Go, Conditional Go hoặc No-Go dựa trên bằng chứng.
Ngay cả trong 90 ngày có ít hư hỏng tự nhiên, vẫn có thể làm rõ điều gì đã được chứng minh và điều gì còn chưa được chứng minh. Một PoC tốt không kết thúc bằng cảm nhận “độ chính xác có vẻ cao”, mà phải trả lời được: “Với thiết bị này, chế độ hư hỏng này và điều kiện vận hành này, hệ thống phát hiện sớm bao nhiêu phút, ai hành động trong bao nhiêu giờ và hồ sơ nào được lưu lại?”.
TOMAS TECH có thể hỗ trợ ngay từ giai đoạn so sánh các hệ thống phát hiện bất thường thiết bị cho nhà máy Thái Lan, xây dựng tiêu chí nghiệm thu cho PoC 90 ngày, lập phiếu thử FAT/SAT và xác định phạm vi kết nối CMMS. Chúng tôi rà soát thiết bị cùng quy trình bảo trì hiện tại, rồi phân tách rõ phạm vi có thể chứng minh và phạm vi phải để lại là chưa được chứng minh. Vui lòng liên hệ TOMAS TECH.
Thông tin tham khảo và nguồn
- NTN Corporation, “産業設備向け状態監視システム(CMS)の提供を開始” (02-09-2026)
https://www.ntn.co.jp/japan/news/new_products/news202600062.html
- Emerson, “Emerson Updates Turbomachinery Protection and Asset Health Monitoring for Safer Operations” (08-09-2026)
- SKF, “SKF advances Insight bearing technology through collaboration with Sentea” (08-09-2026)
- Telit Cinterion, “deviceWISE to Demonstrate Agentic AI and Automated Fault Detection & Recovery on Live Robotic Lines at IMTS 2026” (10-09-2026)
https://www.telit.com/press/devicewise-to-demonstrate-agentic-ai-robotic-at-imts-2026/
- NIST IR 8219, *Securing Manufacturing Industrial Control Systems: Behavioral Anomaly Detection* (2020)
https://nvlpubs.nist.gov/nistpubs/ir/2020/NIST.IR.8219.pdf
- ISO 17359:2018, *Condition monitoring and diagnostics of machines — General guidelines*
https://www.iso.org/standard/71194.html
- ISO 13374-1:2003, *Condition monitoring and diagnostics of machines — Data processing, communication and presentation — Part 1: General guidelines*
https://www.iso.org/standard/21832.html
- ISO 13374-3:2012, *Condition monitoring and diagnostics of machines — Data processing, communication and presentation — Part 3: Communication*
https://www.iso.org/standard/37611.html
- ISO 13374-4:2015, *Condition monitoring and diagnostics of machine systems — Data processing, communication and presentation — Part 4: Presentation*


