


AI-OCR คืออะไร? แนวทางเลือกใช้ ราคา และความแม่นยำสำหรับโรงงานไทย
AI-OCR คืออะไร? AI-OCR คือแนวทางประมวลผลเอกสารที่รวมการรู้จำอักขระจากภาพเข้ากับแมชชีนเลิร์นนิงและความเข้าใจโครงสร้างเอกสาร เพื่อดึงข้อมูลที่ต้องใช้ได้แม้รูปแบบเอกสารจะแตกต่างกัน อย่างไรก็ตาม การเปิดใช้ AI-OCR ไม่ได้ทำให้งานคีย์ข้อมูลหายไปทันที สำหรับโรงงานในประเทศไทย ผลลัพธ์ขึ้นอยู่กับการออกแบบตั้งแต่การรับเอกสาร เกณฑ์ยอมรับความแม่นยำ การตรวจโดยคน PDPA การเชื่อม ERP ไปจนถึงต้นทุนดำเนินงาน บทความนี้อธิบายวิธีตัดสินใจ ตั้งแต่ความต่างของ OCR, AI-OCR และ IDP ไปจนถึง PoC, TCO และ RFP
AI-OCR คืออะไร และต่างจาก OCR กับ IDP อย่างไร
คำขอว่า “ให้อ่านเอกสารนี้” อาจต้องใช้ระบบต่างกันมาก ขึ้นอยู่กับความหลากหลายของเอกสารและขั้นตอนหลังอ่านเสร็จ จึงควรแยกคำศัพท์ก่อนเปรียบเทียบผลิตภัณฑ์
| ประเภท | หน้าที่หลัก | เหมาะกับงาน | สิ่งที่ต้องระวัง |
|---|---|---|---|
| OCR | แปลงตัวอักษรในภาพหรือ PDF เป็นข้อความที่เครื่องอ่านได้ | แบบฟอร์มคงที่ ตัวพิมพ์ชัดเจน การทำ PDF ให้ค้นหาได้ | ไม่ได้รู้เองว่าข้อความใดคือเลขที่ใบสั่งซื้อ |
| AI-OCR | เพิ่มโมเดลเรียนรู้และความเข้าใจเอกสารเพื่อดึงฟิลด์หรือโครงสร้าง | ใบแจ้งหนี้ ใบสั่งซื้อ และเอกสารหลายรูปแบบหรือหลายภาษา | คำว่า “AI” ไม่ได้บอกขอบเขตฟังก์ชันหรือรับประกันความแม่นยำ |
| IDP | รวมการจำแนก การดึงข้อมูล การตรวจสอบ เวิร์กโฟลว์ และการเชื่อมระบบ | งานเอกสารหลายชนิดที่ต้องส่งข้อมูลเข้า ERP อย่างต่อเนื่อง | ต้องออกแบบกระบวนการ ข้อยกเว้น การติดตาม และเจ้าของงาน |
สรุปง่าย ๆ คือ OCR “อ่านข้อความ” AI-OCR “ตีความและดึงข้อมูล” และ IDP หรือ Intelligent Document Processing “บริหารกระบวนการเอกสารตั้งแต่รับจนถึงระบบปลายทาง” ชื่อทางการตลาดไม่ได้เป็นมาตรฐาน จึงต้องถามว่าระบบครอบคลุมการจำแนก OCR เลย์เอาต์ การดึงฟิลด์ การตรวจสอบ หน้าจอให้คนแก้ และการเชื่อมระบบมากน้อยเพียงใด
ถ้าแบบตรวจสอบมีเลย์เอาต์เดียวและต้องการเพียงข้อความสำหรับค้นหา OCR ทั่วไปอาจเพียงพอ แต่ถ้าต้องดึงเลขที่ใบแจ้งหนี้ วันที่ ภาษี ยอดรวม และเลข PO จากซัพพลายเออร์หลายราย AI-OCR จะเหมาะกว่า หากต้องจำแนกเอกสาร แยกหน้า ตรวจยอด ขออนุมัติ บันทึก ERP และเก็บ audit trail ด้วย ขอบเขตนั้นใกล้กับ IDP
เหตุใด OCR เอกสารจึงยากในภาคการผลิตไทย
โรงงานและสำนักงานใหญ่ภูมิภาคในไทยไม่ได้มีเพียงปัญหากระดาษจำนวนมาก แต่ยังมีภาษา รูปแบบผู้ขาย กระบวนการค้า และระบบไอทีหลายชั้น เอกสารที่พบบ่อย ได้แก่ ใบสั่งซื้อ ใบส่งของ ใบแจ้งหนี้ เอกสารภาษี เอกสารนำเข้า-ส่งออก ใบรับรองผลตรวจ คำสั่งผลิต รายงานประจำวัน ใบตรวจเครื่องจักร และเช็กลิสต์ที่มีลายมือเพิ่มเติม
เอกสารชนิดเดียวกันอาจวางตำแหน่งฟิลด์ คอลัมน์ตาราง หน่วย สกุลเงิน และวันที่ไม่เหมือนกัน ภาษาไทย อังกฤษ และญี่ปุ่นอาจอยู่ในหน้าเดียวกัน คุณภาพภาพก็แตกต่าง ทั้งเอียง เงา รอยพับ ตราประทับ ภาพถ่ายโทรศัพท์ หรือสำเนาหลายรุ่น เมื่อดึงข้อมูลแล้ว ERP ยังต้องตรวจรหัสผู้ขาย รหัสสินค้า ประเภทภาษี หน่วย โรงงาน และข้อมูลบัญชี ซึ่ง OCR มองไม่เห็นจากหน้าเอกสาร
เอกสารทางการปัจจุบันของ Google Cloud ระบุว่า Enterprise Document OCR รองรับภาษามากกว่า 200 ภาษา รวมถึงภาษาญี่ปุ่น ไทย และเวียดนาม (ข้อมูลทางการสืบค้นวันที่ 2026-08-28) แต่คำว่า “รองรับภาษา” ไม่ใช่การรับประกันความแม่นยำของเอกสารในแต่ละโครงการ ผลลัพธ์ขึ้นกับคุณภาพภาพ แบบอักษร ขนาดตัวอักษร ตาราง ลายมือ ภาษาผสม และนิยามฟิลด์ จึงต้องทดสอบด้วยเอกสารจริงขององค์กร

ออกแบบกระบวนการ AI-OCR เป็น 5 ขั้นตอน
ระบบยังไม่ถือว่าเสร็จเพียงเพราะส่ง PDF ไปยัง API และได้รับ JSON กลับมา การใช้งานจริงควรแยกห้าขั้นตอนพร้อมตัวควบคุมที่วัดได้
1. จำแนกประเภทเอกสาร
ต้องรู้ก่อนว่าไฟล์เป็นใบแจ้งหนี้ ใบสั่งซื้อ ใบส่งของ รายงานตรวจสอบ หรือเอกสารชนิดอื่น ไฟล์ PDF หนึ่งไฟล์อาจรวมหลายเอกสาร จึงอาจต้องแบ่งหน้า หากจำแนกผิด ระบบจะใช้ extractor และกฎฟิลด์บังคับผิดชุด
การจำแนกใช้คำสำคัญ โครงสร้างหน้า โลโก้ หรือคุณลักษณะระดับเอกสารได้ แต่ไม่ควรพึ่งโลโก้อย่างเดียว เพราะแบรนด์และแบบฟอร์มเปลี่ยนได้ ควรมีเส้นทาง “ไม่ทราบประเภท” เพื่อไม่บังคับเอกสารความเชื่อมั่นต่ำเข้าสู่คลาสที่รู้จัก และติดตามจำนวนซัพพลายเออร์หรือรูปแบบใหม่
2. รู้จำตัวอักษรและเลย์เอาต์
ขั้นต่อไปคืออ่านตัวอักษร คำ บรรทัด ย่อหน้า ตาราง และช่องเลือก การเก็บพิกัด หมายเลขหน้า และความสัมพันธ์ของเซลล์สำคัญ เพราะระบบต้องแยกยอดที่อยู่ข้างคำว่า Total ออกจากยอดย่อยในตารางรายการ
คุณภาพอินพุตเป็นส่วนหนึ่งของระบบ ควรตรวจทิศทาง ความเอียง ขอบที่ขาด ความมืด แสงสะท้อน การบีบอัด และภาพซ้ำตั้งแต่ทางเข้า การขอให้ถ่ายหรือสแกนใหม่เมื่ออ่านไม่ได้ปลอดภัยกว่าการส่งค่าที่ดูมั่นใจแต่เกิดจากภาพขาดหาย
3. ดึงฟิลด์ข้อมูล
ระบบแปลงผล OCR เป็นฟิลด์ เช่น เลข PO วันที่ใบแจ้งหนี้ สกุลเงิน ยอดก่อนภาษี ภาษี ยอดรวม สินค้า จำนวน และราคาต่อหน่วย ผลลัพธ์ที่มีประโยชน์ควรเป็นข้อมูลโครงสร้างที่มีชื่อฟิลด์ ค่า หน้า ตำแหน่ง และค่าความเชื่อมั่นหรือหลักฐานที่เกี่ยวข้อง
ต้องทำ normalization เพราะฟิลด์เดียวกันอาจเขียนว่า Invoice No., Inv No หรือ Tax Invoice Number วันที่อาจใช้ พ.ศ. หรือ ค.ศ. และตัวคั่นตัวเลขอาจต่างกัน ควรเก็บทั้งค่าที่อ่านได้เดิมและค่าหลังแปลงมาตรฐาน เพื่อการตรวจสอบย้อนหลัง
4. ตรวจสอบความถูกต้อง
อย่าส่งผล AI-OCR เข้า ERP โดยตรงโดยไม่มีตัวควบคุม ให้รวมค่าความเชื่อมั่นกับกฎธุรกิจ เช่น ยอดรวมตรงกับผลรวมรายการหรือไม่ PO มีอยู่จริงหรือไม่ ผู้ขายกับสกุลเงินสอดคล้องหรือไม่ และเลขที่ใบแจ้งหนี้ซ้ำหรือไม่
ค่าความเชื่อมั่นมีประโยชน์ แต่ไม่ได้หมายความว่า 0.9 จะถูกต้องเสมอ ความหมายและการปรับเทียบต่างกันตามบริการ ต้องเทียบคะแนนกับข้อผิดพลาดจริงในข้อมูลตัวแทน ก่อนกำหนด threshold สำหรับ straight-through processing ฟิลด์เสี่ยงสูง เช่น ยอดเงินหรือบัญชีธนาคาร อาจต้องตรวจ master data หรือใช้การอนุมัติเพิ่ม แม้คะแนน OCR สูง
5. เชื่อมระบบหลัก
ข้อมูลที่ผ่านการตรวจจะถูกส่งไป ERP บัญชี MES ระบบเอกสาร หรือเวิร์กโฟลว์อนุมัติ หากระบบเดิมไม่มี API อาจใช้ CSV หรือ RPA แต่ต้องออกแบบการ retry การป้องกันข้อมูลซ้ำ encoding การทำงานพร้อมกัน และ partial failure
เชื่อมโยงรหัสเอกสารต้นฉบับ เวลาประมวลผล เวอร์ชัน processor ค่าที่ดึง ค่าที่แก้ ผู้ตรวจ และเลขรายการ ERP เข้าด้วยกัน เพื่อรองรับการปิดบัญชี audit คำถามจากผู้ขาย วิเคราะห์ปัญหา และปรับปรุงโมเดล
วัดความแม่นยำ AI-OCR อย่างไร
ความแม่นยำ AI-OCR ไม่ควรถูกลดเหลือเลขเปอร์เซ็นต์เดียว การอ่านตัวอักษรอาจดีมาก แต่ถ้าเลข PO หรือยอดรวมผิด ผลทางธุรกิจก็ใช้ไม่ได้ ในทางกลับกัน ความผิดเล็กน้อยในหมายเหตุอาจยอมรับได้ หากฟิลด์บังคับทั้งหมดถูกต้อง
อ่านกรอบทดสอบเพิ่มเติมได้ที่ การประเมินความแม่นยำ AI-OCR สำหรับประเทศไทย โดย PoC ควรแยกการประเมินอย่างน้อยดังนี้
| ชั้นการประเมิน | ตัวชี้วัดตัวอย่าง | คำถามทางธุรกิจ |
|---|---|---|
| การรู้จำข้อความ | ข้อผิดพลาดระดับตัวอักษรหรือคำ | อ่านข้อความต้นฉบับได้เพียงใด |
| การดึงฟิลด์ | ถูก ผิด และหาย แยกตามฟิลด์ | ฟิลด์บังคับน่าเชื่อถือหรือไม่ |
| การจำแนก | ผลถูกและผิดแยกตามชนิดเอกสาร | ส่งเอกสารไปกระบวนการถูกต้องหรือไม่ |
| โครงสร้างตาราง | ความสัมพันธ์แถว คอลัมน์ และเซลล์ | นำเข้ารายการโดยไม่เลื่อนได้หรือไม่ |
| ผลลัพธ์ธุรกิจ | อัตราอัตโนมัติ อัตราตรวจ แก้ไข และเวลา | ลดงานและ lead time จริงหรือไม่ |
สร้างชุดตัวอย่าง PoC ที่เป็นตัวแทน
อย่าใช้เฉพาะแบบฟอร์มสะอาด ควรแบ่งตัวอย่างตามผู้ขาย ชนิดเอกสาร ภาษา ช่องทางรับ คุณภาพภาพ จำนวนหน้า ความยาวตาราง ตราประทับ และลายมือ ให้ผู้ใช้งานธุรกิจช่วยกำหนด ground truth เพื่อให้คำว่า “ถูก” ตรงกับสิ่งที่ระบบปลายทางต้องใช้
ไม่ควรใช้เอกสารชุดเดียวกันทั้งปรับโมเดลและประเมินรับมอบ แยกชุดปรับแต่งกับชุด holdout และตรึงชุดรับมอบไว้จนประเมินเสร็จ บันทึก processor เวอร์ชัน การตั้งค่า และวันที่ เพราะโมเดลบริการอาจอัปเดตได้
กำหนดเกณฑ์รับ PoC จากความเสี่ยง
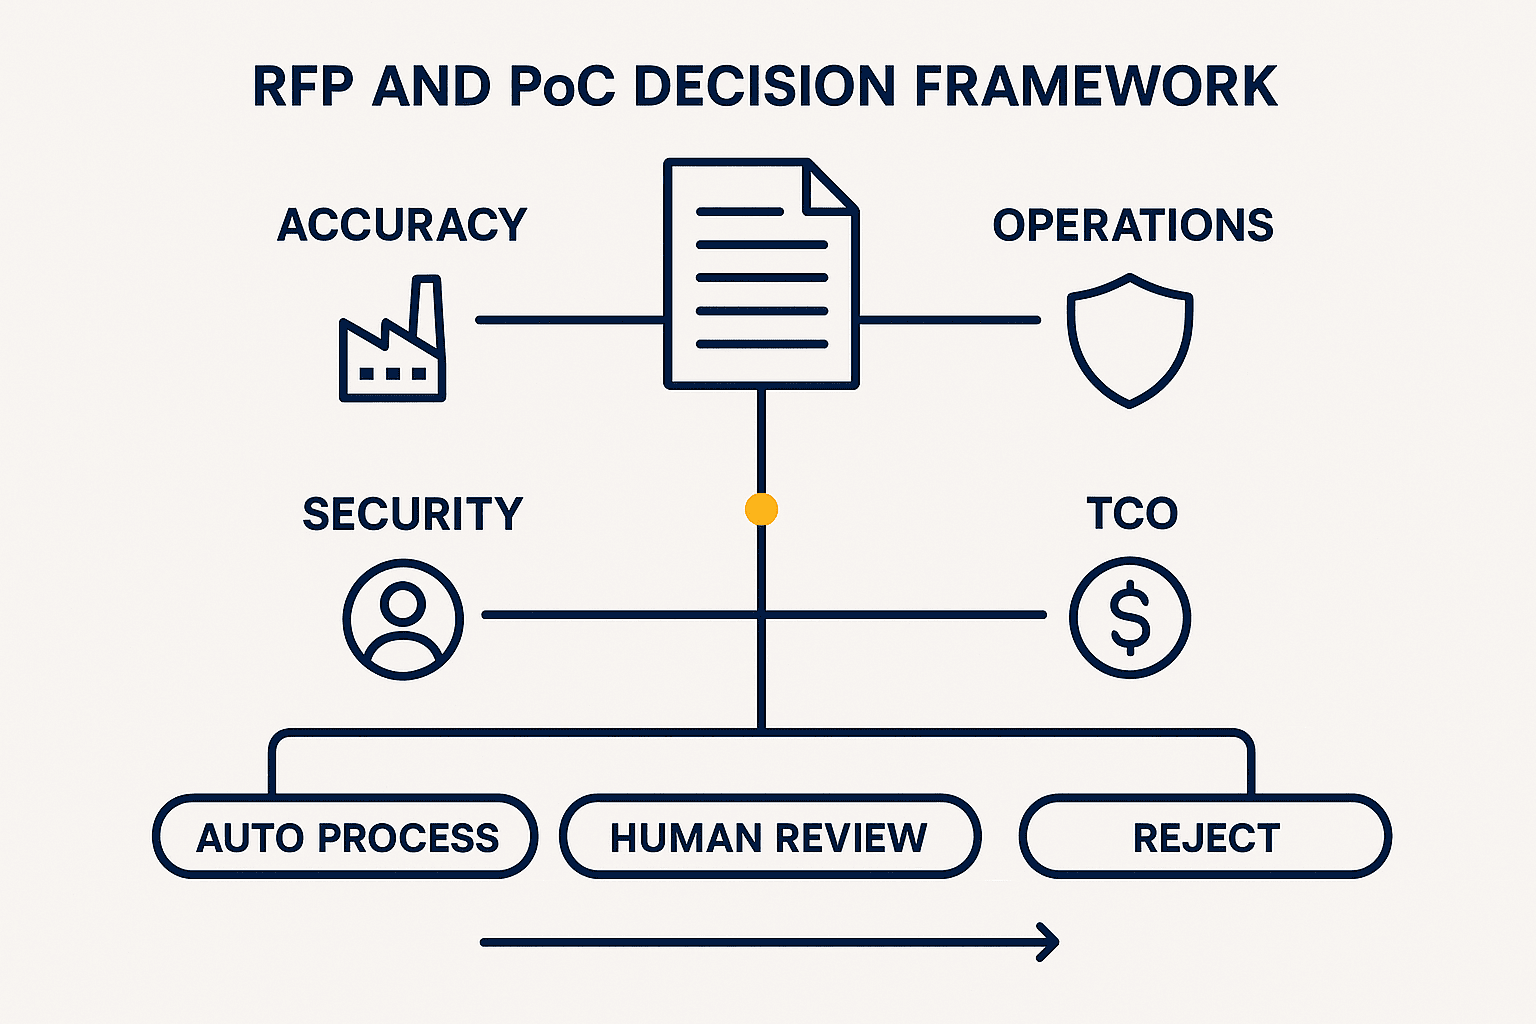
อย่านำค่าเฉลี่ยของผู้ขายมาเป็นเกณฑ์โดยตรง ควรกำหนดความถูกต้องแยกตามฟิลด์สำคัญ จำนวนการพลาดที่ยอมรับได้ เงื่อนไขส่งอัตโนมัติ เงื่อนไขให้คนตรวจ latency throughput ช่วง peak และเวลาฟื้นตัว
แนวทางที่ใช้ได้จริงมีสามเส้นทาง:
- ความเชื่อมั่นสูงและผ่านกฎธุรกิจ: ส่งลงระบบอัตโนมัติ
- บางฟิลด์ไม่แน่นอน: ส่งเฉพาะจุดนั้นให้คนตรวจ
- อ่านไม่ได้หรือขัดแย้งรุนแรง: ปฏิเสธ ขอเอกสารใหม่ หรือตรวจสอบ
เป้าหมายไม่ใช่ทำเหมือนว่า AI ไม่มีความไม่แน่นอน แต่คือป้องกันไม่ให้ข้อมูลที่ไม่แน่นอนไหลลงระบบโดยเงียบ ๆ
Human-in-the-loop คือกลไกควบคุม ไม่ใช่ความล้มเหลว
Human-in-the-loop หมายถึงให้คนยืนยันหรือแก้เฉพาะฟิลด์ที่ระบบอัตโนมัติไม่สามารถตัดสินได้อย่างปลอดภัย เป้าหมายคือเปลี่ยนจากการอ่านทุกหน้าเป็นการดูเฉพาะค่าที่คลุมเครือและข้อผิดกฎ
หน้าจอตรวจควรแสดงภาพต้นฉบับคู่กับค่าที่ดึง ไฮไลต์ตำแหน่ง และแก้ด้วยคีย์บอร์ดได้เร็ว บันทึกค่าก่อนแก้ ค่าหลังแก้ ผู้แก้ และเหตุผล ข้อมูลเหล่านี้ใช้ปรับกฎ แจ้งผู้ขาย หรือปรับโมเดลเมื่อเหมาะสม
อย่าวัดเพียงสัดส่วนเอกสารที่ต้องตรวจ ควรวัดเวลาเฉลี่ยต่อรายการ จำนวนฟิลด์ที่ตรวจ ความเห็นต่างระหว่างผู้ตรวจ คิวสะสมช่วงปลายเดือน และอัตราประมวลผลซ้ำ แม้อัตราอัตโนมัติสูง เอกสารยากจำนวนน้อยก็อาจกินเวลาส่วนใหญ่ได้
แผนดำเนินการ AI-OCR 7 ขั้นตอน
ขั้นที่ 1: จำกัดวัตถุประสงค์ทางธุรกิจ
แทนที่จะตั้งเป้า “เลิกใช้กระดาษทั้งบริษัท” ให้เลือกงานชัดเจน เช่น คีย์ใบแจ้งหนี้ รับใบสั่งซื้อ หรือค้นหาใบตรวจคุณภาพ เก็บปริมาณงาน ช่วง peak เวลาคีย์ การตรวจซ้ำ งานแก้ และผลกระทบของข้อผิดพลาด แล้วตั้ง KPI ที่วัดได้
ขั้นที่ 2: ทำบัญชีรายการเอกสาร
บันทึกชนิดเอกสาร ผู้ออก ภาษา จำนวนหน้า ช่องทางรับ จำนวนเลย์เอาต์ ลายมือ ตาราง ฟิลด์บังคับ และข้อกำหนดเก็บรักษา แยกแบบที่มีปริมาณสูงออกจากข้อยกเว้นที่เกิดน้อยแต่เสี่ยงสูง
ขั้นที่ 3: ออกแบบ To-Be และผู้รับผิดชอบ
กำหนดว่าใครส่งไฟล์ ใครตรวจข้อยกเว้น ใครแก้ master data และใครรับเหตุระบบล่ม แบ่งความรับผิดชอบระหว่างผู้ให้บริการคลาวด์ ผู้ติดตั้ง IT ภายใน เจ้าของกระบวนการ และฝ่ายคุ้มครองข้อมูล
ขั้นที่ 4: เปรียบเทียบเทคโนโลยี การปฏิบัติงาน และสัญญา
Google Cloud Document AI, Azure AI Document Intelligence และ Amazon Textract มีขอบเขต OCR เลย์เอาต์ ตาราง query โมเดลสำเร็จรูป หน่วยราคา และภูมิภาคให้บริการต่างกัน เปรียบเทียบจากฟังก์ชันที่เอกสารของคุณต้องใช้ ไม่ใช่ชื่อแบรนด์ ดูกรอบเพิ่มได้ที่ คู่มือเปรียบเทียบบริการ AI-OCR
ขั้นที่ 5: ทดสอบเกณฑ์รับใน PoC
ใช้ชุดประเมินและ ground truth เดียวกันทุกผู้ขาย ต้องมีเอกสารจริงที่ยาก ไม่ใช่เฉพาะไฟล์เดโม ประเมินงานตั้งค่า หน้าจอตรวจ API monitoring การประมวลผลซ้ำ และการฝึกผู้ใช้ด้วย
ขั้นที่ 6: เริ่ม production ในขอบเขตจำกัด
เริ่มจากผู้ขายบางราย เอกสารหนึ่งกลุ่ม หรือหนึ่งไซต์ ใช้ parallel run ระหว่างปรับ threshold และกฎ ตั้งช่องทาง support แผนทำงานมือ สิทธิ์ เก็บข้อมูล และการตรวจ log ก่อนขยาย
ขั้นที่ 7: บริหารการเปลี่ยนแปลง
แบบฟอร์มใหม่ ผู้ขายเปลี่ยน นโยบายเปลี่ยน โมเดลอัปเดต และ ERP master เปลี่ยนเป็นเรื่องปกติ ทบทวนความแม่นยำแยกฟิลด์ เหตุผลการตรวจ อัตราอัตโนมัติ ข้อยกเว้น เวลา และต้นทุนตามรอบ พร้อม regression test สำหรับกลุ่มสำคัญ

ราคา AI-OCR และการคำนวณ TCO
ราคา AI-OCR เปรียบเทียบด้วย “ราคาต่อหน้า” อย่างเดียวไม่ได้ Cloud API อาจคิดต่างกันตาม processor ฟังก์ชัน ปริมาณหน้า โหมด และ region โดย storage กับ network อาจคิดเพิ่ม SaaS อาจรวมค่ารายเดือน โควตาเอกสาร ผู้ใช้ workflow และ support ราคาเปลี่ยนได้ จึงต้องตรวจหน้าอย่างเป็นทางการและใบเสนอราคาปัจจุบันก่อนอนุมัติ
หน้าอย่างเป็นทางการของ Google Cloud Document AI ระบุ Enterprise Document OCR ที่ 1.50 ดอลลาร์สหรัฐต่อ 1,000 หน้า สำหรับช่วง count 1,000 ถึง 5,000,000 หน้า (ข้อมูลสืบค้นวันที่ 2026-08-28) นี่คืออัตราที่เผยแพร่สำหรับฟังก์ชันและช่วงปริมาณเฉพาะ ไม่ใช่ต้นทุนโครงการทั้งหมด และไม่รวม processor อื่น บริการคลาวด์รอบข้าง ภาษี อัตราแลกเปลี่ยน หรือสัญญารายลูกค้า ราคา Amazon Textract ขึ้นกับฟังก์ชันและ region ต้องตรวจตัวอย่างบนหน้าอย่างเป็นทางการกับ API และ region ที่จะใช้ ส่วน Azure และผู้ขายอื่นก็อาจแตกต่างตามพื้นที่และสัญญา
การทำ business case สามารถใช้ แนวทางราคาและต้นทุน AI-OCR ประกอบ
ต้นทุนที่ควรรวม
| หมวดต้นทุน | รายการหลัก | สิ่งที่มักตกหล่น |
|---|---|---|
| เริ่มต้น | วิเคราะห์งาน ทำ inventory, PoC, ตั้งค่า เชื่อมระบบ ทดสอบ ฝึกอบรม | การทำ ground truth และออกแบบหน้าจอข้อยกเว้น |
| ใช้งาน | OCR/extraction API, license, storage, network | การประมวลผลซ้ำ เรียกหลาย processor และ minimum fee |
| ดำเนินงาน | คนตรวจ monitoring support ดูแล master และปรับกฎ | เอกสารแบบใหม่และกำลังคนช่วง peak |
| กำกับดูแล | security review สัญญา audit log และ PDPA | คำขอเจ้าของข้อมูล การลบ และการโอนข้ามประเทศ |
| การเปลี่ยน | แก้ ERP, API หรือโมเดล และขยายไซต์ | regression test และวิธีทำงานสำรอง |
วัดต้นทุนปัจจุบันด้วยความละเอียดเท่ากัน รวมเวลาคีย์ ตรวจซ้ำ แก้งาน OT ปลายเดือน ความล่าช้าการจ่ายหรือส่งสินค้า การค้นหาเอกสาร และเวลาประสานของหัวหน้างาน อย่าสมมติว่าอัตโนมัติ 100% ให้คำนวณกรณีที่ยังต้องตรวจและปริมาณเพิ่มด้วย
ใช้สูตรประมาณการเดียวกัน
สูตรเปรียบเทียบที่ใช้ร่วมกันได้คือ:
TCO รายเดือน = ค่าพื้นฐาน + ค่าตามปริมาณ + ค่าคลาวด์รอบข้าง + ค่าแรงตรวจ + ค่าดูแล + ค่าเปลี่ยนแปลงเฉลี่ยต่อเดือน
ต้องแปลงปริมาณให้ตรงหน่วยคิดเงิน PDF หลายหน้าสร้างจำนวนหน้าที่คิดเงินหลายหน้า และถ้าส่งหน้าเดียวผ่าน OCR กับ extractor เพิ่มเติม อาจมีหลายองค์ประกอบราคา รวม retry, test และ non-production ด้วย
PDPA สถานที่ตั้งข้อมูล และความปลอดภัย
เมื่อเอกสารมีข้อมูลส่วนบุคคลในไทย การซื้อผลิตภัณฑ์ที่มีใบรับรองไม่ได้ทำให้สอดคล้อง PDPA โดยอัตโนมัติ ต้องระบุข้อมูล วัตถุประสงค์ ฐานกฎหมาย ผู้เกี่ยวข้อง ระยะเก็บ ผู้ประมวลผล การโอนข้ามประเทศ การรองรับคำขอเจ้าของข้อมูล และ incident response แล้วทบทวนกับกฎหมาย DPO และ security บทความนี้ไม่ใช่คำแนะนำทางกฎหมาย
วาด data flow ทั้งหมด
แสดงต้นทาง อุปกรณ์อัปโหลด เครือข่าย region ประมวลผล OCR ที่เก็บชั่วคราว log หน้าจอตรวจ ERP backup และการเข้าถึงของ support คำว่า data location อาจครอบคลุมการประมวลผล backup diagnostic telemetry และ subprocessor ไม่ใช่แค่ storage หลัก ต้องตรวจเอกสารบริการและสัญญา
หากเอกสารมีชื่อ ที่อยู่ โทรศัพท์ ID บัญชีธนาคาร ลายเซ็น หรือข้อมูลส่วนบุคคลอื่น ควรประมวลผลและเก็บเท่าที่จำเป็น ไม่คัดลอกเอกสารจริงเข้าระบบทดสอบโดยไม่มีการควบคุม พิจารณา masking แยกสิทธิ์ จำกัดเวลา และลบอัตโนมัติ
สิ่งที่ต้องยืนยันในสัญญาและการปฏิบัติงาน
- ข้อมูล input และ output ถูกใช้ปรับปรุงบริการหรือฝึกโมเดลหรือไม่
- region ประมวลผลและสถานที่เก็บที่เลือกได้
- การเข้ารหัส การจัดการกุญแจ สิทธิ์ และ log ผู้ดูแล
- ระยะเก็บ วิธีลบ และนโยบายลบจาก backup
- subprocessor กลไกโอนข้อมูล และข้อตกลงประมวลผล
- การแจ้ง incident และการเข้าถึงเนื้อหาของ support
- การส่งออกและยืนยันการลบเมื่อเลิกสัญญา
Government Platform for PDPA Compliance ของ GPPC/PDPC เป็นช่องทางทางการสำหรับเข้าถึงข้อมูลการปฏิบัติตาม PDPA แต่เนื้อหาที่ต้องแจ้ง ฐานกฎหมาย และการโอนข้ามประเทศของแต่ละกรณีควรให้ผู้เชี่ยวชาญตรวจ
RFP สำหรับ AI-OCR ควรถามอะไร
หลีกเลี่ยงคำกว้าง ๆ เช่น “รองรับ AI-OCR” หรือ “ความแม่นยำสูง” ให้กำหนดเงื่อนไขรับมอบและหลักฐาน
| หัวข้อ RFP | คำถาม | หลักฐานที่ควรขอ |
|---|---|---|
| ขอบเขตเอกสาร | รองรับภาษา เลย์เอาต์ ลายมือ ตาราง และหลายหน้าแบบใด | ผล PoC จากตัวอย่างองค์กร |
| ความแม่นยำ | วัดอะไรแยกตามฟิลด์ ภายใต้เงื่อนไขใด | ตารางเทียบ ground truth และตัวอย่างข้อผิดพลาด |
| ข้อยกเว้น | จัดการ low confidence แบบใหม่ และ integration fail อย่างไร | เดโมหน้าจอ ขั้นตอน replay และ flow งาน |
| การเชื่อม | มี API, batch, webhook, ERP และป้องกันซ้ำอย่างไร | API spec, error code และ architecture |
| ความปลอดภัย | ประมวลผล เก็บ เข้ารหัส เข้าถึง และลบที่ใด | ข้อสัญญา assurance report และ data flow |
| การดำเนินงาน | monitoring, SLA, incident และ model update ทำอย่างไร | SLA, support model และ regression plan |
| ราคา | ค่าเริ่มต้น ใช้งาน ขั้นต่ำ retry และ environment เท่าไร | rate card สมมติฐาน และ TCO 3 ปี |
| ทางออก | ย้ายเอกสาร label และ configuration ได้หรือไม่ | รูปแบบ export และขั้นตอนลบ |
กำหนดเงื่อนไขเปรียบเทียบผู้ขายให้เท่าเทียม
ให้ทุกผู้ขายใช้ชุดประเมิน นิยามคำตอบ เวลาทดสอบ และขอบเขตการตั้งค่าเดียวกัน รายงานผลแยกฟิลด์ ชนิดเอกสาร ภาษา และคุณภาพภาพ ไม่ใช่เพียงค่าเฉลี่ย ในเดโมให้ขอดูกรณีล้มเหลว เช่น confidence ต่ำ จำแนกผิด ตารางพัง API หยุด และ ERP ปฏิเสธ ความสามารถในการหยุดอย่างปลอดภัยและกู้คืนมีผลต่อคุณภาพ production พอ ๆ กับการอ่านสำเร็จ
เลือกระหว่าง API, SaaS และการพัฒนาเฉพาะ
แนวทาง Cloud API
ทีมพัฒนารวม OCR หรือ document understanding API กับการจำแนก กฎตรวจ หน้าจอผู้ตรวจ และ ERP ยืดหยุ่น แต่ลูกค้าหรือพาร์ทเนอร์ต้องเป็นเจ้าของแอปและการปฏิบัติงาน API ที่อ่านดีไม่ได้ทำให้กระบวนการธุรกิจครบเอง
แนวทาง SaaS เอกสาร
SaaS มีช่องทางรับ หน้าจอตรวจ workflow และ export จึงเริ่มได้เร็วกว่า แต่ต้องยืนยันเอกสารไทย รูปแบบภาษี ระบบ ERP และกฎอนุมัติ รวมถึงการคิดเงินตามหน้า ผู้ใช้ แบบฟอร์ม integration หรือ support
โมเดลและแอปเฉพาะ
เหมาะกับสัญลักษณ์เฉพาะ ตารางซับซ้อน หรือ flow ของโรงงาน แต่ต้องมีข้อมูลติดป้าย deployment บุคลากรดูแล และ regression test ควรทดสอบ processor สำเร็จรูปกับกฎธุรกิจก่อน แล้วพัฒนาเฉพาะจุดที่มีผลตอบแทนชัดเจน
ข้อผิดพลาดที่พบบ่อย
เลือกจากคำโฆษณา “แม่นยำ 99%”
หากเอกสาร metric และ ground truth ต่างกัน ผลก็เทียบกันไม่ได้ ต้องประเมินฟิลด์บังคับและผลธุรกิจด้วยข้อมูลของตนเอง
เริ่มจากเอกสารทุกชนิด
ขอบเขตจะเต็มด้วยข้อยกเว้นจน PoC ปิดไม่ได้ เริ่มจากงานปริมาณสูง รูปแบบค่อนข้างคงที่ และวัดผลได้
ติดตั้ง OCR แต่คงงานก่อนและหลังไว้ทั้งหมด
ถ้ายังคัดลอกผลเข้า Excel แล้วคีย์ ERP อีกครั้ง ประโยชน์จะจำกัด ต้องวัดทั้งกระบวนการตั้งแต่รับจนบันทึกที่ตรวจแล้ว
ส่งผลลัพธ์ที่มีค่าความเชื่อมั่นต่ำเข้า ERP โดยอัตโนมัติ
ใช้ threshold การกระทบยอด และอนุมัติสำหรับฟิลด์สำคัญ รวม confidence กับ vendor master และการตรวจคณิตศาสตร์
ไม่วัดผลหลัง go-live
แบบฟอร์มและคุณภาพภาพเปลี่ยนเสมอ ต้องติดตามความถูกต้องแยกฟิลด์ เหตุผลที่ต้องตรวจ แบบใหม่ เวลา และต้นทุน
FAQ เกี่ยวกับการนำ AI-OCR มาใช้ ราคา และความแม่นยำ
AI-OCR คืออะไรเมื่อเทียบกับ OCR ปกติ?
OCR ปกติเน้นแปลงภาพเป็นข้อความ ส่วน AI-OCR ใช้ความเข้าใจเอกสารจากโมเดลเพื่อดึงฟิลด์ ตาราง และความสัมพันธ์จากหลายเลย์เอาต์ ชื่อแตกต่างตามผู้ขาย จึงต้องตรวจขอบเขตการจำแนก ดึงข้อมูล ตรวจสอบ หน้าจอสำหรับผู้ตรวจสอบ และ integration
AI-OCR รองรับภาษาไทย ญี่ปุ่น และเวียดนามหรือไม่?
มีบริการที่รองรับ เอกสารปัจจุบันของ Google Cloud ระบุ Enterprise Document OCR รองรับภาษามากกว่า 200 ภาษา รวมญี่ปุ่น ไทย และเวียดนาม (สืบค้น 2026-08-28) แต่ไม่ใช่การรับประกันความแม่นยำของโครงการ ต้องทดสอบเอกสารตัวแทนแยกตามฟิลด์
ราคา AI-OCR เท่าไร?
ขึ้นกับฟังก์ชัน ปริมาณ region สัญญา หน้าจอตรวจ และ integration หน้าอย่างเป็นทางการของ Google Cloud ระบุ Enterprise Document OCR ที่ 1.50 ดอลลาร์สหรัฐต่อ 1,000 หน้า สำหรับช่วง count 1,000 ถึง 5,000,000 หน้า ณ 2026-08-28 ตัวเลขนี้ไม่ใช่ TCO ทั้งหมด และต้องตรวจเงื่อนไขล่าสุด
ความแม่นยำเท่าไรจึงใช้ OCR เอกสารใน production ได้?
ไม่มี threshold เดียว ต้องพิจารณาความเสี่ยงของแต่ละฟิลด์ กฎตรวจ การให้คนดู และผลของความผิดพลาด กำหนดเกณฑ์เลข PO ยอดเงิน วันที่ และฟิลด์บังคับแยกกัน แล้วแบ่งเส้นทางอัตโนมัติ ตรวจโดยคน และปฏิเสธ
AI-OCR อ่านลายมือได้หรือไม่?
บางบริการอ่านลายมือบางรูปแบบได้ แต่ผลต่างกันตามอักษร ผู้เขียน ข้อจำกัดช่อง และคุณภาพภาพ ต้องทดสอบตัวอย่างจริง และใช้กฎ master data หรือคนตรวจสำหรับข้อมูลสำคัญ
ควรใช้งาน AI-OCR แบบ on-premises หรือไม่?
ควรตัดสินจากระดับความอ่อนไหวของข้อมูล ข้อจำกัดเครือข่าย สถานที่ตั้งข้อมูล ความสามารถในการดูแล รอบการอัปเดต และ TCO การเลือก cloud หรือ on-premises เพียงอย่างเดียวไม่ได้ตัดสินความปลอดภัย ต้องเปรียบเทียบ data flow สิทธิ์ การเข้ารหัส log patch backup และสิทธิ์เข้าถึงของผู้ให้บริการด้วย
PoC ต้องเตรียมอะไร?
เตรียม use case ที่จำกัด inventory เอกสาร ชุด holdout ที่เป็นตัวแทน ground truth ฟิลด์บังคับ acceptance metric ระบบปลายทาง เงื่อนไข security และเจ้าของกระบวนการ แยกเอกสารที่ใช้ปรับจากเอกสารรับมอบ
สรุป: เลือก AI-OCR ในฐานะกระบวนการปฏิบัติงาน
AI-OCR ช่วยเปลี่ยนเอกสารหลายรูปแบบเป็นข้อมูลโครงสร้าง แต่โมเดลอย่างเดียวไม่กำหนดผลลัพธ์ ต้องออกแบบการจำแนก การรู้จำข้อความและเลย์เอาต์ การดึงฟิลด์ การตรวจ และการเชื่อมระบบหลักเป็น flow เดียว ใช้ Human-in-the-loop ควบคุมความไม่แน่นอน สำหรับโรงงานไทย ควรรวมเอกสารหลายภาษา PDPA สถานที่ข้อมูล และการตรวจ ERP master ใน PoC และ RFP เปรียบเทียบราคาทางการปัจจุบันและคำนวณ TCO ที่รวมคนตรวจและ change management ไม่ใช่ดูเฉพาะราคาต่อหน้า
คุณสามารถหารือความเป็นไปได้ของเอกสาร เกณฑ์รับ PoC และโครงสร้าง RFP ได้ตั้งแต่ก่อนเลือกผลิตภัณฑ์ หากต้องการวางแนวทางให้เหมาะกับโรงงานในไทยและระบบเดิม โปรด ติดต่อ TOMAS TECH
แหล่งอ้างอิงทางการ (สืบค้นวันที่ 2026-08-28)
- Google Cloud, Document AI processor and language list: https://docs.cloud.google.com/document-ai/docs/processors-list
- Google Cloud, Document AI overview: https://docs.cloud.google.com/document-ai/docs/overview
- Google Cloud, Extraction overview: https://docs.cloud.google.com/document-ai/docs/extracting-overview
- Microsoft Learn, Azure AI Document Intelligence Read model: https://learn.microsoft.com/en-us/azure/ai-services/document-intelligence/prebuilt/read?view=doc-intel-4.0.0
- AWS Documentation, Amazon Textract tables: https://docs.aws.amazon.com/textract/latest/dg/how-it-works-tables.html
- Google Cloud, Document AI pricing: https://cloud.google.com/products/document-ai/pricing
- AWS, Amazon Textract pricing: https://aws.amazon.com/textract/pricing/
- Thailand GPPC/PDPC, Government Platform for PDPA Compliance: https://gppc.pdpc.or.th/
ราคา ฟังก์ชัน และภาษาที่กล่าวถึงอ้างอิงข้อมูลทางการ ณ วันสืบค้น เงื่อนไขจริงเปลี่ยนตาม region ปริมาณ ภาษี อัตราแลกเปลี่ยน และสัญญา โปรดตรวจเอกสารล่าสุดและใบเสนอราคาก่อนจัดซื้อ


