


โรงงานจำนวนมากต้องการนำ ChatGPT มาใช้ในงาน แต่หลังจากอนุมัติสภาพแวดล้อมสำหรับองค์กรแล้ว แผนปฏิบัติกลับไม่ชัดเจน บทความนี้ไม่ใช่การเปรียบเทียบแพ็กเกจหรือรวบรวมกรณีศึกษาแบบกว้าง ๆ แต่เป็นแนวทางให้โรงงานในประเทศไทยนำ ChatGPT Work ไปใช้และตรวจรับภายใน 90 วันใน 3 กลุ่มงาน ได้แก่ ① การทบทวนการเดินเครื่องรายวันและรายสัปดาห์ ② การรวมเอกสารคุณภาพ ซ่อมบำรุง และการตอบลูกค้า ③ การวิเคราะห์ KPI และแดชบอร์ด ขอบเขตเริ่มต้นจบที่การอ่าน วิเคราะห์ และสร้างผลงาน ทุกการเขียนข้อมูลกลับ ERP, MES หรือ OT ยังต้องมีคนอนุมัติ
กำหนดขอบเขตงานที่ตรวจรับได้สำหรับการทดลอง ChatGPT 90 วัน
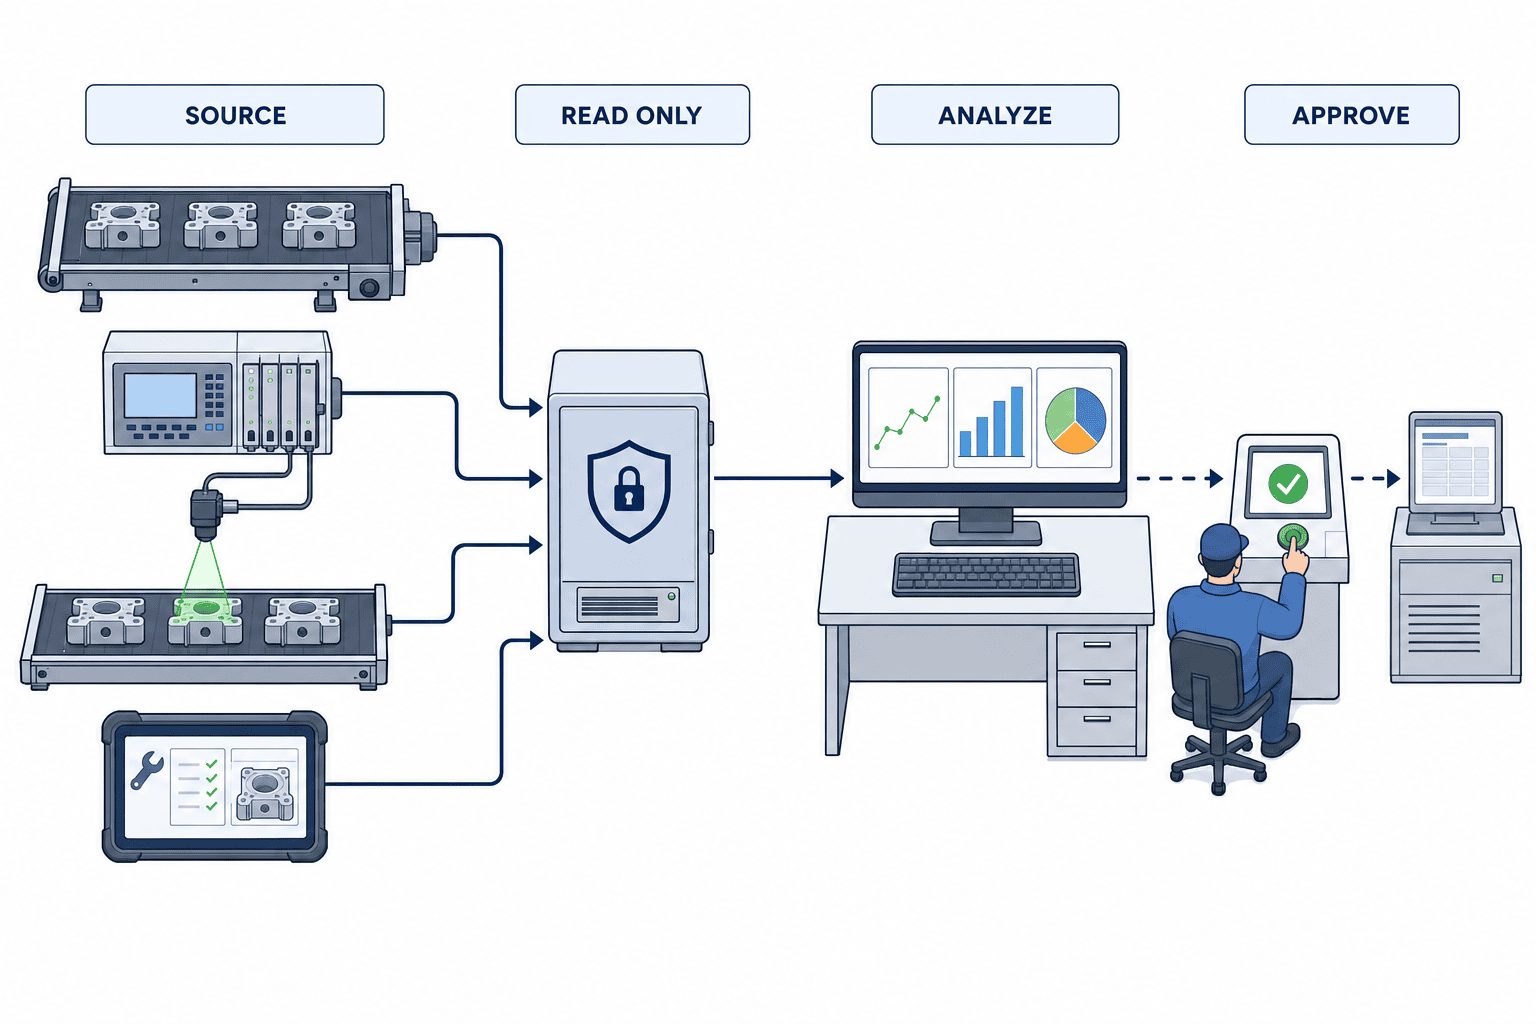
โครงการ AI ในโรงงานมักหยุดชะงักเพราะหน่วยตรวจรับไม่ชัด ไม่ใช่เพราะเทคโนโลยีขาดความสามารถ เป้าหมายอย่าง “เพิ่มประสิทธิภาพ” หรือ “ใช้ AI ทั่วทั้งบริษัท” ไม่สามารถตัดสินผ่านหรือไม่ผ่านหลัง 90 วันได้ ควรเริ่มจาก 1 โรงงาน 3 กลุ่มงาน ผู้ใช้จำกัด และการเข้าถึงแบบอ่านเป็นหลัก
OpenAI เปิดตัว ChatGPT Work ในเดือนกรกฎาคม 2026 สำหรับงานที่ใช้เวลานาน ทั้งการค้นคว้า วิเคราะห์ และสร้างผลงาน และประกาศ Data agent ในเดือนกันยายน 2026 โดยอธิบายว่าการเชื่อมต่อข้อมูลเคารพสิทธิ์เดิมและอยู่ภายใต้การควบคุมของผู้ดูแล แนวคิดนี้สนับสนุนการเริ่มจากการอ่านและวิเคราะห์ภายใต้สิทธิ์เดิม ไม่ใช่เหตุผลให้ทำทุกอย่างอัตโนมัติตั้งแต่วันแรก
| ขอบเขต | รวมใน 90 วัน | ไม่รวมใน 90 วัน |
|---|---|---|
| องค์กร | 1 โรงงาน 3 กลุ่มงาน กลุ่มละ 5–10 คน | เปิดใช้พร้อมกันหลายบริษัท |
| การจัดการข้อมูล | อ่าน ค้นหา รวมข้อมูล ร่าง และแสดงผล | เขียน ERP/MES/OT โดยไม่มีคนดูแล |
| ผลงาน | ชุดประชุม รายงานรวม มุมมอง KPI | เปลี่ยน master data อัตโนมัติ |
| การตัดสินใจ | แสดงหลักฐานแล้วให้คนอนุมัติ | ให้ AI ตัดสินคุณภาพหรือหยุดส่งของเอง |
| การประเมิน | เวลา คุณภาพ ความทำซ้ำ สิทธิ์ และการตรวจสอบ | คะแนนความพอใจเพียงอย่างเดียว |
หากยังตัดสินใจเรื่องผู้ถือสัญญาและการบริหารไม่เสร็จ ให้อ่าน แนวทางนำ ChatGPT เข้าสู่องค์กร ก่อน หากยังอยู่ในขั้นเลือกเครื่องมือ ดู วิธีเลือกเครื่องมือ Generative AI บทความนี้เริ่มจากขั้นถัดไป คือจะให้ระบบสร้างอะไรและโรงงานจะตรวจรับอย่างไร
เหตุผลที่เลือก 3 กลุ่มงานนี้
ทั้งสามกลุ่มเกิดขึ้นเป็นประจำ กำหนดอินพุตและเอาต์พุตได้ และวัดคุณค่าได้โดยไม่ต้องเขียนข้อมูลกลับระบบปฏิบัติการ การวิเคราะห์รายประเทศที่ OpenAI เผยแพร่ระบุว่า เมื่ออยู่ในที่ทำงาน ผู้ใช้มีแนวโน้มใช้ ChatGPT เพื่อทำงานให้เสร็จหรือสร้างผลงานมากกว่าตอนอยู่นอกที่ทำงานเกิน 2 เท่า ประเด็นสำคัญไม่ใช่ตัวเลข แต่คือควรวัดผลงานทางธุรกิจที่เสร็จแล้ว ไม่ใช่จำนวนข้อความแชต
| กลุ่มงาน | อินพุตหลัก | ผลงานที่คาดหวัง | การตัดสินใจที่คนยังถือไว้ |
|---|---|---|---|
| ① ทบทวนการเดินเครื่อง | ผลิตจริง หยุดเครื่อง yield ส่วนต่างแผน | สรุปรายวัน ประเด็นรายสัปดาห์ ข้อเสนอการดำเนินการ | ยืนยันสาเหตุ ลำดับความสำคัญ คำสั่ง |
| ② รวมเอกสาร | ใบของเสีย ประวัติซ่อม ข้อกำหนดลูกค้า อีเมล | ไทม์ไลน์ ตารางเปรียบเทียบ ร่างคำตอบ | คำตอบภายนอก การตัดสินคุณภาพ ผู้รับผิดชอบ |
| ③ วิเคราะห์ KPI | ตาราง KPI ผลงานรายแผนก คู่มือนิยาม | แนวโน้ม แดชบอร์ด บันทึกการตรวจสอบ | เปลี่ยนนิยาม ตั้งเป้า ลงทุน |
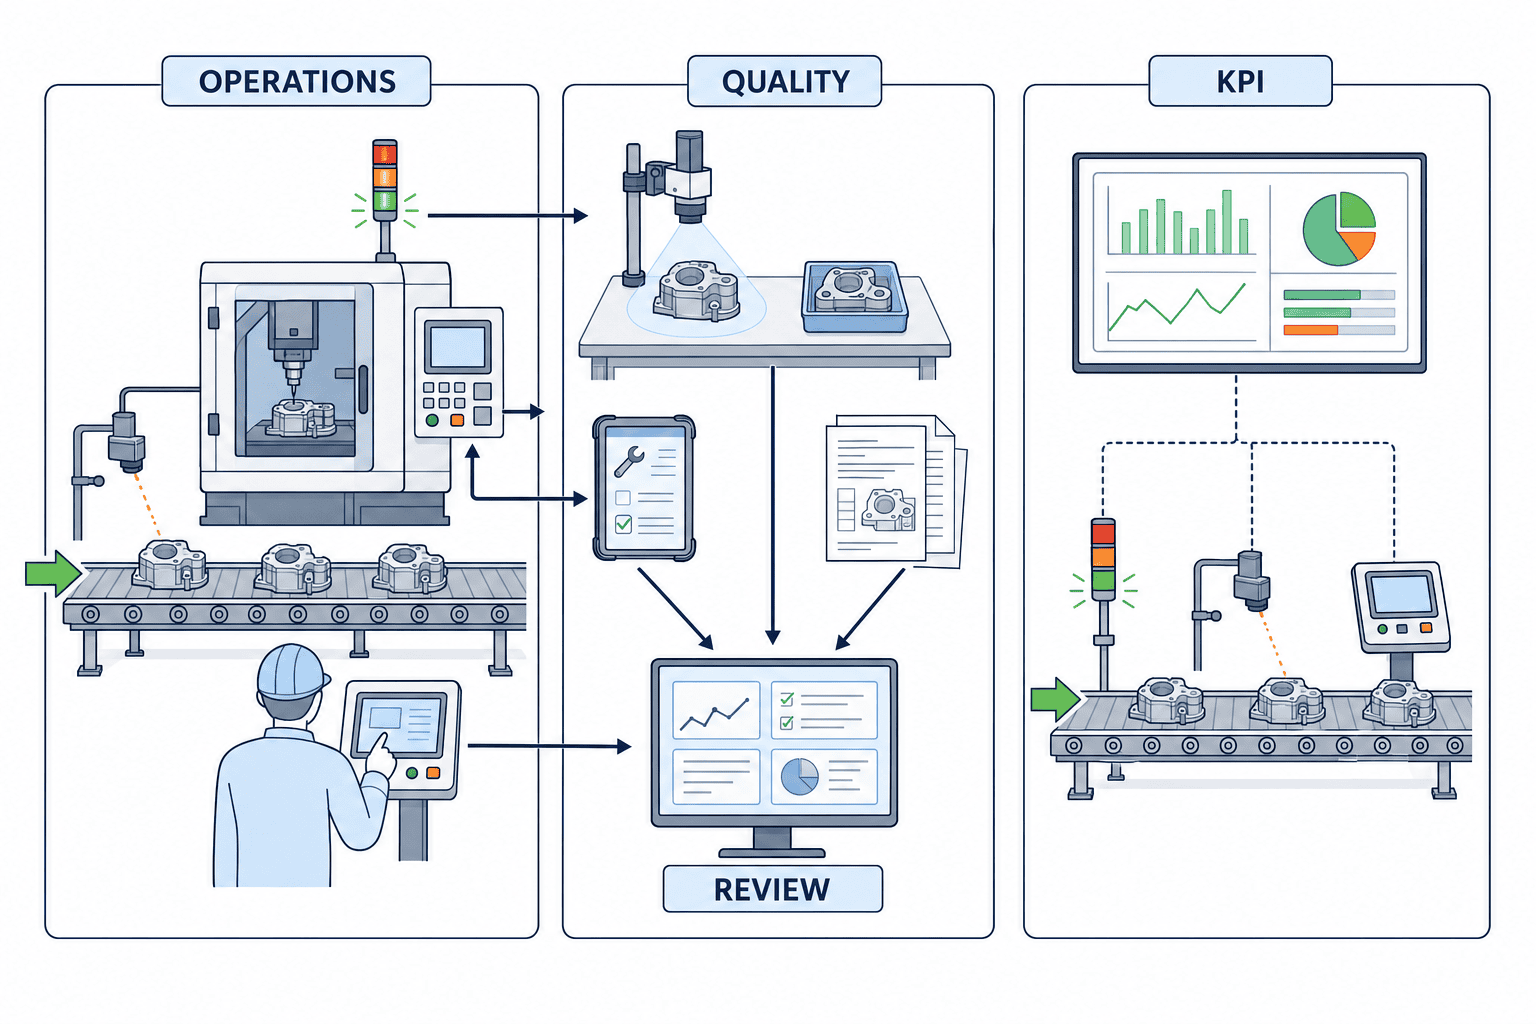
กลุ่มงาน ① การทบทวนการเดินเครื่องรายวันและรายสัปดาห์
การประชุมรายวันมักใช้ Excel หลายไฟล์ ข้อมูลส่งออกจาก MES บันทึกซ่อม และโน้ตหน้างาน พนักงานเสียเวลาไปกับการหาว่าตัวเลขอยู่ที่ไหน ทำชื่อช่องให้ตรงกัน และเขียนคำอธิบายใหม่ งานของ ChatGPT Work คือจัดหลักฐานก่อนการตัดสินใจ ไม่ใช่ตัดสินใจแทน
ในสองสัปดาห์แรก จำกัดช่องข้อมูลเป็นวันที่ ไลน์ รหัสชิ้นงาน แผน ผลิตจริง ของเสีย นาทีหยุด รหัสสาเหตุ และหมายเหตุ รับเฉพาะ CSV หรือไฟล์แชร์ที่อนุมัติแล้ว และกำหนดเอาต์พุต 5 ส่วน ได้แก่ ส่วนต่างจากแผนและวันก่อน จุดผิดปกติที่ควรตรวจ แถวข้อมูลอ้างอิง คำถามที่ต้องยืนยัน และแผนชั่วคราว
คำสั่งต้องระบุว่า ถ้าไม่มีรหัสสาเหตุให้แสดง “unknown” ห้ามเดา ให้คำนวณ yield ตามสูตรที่โรงงานอนุมัติและแสดง N/A เมื่อค่าหารเป็นศูนย์ และห้ามสรุปสาเหตุเพียงเพราะค่าเกินเกณฑ์ กติกาเหล่านี้ช่วยไม่ให้ผู้ใช้เชื่อข้อความที่ลื่นไหลมากกว่าหลักฐาน
รายงานรายสัปดาห์นำผลรายวันมารวมเพื่อดูการหยุดซ้ำ ความสูญเสียสะสม ความแปรปรวนตามชิ้นงาน และ action ที่ค้าง แต่คำว่า OEE, downtime หรือ defect rate อาจนิยามต่างกันในแต่ละโรงงาน จึงต้องแนบคู่มือนิยาม KPI และใช้เฉพาะสูตรกับข้อยกเว้นที่อนุมัติ
การตรวจรับต้องวัดสัดส่วนตัวเลขที่ย้อนกลับถึงแถวต้นทาง การเปิดเผยช่องว่าง จำนวนครั้งแก้ไขก่อนประชุม เวลาจัดเตรียม และจำนวนประเด็นที่ต้องถามเพิ่ม หากคำอธิบายดูดีแต่ตามกลับไปหาหลักฐานไม่ได้ ถือว่าไม่ผ่าน
กลุ่มงาน ② รวมข้อมูลคุณภาพ ซ่อมบำรุง และการตอบลูกค้า
เมื่อเกิดปัญหาคุณภาพหรือเครื่องจักร ข้อมูลกระจายตามฝ่าย ฝ่ายคุณภาพมีอาการและผลตรวจ ฝ่ายซ่อมมี alarm และอะไหล่ที่เปลี่ยน ฝ่ายผลิตมี lot กับ condition ส่วนฝ่ายขายมีคำถามจากลูกค้า คุณค่าแรกของ ChatGPT workflow automation คือจัดให้ทุกฝ่ายเห็นไทม์ไลน์และคำศัพท์เดียวกัน ไม่ใช่สรุป root cause อัตโนมัติ
ใช้แม่แบบเดียวกันทุกเคส:
- เหตุการณ์: พบอะไร ที่ไหน เมื่อไร
- ขอบเขตผลกระทบ: lot เครื่องจักร ลูกค้า และสต็อก
- ข้อเท็จจริงยืนยันแล้ว: แหล่งต้นฉบับและผู้สร้าง
- เรื่องที่ยังไม่ยืนยัน: ข้อมูลที่ขาดและเจ้าของงาน
- สมมติฐาน: แยกจากข้อเท็จจริงและระบุวิธีทดสอบ
- การควบคุมชั่วคราว: ผู้อนุมัติ เวลา และเงื่อนไขยกเลิก
- ร่างตอบลูกค้า: ระบุชัดว่ายังรออนุมัติ
หากเอกสารมีทั้งภาษาญี่ปุ่น ภาษาอังกฤษ และภาษาไทย ให้สร้าง glossary ก่อน คำว่า “leak”, “รั่ว” และ “漏れ” แปลใกล้กัน แต่อาจหมายถึงจุดตรวจ อาการ หรือสาเหตุ Glossary ควรเก็บคำที่เลือก คำเรียกอื่น คำคลุมเครือที่ห้ามใช้ นิยาม หน่วย และเอกสารอ้างอิง การตรวจรับคำแปลต้องเทียบ lot วันที่ หน่วย และชื่อชิ้นส่วน ไม่ใช่ดูเพียงความเป็นธรรมชาติ
ร่างคำตอบภายนอกต้องผ่านผู้รับผิดชอบคุณภาพและฝ่ายขายก่อนส่ง ChatGPT ร่าง แปล และชี้ประเด็นที่ขาดได้ แต่ห้ามระบุว่า root cause ยืนยันแล้วหรือปัญหาจะไม่เกิดซ้ำ หากไม่มี 8D หรือ CAPA ที่อนุมัติ การลงรับคืนใน ERP การปิด corrective action ใน QMS และการเปลี่ยน PLC ไม่อยู่ในขอบเขต 90 วัน
หากต้องการพัฒนาไปถึงฐานข้อมูลที่เชื่อมโยงกว้างขึ้น อ่าน แนวทาง Data Agent สำหรับโรงงาน โครงการนี้ไม่บังคับให้เปลี่ยน data platform แต่ตรวจคุณภาพจากแหล่งอ่านที่อนุมัติ
กลุ่มงาน ③ การวิเคราะห์ KPI และแดชบอร์ด
บทความช่วยเหลือ Data plugin ของ OpenAI ระบุการวิเคราะห์ สร้างแดชบอร์ด และตรวจสอบผลลัพธ์เป็นงานหลัก สำหรับโรงงาน ความหมายและเงื่อนไขอัปเดตของตัวเลขสำคัญกว่ากราฟที่สวย
KPI ทุกตัวต้องมีชื่อ วัตถุประสงค์ สูตร ระดับข้อมูล ช่วงเวลา time zone ข้อยกเว้น ความถี่ เจ้าของ และผู้อนุมัติ “อัตราของเสียรายเดือน” เปลี่ยนผลได้ตามว่าหารด้วยยอดผลิตหรือยอดตรวจ ต้องระบุการรวม rework งานทดลอง scrap และการโอนระหว่างโรงงาน
แดชบอร์ดแบ่ง 3 ชั้น:
- ชั้น 1 ผู้จัดการโรงงาน: KPI ด้าน safety, quality, delivery, cost และเทียบงวดก่อน
- ชั้น 2 ผู้จัดการฝ่าย: contribution และ anomaly ตามไลน์ ชิ้นงาน และกะ
- ชั้น 3 นักวิเคราะห์: ข้อมูลต้นทาง สูตรแปลง missing data ประวัติ refresh และผลตรวจ
ทุกหน้าต้องแสดงเวลาอัปเดต ช่วงข้อมูล filter และลิงก์สูตร แยกข้อเท็จจริงเรื่องเกณฑ์ออกจากข้อเสนอวินิจฉัย เช่น “Line B มี defect rate 2.1% สูงกว่าเกณฑ์ 1.5%” ไม่ได้พิสูจน์ว่าเครื่องสึกหรอ
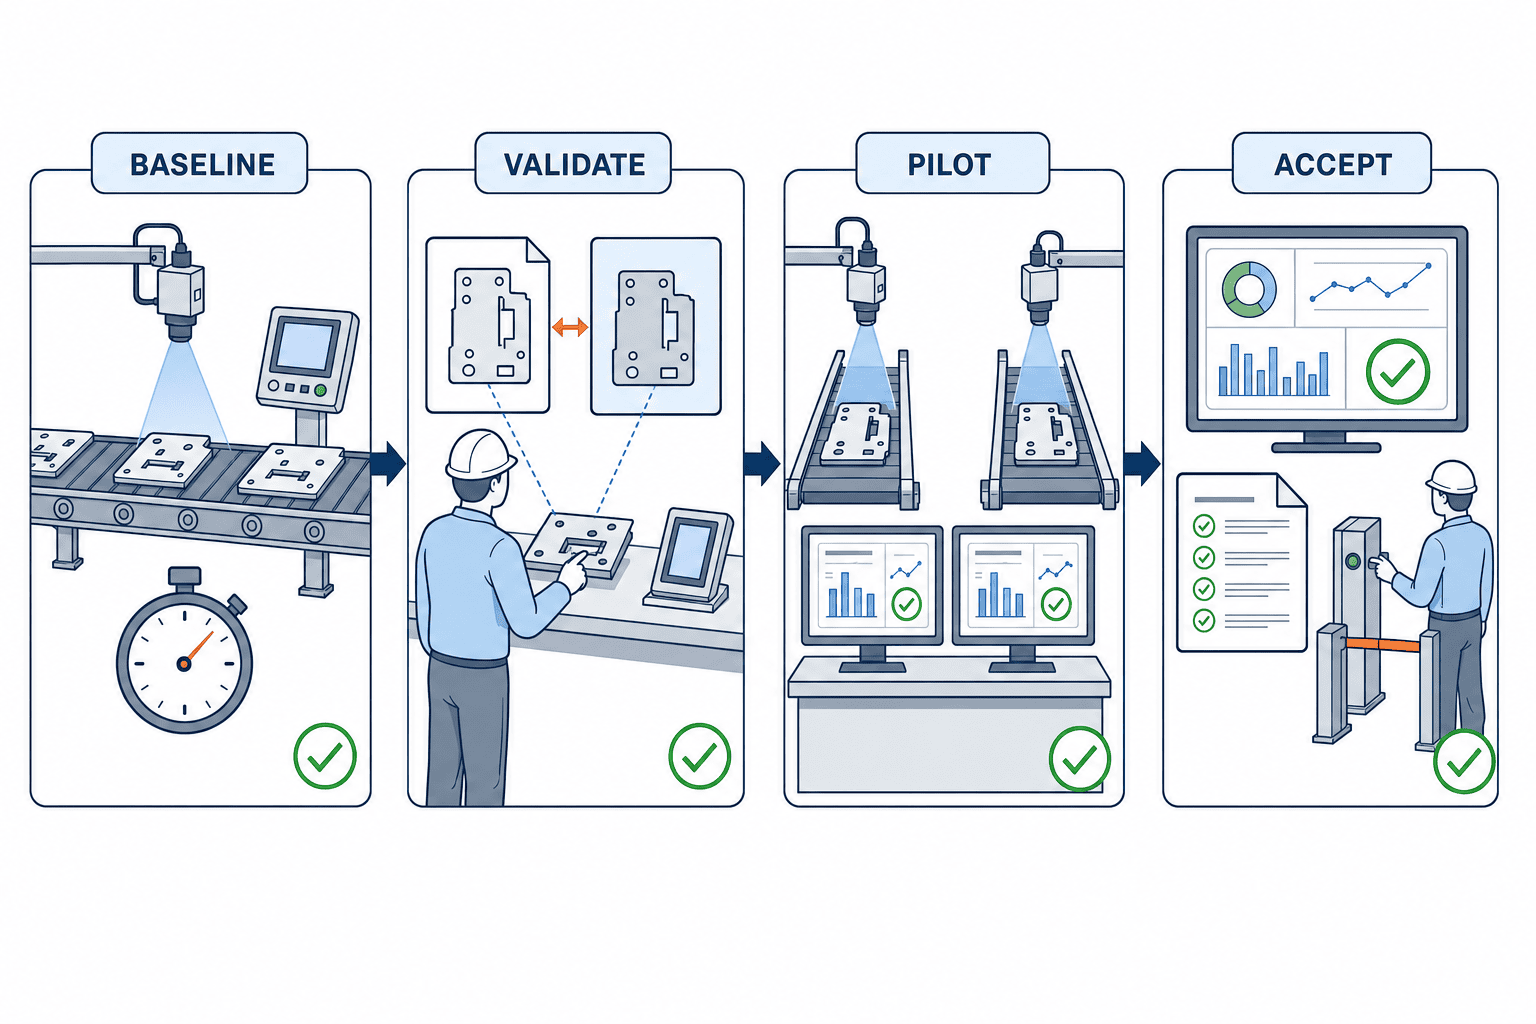
Roadmap 90 วันสำหรับ ChatGPT Data Analysis
แบ่งเป็น 4 ระยะ แต่ละระยะมีเงื่อนไขออก หากไม่ผ่านต้องไม่ขยายขอบเขต
วันที่ 0–15: baseline งานและสิทธิ์
วัดเวลาจัดเตรียม จำนวนครั้งแก้ แหล่งข้อมูล และเส้นทางอนุมัติปัจจุบันอย่างน้อย 10 วันทำงาน แยกวันปกติและวันงานสูง มิฉะนั้นอัตราปรับปรุงจะไม่มีฐานจริง
จัดประเภทข้อมูลเป็น public, internal, confidential และ highly confidential ให้ฝ่ายกฎหมาย ความปลอดภัยสารสนเทศ และเจ้าของข้อมูลตรวจข้อมูลส่วนบุคคล ความลับลูกค้า ข้อมูลควบคุมการส่งออก และข้อจำกัดตามสัญญาก่อนเชื่อมต่อ หน้า Business Data Privacy ของ OpenAI อธิบายว่าข้อมูลธุรกิจไม่ถูกใช้ฝึกโมเดลโดยค่าเริ่มต้น มีการเข้ารหัสระหว่างส่งและขณะเก็บ รวมถึงเครื่องมือผู้ดูแล แต่ไม่ได้แปลว่าการตั้งค่าของทุกบริษัทผ่านกฎหมาย สัญญา และ retention โดยอัตโนมัติ
เงื่อนไขวันที่ 15 คือมีเอกสารรายชื่อผู้ใช้ งาน แหล่งข้อมูล ข้อมูลต้องห้าม ผู้อนุมัติ และผู้ตรวจ log
วันที่ 16–30: gold set และแม่แบบเอาต์พุต
เลือก 10 เคสต่อกลุ่มงาน เป็นเคสปกติ 6 เคส ข้อมูลขาด 2 เคส และข้อยกเว้น 2 เคส คำตอบมาตรฐานต้องมีหลักฐาน ขั้นคำนวณ จุดที่เลื่อนการตัดสิน และประวัติอนุมัติ
คำสั่งแบ่งเป็น 5 ส่วน: บทบาท อินพุต เอาต์พุต ข้อห้าม และวิธีตรวจสอบ จัดการเลขเวอร์ชัน เจ้าของ เหตุผลที่เปลี่ยน และผลทดสอบ เอกสาร Operations ของ OpenAI กล่าวถึง plugins และ Skills แต่การเชื่อมต่อทางเทคนิคต้องแยกจากการอนุมัติทางธุรกิจ
ตาม “โมเดลสมมติของ TOMAS TECH” เงื่อนไขวันที่ 30 คือ 3 กลุ่มงาน × 10 เคส มีช่องบังคับครบอย่างน้อย 95% ข้อผิดพลาดตัวเลขร้ายแรง 0 และลิงก์ต้นทาง 100% ตัวเลขนี้เป็นเกณฑ์เสนอ ไม่ใช่การรับประกันจาก OpenAI
วันที่ 31–60: จำกัดผู้ใช้และทำงานคู่ขนาน
จำกัด 5–10 คนต่อกลุ่ม ใน 10 วันทำงานแรก ให้สร้างผลงานทั้งวิธีเดิมและวิธีที่มี AI แล้วจัดความต่างเป็นข้อมูลขาด นิยามไม่ตรง คำนวณผิด แปลผิด หลักฐานไม่พอ หรืออนุมัติขาด
ใช้สิทธิ์ขั้นต่ำกับ Data plugin และ business plugin เอกสารของ OpenAI ระบุการเคารพสิทธิ์เดิมและการควบคุมของผู้ดูแล ส่วนความสามารถด้าน audit และการติดตาม action ขึ้นอยู่กับแพ็กเกจที่สมัครและเครื่องมือที่เชื่อมต่อ การตรวจรับต้องทดสอบว่าผู้ใช้เห็นเฉพาะข้อมูลที่อนุญาต การเปลี่ยนสิทธิ์ส่งผลจริง และติดตาม action ได้ รวมกรณีพนักงานลาออก ย้ายงาน และผู้รับเหมา
เงื่อนไขวันที่ 60 ในโมเดลสมมติคือ ข้อผิดพลาดร้ายแรง 0 ติดต่อกัน 10 วันทำงาน อัตราแก้ไขเคสปกติไม่เกิน 10% การทดสอบสิทธิ์ผ่าน 100% และการส่งภายนอกโดยไม่อนุมัติ 0
วันที่ 61–90: ใช้งานจริง ทดสอบข้อยกเว้น และตรวจรับ
เพิ่มกรณีคอลัมน์หาย หน่วยผสม time zone ต่าง รหัสซ้ำ ไฟล์เก่า ข้อมูลไม่มีสิทธิ์ และคำสั่งขัดกัน ระบบควรหยุดหรือถาม ไม่ใช่เติมคำตอบเอง
การประชุมตรวจรับสุดท้ายต้องมีเจ้าของงาน IT ความปลอดภัยสารสนเทศ คุณภาพ และตัวแทนผู้ใช้ เลือก “ผ่าน” “ต่อแบบจำกัด” หรือ “หยุด” การเปิดใช้กว้างต้องใช้ตัวเลข หลักฐาน และพฤติกรรมเมื่อผิดปกติ ไม่ใช่แค่คำชม
โมเดลสมมติของ TOMAS TECH: ตัวอย่างคำนวณ PoC 90 วัน
ตัวอย่างต่อไปนี้เป็นแบบจำลองสมมติสำหรับโรงงานขนาดกลางในไทย ไม่ใช่ผลลัพธ์จาก OpenAI ต้องแทนจำนวนคน ค่าแรง ปริมาณงาน และเวลารออนุมัติด้วยข้อมูลจริง
สมมติฐาน
| รายการ | ค่าสมมติ |
|---|---|
| ผู้ใช้ | 24 คน (3 กลุ่ม × 8) |
| วันทำงาน | 22 วัน/เดือน |
| รายงานเดินเครื่อง | 2 ชุด/วัน เดิม 60 นาที หลังใช้ 35 นาที |
| รายงานรวม | 20 ชุด/เดือน เดิม 150 นาที หลังใช้ 95 นาที |
| KPI | 12 ครั้ง/เดือน เดิม 180 นาที หลังใช้ 110 นาที |
| ค่าแรงรวม | 600 THB/ชั่วโมง |
| อนุมัติและ audit เพิ่ม | 18 ชั่วโมง/เดือน |
| เตรียมเริ่มต้น | 240 ชั่วโมง |
สูตรคำนวณ
คำนวณเวลาที่ประหยัดต่อเดือนของแต่ละกลุ่มงานและปัดเป็นทศนิยมหนึ่งตำแหน่งก่อนนำค่าที่แสดงมารวมกัน
- ทบทวนการเดินเครื่อง: 2 × 22 × (60−35) ÷ 60 = 18.3 ชั่วโมง/เดือน
- รายงานรวม: 20 × (150−95) ÷ 60 = 18.3 ชั่วโมง/เดือน
- KPI: 12 × (180−110) ÷ 60 = 14.0 ชั่วโมง/เดือน
- ประหยัดรวม: 18.3 + 18.3 + 14.0 = 50.6 ชั่วโมง/เดือน
- ประหยัดสุทธิ: 50.6 − 18 = 32.6 ชั่วโมง/เดือน
- มูลค่าแรง: 32.6 × 600 = 19,560 THB/เดือน
3 เดือนคิดเป็น 58,680 THB ส่วนการเตรียม 240 × 600 = 144,000 THB ดังนั้นแบบจำลองนี้ไม่ได้ตั้งเป้าคืนทุนภายใน 90 วัน แต่ตรวจว่าผลประหยัดทำซ้ำได้และความเสี่ยงถูกควบคุมพอสำหรับการขยาย 6–12 เดือนหรือไม่ หากคิดเฉพาะค่าแรง จุดคุ้มทุนโดยประมาณคือ 144,000 ÷ 19,560 = 7.4 เดือน ไม่รวม license, connector, training และบริการภายนอก
ต้องทำ sensitivity analysis ด้วย หากเวลาหลังใช้แย่กว่าสมมติ 20% ผลประหยัดจะลด หากปริมาณงานเพิ่มสองเท่าแต่ผู้อนุมัติเท่าเดิม ผลไม่เพิ่มสองเท่า จึงต้องติดตาม correction rate เวลารออนุมัติ และข้อผิดพลาดร้ายแรงควบคู่กัน
การออกแบบ ChatGPT Plugin และสิทธิ์
จำนวน connector มากไม่ได้แปลว่าโครงการดีกว่า เริ่มจาก 1–2 แหล่งต่อกลุ่มงาน ลำดับที่เหมาะคือไฟล์ที่อนุมัติ ฐานข้อมูลหรือ BI แบบ read-only ระบบ ticket/เอกสาร และระบบหลักเป็นลำดับสุดท้าย
| แกน | คำถามควบคุม | หลักฐานตรวจรับ |
|---|---|---|
| ผู้ใช้ | ใครเข้าได้ ย้ายหรือลาออกแล้วเกิดอะไร | รายชื่อบัญชี ผล disable test |
| ข้อมูล | เห็นโรงงาน ลูกค้า และช่วงใด | access matrix ผลปฏิเสธ audit log |
| การกระทำ | อ่าน วิเคราะห์ export หรือเขียน | ผลทดสอบแยก action |
| ผลงาน | เก็บ แชร์ รักษา และลบที่ไหน | setting ประวัติแชร์ deletion test |
ข้อมูล business plugins ของ OpenAI อธิบายการบังคับใช้สิทธิ์เดิมของระบบต้นทาง การควบคุมโดยผู้ดูแล และค่าเริ่มต้นที่ไม่ใช้ข้อมูลธุรกิจฝึกโมเดล ส่วน audit log ใช้ได้เมื่อแพ็กเกจที่ลูกค้าสมัครและ connector รองรับ ฝั่งบริษัทต้องตั้ง SSO, RBAC, sharing, retention และผู้รับผิดชอบ log ที่มีอยู่ พร้อมทบทวนสิทธิ์เป็นระยะ หากระบบต้นทางให้สิทธิ์กว้างเกินไป การจำกัดเฉพาะชั้น AI ไม่เพียงพอ
เหตุผลที่ ERP, MES และ OT ต้องมีคนอนุมัติการเขียน
ข้อผิดพลาดจากการอ่านมักแก้ได้ตอน review แต่ข้อผิดพลาดจากการเขียนอาจกระทบสต็อก แผน คุณภาพ เครื่องจักร และกระบวนการจริง ใน 90 วัน ChatGPT สร้างคำขอเปลี่ยน diff เหตุผล และขอบเขตผลกระทบ แล้วผู้มีสิทธิ์อนุมัติและดำเนินการอีกขั้น
การไปสู่ automated write ต้องมีข้อผิดพลาดร้ายแรง 0 ต่อเนื่อง ผ่าน exception test มี rollback, dual approval, audit log และผู้รับผิดชอบเห็นชอบ แม้ผ่านแล้ว การตั้ง PLC, safety interlock, quality disposition, payment และ shipment hold ยังต้องประเมินความเสี่ยงแยก
Scorecard สำหรับตรวจรับ
| ด้าน | คะแนน | ตัวอย่างผ่าน |
|---|---|---|
| ผลทางธุรกิจ | 25 | เวลางานสุทธิลดอย่างน้อย 20% |
| คุณภาพผลงาน | 25 | ช่องบังคับ ≥95% ข้อผิดพลาดตัวเลขร้ายแรง 0 |
| ความทำซ้ำ | 15 | อินพุตเดียวกันให้ตัวเลขและข้อสรุปสำคัญตรงกัน |
| ความปลอดภัยและสิทธิ์ | 20 | ทดสอบสิทธิ์ผ่าน 100% เข้าถึงผิดสิทธิ์ 0 |
| การปฏิบัติการ | 15 | มีเจ้าของ ขั้นตอน และช่องทางเหตุขัดข้อง |
ในโมเดลสมมติของ TOMAS TECH ต้องได้อย่างน้อย 80 คะแนน และข้อผิดพลาดตัวเลขร้ายแรง การละเมิดสิทธิ์ และการส่งภายนอกโดยไม่อนุมัติต้องเป็น 0 คะแนน 70–79 ให้ต่อขอบเขตเดิม 30 วัน ส่วน 69 หรือต่ำกว่า หรือผิดเงื่อนไขร้ายแรง ให้หยุดและออกแบบใหม่ อุตสาหกรรมกำกับหรือกระบวนการเสี่ยงควรเข้มกว่านี้
ความล้มเหลวที่พบบ่อย
แจกสิทธิ์ให้ทุกคนก่อน
รูปแบบอินพุตและความคาดหวังจะแตกต่างก่อนมี gold set เริ่มจาก 3 กลุ่มงานประมาณ 24 คน พร้อมเจ้าของงาน ข้อมูล และผู้อนุมัติ
ใช้ความสวยของแดชบอร์ดเป็นผลสำเร็จ
กราฟสวยที่ใช้สูตรผิดอันตราย ต้องตรวจนิยาม แหล่งข้อมูล missing data และเวลา refresh พร้อมกัน
ถือว่าผลวิเคราะห์คือ root cause
ความสัมพันธ์ anomaly หรือ hypothesis ไม่ใช่สาเหตุยืนยัน ต้องรวมการตรวจหน้างาน การวัดเพิ่ม และความรู้กระบวนการ
ตรวจภาษาแต่ไม่ตรวจ token งานจริง
ตัวเลข หน่วย lot part number และเวลาอาจสำคัญกว่าภาษาสวย แยก language review จาก data reconciliation
รีบให้ ChatGPT Automation เขียนระบบ
จำกัด 90 วันที่การอ่าน วิเคราะห์ และสร้างผลงาน งานเขียนกลับต้องเป็น PoC แยกเมื่อมี approval, diff, rollback และ audit
หากต้องการมุมมองกรณีใช้งานที่กว้างขึ้น ดู กรณีใช้ Generative AI ในการผลิต บทความนี้ต่างกันตรงที่เน้นขั้นตอนติดตั้งและตรวจรับ 90 วัน
คำถามที่พบบ่อย
PoC ChatGPT Work ในโรงงานควรเริ่มกี่คน?
โมเดลสมมติใช้ 1 โรงงาน 3 กลุ่ม กลุ่มละ 5–10 คน สิ่งสำคัญกว่าจำนวนคือมีเจ้าของงาน เจ้าของข้อมูล และผู้อนุมัติครบ
ChatGPT Data Analysis เชื่อม MES โดยตรงได้หรือไม่?
การเชื่อมต่อทางเทคนิคกับการอนุมัติทางธุรกิจเป็นคนละเรื่อง เริ่มจากไฟล์อนุมัติหรือ BI แบบ read-only ตรวจสิทธิ์ log retention และพฤติกรรม exception ไม่รวมการเขียน MES ใน PoC แรก
ให้ ChatGPT Workflow Automation ตัดสินคุณภาพได้หรือไม่?
ใน 90 วัน ให้จัดหลักฐาน เทียบ spec และร่างคำตอบ ส่วน disposition การส่งสินค้า และ corrective action ให้ผู้รับผิดชอบอนุมัติ
ควรเชื่อม ChatGPT Plugin กี่ตัว?
เริ่ม 1–2 แหล่งต่อกลุ่ม Least privilege นิยามตรงกัน และตรวจสอบย้อนหลังได้ สำคัญกว่าจำนวน
หากคืนทุนไม่ทัน 90 วัน ยังควรทดลองหรือไม่?
ควร หากต้องการวัดผล คุณภาพ exception และการควบคุมสิทธิ์จากงานจริง แบบจำลองสมมติให้จุดคุ้มทุนเฉพาะแรงงานประมาณ 7.4 เดือน แต่โรงงานต้องแทนค่าจริงและใช้ตัดสินใจช่วง 6–12 เดือน
สรุป: เริ่มเล็ก ตัดสินจากผลงานและหลักฐาน
โรงงานไทยสามารถขับเคลื่อน ChatGPT ได้ด้วยการตรวจรับ 3 กลุ่มงานใน 90 วัน แทนการเปิดใช้อิสระหลังซื้อ จัดมาตรฐานการทบทวนรายวัน/รายสัปดาห์ การรวมเอกสารคุณภาพ-ซ่อม-ลูกค้า และการวิเคราะห์ KPI จนถึงผลงาน ให้คนอนุมัติการเขียน ERP, MES และ OT และวัดเวลาที่ลด อัตราแก้ ข้อผิดพลาดร้ายแรง การตามแหล่งข้อมูล การทดสอบสิทธิ์ และพฤติกรรม exception ไม่ใช่จำนวนข้อความ
แม้ตำแหน่งข้อมูลและเส้นทางอนุมัติยังไม่สมบูรณ์ ก็เริ่มจากกำหนดกลุ่มงานและ scorecard ได้ ติดต่อ TOMAS TECH เพื่อหารือขอบเขต PoC ที่ทำงานร่วมกับ ERP และ MES ปัจจุบันโดยไม่ตั้งสมมติฐานว่าต้องเปลี่ยนระบบ
แหล่งอ้างอิง
- OpenAI: Put data to work — Data agent, 10 กันยายน 2026
- OpenAI Help: ChatGPT Data plugin
- OpenAI: ChatGPT for your most ambitious work, 9 กรกฎาคม 2026
- OpenAI: Solutions for Operations
- OpenAI: Business plugins
- OpenAI: Business data privacy, security, and compliance
- OpenAI: Samsung Electronics deployment, 21 มิถุนายน 2026
- OpenAI: Unlocking new ways of working, 16 กันยายน 2026
- OpenAI: How the world is putting ChatGPT to work, 6 สิงหาคม 2026
*ขั้นตอน 90 วัน จำนวนคน เวลา ค่าใช้จ่าย และเกณฑ์ในบทความเป็น “โมเดลสมมติของ TOMAS TECH” ต้องปรับตามสัญญา กฎหมาย นโยบายความปลอดภัย ระบบคุณภาพ และข้อกำหนด safety ของแต่ละบริษัท*


