


ประชุมกันทุกสัปดาห์ และมีไฟล์บันทึกเสียงเก็บไว้ครบ แต่พอถึงต้นสัปดาห์ถัดไป สิ่งที่เหลืออยู่ในมือกลับมีเพียงไฟล์เสียงที่ไม่มีใครเปิดฟัง กับบันทึกสั้น ๆ ไม่กี่บรรทัดที่ผู้รับผิดชอบเขียนขึ้นจากความทรงจำ ในโรงงานสัญชาติญี่ปุ่นที่ตั้งฐานอยู่ในประเทศไทย สภาพแบบนี้ไม่ใช่เรื่องแปลก บทความนี้จะจัดระเบียบเรื่องการใช้ AI ถอดเสียง ไม่ใช่ในฐานะเรื่องของการนำเครื่องมือทำรายงานการประชุมมาใช้เพียงตัวเดียว แต่ในฐานะการออกแบบเวิร์กโฟลว์ทั้งสายงาน ตั้งแต่การแปลงเสียงเป็นข้อความ การสรุปเนื้อหา ไปจนถึงการประกอบเป็นรายงานโดยอัตโนมัติ โดยเฉพาะจะดูว่าเกิดอะไรขึ้นในการประชุมที่มีภาษาไทยและภาษาเวียดนามปะปนอยู่ และการส่งข้อมูลเสียงไปยังคลาวด์ในต่างประเทศถูกพิจารณาอย่างไรในทางกฎหมาย โดยอ้างอิงจากข้อมูลที่เปิดเผยต่อสาธารณะ
เหตุใดไฟล์บันทึกเสียงการประชุมจึงหยุดอยู่ตรงทางเข้าของ AI ระบบอัตโนมัติทางธุรกิจ
ไฟล์เสียงเพิ่มขึ้น แต่เอกสารที่มีคนอ่านกลับไม่เพิ่ม
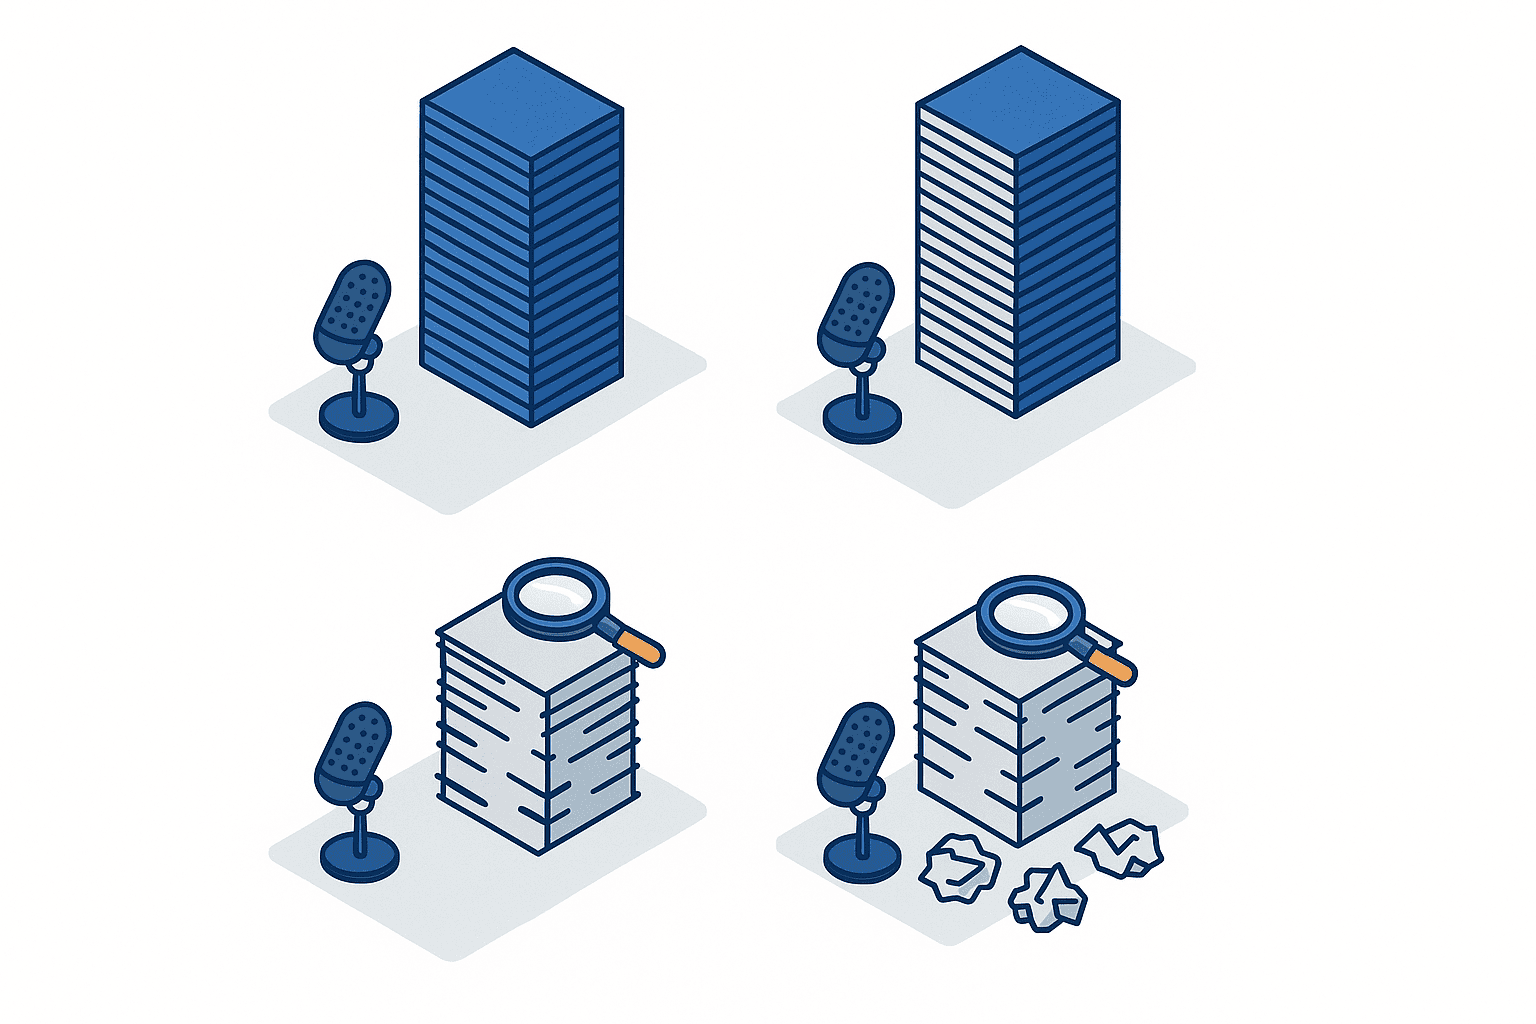
หลายฐานการผลิตเริ่มบันทึกเสียงการประชุมกันไปแล้ว เครื่องมือประชุมออนไลน์มีฟังก์ชันบันทึกการประชุมมาให้ และสมาร์ตโฟนก็บันทึกเสียงได้ในคุณภาพที่เพียงพอ อุปสรรคของการบันทึกจึงแทบหายไปหมด แต่ถึงอย่างนั้น หลายคนก็ยังไม่รู้สึกว่าไฟล์บันทึกเหล่านั้นถูกใช้งานจริงในธุรกิจ เพราะการบันทึกถูกมองเป็นเพียงประกันไว้ให้ย้อนกลับมาฟังทีหลัง และไม่ได้เชื่อมต่อไปสู่กระบวนการถัดไป
การย้อนฟังการประชุมความยาว 1 ชั่วโมง โดยหลักการแล้วต้องใช้เวลา 1 ชั่วโมง ต่อให้เร่งความเร็วเป็นสองเท่าก็ยังใช้เวลา 30 นาที ถ้าคนที่ไม่ได้เข้าประชุมต้องใช้เวลา 30 นาทีเพื่อทำความเข้าใจเนื้อหา สู้เดินไปถามคนที่เข้าประชุม 5 นาทีจะเร็วกว่า ตรรกะแบบนี้จึงทำงานอยู่เสมอ ผลลัพธ์คือไฟล์บันทึกกลายเป็นสินทรัพย์ที่ถูกเก็บไว้เฉย ๆ และมีแต่พื้นที่ในโฟลเดอร์ที่เพิ่มขึ้น
สิ่งที่เกิดขึ้นตรงนี้ไม่ใช่การขาดเทคโนโลยี แต่เป็นรอยขาดของกระบวนการ เสียงมีอยู่ แต่ขั้นตอนที่ทำให้เสียงกลายเป็นสิ่งที่อ่านได้ยังเป็นงานคน และเมื่อยังเป็นงานคน ก็ไม่มีใครเริ่มลงมือ บทบาทที่แท้จริงของ AI ถอดเสียงคือการอุดรอยขาดนี้ แต่การทำให้เฉพาะขั้นตอนถอดเสียงเป็นอัตโนมัติเพียงอย่างเดียว ยังไม่สามารถปิดรอยขาดได้ทั้งหมด
ทำให้เฉพาะการถอดเสียงเป็นอัตโนมัติ ภาระงานก็ยังไม่เบาลง
เมื่อถอดเสียงการประชุมความยาว 1 ชั่วโมงออกมา หากประมาณจากความเร็วในการพูดทั่วไปของภาษาญี่ปุ่น จะได้ข้อความราวหนึ่งหมื่นห้าพันถึงสองหมื่นตัวอักษร ปริมาณเท่านี้เทียบได้กับหนังสือหลายสิบหน้า การอ่านทบทวนต้องใช้เวลา 10 ถึง 15 นาที และเนื่องจากการพูดซ้ำแก้คำ การขานรับ และบทสนทนานอกเรื่องยังคงอยู่ครบ ข้อความนั้นจึงมีประสิทธิภาพต่ำมากในฐานะสิ่งที่ต้องอ่าน
พูดอีกอย่างคือ จุดสิ้นสุดของการถอดเสียงเป็นเพียงรูปแบบที่อ่านได้ แต่ยังไม่ใช่รูปแบบที่ใช้งานได้ รูปแบบที่ใช้งานได้หมายถึงสภาพที่มองไม่กี่บรรทัดก็เข้าใจ 3 ประเด็น ได้แก่ อะไรที่ตัดสินใจแล้ว อะไรที่ยังไม่ได้ข้อสรุป และใครต้องทำอะไรภายในเมื่อไร ตราบใดที่การแปลงนี้ยังทำโดยคน สิ่งที่ลดได้ก็มีแค่เวลาย้อนฟัง ส่วนเวลาในการสรุปยังคงอยู่เหมือนเดิม
สิ่งที่ส่งผลจริงในทางปฏิบัติคือเวลาในการสรุปนี่เอง หลายท่านน่าจะรู้สึกว่าเวลาถูกกินไปกับการจัดทำเอกสารหลังประชุมมากกว่าตัวการประชุมเสียอีก ด้วยเหตุนี้ การใช้ AI ถอดเสียงจึงไม่ควรจบลงที่การเปรียบเทียบความแม่นยำของการถอดเสียง แต่ต้องออกแบบให้ครอบคลุมถึงกระบวนการปลายทางด้วย
ถ้าคิดเฉพาะในหน่วยของรายงานการประชุม จะออกแบบผิดตั้งแต่ต้น
ยังมีอีกจุดหนึ่งที่ทำให้ออกแบบผิดได้ง่าย นั่นคือเอกสารที่ควรเกิดขึ้นจากการประชุมไม่ได้มีแค่รายงานการประชุมเท่านั้น
ตัวอย่างเช่น การประชุมพิจารณาปัญหาคุณภาพที่ไซต์ของลูกค้า นอกจากรายงานการประชุมแล้ว ยังทำให้เกิดรายงานการแก้ไขและป้องกัน เอกสารส่งต่อให้ฝ่ายเทคนิคภายในองค์กร และสรุปรายสัปดาห์สำหรับสำนักงานใหญ่ที่ญี่ปุ่น ส่วนการเจรจาราคากับซัพพลายเออร์ นอกจากบันทึกการเจรจาแล้ว ยังต้องมีเอกสารแนบสำหรับขออนุมัติของฝ่ายจัดซื้อ และบันทึกประเด็นสำหรับการเจรจาครั้งถัดไป ความจริงคือจากไฟล์เสียงเพียงไฟล์เดียว จะแตกออกเป็นเอกสารหลายชิ้นที่ทั้งผู้รับและระดับความละเอียดต่างกัน
ถ้าตั้งเป้าไว้แค่การสร้างรายงานการประชุมอัตโนมัติ การแตกตัวนี้จะหลุดออกจากสายตา ผลคือจะหยุดอยู่ในสภาพครึ่ง ๆ กลาง ๆ ที่ว่ารายงานการประชุมออกมาอัตโนมัติแล้ว แต่รายงานฉบับอื่นสุดท้ายก็ยังเขียนด้วยมือ จุดตั้งต้นของการออกแบบเวิร์กโฟลว์คือการเปลี่ยนความคิดจากการผลิตรายงานการประชุมสำเร็จรูปหนึ่งชิ้น ไปเป็นการประกอบผลลัพธ์หลายชิ้นขึ้นจากวัตถุดิบที่ชื่อว่าข้อความถอดเสียง
อนึ่ง เรื่องคุณภาพของตัวรายงานการประชุมเอง โดยเฉพาะปัญหาที่บทสรุปพังในการประชุมหลายภาษา ได้แยกไปกล่าวไว้ในวิธีเลือก AI สร้างรายงานการประชุมอัตโนมัติ ปี 2026 บทความนี้จะโฟกัสที่ชั้นถัดขึ้นไปหนึ่งชั้น นั่นคือการออกแบบกระบวนการว่าจะประกอบกลุ่มผลลัพธ์ขึ้นจากวัตถุดิบอย่างไร
ค่าเป้าหมายของผลการลดงานต้องสร้างจากการวัดจริงในองค์กรของตนเอง
ก่อนเข้าสู่การออกแบบกระบวนการ ยังมีอีกเรื่องที่ควรตกลงกันไว้ก่อน นั่นคือจะพูดถึงผลลัพธ์ด้วยตัวเลขใด บทความเปรียบเทียบเครื่องมือสร้างรายงานการประชุมอัตโนมัติด้วย AI ที่เผยแพร่โดยสื่อเปรียบเทียบซอฟต์แวร์ IT Trend ระบุผลของการนำเครื่องมือเหล่านี้มาใช้ว่าช่วยลดชั่วโมงงานในการจัดทำรายงานการประชุม อย่างไรก็ตาม สิ่งที่สื่อเปรียบเทียบนำเสนอคือรายการฟังก์ชันและค่าบริการของแต่ละผลิตภัณฑ์ ไม่ใช่ตัวเลขที่ระบุเชิงปริมาณว่าลดได้กี่ % ภายใต้เงื่อนไขใด
เป็นเรื่องธรรมดาที่เวลาพิจารณานำระบบมาใช้ จะอยากหาตัวเลขอัตราการลดงาน แต่โดยทั่วไปอัตราการลดงานที่หมุนเวียนอยู่ในตลาด มักถูกอ้างอิงต่อ ๆ กันมาโดยไม่ระบุขนาดขององค์กรที่เป็นกรณีศึกษา ประเภทของการประชุม หรือขั้นตอนการทำรายงานการประชุมก่อนนำระบบมาใช้ ถ้าเป็นองค์กรที่เคยเขียนด้วยลายมือแล้วมาพิมพ์เรียบเรียงใหม่ ตัวเลขที่ลดได้ก็จะออกมาสูง แต่ถ้าเป็นองค์กรที่เดิมเขียนเป็นหัวข้อย่อยตามเทมเพลตอยู่แล้ว ผลก็จะน้อยลง การเขียนตัวเลขที่ไม่ทราบเงื่อนไขตั้งต้นลงในเอกสารขออนุมัติ จะทำให้ภายหลังสร้างเกณฑ์วัดผลไม่ได้
ลำดับที่เหมาะสมในทางปฏิบัติคือ ก่อนจะไปหาอัตราการลดงานของบริษัทอื่น ให้วัดสภาพปัจจุบันขององค์กรตนเองจริง ๆ เป็นเวลา 1 ถึง 2 สัปดาห์ การวัดไม่ใช่เรื่องยาก เพียงให้ผู้รับผิดชอบรายงานเวลาที่ใช้ไปกับการจัดทำเอกสารหลังประชุมด้วยตนเองก็เพียงพอ เมื่อมีค่าที่วัดได้จริงนี้ เกณฑ์เปรียบเทียบก็จะกลายเป็นตัวเลขขององค์กรเอง และไม่จำเป็นต้องหยิบยืมตัวเลขภายนอกที่ไม่ทราบแหล่งที่มา
ความต่างของความแม่นยำรายภาษา ซึ่งเป็นเงื่อนไขตั้งต้นของการใช้ AI ถอดเสียง
ภาษาอังกฤษและภาษาญี่ปุ่นอยู่ในระดับใช้งานจริงได้แล้ว
เครื่องมือถอดเสียงด้วย AI ทั่วไปอย่าง Notta, Fireflies.ai และ Transkriptor มีความแม่นยำถึงระดับใช้งานจริงได้แล้วสำหรับภาษาอังกฤษและภาษาญี่ปุ่น บทความอธิบายที่ว่าด้วยการใช้ AI ถอดเสียงในการประชุมภายในองค์กร ก็จัดระเบียบประเด็นเรื่องความแม่นยำและความลับ โดยตั้งอยู่บนสมมติฐานว่าใช้กับการประชุมภาษาญี่ปุ่น เมื่อป้อนไฟล์เสียงการประชุมเข้าไป แม้จะยังเหลือความผิดพลาดในการแปลงชื่อเฉพาะและศัพท์เฉพาะภายในองค์กร แต่ข้อความที่ได้กลับมาก็ยังพอตามความหมายได้ ความผิดพลาดเหล่านั้นยังลดลงได้พอสมควรด้วยการลงทะเบียนชื่อบริษัทและรหัสสินค้าไว้ในพจนานุกรมศัพท์
บทความเปรียบเทียบเครื่องมือสรุปเนื้อหาจากต่างประเทศก็แนะนำผลิตภัณฑ์หลายตัวที่จัดการตั้งแต่การถอดเสียงไปจนถึงการสรุปแบบครบวงจร แสดงว่าในโลกที่ใช้ภาษาอังกฤษ การเชื่อมการถอดเสียงเข้ากับการสรุปกลายเป็นโครงสร้างฟังก์ชันมาตรฐานไปแล้ว อย่างไรก็ตาม บทความเปรียบเทียบนี้เป็นบทความบล็อกที่เขียนโดยผู้ให้บริการ API รู้จำเสียงเอง ไม่ใช่การประเมินเทียบเคียงโดยบุคคลที่สามที่เป็นอิสระ จึงต้องอ่านโดยหักลบประเด็นนี้ไว้ด้วย
ปัญหาคือ เวลาพิจารณานำระบบมาใช้ มักไม่มีการตรวจสอบว่าระดับใช้งานจริงได้ที่ว่านั้นเป็นเรื่องของภาษาใด ความล้มเหลวที่ว่าเครื่องมือซึ่งประเมินแล้วดีที่สำนักงานใหญ่ในญี่ปุ่น พอนำมาขยายผลที่ฐานในประเทศไทยตรง ๆ กลับไม่มีใครใช้ ก็เกิดขึ้นจากจุดนี้
ความแม่นยำของภาษาไทยที่ลดลงมีเหตุผลเชิงโครงสร้าง
การรู้จำเสียงภาษาไทยเป็นเรื่องยาก ไม่ได้เกิดจากการออกเสียงของผู้พูด แต่มาจากโครงสร้างของภาษาเอง ปัจจัยหลักมี 3 ข้อ
ข้อแรกคือวรรณยุกต์ ภาษาไทยเป็นภาษาที่มีวรรณยุกต์ 5 เสียง แม้พยัญชนะและสระจะเรียงเหมือนกัน หากวรรณยุกต์ต่างกันก็กลายเป็นคนละคำ ระบบจึงต้องดึงการเปลี่ยนแปลงของระดับเสียงออกมาให้ถูกต้องจากเสียงในห้องประชุมที่มีเสียงรบกวน
ข้อที่สองคือการไม่เว้นวรรคระหว่างคำ ภาษาไทยไม่ใส่ช่องว่างระหว่างคำกับคำ ตัวอักษรจึงเรียงต่อเนื่องกันไป ด้วยเหตุนี้ หลังแปลงเสียงเป็นตัวอักษรแล้วยังต้องมีขั้นตอนตัดคำเพื่อตัดสินว่าช่วงใดถึงช่วงใดคือหนึ่งคำ และถ้าพลาดตรงนี้ ทั้งการสรุปและการค้นหาที่ตามมาก็จะเพี้ยนไปหมด ภาษาญี่ปุ่นก็ไม่เว้นวรรคเช่นกัน แต่การสลับกันระหว่างตัวอักษรคันจิกับตัวอักษรคานะเป็นเบาะแสของรอยต่อระหว่างคำ ส่วนภาษาไทยไม่มีเบาะแสแบบนั้น
ข้อที่สามคือการเขียนตัวเลข ในภาษาไทย วิธีพูดถึงจำนวนและวันที่ขึ้นอยู่กับบริบท เวลาถอดออกมาเป็นข้อความจึงไม่มีคำตอบเดียวว่าควรเขียนในรูปแบบใด เนื่องจากการประชุมในภาคการผลิตมีตัวเลขอย่างจำนวน ขนาด วันที่ และอัตราของเสียเป็นแกนกลาง ความคลุมเครือนี้จึงส่งผลตรง ๆ ในทางปฏิบัติ
งานวิจัยด้านการรู้จำเสียงภาษาไทยก้าวหน้าขึ้นในระยะหลัง โดยงานวิจัยที่เผยแพร่ในเดือนมกราคม 2026 ได้เสนอโมเดลรู้จำเสียงภาษาไทยขนาดเบาที่รองรับการประมวลผลแบบเรียลไทม์ นี่เป็นผลงานวิจัยเชิงวิชาการ ไม่ได้หมายความว่าเครื่องมือที่วางขายจะขึ้นถึงระดับนี้ในทันที แต่ในทางกลับกัน ก็สะท้อนแกนเวลาว่าการรู้จำเสียงภาษาไทยแบบเรียลไทม์ที่ใช้งานได้จริงเพิ่งตั้งต้นเป็นงานวิจัยในช่วงต้นปี 2026 จากแกนเวลานี้จึงอ่านได้ว่าการรองรับภาษาไทยของเครื่องมือเชิงพาณิชย์ทั่วไปยังไม่สุกงอมเท่ากับภาษาอังกฤษและภาษาญี่ปุ่น
เรื่องความแม่นยำและค่าใช้จ่ายของการใช้ AI กับภาษาไทยโดยทั่วไป ได้จัดระเบียบไว้ในความแม่นยำและค่าใช้จ่ายของ Generative AI ภาษาไทย การสรุปและการแปลที่อยู่ปลายทางของการถอดเสียง ก็ได้รับข้อจำกัดเฉพาะของภาษาไทยเช่นเดียวกัน
ภาษาเวียดนามมีทั้งวรรณยุกต์ ความต่างของสำเนียงถิ่น และปริมาณกับคุณภาพของข้อมูลฝึกสอน
ภาษาเวียดนามก็เป็นภาษาที่มีวรรณยุกต์เช่นกัน โดยมีวรรณยุกต์ 6 เสียง เช่นเดียวกับภาษาไทย ความต่างของวรรณยุกต์เปลี่ยนความหมายของคำโดยตรง การจับระดับเสียงผิดจึงไม่ใช่แค่พิมพ์ผิด แต่เป็นการเข้าใจความหมายผิด
ความยากเฉพาะตัวของภาษาเวียดนามคือความต่างของสำเนียงถิ่นที่มาก ภาคเหนือ ภาคกลาง และภาคใต้ออกเสียงไม่เหมือนกัน คำเดียวกันก็ออกเสียงจริงต่างกัน ในการประชุมของโรงงาน พนักงานที่มาจากคนละภูมิภาคนั่งอยู่ด้วยกัน ไฟล์เสียงไฟล์เดียวจึงมีระบบการออกเสียงหลายแบบปะปนกัน
ยิ่งกว่านั้น ข้อจำกัดด้านข้อมูลฝึกสอนยังถูกชี้ว่าเป็นปัญหาที่ฝังลึก บทความที่นำเสนอในการประชุมวิชาการปี 2026 ก็หยิบยกปัญหาด้านข้อมูลขึ้นมาอีกครั้งในฐานะโจทย์ของการรู้จำเสียงภาษาเวียดนาม ทั้งเรื่องปริมาณของข้อมูลฝึกสอน รวมถึงคุณภาพและความสม่ำเสมอของการกำกับข้อมูล ข้อเท็จจริงที่ว่าบทความวิชาการซึ่งผ่านการตรวจทานโดยผู้ทรงคุณวุฒิยังชี้ประเด็นนี้ในปี 2026 ถือเป็นข้อมูลสำคัญสำหรับฝ่ายที่ต้องเลือกเครื่องมือเชิงพาณิชย์ แม้ผู้ขายเครื่องมือจะแสดงว่ารองรับภาษาเวียดนาม ก็ต้องประเมินบนสมมติฐานว่าการรองรับนั้นไม่ได้หมายถึงคุณภาพเท่ากับภาษาอังกฤษ
เรื่องความแม่นยำของ Generative AI ในภาษาเวียดนามโดยรวม ได้กล่าวไว้ในความแม่นยำของ Generative AI ภาษาเวียดนาม
วิธีจัดการในทางปฏิบัติเมื่อมองแยกตามภาษา
เมื่อเรียบเรียงทั้งหมดข้างต้นให้อยู่ในรูปที่ใช้ได้จริงตอนพิจารณานำระบบมาใช้ จะได้ดังนี้ เนื่องจากไม่มีเกณฑ์วัดเทียบเคียงที่เปิดเผยต่อสาธารณะสำหรับตัวเลขความแม่นยำ ตรงนี้จึงไม่แสดงเป็นตัวเลข แต่แสดงเป็นวิธีจัดการในการใช้งาน
| ภาษา | จุดยากเชิงโครงสร้าง | วิธีจัดการในทางปฏิบัติ | ประมาณการชั่วโมงงานตรวจสอบโดยคน |
|---|---|---|---|
| ภาษาญี่ปุ่น | แปลงชื่อเฉพาะและศัพท์ภายในองค์กรผิด | ลงทะเบียนพจนานุกรมศัพท์แล้วใช้ได้แทบทันที | อ่านทบทวนและตรวจทานตัวเลขเท่านั้น |
| ภาษาอังกฤษ | ผู้พูดสำเนียงหนัก เสียงผู้พูดหลายคนซ้อนกัน | ใช้ได้แทบทันที ควรตรวจสอบความแม่นยำของการแยกผู้พูด | อ่านทบทวนและตรวจทานตัวเลขเท่านั้น |
| ภาษาไทย | วรรณยุกต์ 5 เสียง ไม่เว้นวรรคระหว่างคำ การเขียนตัวเลขไม่คงที่ | ใช้เป็นวัตถุดิบได้ แต่ตัวเลขและชื่อเฉพาะต้องให้คนตรวจสอบเสมอ | ตรวจสอบตัวเลขและข้อตัดสินใจทุกรายการ |
| ภาษาเวียดนาม | วรรณยุกต์ 6 เสียง ความต่างของสำเนียงถิ่น ข้อจำกัดด้านปริมาณและคุณภาพของข้อมูลฝึกสอน | เช่นเดียวกับภาษาไทย หากมีผู้พูดที่สำเนียงถิ่นต่างกันมาก ความแม่นยำจะลดลง | ตรวจสอบตัวเลขและข้อตัดสินใจทุกรายการ |
| หลายภาษาปะปนกัน | ตรวจจับการสลับภาษาไม่ครบ | การประชุมที่เปลี่ยนภาษาเป็นรายคำพูด ควรทบทวนสมมติฐานของการประมวลผลอัตโนมัติใหม่ | บางกรณีจำเป็นต้องตรวจสอบข้อความทั้งหมด |
สิ่งที่ตารางนี้ต้องการสื่อ ไม่ใช่ว่า AI ถอดเสียงใช้กับภาษาไทยหรือภาษาเวียดนามไม่ได้ แต่คือใช้ได้ โดยต้องใส่ขั้นตอนการตรวจสอบโดยคนเข้าไปในกระบวนการปลายทางอย่างชัดเจน หากนำระบบมาใช้โดยไม่เผื่อขั้นตอนตรวจสอบไว้เป็นชั่วโมงงาน ก็จะได้ข้อสรุปว่าความแม่นยำต่ำจนใช้ไม่ได้ และระบบจะไม่ติดตั้งอยู่ในองค์กร
กำหนดเส้นผ่านของความแม่นยำไว้ล่วงหน้า
สิ่งที่มักเกิดขึ้นตอนพิจารณานำระบบมาใช้คือ การถกเรื่องความแม่นยำจบลงด้วยความรู้สึกส่วนตัว คำพูดอย่างถูกอยู่พอสมควร หรือผิดเป็นบางครั้ง ไม่สามารถใช้ตัดสินว่าจะนำมาใช้หรือไม่
ในทางปฏิบัติ ถ้าแยกเส้นผ่านออกเป็น 3 ข้อดังนี้ การถกเถียงจะได้ข้อสรุป
- ความถูกต้องของตัวเลข จำนวน วันที่ ยอดเงิน และอัตราของเสียถูกถอดออกมาถูกต้องหรือไม่ ตรงนี้เรียกร้อง 100% ได้ และตั้งสมมติฐานว่าไม่ใช้ผลลัพธ์อัตโนมัติตรง ๆ แต่ให้คนตรวจทาน
- ความถูกต้องของชื่อเฉพาะ ชื่อลูกค้า รหัสสินค้า ชื่อเครื่องจักร วัดในช่วงทดลองใช้ว่าการลงทะเบียนพจนานุกรมศัพท์ช่วยให้ดีขึ้นได้แค่ไหน
- ความสามารถในการตามความหมาย แม้จะมีคำที่แปลงผิด คนอ่านยังเข้าใจหรือไม่ว่ากำลังพูดเรื่องอะไร ตรงนี้ยอมให้มีความผิดพลาดได้บ้าง
การแบ่ง 3 ส่วนนี้ช่วยให้ไม่ด่วนสรุปว่าใช้ไม่ได้ทันทีที่เห็นผลการถอดเสียงภาษาไทย เพราะสภาพที่ตามความหมายได้แต่ตัวเลขน่าสงสัย คือสภาพที่แทรกขั้นตอนตรวจสอบเข้าไปเพียงขั้นตอนเดียวก็ใช้งานได้จริงแล้ว
การขยายผลสู่ AI สรุปสำหรับงานธุรกิจ และการออกแบบ AI สร้างรายงานอัตโนมัติ
ออกแบบโดยแบ่งเป็น 3 ขั้น
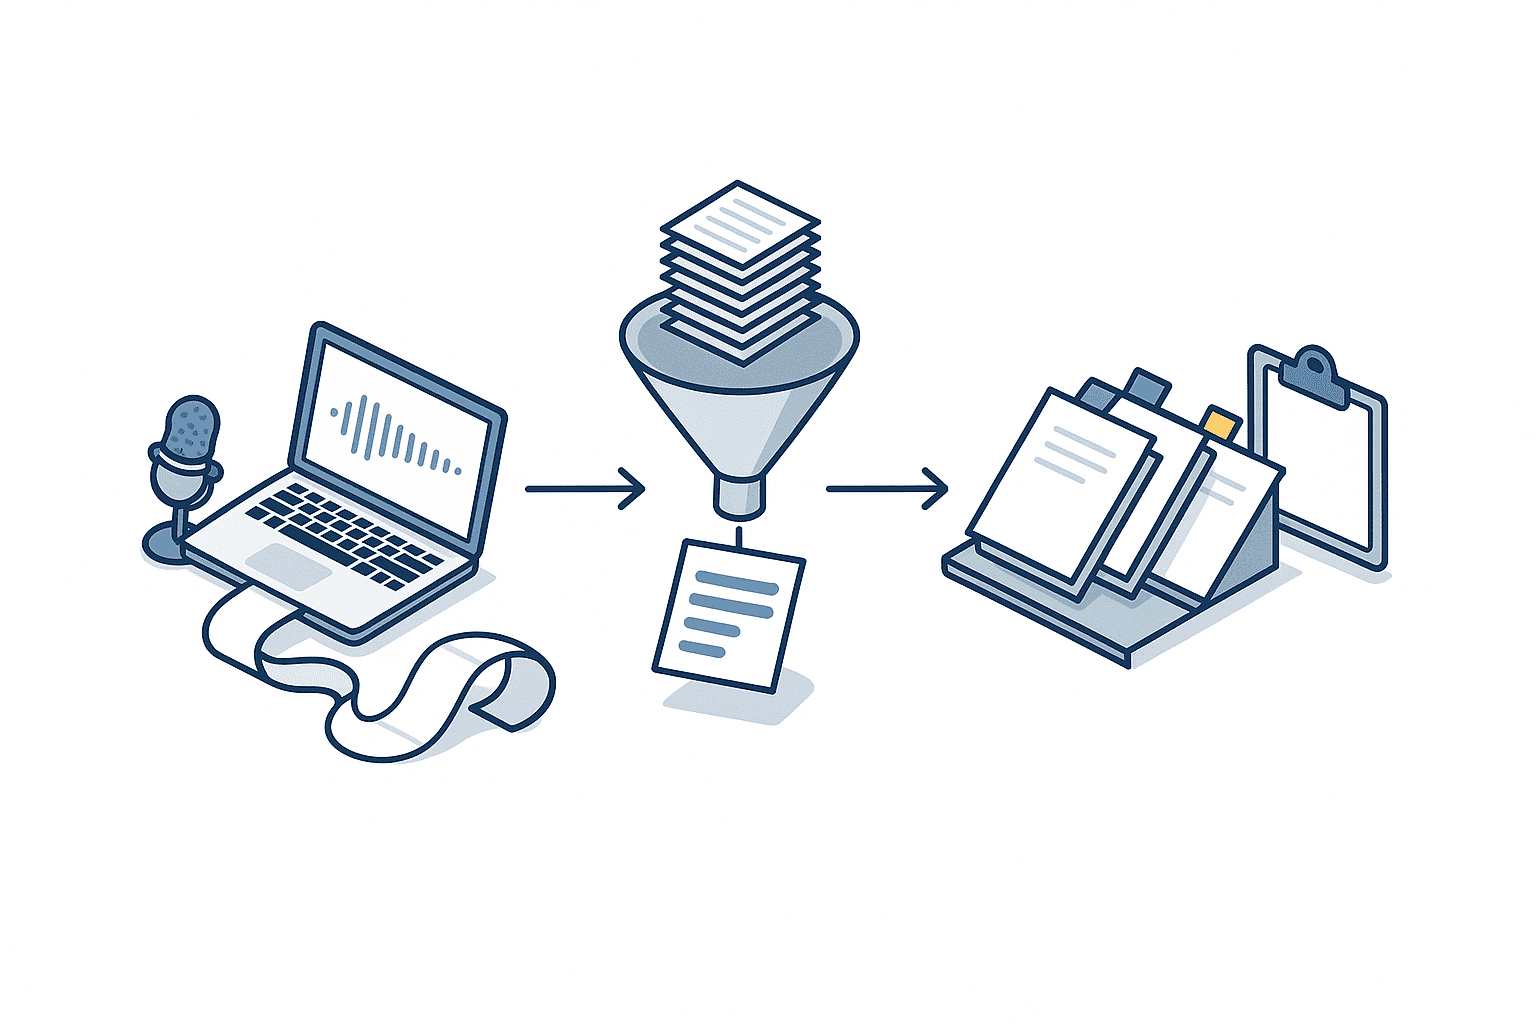
จากตรงนี้คือใจกลางของบทความ เราจะออกแบบเส้นทางจากเสียงไปสู่ผลลัพธ์ โดยแบ่งออกเป็น 3 ขั้นดังนี้
ขั้นที่ 1 คือการถอดเสียง แปลงเสียงเป็นข้อความที่มีเวลาและผู้พูดกำกับเป็นรายคำพูด ผลลัพธ์ของขั้นนี้ไม่ใช่เอกสารสำหรับให้คนอ่าน แต่เป็นวัตถุดิบสำหรับให้ขั้นถัดไปประมวลผล
ขั้นที่ 2 คือการสรุป ดึงข้อตัดสินใจ เรื่องที่ยังไม่ได้ข้อสรุป ผู้รับผิดชอบและกำหนดเวลา รวมถึงภูมิหลังของประเด็น ออกมาจากวัตถุดิบ แล้วทำให้เป็นข้อมูลที่มีโครงสร้าง สิ่งสำคัญตรงนี้คือให้ผลลัพธ์ออกมาเป็นรายการหัวข้อ ไม่ใช่เป็นเรียงความ
ขั้นที่ 3 คือการสร้างรายงาน นำหัวข้อที่ได้จากขั้นที่ 2 ไหลเข้าเทมเพลตที่แยกตามผู้รับ แล้วประกอบขึ้นเป็นผลลัพธ์อย่างรายงานการประชุม รายงานฉบับต่าง ๆ และสรุปรายสัปดาห์
ข้อดีที่สุดของการแบ่ง 3 ขั้นนี้คือแยกแยะสาเหตุของความล้มเหลวได้ เมื่อผลลัพธ์ใช้การไม่ได้ เราจะรู้ว่าสาเหตุอยู่ที่การรู้จำเสียง อยู่ที่คำสั่งในการดึงข้อมูล หรืออยู่ที่การออกแบบเทมเพลต หากใช้โครงสร้างที่เครื่องมือตัวเดียวพ่นผลจากเสียงออกมาเป็นรายงานการประชุมรวดเดียว จะแยกแยะแบบนี้ไม่ได้ และลงมือปรับปรุงอะไรไม่ได้เลย
ข้อมูลเข้าออกและการเข้ามีส่วนร่วมของคนในแต่ละขั้น
เรามาจัดระเบียบกันว่าในแต่ละขั้นทั้ง 3 อะไรเข้าไปและอะไรออกมา และคนเข้ามาเกี่ยวข้องตรงจุดใด
| ขั้น | ข้อมูลเข้า | ข้อมูลออก | การเข้ามีส่วนร่วมของคน | ความง่ายในการทำอัตโนมัติ |
|---|---|---|---|---|
| ขั้นที่ 1 การถอดเสียง | ไฟล์เสียงหรือไฟล์บันทึกการประชุม | ข้อความที่มีผู้พูดและเวลากำกับ | จัดทำพจนานุกรมศัพท์ ตรวจทานตัวเลข | สูง แทบตัดสินได้ที่การเลือกเครื่องมือ |
| ขั้นที่ 2 การสรุป | ข้อความจากขั้นที่ 1 | ข้อมูลรายหัวข้อของข้อตัดสินใจ เรื่องที่ยังไม่ได้ข้อสรุป ผู้รับผิดชอบและกำหนดเวลา | นิยามหัวข้อที่จะดึง ตรวจผลลัพธ์ในช่วงแรก | ปานกลาง การออกแบบคำสั่งมีผลมาก |
| ขั้นที่ 3 การสร้างรายงาน | ข้อมูลรายหัวข้อจากขั้นที่ 2 | เอกสารอย่างรายงานการประชุม รายงานฉบับต่าง ๆ และบทสรุป | สร้างและดูแลเทมเพลต | สูง แต่ต้องใช้ชั่วโมงงานออกแบบในช่วงแรก |
สิ่งที่อ่านได้จากตารางนี้คือการจัดสรรแรงที่จะทุ่มลงไป ขั้นที่ 1 แทบตัดสินได้ที่การเลือกเครื่องมือ ส่วนขั้นที่ 3 เมื่อสร้างเทมเพลตแล้วก็ใช้ซ้ำได้เรื่อย ๆ สิ่งที่ต้องลงแรงอย่างต่อเนื่องคือขั้นที่ 2 นั่นคือการออกแบบคำสั่งสำหรับการสรุป พูดกลับกัน การทุ่มเวลาออกแบบไปที่จุดนี้คือแนวทางที่มีประสิทธิภาพที่สุด
ตรึงรูปแบบของบทสรุปไว้ก่อน
ความล้มเหลวที่พบมากที่สุดเมื่อใช้ AI สรุปในงานธุรกิจคือการสั่งเพียงว่าช่วยสรุปให้หน่อย คำสั่งแบบนี้ทำให้ระดับความละเอียดและโครงสร้างของบทสรุปที่ได้เปลี่ยนไปทุกครั้ง เมื่อเปลี่ยนทุกครั้ง ผู้อ่านก็ต้องอ่านทั้งหมดทุกครั้ง จึงไม่ได้ลดเวลาลงเลย
ในทางปฏิบัติ ให้ตรึงหัวข้อที่จะดึงออกมาไว้ก่อน หากเป็นการประชุมในภาคการผลิต รูปแบบต่อไปนี้ใช้ได้สะดวก
- ข้อตัดสินใจ อะไรที่ตัดสินไปแล้ว ให้ระบุผู้ตัดสินใจและวันที่ตัดสินใจด้วย
- เรื่องที่ยังไม่ได้ข้อสรุป อะไรที่ยังตัดสินไม่ได้ ใครจะเป็นผู้ตัดสินในลำดับถัดไป
- ผู้รับผิดชอบและกำหนดเวลา ใครต้องทำอะไรภายในเมื่อไร หากยังไม่ได้กำหนดผู้รับผิดชอบ ให้ระบุชัดว่ายังไม่กำหนด
- ตัวเลข ให้ไล่เรียงจำนวน วันที่ ยอดเงิน และอัตราของเสียที่ปรากฏในการประชุมออกมาตามที่พูดจริง
- ภูมิหลังของประเด็น เหตุใดจึงเกิดการถกเถียงนั้นขึ้น ไม่เกิน 1 ย่อหน้า
เมื่อกำหนดรูปแบบนี้ไว้ เกณฑ์ประเมินคุณภาพของบทสรุปก็ถูกกำหนดไปพร้อมกัน เพราะเราจะตรวจได้อย่างเป็นรูปธรรมว่าเก็บข้อตัดสินใจได้ครบหรือไม่ กำหนดเวลาตกหล่นหรือไม่ และหลุดพ้นจากการประเมินแบบรู้สึกว่าบทสรุปยังไม่แน่นได้
โดยเฉพาะข้อที่ 4 คือการไล่เรียงตัวเลข จะได้ผลมากในการประชุมภาษาไทยและภาษาเวียดนาม หากให้ไล่เรียงเฉพาะตัวเลขไว้เป็นหัวข้อแยกต่างหาก จุดที่คนต้องตรวจสอบจะรวมอยู่ที่เดียว และตรวจทานได้โดยไม่ต้องกลับไปอ่านข้อความทั้งหมด นี่คือกลไกที่ทำให้แนวทางที่ว่าตัวเลขต้องให้คนตรวจทุกรายการ ซึ่งกล่าวไว้ในหัวข้อก่อนหน้า อยู่ในระดับชั่วโมงงานที่เป็นจริงได้
เวลาจะลงเป็นรายงาน ให้ผ่านข้อมูลที่มีโครงสร้างก่อน
เราแนะนำว่าอย่าให้ผลลัพธ์ของขั้นที่ 2 ออกมาเป็นเอกสารสำเร็จรูปทันที ให้ออกมาเป็นข้อมูลที่แบ่งเป็นหัวข้อ แล้วค่อยไหลเข้าเทมเพลต รูปแบบนี้มีข้อดี 3 ข้อ
- สร้างเอกสารหลายชิ้นที่มีผู้รับต่างกันจากการประชุมเดียวกันได้ ปรับระดับความละเอียดให้ต่างกันระหว่างฉบับสำหรับสำนักงานใหญ่ที่ญี่ปุ่นกับฉบับสำหรับหน่วยงานในพื้นที่ได้
- ถ้าแก้เทมเพลต ก็สร้างเอกสารของการประชุมครั้งก่อน ๆ ขึ้นใหม่ทั้งชุดได้
- เมื่อหัวข้อใดว่างเปล่า จะแยกแยะได้ง่ายว่าการดึงข้อมูลล้มเหลว หรือในที่ประชุมไม่ได้พูดเรื่องนั้นเลย
ข้อที่ 3 สำคัญเป็นพิเศษในทางการใช้งาน หากให้ผลลัพธ์ออกมาเป็นเรียงความ ข้อเท็จจริงที่ว่ายังไม่ได้กำหนดผู้รับผิดชอบจะถูกฝังหายไปในเนื้อความจนมองไม่เห็น แต่ถ้าเหลือช่องว่างไว้เป็นหัวข้อ ก็จะเห็นได้ในพริบตาว่ายังมีสิ่งที่ต้องเติมค้างอยู่
ลำดับขั้นเมื่อต้องแจกจ่ายหลายภาษา
ที่ฐานในประเทศไทย มีหลายกรณีที่ต้องแจกจ่ายเนื้อหาเดียวกันทั้งภาษาญี่ปุ่นและภาษาอังกฤษ หรือภาษาไทย ในกรณีนี้ การเลือกว่าจะแปลในขั้นใดจะทำให้ปริมาณงานย้อนกลับต่างกัน
แนวทางที่แนะนำคือ ทำจนถึงการสรุปในขั้นที่ 2 ด้วยภาษาต้นฉบับของการประชุม แล้วค่อยแทรกการแปลก่อนการสร้างรายงานในขั้นที่ 3 หากแปลข้อความทั้งหมดทันทีหลังถอดเสียง ความผิดพลาดของการแปลจะแพร่ต่อไปยังบทสรุป และตามไม่ได้ว่าความหมายเปลี่ยนไปตรงจุดใด ข้อมูลรายหัวข้อหลังสรุปมีปริมาณน้อย ชั่วโมงงานในการตรวจสอบคำแปลจึงอยู่ในระดับที่จำกัด
เรื่องการทำให้กระบวนการแปลภายในองค์กรเป็นอัตโนมัติ ได้กล่าวไว้ในการแปลอัตโนมัติในองค์กร ปี 2026 แม้จะเป็นการใส่การแปลเข้าไปในเวิร์กโฟลว์ของการประชุม แนวทางการบริหารคลังศัพท์ที่จัดระเบียบไว้ในบทความนั้นก็ยังใช้ได้ตรง ๆ
ประเด็นเรื่องการใช้ AI ถอดเสียงเมื่อมองจาก PDPA และข้อมูลความลับ
สิ่งที่ต้องตรวจสอบควบคู่ไปกับการออกแบบเวิร์กโฟลว์คือการจัดการเรื่องกฎหมายและความลับ การส่งเสียงการประชุมไปยังบริการภายนอก ในทางเทคนิคเป็นเพียงการอัปโหลดไฟล์ แต่ในแง่ของการจัดการ ถือเป็นการส่งมอบข้อมูลส่วนบุคคลและความลับภายในองค์กรออกไปภายนอก หากปล่อยเรื่องนี้ไว้ทีหลัง จะกลายเป็นรูปแบบที่เสียหายมากที่สุด คือถูกสั่งหยุดตอนที่การใช้งานเข้าที่เข้าทางแล้ว
PDPA ของไทยกับกฎเกณฑ์การโอนข้อมูลข้ามพรมแดน
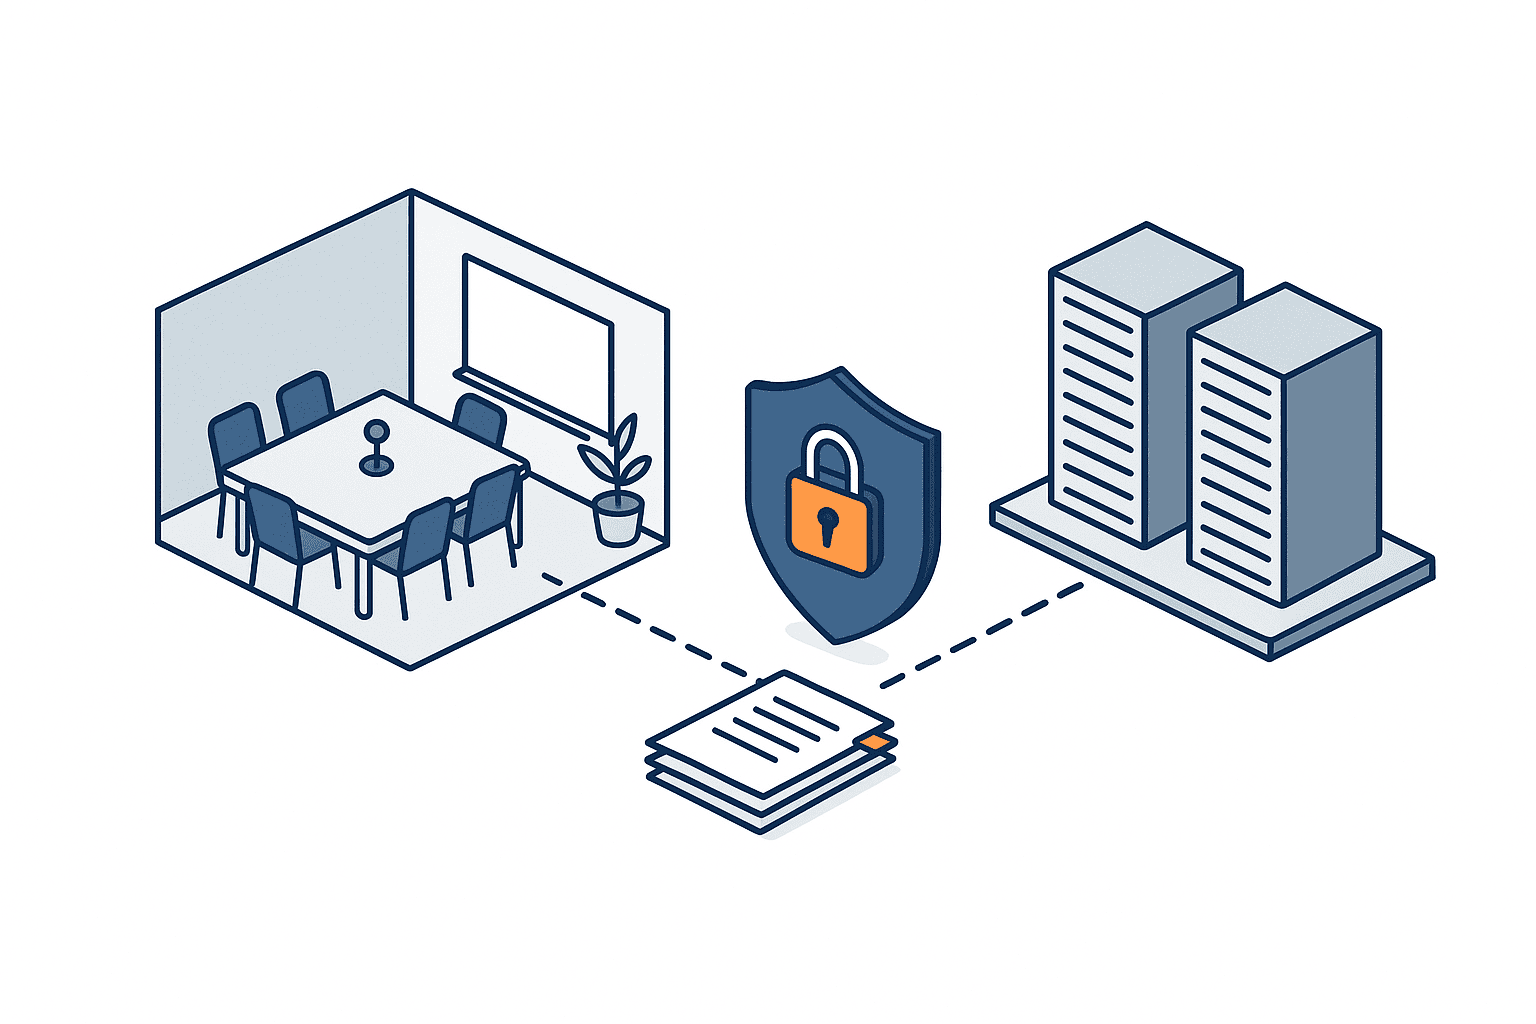
สำหรับกฎหมายคุ้มครองข้อมูลส่วนบุคคลของไทยหรือที่เรียกกันว่า PDPA นั้น กฎลำดับรองที่เกี่ยวกับการโอนข้อมูลข้ามพรมแดนมีผลใช้บังคับตั้งแต่วันที่ 24 มีนาคม 2024 ตามคำอธิบายของสำนักงานกฎหมาย กฎเกณฑ์ดังกล่าวทำให้เงื่อนไขของการโอนข้อมูลส่วนบุคคลไปต่างประเทศมีความชัดเจนเป็นรูปธรรมขึ้น
การส่งไฟล์บันทึกเสียงการประชุมไปยังบริการถอดเสียงบนคลาวด์ไม่ใช่เรื่องที่ไม่เกี่ยวข้องกับกฎเกณฑ์นี้ เสียงการประชุมมีข้อมูลส่วนบุคคลอยู่ ทั้งชื่อผู้เข้าร่วม หน่วยงานที่สังกัด ตัวเสียงเอง และในบางกรณีอาจมีชื่อและข้อมูลติดต่อของผู้รับผิดชอบฝ่ายลูกค้า หากใช้บริการที่ประมวลผลบนเซิร์ฟเวอร์ในต่างประเทศ ก็อาจเข้าข่ายการโอนข้อมูลส่วนบุคคลออกนอกประเทศ
หากเข้าข่าย ก็จะเกิดความจำเป็นต้องทำให้ครบตามเงื่อนไขของการโอนข้ามพรมแดนที่กฎเกณฑ์กำหนด เช่น การขอความยินยอม หรือการใช้ข้อสัญญามาตรฐาน สิ่งที่ต้องระวังตรงนี้คือ นี่ไม่ใช่การบอกว่าห้ามใช้ SaaS จากต่างประเทศ แต่เป็นเรื่องของการดำเนินขั้นตอนให้ครบตามเงื่อนไข ปัญหาในทางปฏิบัติอยู่ที่หน้างานเริ่มใช้เครื่องมือด้วยบัญชีส่วนตัวโดยยังไม่ได้ผ่านขั้นตอนเหล่านั้น
บทความนี้ไม่ได้เป็นการชี้ขาดการตีความกฎหมาย การจะเข้าข่ายหรือไม่ในทางปฏิบัติขึ้นอยู่กับเนื้อหาของข้อมูลที่จัดการ สถานที่ประมวลผลของบริการ และรูปแบบของสัญญา จึงขอให้ตรวจสอบกับฝ่ายกฎหมายหรือผู้เชี่ยวชาญในพื้นที่ก่อนนำระบบมาใช้ สิ่งที่ต้องการจะบอกตรงนี้คือ มีประเด็นที่ต้องตรวจสอบอยู่จริง และควรวางการตรวจสอบนั้นไว้ในช่วงต้นของการพิจารณานำระบบมาใช้
เมื่อออกแบบเป็นเวิร์กโฟลว์ สิ่งสำคัญคือต้องทำการตรวจสอบนี้ไม่เฉพาะกับการถอดเสียงในขั้นที่ 1 แต่รวมถึงการสรุปในขั้นที่ 2 และการสร้างรายงานในขั้นที่ 3 ด้วย ในโครงสร้างที่ใช้บริการต่างกันในแต่ละขั้น ปลายทางที่ส่งเสียงไป ปลายทางที่ส่งข้อความไป และปลายทางที่จัดเก็บเอกสารที่สร้างขึ้น ล้วนต่างกัน หากตรวจสอบเฉพาะบริการถอดเสียงแล้ววางใจ ก็อาจเกิดกรณีที่ข้อมูลความลับชุดเดียวกันรั่วออกไปภายนอกผ่านอีกเส้นทางหนึ่งในขั้นถัดไป ขอให้เขียนลงในกระดาษแผ่นเดียวว่าข้อมูลใดถูกส่งไปที่ใดในแต่ละขั้น
ตรวจสอบนโยบายการนำไปฝึกสอนโมเดลและการเก็บรักษาข้อมูลในสัญญา
นอกเหนือจากกฎหมายแล้ว ยังมีสิ่งที่ต้องตรวจสอบในมุมของการรักษาความลับ การประชุมมีทั้งกลยุทธ์ธุรกิจ ข้อมูลราคา ข้อกำหนดผลิตภัณฑ์ที่ยังไม่เปิดเผย และเรื่องที่เกี่ยวข้องกับงานบุคคล เมื่อจะส่งสิ่งเหล่านี้ไปยังบริการภายนอก ก็ต้องตรวจสอบตั้งแต่ขั้นทำสัญญาว่าข้อมูลนั้นจะถูกจัดการอย่างไร
หัวข้อที่ควรตรวจสอบมีดังนี้
- เสียงและข้อความที่ป้อนเข้าไปจะถูกนำไปใช้ฝึกสอนโมเดลหรือไม่ มีการตั้งค่าไม่ให้ถูกนำไปใช้หรือไม่ และการตั้งค่านั้นเป็นค่าตั้งต้นหรือไม่
- ระยะเวลาเก็บรักษาข้อมูล หลังประมวลผลแล้วจะถูกลบภายในกี่วัน และร้องขอให้ลบได้หรือไม่
- ประเทศและภูมิภาคที่ประมวลผล ระบุที่ตั้งของศูนย์ข้อมูลได้หรือไม่
- มีการจ้างช่วงต่อหรือไม่ มีการจ้างช่วงงานรู้จำเสียงให้ผู้ประกอบการรายอื่นหรือไม่
- การให้บริการตรวจสอบและบันทึกการใช้งาน ตรวจสอบได้หรือไม่ว่าใครเข้าถึงเมื่อใด
โดยทั่วไป แผนแบบไม่มีค่าใช้จ่ายและแผนสำหรับผู้ใช้รายบุคคลจะมีเงื่อนไขเหล่านี้ต่างจากแผนสำหรับองค์กร หากไหลจากขั้นที่ผู้รับผิดชอบลองใช้ด้วยบัญชีส่วนตัวเข้าสู่การใช้งานจริง ความต่างนี้จะถูกมองข้าม ขอให้ตัดสินใจตั้งแต่แรกว่าจะทดลองใช้ด้วยสัญญาสำหรับองค์กร หรือจะจำกัดการทดลองใช้ไว้เฉพาะการประชุมที่มีความลับต่ำ
เรื่องโครงสร้างของสภาพแวดล้อมสำหรับใช้ Generative AI อย่างปลอดภัยภายในองค์กร ได้จัดระเบียบไว้ในสภาพแวดล้อม Generative AI ที่ปลอดภัย ปี 2026 การคิดโดยวางเวิร์กโฟลว์ของการถอดเสียงไว้ในการออกแบบสภาพแวดล้อมนั้นถือเป็นแนวทางที่เป็นจริงได้
การแบ่งชั้นความลับของการประชุมและการเลือกใช้เครื่องมือ
ไม่จำเป็นต้องจัดการทุกการประชุมเหมือนกันหมด การแบ่งชั้นตามระดับความลับ แล้วเปลี่ยนเครื่องมือและวิธีใช้งานตามแต่ละชั้น จะทำให้ระบบเดินได้จริงมากกว่า
| ชั้น | ตัวอย่างการประชุม | การส่งเสียงออกภายนอก | การใช้งาน |
|---|---|---|---|
| ทั่วไป | ประชุมติดตามความคืบหน้าตามวาระ อบรมภายในองค์กร | ใช้บริการคลาวด์ที่ทำสัญญาแบบองค์กรได้ | ใช้เวิร์กโฟลว์มาตรฐานได้ทันที |
| มีข้อมูลของคู่ค้า | เจรจากับซัพพลายเออร์ พิจารณาทางเทคนิคร่วมกับลูกค้า | ทำได้หลังตรวจสอบสัญญาและเงื่อนไขการโอนข้ามพรมแดนแล้ว | พิจารณาการประมวลผลล่วงหน้าเพื่อปกปิดชื่อเฉพาะ |
| ความลับสูง | แผนธุรกิจ กลยุทธ์ราคา งานบุคคล | โดยหลักการแล้วไม่ส่งออกภายนอก | จำกัดไว้ที่การจดด้วยลายมือ หรือระบบที่ทำงานในเครือข่ายปิด |
การขีดเส้นแบ่งชั้น หากเป็นฐานที่มีระเบียบการจัดการข้อมูลอยู่แล้ว การนำชั้นเดิมมาใช้ต่อเลยจะเป็นทางลัดที่สุด หากจะสร้างการแบ่งชั้นขึ้นใหม่ ตัวงานนั้นเองก็จะกินเวลาหลายเดือน แต่ถ้าใช้วิธีจับการประชุมไปเทียบกับชั้นการจัดการเอกสารที่มีอยู่แล้ว ก็จะตัดสินใจได้ภายในไม่กี่สัปดาห์
วิธีดำเนินการนำมาใช้ในฐานะ AI ระบบอัตโนมัติทางธุรกิจ
เริ่มจากการสำรวจการประชุมทั้งหมด
สิ่งที่ควรทำก่อนการเปรียบเทียบเครื่องมือคือการสำรวจการประชุมทั้งหมดของฐานตนเอง โดยทำเป็นรายการของหัวข้อต่อไปนี้สำหรับช่วง 1 เดือนล่าสุด
- ชื่อการประชุมและความถี่ในการจัด
- จำนวนผู้เข้าร่วมและภาษาที่ใช้เป็นหลัก
- ระยะเวลาต่อครั้ง
- ประเภทของเอกสารที่จัดทำหลังการประชุมและผู้รับเอกสาร
- ค่าเวลาที่ใช้ในการจัดทำเอกสารตามที่ผู้รับผิดชอบรายงานเอง
เมื่อทำรายการนี้ขึ้นมา ก็จะตัดสินใจคัดกรองเป้าหมายได้ ในหลายฐาน การประชุมเพียงบางส่วนกินชั่วโมงงานการจัดทำเอกสารไปเกือบทั้งหมด และเมื่อสำรวจแล้วความเอนเอียงนั้นจะปรากฏออกมาเป็นตัวเลข ไม่จำเป็นต้องเอาทุกการประชุมมาเป็นเป้าหมาย การเริ่มจากการประชุมที่ชั่วโมงงานกระจุกตัวอยู่คือทางที่สมเหตุสมผล
ผลพลอยได้ของการสำรวจคือการมองเห็นการประชุมที่แต่เดิมไม่ได้จัดทำเอกสารเลย การประชุมที่ไม่มีเอกสารหลงเหลืออยู่ ต้องมีการตกลงกันก่อนว่าควรเก็บอะไรไว้ ก่อนจะไปถึงการทำอัตโนมัติ
แบ่งช่วงด้วย 30 วันและ 90 วัน
หากเริ่มนำระบบมาใช้โดยไม่ขีดเส้นเวลา ก็จะจบลงที่สภาพทดลองใช้ไปเรื่อย ๆ การวางจุดแบ่ง 2 จุดดังต่อไปนี้เป็นรูปแบบที่จัดการได้ง่าย
| ช่วงเวลา | สิ่งที่ต้องทำ | สิ่งที่ต้องตัดสิน |
|---|---|---|
| 2 สัปดาห์ก่อนเริ่มใช้ | สำรวจการประชุมทั้งหมด และวัดเวลาที่ใช้จัดทำเอกสารจริง | คัดกรองการประชุมเป้าหมายให้เหลือไม่เกิน 3 ประเภท |
| 30 วันแรกนับจากเริ่ม | ใช้งานเฉพาะขั้นที่ 1 และขั้นที่ 2 การสร้างรายงานยังทำด้วยมือ | ความแม่นยำของการถอดเสียงถึงเส้นผ่านหรือไม่ พจนานุกรมศัพท์ช่วยให้ดีขึ้นหรือไม่ |
| วันที่ 30 ถึงวันที่ 90 | สร้างเทมเพลตของขั้นที่ 3 และใช้งานตลอดสาย | เวลาจัดทำเอกสารลดลงจากค่าที่วัดไว้จริงเท่าใด |
| หลังวันที่ 90 | ขยายการประชุมเป้าหมาย และผนวกการแจกจ่ายหลายภาษา | จะขยายไปหน่วยงานอื่น หรือจะคงเป้าหมายที่จำกัดไว้ให้ติดตั้งได้มั่นคง |
หากพยายามประกอบไปถึงการสร้างรายงานรวดเดียวใน 30 วันแรก การออกแบบเทมเพลตกับการตรวจสอบความแม่นยำจะเดินไปพร้อมกันจนแยกแยะปัญหาไม่ได้ ขอให้รักษาลำดับไว้ว่าจนถึงวันที่ 30 ให้หยุดอยู่แค่ขั้นที่ 2 แล้วจึงเริ่มลงมือกับเทมเพลตเมื่อรูปแบบของบทสรุปนิ่งแล้ว
รายการตรวจสอบที่ควรเคลียร์ก่อนเริ่มใช้
สาเหตุที่ทำให้หน้างานหยุดชะงัก ส่วนใหญ่อยู่นอกเหนือเรื่องเทคนิค การตรวจสอบสิ่งต่อไปนี้ก่อนลงมือจะช่วยลดการหยุดชะงักหลังเริ่มใช้
- เรื่องการบันทึกเสียงการประชุม ได้กำหนดวิธีแจ้งและวิธีขอความยินยอมจากผู้เข้าร่วมแล้วหรือยัง
- รูปแบบสัญญาของบริการที่จะใช้เป็นแบบสำหรับองค์กร และตรวจสอบการตั้งค่าเรื่องการนำไปฝึกสอนโมเดลแล้วหรือยัง
- ได้ตรวจสอบเรื่องการโอนข้อมูลข้ามพรมแดนกับฝ่ายกฎหมายหรือผู้เชี่ยวชาญในพื้นที่เรียบร้อยแล้วหรือยัง
- สภาพไมโครโฟนในห้องประชุมมีคุณภาพพอที่จะแยกแยะผู้พูดได้หรือไม่ เป็นการใช้งานแบบส่งไมโครโฟนตัวเดียวเวียนกันหรือไม่
- ได้กำหนดหรือยังว่าใครเป็นผู้จัดทำและใครเป็นผู้ปรับปรุงรายชื่อชื่อเฉพาะที่จะลงทะเบียนในพจนานุกรมศัพท์
- ใครจะเป็นผู้ตรวจสอบขั้นสุดท้ายของเอกสารที่ระบบสร้างออกมา ขั้นตอนการอนุมัติขัดแย้งกับกระบวนการขออนุมัติเดิมหรือไม่
ข้อที่ 4 เรื่องสภาพไมโครโฟนมักถูกมองข้าม ความแม่นยำของการแยกผู้พูดขึ้นอยู่กับวิธีที่เสียงเข้าไมโครโฟนอย่างมาก ไฟล์บันทึกที่ทุกคนพูดจากตำแหน่งที่ห่างจากไมโครโฟนตัวเดียว จะทำให้การแยกแยะผู้พูดเป็นเรื่องยากไม่ว่าจะใช้เครื่องมือใด การเพิ่มไมโครโฟนสำหรับห้องประชุมเพียงตัวเดียวในระดับไม่กี่พันบาท แล้วทำให้ความแม่นยำของขั้นตอนปลายทางเปลี่ยนไป เป็นเรื่องที่พบได้ไม่น้อย
จุดที่มักสะดุด
ความล้มเหลวที่พบซ้ำ ๆ ในงานสนับสนุนการนำระบบมาใช้มี 3 ข้อดังนี้
ข้อแรกคือขยายขอบเขตเป้าหมายมากเกินไป เมื่อเอาทุกการประชุมมาเป็นเป้าหมาย เส้นผ่านของความแม่นยำจะต่างกันไปในแต่ละการประชุมจนประเมินไม่ลงตัว และช่วงทดลองใช้ก็จบลงโดยไม่มีจุดใดถูกปรับปรุงเลย
ข้อที่สองคือเริ่มโดยไม่กำหนดรูปแบบของบทสรุป ดังที่กล่าวไปแล้วว่า เมื่อไม่มีรูปแบบ ระดับความละเอียดของผลลัพธ์จะเปลี่ยนไปทุกครั้ง และภาระของฝ่ายผู้อ่านก็ไม่ลดลง
ข้อที่สามคือไม่เผื่อขั้นตอนตรวจสอบไว้เป็นชั่วโมงงาน โดยเฉพาะเมื่อต้องจัดการภาษาไทยหรือภาษาเวียดนาม การตรวจสอบตัวเลขและข้อตัดสินใจจะเกิดขึ้นอย่างแน่นอน หากเขียนชั่วโมงงานส่วนนี้ลงในตารางกระบวนการตั้งแต่แรก ก็จะไม่เกิดความผิดหวังว่ายุ่งยากกว่าที่คิด แต่ถ้าไม่ได้เขียนไว้ ก็จะกลายเป็นการประเมินว่าไม่เห็นผลของการลดงาน
การสนับสนุนที่ TOMAS TECH ให้บริการได้
เราให้การสนับสนุนการผนวก Generative AI เข้ากับเวิร์กโฟลว์ของหน้างาน โดยอาศัยประสบการณ์จริงจากการส่งมอบระบบบริหารการผลิตและระบบบริหารพลังงานให้แก่ผู้ผลิตสัญชาติญี่ปุ่นในประเทศไทย สำหรับการออกแบบตั้งแต่การถอดเสียง การสรุป ไปจนถึงการสร้างรายงานอัตโนมัติ เรามักช่วยเหลือในรูปแบบต่อไปนี้
- สำรวจการประชุมทั้งหมด วัดชั่วโมงงานการจัดทำเอกสารจริง และคัดกรองการประชุมเป้าหมาย
- ตรวจสอบความแม่นยำในการประชุมที่มีภาษาญี่ปุ่น ภาษาอังกฤษ ภาษาไทย และภาษาเวียดนามปะปนกัน พร้อมกำหนดเส้นผ่าน
- ออกแบบหัวข้อที่จะดึงออกมาในการสรุป และสร้างรูปแบบที่เหมาะกับการประชุมในภาคการผลิต
- จัดเตรียมเทมเพลตแยกตามผู้รับ เช่น รายงานการประชุม รายงานการแก้ไขและป้องกัน และบทสรุปสำหรับสำนักงานใหญ่
- จัดทำรายชื่อรหัสสินค้า ชื่อเครื่องจักร และชื่อลูกค้าที่จะลงทะเบียนในพจนานุกรมศัพท์ พร้อมออกแบบระบบการปรับปรุงข้อมูล
- จัดระเบียบหัวข้อที่ต้องตรวจสอบเรื่องรูปแบบสัญญา การเก็บรักษาข้อมูล การนำไปฝึกสอนโมเดล และการโอนข้ามพรมแดน พร้อมนำเสนอประเด็นให้ฝ่ายกฎหมาย
- ตรวจสอบสภาพไมโครโฟนในห้องประชุมและคุณภาพการบันทึกเสียง พร้อมเสนอโครงสร้างอุปกรณ์ที่จำเป็น
- ออกแบบกระบวนการใช้งาน รวมถึงการเชื่อมต่อกับระบบบริหารการผลิตและระบบจัดการเอกสารเดิม
โดยเฉพาะประเด็นที่ว่าจะวางเอกสารที่สร้างขึ้นไว้ตรงไหนของระบบงานเดิมหรือระบบจัดการเอกสาร เป็นพื้นที่ที่การนำเครื่องมือเดี่ยว ๆ มาใช้ไม่ได้ครอบคลุม เราได้เห็นการไหลของเอกสารในโรงงานผ่านการส่งมอบระบบบริหารการผลิตมาโดยตลอด จึงร่วมออกแบบไปจนถึงปลายทางที่จัดเก็บผลลัพธ์ได้
คำถามที่พบบ่อย
การใช้ AI ถอดเสียงคืออะไร
หมายถึงชุดของความพยายามที่แปลงเสียงเป็นข้อความด้วย AI แล้วเชื่อมข้อความนั้นไปสู่ผลลัพธ์ที่ใช้งานได้จริงในธุรกิจ บทความนี้แนะนำให้ออกแบบเป็นเวิร์กโฟลว์ 3 ขั้น คือการถอดเสียง การสรุป และการสร้างรายงาน แทนที่จะมองการถอดเสียงเป็นเรื่องเดี่ยว ๆ เพราะถ้าทำให้เฉพาะการถอดเสียงเป็นอัตโนมัติ จากการประชุม 1 ชั่วโมงก็จะได้เพียงข้อความปริมาณที่ต้องใช้เวลาอ่านจบมากกว่า 10 นาที และงานสรุปข้อความนั้นก็ยังเหลือเป็นงานคนอยู่ดี ภาระงานจะเบาลงก็ต่อเมื่อไปถึงสภาพที่มองไม่กี่บรรทัดก็เข้าใจข้อตัดสินใจ เรื่องที่ยังไม่ได้ข้อสรุป และผู้รับผิดชอบกับกำหนดเวลา อนึ่ง ค่าเป้าหมายของผลการลดงาน ขอให้ตั้งหลังจากวัดเวลาการจัดทำเอกสารขององค์กรตนเองจริงเป็นเวลา 1 ถึง 2 สัปดาห์แล้ว แทนที่จะหยิบยืมอัตราการลดงานของบริษัทอื่น
ค่าใช้จ่ายของ AI ถอดเสียงเป็นอย่างไร
โครงสร้างราคาที่เปิดเผยแบ่งได้เป็นแบบคิดค่าบริการรายเดือนต่อผู้ใช้หนึ่งคน กับแบบคิดตามปริมาณการใช้ตามชั่วโมงเสียงที่ประมวลผล หากคาดการณ์จำนวนการประชุมได้ แบบรายเดือนจะจัดการง่ายกว่า แต่หากช่วงงานหนักและงานเบาต่างกันมาก แบบตามปริมาณการใช้จะเหมาะกว่า อย่างไรก็ตาม สิ่งที่มักถูกมองข้ามในการเปรียบเทียบค่าใช้จ่ายไม่ใช่ค่าบริการของเครื่องมือ แต่เป็นชั่วโมงงานของคนที่ต้องตรวจสอบผลลัพธ์ เมื่อต้องจัดการภาษาไทยหรือภาษาเวียดนาม ขั้นตอนตรวจสอบตัวเลขและข้อตัดสินใจจะเกิดขึ้นอย่างแน่นอน จึงขอให้แปลงเวลานี้เป็นค่าแรงต่อเดือน แล้วนำไปรวมกับค่าบริการเครื่องมือเพื่อเปรียบเทียบ นอกจากนี้ โดยทั่วไปแผนสำหรับองค์กรกับแผนสำหรับผู้ใช้รายบุคคลจัดการข้อมูลต่างกัน จึงต้องระวังไม่ให้ตัดสินใจโดยยึดราคาของแผนแบบไม่มีค่าใช้จ่ายเป็นเกณฑ์
ใช้ AI ถอดเสียงกับการประชุมภาษาไทยหรือภาษาเวียดนามได้หรือไม่
ใช้ได้ แต่อย่าตั้งสมมติฐานว่าจะได้ความแม่นยำเท่ากับภาษาอังกฤษหรือภาษาญี่ปุ่น ภาษาไทยมีวรรณยุกต์ 5 เสียง และไม่มีช่องว่างระหว่างคำจึงตัดคำได้ยาก อีกทั้งการเขียนตัวเลขยังขึ้นอยู่กับบริบท ส่วนภาษาเวียดนามมีวรรณยุกต์ 6 เสียง บวกกับความต่างของสำเนียงถิ่นระหว่างภาคเหนือกับภาคใต้ที่มาก และข้อจำกัดด้านปริมาณกับคุณภาพของข้อมูลฝึกสอนก็ยังถูกชี้เป็นโจทย์ในบทความวิชาการปี 2026 ในทางปฏิบัติ แม้จะใช้ได้เพียงพอสำหรับวัตถุประสงค์ในการตามความหมาย แต่การผนวกแนวทางให้คนตรวจสอบทุกรายการสำหรับตัวเลขอย่างจำนวน วันที่ ยอดเงิน อัตราของเสีย และสำหรับข้อตัดสินใจ ถือว่าปลอดภัยกว่า หากให้ไล่เรียงเฉพาะตัวเลขไว้เป็นหัวข้อแยกต่างหากในขั้นตอนการสรุป การตรวจสอบนี้จะรวมอยู่ที่เดียวและคุมชั่วโมงงานได้
เมื่อใช้ AI สรุปในงานธุรกิจ คนควรตรวจสอบถึงระดับใด
แทนที่จะอ่านซ้ำทั้งหมด การกำหนดจุดที่ต้องตรวจสอบไว้เป็นรูปแบบตายตัวจะเป็นแนวทางที่ใช้ได้จริงกว่า กล่าวโดยเจาะจงคือ กำหนดให้ตัวเลข ข้อตัดสินใจ และผู้รับผิดชอบกับกำหนดเวลา รวม 3 หัวข้อ เป็นเป้าหมายของการตรวจสอบ ส่วนที่เขียนเป็นเนื้อความอย่างภูมิหลังของประเด็นให้อ่านผ่านเท่านั้น หากใส่ 3 หัวข้อนี้ไว้ในรูปแบบผลลัพธ์ของบทสรุปตั้งแต่แรก การตรวจสอบก็จบได้เป็นรายหัวข้อ ในทางกลับกัน หากให้บทสรุปออกมาเป็นเรียงความชิ้นเดียว จุดที่ต้องตรวจสอบจะเปลี่ยนไปทุกครั้ง และสุดท้ายก็ต้องอ่านทั้งหมดอยู่ดี ขอให้เผื่อช่วงประมาณ 2 สัปดาห์แรกนับจากเริ่มใช้งานไว้เป็นช่วงที่นำผลการถอดเสียงต้นฉบับมาเทียบกัน เพื่อจับแนวโน้มของการดึงข้อมูลที่ตกหล่นและปรับคำสั่ง
ควรเริ่มลงมือกับ AI สร้างรายงานอัตโนมัติจากตรงไหน
ขอให้เริ่มลงมือหลังจากผลลัพธ์ของการสรุปนิ่งแล้ว ตามลำดับคือ 30 วันแรกนับจากเริ่มให้ใช้งานเฉพาะการถอดเสียงและการสรุป แล้วจึงเข้าสู่การสร้างเทมเพลตเมื่อรูปแบบของบทสรุปลงตัวแล้ว จะปลอดภัยกว่า เทมเพลตให้แยกสร้างตามผู้รับ เพราะบทสรุปสำหรับสำนักงานใหญ่ที่ญี่ปุ่น รายงานการประชุมสำหรับหน่วยงานในพื้นที่ และบันทึกสำหรับส่งมอบลูกค้า มีทั้งระดับความละเอียดและรูปแบบการเขียนที่ต่างกัน หากออกแบบให้รับผลลัพธ์ของการสรุปเป็นข้อมูลรายหัวข้อแทนที่จะเป็นเรียงความ ก็จะประกอบเอกสารสำหรับผู้รับหลายรายจากการประชุมครั้งเดียวได้ และถ้าแก้เทมเพลตก็สร้างของครั้งก่อน ๆ ขึ้นใหม่ทั้งชุดได้
ส่งไฟล์บันทึกเสียงการประชุมไปยังคลาวด์ในต่างประเทศได้โดยไม่มีปัญหาหรือไม่
มีประเด็นที่ต้องตรวจสอบอยู่ ในกฎหมายคุ้มครองข้อมูลส่วนบุคคลของไทย กฎลำดับรองที่เกี่ยวกับการโอนข้อมูลข้ามพรมแดนมีผลใช้บังคับตั้งแต่วันที่ 24 มีนาคม 2024 และตามคำอธิบายของสำนักงานกฎหมาย เงื่อนไขของการโอนข้อมูลส่วนบุคคลไปต่างประเทศได้ถูกทำให้ชัดเจนเป็นรูปธรรม เนื่องจากเสียงการประชุมมีข้อมูลส่วนบุคคลอย่างชื่อและหน่วยงานที่สังกัดของผู้เข้าร่วมอยู่ด้วย การใช้บริการที่ประมวลผลบนเซิร์ฟเวอร์ในต่างประเทศจึงอาจเข้าข่ายการโอนข้อมูลส่วนบุคคลข้ามพรมแดน หากเข้าข่าย ก็ต้องทำให้ครบตามเงื่อนไขที่กฎเกณฑ์กำหนด เช่น การขอความยินยอมหรือการใช้ข้อสัญญามาตรฐาน การจะเข้าข่ายหรือไม่ในทางปฏิบัติขึ้นอยู่กับข้อมูลที่จัดการและรูปแบบของสัญญา จึงขอให้ตรวจสอบกับฝ่ายกฎหมายหรือผู้เชี่ยวชาญในพื้นที่ก่อนนำระบบมาใช้ ความเสี่ยงในทางปฏิบัติอยู่ที่หน้างานเริ่มใช้เครื่องมือด้วยบัญชีส่วนตัวโดยยังไม่ผ่านการตรวจสอบนี้
สรุป
เมื่อพิจารณาการใช้ AI ถอดเสียง จุดโฟกัสของการเปรียบเทียบมักไปรวมอยู่ที่ความแม่นยำของการรู้จำเสียง แต่สิ่งที่ทำให้ภาระงานเบาลงจริงคือการออกแบบการสรุปและการสร้างรายงานที่อยู่ถัดจากการถอดเสียง เมื่อถอดเสียงการประชุม 1 ชั่วโมงออกมา จะได้ข้อความปริมาณที่ต้องใช้เวลาอ่านจบมากกว่า 10 นาที แต่นั่นเป็นเพียงรูปแบบที่อ่านได้ ไม่ใช่รูปแบบที่ใช้งานได้ จำเป็นต้องออกแบบให้ครอบคลุมกระบวนการที่พาไปถึงสภาพที่มองไม่กี่บรรทัดก็เข้าใจข้อตัดสินใจ เรื่องที่ยังไม่ได้ข้อสรุป และผู้รับผิดชอบกับกำหนดเวลา
สิ่งที่มักถูกมองข้ามที่ฐานในประเทศไทยคือความต่างของความแม่นยำตามภาษา เครื่องมือทั่วไปอย่าง Notta อยู่ในระดับใช้งานจริงได้แล้วสำหรับภาษาอังกฤษและภาษาญี่ปุ่น แต่ภาษาไทยมีจุดยากเชิงโครงสร้างทั้งวรรณยุกต์ 5 เสียง การไม่เว้นวรรคระหว่างคำ และความคลุมเครือของการเขียนตัวเลข อีกทั้งผลงานวิจัยเรื่องโมเดลรู้จำเสียงแบบเรียลไทม์ที่ใช้งานได้จริงเพิ่งเผยแพร่ในเดือนมกราคม 2026 ส่วนภาษาเวียดนามนั้น นอกจากวรรณยุกต์ 6 เสียงและความต่างของสำเนียงถิ่นแล้ว ข้อจำกัดด้านปริมาณและคุณภาพของข้อมูลฝึกสอนก็ยังถูกยกเป็นโจทย์ในบทความวิชาการปี 2026 หากยกเครื่องมือที่ประเมินไว้ที่สำนักงานใหญ่ในญี่ปุ่นมาใช้ตรง ๆ ก็อาจได้ข้อสรุปว่าใช้กับการประชุมหน้างานไม่ได้ ความเข้าใจที่ถูกต้องคือ ไม่ใช่ว่าใช้ไม่ได้ แต่ต้องเผื่อขั้นตอนที่คนตรวจสอบตัวเลขและข้อตัดสินใจไว้เป็นชั่วโมงงาน
อีกประเด็นหนึ่งคือกฎหมายและความลับ ใน PDPA ของไทย กฎลำดับรองเรื่องการโอนข้อมูลข้ามพรมแดนมีผลใช้บังคับตั้งแต่วันที่ 24 มีนาคม 2024 และการส่งเสียงการประชุมไปยังบริการที่ประมวลผลบนเซิร์ฟเวอร์ในต่างประเทศอาจเข้าข่ายการโอนข้อมูลส่วนบุคคลข้ามพรมแดน พร้อมกันนั้นยังต้องตรวจสอบเรื่องในสัญญา ทั้งการนำไปฝึกสอนโมเดล ระยะเวลาเก็บรักษาข้อมูล ประเทศที่ประมวลผล และการจ้างช่วงต่อ สิ่งเหล่านี้เป็นหัวข้อที่ต้องตรวจสอบไปพร้อมกับการเลือกเครื่องมือ ไม่ใช่หลังจากนำระบบมาใช้แล้ว
สำหรับวิธีดำเนินการ รูปแบบที่จัดการได้ง่ายคือการแบ่งเป็นช่วง โดยใช้เวลา 1 ถึง 2 สัปดาห์สำรวจการประชุมทั้งหมดและวัดเวลาการจัดทำเอกสารจริง คัดกรองเป้าหมายให้เหลือไม่เกิน 3 ประเภท แล้ว 30 วันแรกนับจากเริ่มให้ทำถึงการถอดเสียงและการสรุป จากนั้นวันที่ 30 ถึงวันที่ 90 จึงประกอบเทมเพลตของการสร้างรายงาน การวัดผลของการลดงานขาดค่าที่วัดไว้จริงก่อนเริ่มใช้ไม่ได้ หากข้ามจุดนี้ไป ภายหลังก็จะไม่มีวัตถุดิบสำหรับพูดถึงผลลัพธ์
การตัดสินใจว่าควรเลือกการประชุมใดของฐานตนเองเป็นเป้าหมาย หรือควรวางขั้นตอนตรวจสอบไว้มากน้อยเพียงใดในการประชุมที่มีภาษาไทยและภาษาเวียดนามปะปนกัน เป็นส่วนที่ตัดสินไม่ได้หากไม่ได้เห็นองค์ประกอบของการประชุมจริงและขั้นตอนการจัดทำเอกสารในปัจจุบัน เรารับปรึกษาแม้เพียงในขั้นพิจารณา เช่น วิธีดำเนินการสำรวจการประชุม หรือวิธีสร้างรูปแบบของบทสรุป จึงอยากขอให้เล่าสภาพปัจจุบันให้เราฟังก่อน ปรึกษาได้ที่หน้าติดต่อสอบถาม
แหล่งอ้างอิง
- บทความเปรียบเทียบเครื่องมือสร้างรายงานการประชุมอัตโนมัติด้วย AI จากสื่อเปรียบเทียบซอฟต์แวร์ IT Trend — การเปรียบเทียบผลิตภัณฑ์โดยสื่อเปรียบเทียบ ระบุผลของการนำมาใช้ว่าช่วยลดชั่วโมงงานในการจัดทำรายงานการประชุม
- คู่มือการใช้ AI ถอดเสียงในการประชุมภายในองค์กร ว่าด้วยความแม่นยำ ความลับ และการจัดทำรายงานการประชุม โดย Uravation — บทความอธิบายโดยบริษัทผู้ประกอบการ จัดระเบียบประเด็นความแม่นยำและข้อมูลความลับในการใช้ถอดเสียงกับการประชุมภายในองค์กร
- 8 Best AI Transcript Summarizers Compared 2026 – AssemblyAI — บทความบล็อกที่เขียนโดยผู้ให้บริการ API รู้จำเสียงเอง เปรียบเทียบผลิตภัณฑ์ที่ครอบคลุมตั้งแต่การถอดเสียงจนถึงการสรุป
- Typhoon ASR Real-time FastConformer-Transducer for Thai Automatic Speech Recognition – arXiv — งานวิจัยเชิงวิชาการที่เผยแพร่ในเดือนมกราคม 2026 เสนอโมเดลขนาดเบาสำหรับการรู้จำเสียงภาษาไทยแบบเรียลไทม์
- Vietnamese Automatic Speech Recognition A Revisit – ACL Anthology — บทความวิชาการปี 2026 จัดระเบียบโจทย์ของการรู้จำเสียงภาษาเวียดนาม เช่น ข้อจำกัดด้านปริมาณและคุณภาพของข้อมูลฝึกสอน
- คำอธิบายประกาศเรื่องหลักเกณฑ์การโอนข้อมูลข้ามพรมแดนตามกฎหมายคุ้มครองข้อมูลส่วนบุคคลของไทย โดยสำนักงานกฎหมาย TMI Associates — คำอธิบายโดยสำนักงานกฎหมาย เนื้อหาของกฎลำดับรองเรื่องการโอนข้ามพรมแดนที่มีผลใช้บังคับตั้งแต่วันที่ 24 มีนาคม 2024


