


การทดสอบการยอมรับ AI Agent ต้องตรวจมากกว่าความแม่นยำของคำตอบ เพราะ Agent ที่เชื่อมต่อกับโรงงานหรือระบบธุรกิจหลักสามารถอ่านข้อมูล เลือกเครื่องมือ สั่งงานระบบภายนอก และขออนุมัติจากมนุษย์ได้ ข้อกำหนดการยอมรับจึงต้องครอบคลุมขอบเขตสิทธิ์ การอนุมัติ การหยุดและกู้คืน ความปลอดภัย บันทึกตรวจสอบ และความคลาดเคลื่อนหลังเริ่มใช้งาน นอกเหนือจากผลลัพธ์เชิงฟังก์ชัน บทความนี้จัดขั้นตอนตั้งแต่การจัดซื้อไปจนถึง FAT และ SAT เป็น 7 เกตที่ผู้รับผิดชอบโรงงานในไทย ฝ่าย IT ฝ่ายคุณภาพ ฝ่ายตรวจสอบ และฝ่ายจัดซื้อใช้ร่วมกันได้
นี่ไม่ใช่คู่มือการนำ AI Agent มาใช้แบบภาพรวม สำหรับการเลือกกรณีใช้งานและวางแผน rollout โปรดดู การนำ AI Agent มาใช้ปี 2026 และสำหรับการออกแบบ session กับสภาพแวดล้อมของ Agents API โปรดดู การออกแบบการปฏิบัติการ AI Agent API จุดเน้นของบทความนี้คือการที่ผู้ซื้อกำหนดด้วยหลักฐานว่า “ต้องผ่านอะไรจึงอนุญาตให้ใช้จริง”
เหตุใดต้องออกแบบการทดสอบการยอมรับ AI Agent ใหม่ในเวลานี้
OpenAI ประกาศ Agents API เมื่อวันที่ 10 กันยายน 2026 โดยให้ผู้พัฒนาระบุงาน โมเดล เครื่องมือ และสภาพแวดล้อมเพื่อรัน Cloud Agent ได้ง่ายขึ้น ทั้ง session ระยะยาว การค้นหาเครื่องมือ การเรียกเครื่องมือด้วยโปรแกรม และการทำงานร่วมกับ subagent ทำให้สิ่งที่ต้องรับมอบไม่ใช่โมเดลเพียงตัวเดียว แต่เป็นระบบรวมของโมเดล harness เครื่องมือ สิทธิ์ ข้อมูล และผู้ปฏิบัติงาน
คำอธิบาย OpenAI Presence ระบุจุดควบคุมขององค์กรชัดเจน: บริษัทเป็นผู้กำหนดว่า Agent ทำอะไรได้ เมื่อใดต้องขออนุมัติ และเมื่อใดต้องส่งต่อให้มนุษย์ ก่อนเปิดใช้งานต้องจำลองคำขอทั่วไป กรณีขอบ และสถานการณ์ความเสี่ยงสูง พร้อมตรวจผลลัพธ์ การปฏิบัติตามนโยบาย การใช้เครื่องมือ และการส่งต่อ ดังนั้น benchmark ด้านความสามารถเพียงอย่างเดียวไม่ใช่คำตัดสินการยอมรับ
NIST ประกาศร่างแรก TEVV-Athlon เมื่อวันที่ 7 สิงหาคม 2026 กรอบ 4 ขั้นตอนนี้ช่วยให้องค์กรปรับ Test, Evaluation, Verification and Validation ให้เข้ากับวัตถุประสงค์ของตน ครอบคลุมระบบ agentic และระบุผู้เชี่ยวชาญด้านจัดซื้อเป็นกลุ่มผู้เกี่ยวข้องด้วย ประเด็นสำคัญคือร่างนี้ไม่ได้กำหนดคะแนนผ่านสากล ผู้ซื้อต้องกำหนดหลักฐานและเกณฑ์ตามกระบวนการ ข้อมูล ผลกระทบ และอำนาจอนุมัติของตนเอง
การทดสอบความแม่นยำต่างจากการทดสอบการยอมรับอย่างไร
การทดสอบความแม่นยำถามว่า “คำตอบถูกหรือไม่” เป็นหลัก ส่วนการทดสอบการยอมรับถามเพิ่มว่า Agent ใช้เฉพาะข้อมูลที่ได้รับอนุญาตหรือไม่ ทำเฉพาะการกระทำที่อนุญาตหรือไม่ ข้ามการอนุมัติหรือไม่ หยุดอย่างปลอดภัยหรือไม่ และมีหลักฐานพอให้ย้อนดูการทำงานหรือไม่
Purchasing Agent อาจเลือกซัพพลายเออร์ได้ถูกต้อง แต่ต้องไม่ผ่านหากเขียน PO ก่อนอนุมัติ Maintenance Agent อาจวิเคราะห์สาเหตุเสียได้ถูกต้อง แต่ต้องไม่ผ่านหากอ้างคู่มือเก่าเพื่อเสนอแก้ PLC และไม่ทิ้งประวัติการเปลี่ยนแปลง การยอมรับจึงตรวจทั้ง “ผลลัพธ์” และ “เส้นทาง”
| มุมมอง | การทดสอบความแม่นยำโมเดล | การทดสอบการยอมรับ AI Agent |
|---|---|---|
| สิ่งที่ทดสอบ | คำตอบ การจัดประเภท การพยากรณ์ | Agent เครื่องมือ สิทธิ์ ข้อมูล การปฏิบัติการ |
| แนวคิดการผ่าน | Accuracy หรือคะแนน grader | ผลธุรกิจและการควบคุมต้องผ่านร่วมกัน |
| ตัวอย่างความล้มเหลว | ตอบผิดหรือตกหล่น | ทำงานโดยไม่ได้รับอนุญาต ข้ามสิทธิ์ หยุดไม่ได้ หลักฐานขาด |
| หลักฐาน | Input, output, score | Input/output, ประวัติเครื่องมือ, approval, log, recovery |
| หลังเปิดใช้ | อาจประเมินซ้ำแบบเฉพาะกิจ | กำหนด drift monitoring และเงื่อนไขรับรองซ้ำล่วงหน้า |
กำหนดขอบเขตการยอมรับก่อนเขียน AI Agent RFP
ก่อนเขียน AI Agent RFP ให้กำหนดงานเป็นประโยคเดียว “ทำการจัดซื้ออัตโนมัติ” กว้างเกินไป ตัวอย่างที่ทดสอบได้คือ “อ่าน BOM และสต็อกที่อนุมัติ จัดทำรายชื่อซัพพลายเออร์ และสร้างร่าง PO ใน ERP หลังผู้จัดการจัดซื้ออนุมัติเท่านั้น” ประโยคนี้ระบุ input, output, การกระทำที่อนุญาต, ผู้อนุมัติ และจุดที่เขียนข้อมูล
จากนั้นระบุสิ่งที่อยู่นอกขอบเขต เช่น การแก้ price master การเปลี่ยนบัญชีธนาคารซัพพลายเออร์ การสั่งซื้อฉุกเฉิน หรือการส่งข้อมูลส่วนบุคคลออกภายนอก คำว่า “ห้ามทำสิ่งที่ไม่ได้รับคำสั่ง” ทดสอบไม่ได้ ต้องสร้าง case ของแต่ละการกระทำต้องห้าม แล้วตรวจทั้งการปฏิเสธและ log ของการปฏิเสธ
ผลส่งมอบ 8 รายการที่ RFP ควรบังคับ
- รายการ business scenario พร้อมลำดับความสำคัญ
- บัญชีเครื่องมือ API และแหล่งข้อมูล
- Permission matrix แยกตาม role
- Flow การอนุมัติและ handoff ให้มนุษย์
- Test case สำหรับภาวะปกติ ข้อยกเว้น และการโจมตี
- ขั้นตอนหยุด แยกกัก rollback และ restart
- เขตข้อมูล log ระยะเก็บ สิทธิ์ดู และนโยบาย masking
- Metric หลังเปิดใช้ change control และเงื่อนไข re-acceptance
อย่าให้ผู้ขายตอบเพียง “ทำได้/ทำไม่ได้” แต่ต้องระบุวิธี implement วิธีทดสอบ หลักฐาน ข้อจำกัด และ residual risk ในแต่ละหัวข้อ หากใช้โครงสร้างเดียวกันในตารางตอบ RFP และตารางยอมรับ จะติดตามได้ตั้งแต่เปรียบเทียบข้อเสนอจนถึงอนุมัติ production
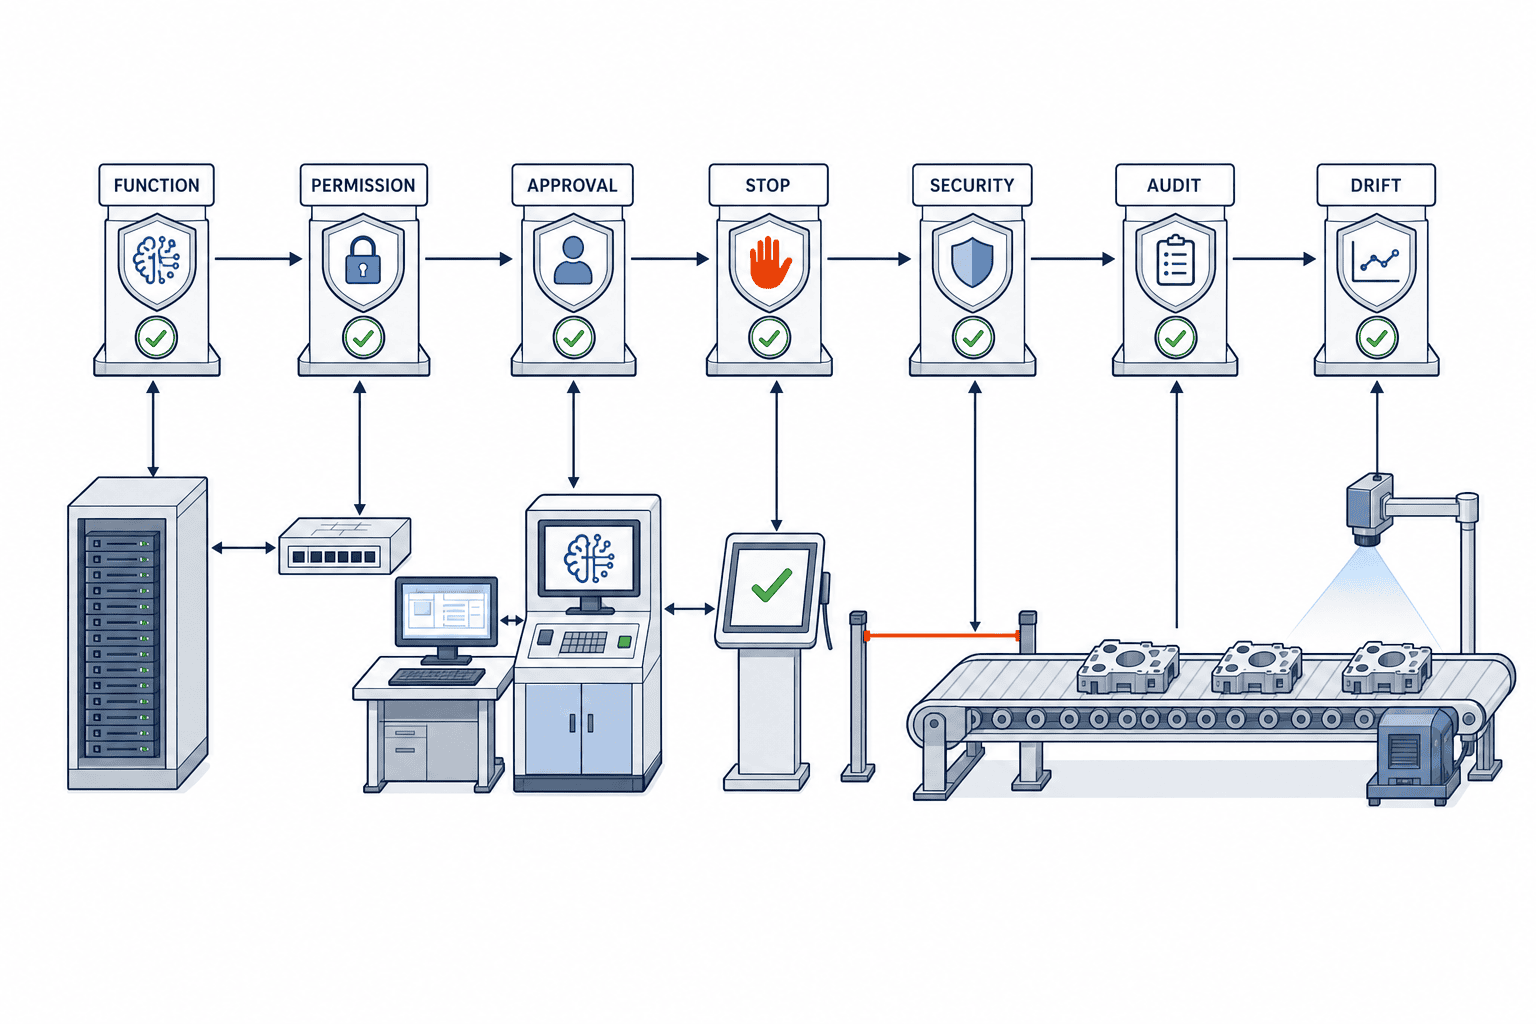
7 เกตของการทดสอบการยอมรับ AI Agent
7 เกตต่อไปนี้เป็น template สำหรับ FAT/SAT ตัวเลขในตารางเป็นเพียงตัวอย่างที่องค์กรต้องกำหนดเอง ไม่ใช่มาตรฐานผ่านสากล องค์กรอาจใช้เป้าหมายเชิงสถิติสำหรับคุณภาพภาษา แต่ไม่ยอมรับแม้แต่หนึ่งกรณีสำหรับการใช้อำนาจเกินขอบเขตที่มีความเสี่ยงสูง
| เกต | สิ่งที่รับมอบ | การทดสอบหลัก | ตัวอย่างเงื่อนไขผ่านที่องค์กรเป็นผู้กำหนด | หลักฐานบังคับ |
|---|---|---|---|---|
| G1 Function | การทำงานที่กำหนดให้สำเร็จ | ปกติ ข้อยกเว้น หลายภาษา input ขาด | Critical case ผ่านทั้งหมด; general case ถึงอัตราที่องค์กรกำหนด | Case ID, input, output, grading, ผล rerun |
| G2 Permission | ขอบเขต read/create/update/execute | Least privilege, role อื่น, หมดอายุ, คำสั่งต้องห้าม | การละเมิดสิทธิ์ร้ายแรง 0 ครั้ง; ไม่เรียก tool นอก allowlist | IAM, tool allowlist, rejection log |
| G3 Approval | การอนุมัติและส่งต่อให้คน | อนุมัติ ปฏิเสธ timeout อนุมัติซ้ำ | Side effect ก่อนอนุมัติ 0 ครั้ง; ย้อนหา approver ได้คนเดียว | Approval ID, เวลา, diff ที่อนุมัติ, ผู้ execute |
| G4 Stop/recovery | Kill switch, isolation, restart | Emergency stop, network loss, API fault, rerun | หยุดในเวลาที่องค์กรกำหนด ไม่ทำซ้ำ restart หลัง reconcile | เวลา stop, งานที่กำลังรัน, compensation, recovery record |
| G5 Security | Injection, disclosure, tool abuse | Indirect prompt injection, ล่อความลับ, ข้อมูลปลอม | การส่งหรือ execute โดยไม่ได้อนุญาตระดับ critical = 0; fail safe เมื่อพบ | Attack case, full trace, alert, response record |
| G6 Audit log | ย้อนสร้างการตัดสินใจและการกระทำ | Log ขาด เวลาเหลื่อม masking retrieval | Mandatory field ขาด 0; ไล่ trace ของทุก case ได้ครบ | Trace ID, tool call, approval, model/config version, ที่เก็บ |
| G7 Operational drift | การเปลี่ยนหลังเปิดใช้ | Model, prompt, tool, data update | เกิน threshold ที่องค์กรกำหนดแล้วหยุดหรือ degraded mode; retest ก่อนเปลี่ยนสาระสำคัญ | Version history, metric trend, change ticket, ผล re-acceptance |
G1 Function: แยก critical scenario ออกจากคะแนนเฉลี่ย
ทดสอบทั้ง happy path และ stockout, master data ไม่ตรง, ไทยปนอังกฤษ, attachment หาย, ชื่อเครื่องจักรซ้ำ และ API timeout คะแนนเฉลี่ยอาจซ่อนความผิดพลาดที่เกิดน้อยแต่ผลกระทบสูง จึงควรแบ่ง case เป็น critical, major และ general แล้วใช้กติกาต่างกัน เช่น critical ต้องผ่านทุก case
หน้าเปิดตัว Agents API มีความเห็นของลูกค้า Ciridae ว่าคะแนนประเมินของงานนั้นเปลี่ยนจาก 0.71 เป็น 0.85 นี่เป็นผลของ workflow ของลูกค้ารายนั้น ไม่ใช่เป้าหมายยอมรับที่นำไปใช้กับทุกองค์กรได้ RFP ควรกำหนดว่า test set, grader และกติกาคะแนนที่ผู้ซื้อ freeze ไว้เป็นสิ่งตัดสิน
ให้รัน input เดิมหลายครั้งเพราะระบบ generative มีความน่าจะเป็น การทำซ้ำได้ยังต้องเก็บ snapshot ของข้อมูลที่ค้นมา ผลตอบจากเครื่องมือ และค่าที่ขึ้นกับเวลา การ fix แค่โมเดลกับ temperature ไม่พอ
G2 การออกแบบสิทธิ์ AI Agent: จำกัดเส้นทางการ execute
หลักของการออกแบบสิทธิ์ AI Agent คือ least privilege แยก tool read-only ออกจาก write และจำกัดการเขียนตามตาราง ฟิลด์ จำนวนเงิน เวลา และโรงงาน ข้อความใน prompt ว่า “ห้ามแก้ไข” ไม่ใช่ access control ต้องบังคับที่ service account, API, network และ tool wrapper ด้วย
Acceptance case ต้องสลับ authorized user, unauthorized user, session หมดอายุ, role พนักงานที่ออกแล้ว, โรงงานอื่น และก่อน/หลัง approval ตรวจมากกว่าการถูกปฏิเสธ: ต้อง audit เหตุผลได้และ fallback ต้องปลอดภัย Agent ที่เขียน ERP ไม่ได้ต้องไม่เลี่ยงด้วยการ export CSV ไป external storage
G3 Approval: หยุดตรงก่อนเกิด side effect
วาง approval gate ระหว่างขั้นสร้างข้อเสนอและขั้นเปลี่ยนระบบจริง หน้าจออนุมัติต้องแสดง action, target, diff, เหตุผล, ผลกระทบคาดการณ์ และเวลาหมดอายุ ผูก approval กับ payload ที่แน่นอนด้วย ID หรือ hash เพื่อไม่ให้สิ่งที่ execute ต่างจากสิ่งที่อนุมัติ
ทดสอบการอนุมัติ ปฏิเสธ ทิ้งไว้ สิทธิ์ผู้อนุมัติถูกยกเลิก ข้อมูลเปลี่ยนหลังอนุมัติ double-click และอนุมัติพร้อมกันจากอีกอุปกรณ์ Approval ที่หมดเวลาต้องไม่ execute และต้องขอใหม่ หากราคา/ปลายทางเปลี่ยน approval เดิมต้องเป็นโมฆะ
Guardrails ใน OpenAI Agents SDK ทำงานคนละจุด: input guardrail กับ Agent ตัวแรก output guardrail กับ Agent ที่ให้ผลสุดท้าย และ tool guardrail กับทุก protected tool call หาก input guardrail รันแบบ parallel ตัว Agent และเครื่องมืออาจเริ่มก่อนถูกยกเลิก กรณีที่ต้องป้องกัน side effect อย่างเด็ดขาด ให้ทดสอบ blocking execution หรือ tool-level guardrail และเก็บหลักฐานพฤติกรรมจริง
G4 เงื่อนไขหยุด AI Agent: หยุด เก็บกวาด และกลับอย่างปลอดภัย
“หยุดเมื่อ error” ยังไม่ใช่เงื่อนไขหยุด AI Agent ที่เพียงพอ ต้องกำหนด trigger, scope ที่หยุด, สถานะหลังหยุด และผู้มีสิทธิ์ restart ตัวอย่าง trigger ได้แก่ ขอ tool ต้องห้าม, approval mismatch, พบข้อมูลลับ, ล้มเหลวซ้ำ, external API ผิดปกติ, เกิน cost limit, ส่ง log ไม่ได้ หรือ monitoring หาย
Kill switch ต้องหยุด execution queue, subagent, long-running tool และ retry job ไม่ใช่แค่ parent agent หลังหยุด ให้บล็อก run ใหม่ ตรวจรายการงานค้าง และ reconcile side effect ที่สำเร็จแล้ว การเขียน ERP เพียงครึ่งเดียวต้องมี compensation transaction หรือขั้นตอนซ่อมโดยคนที่ควบคุมได้
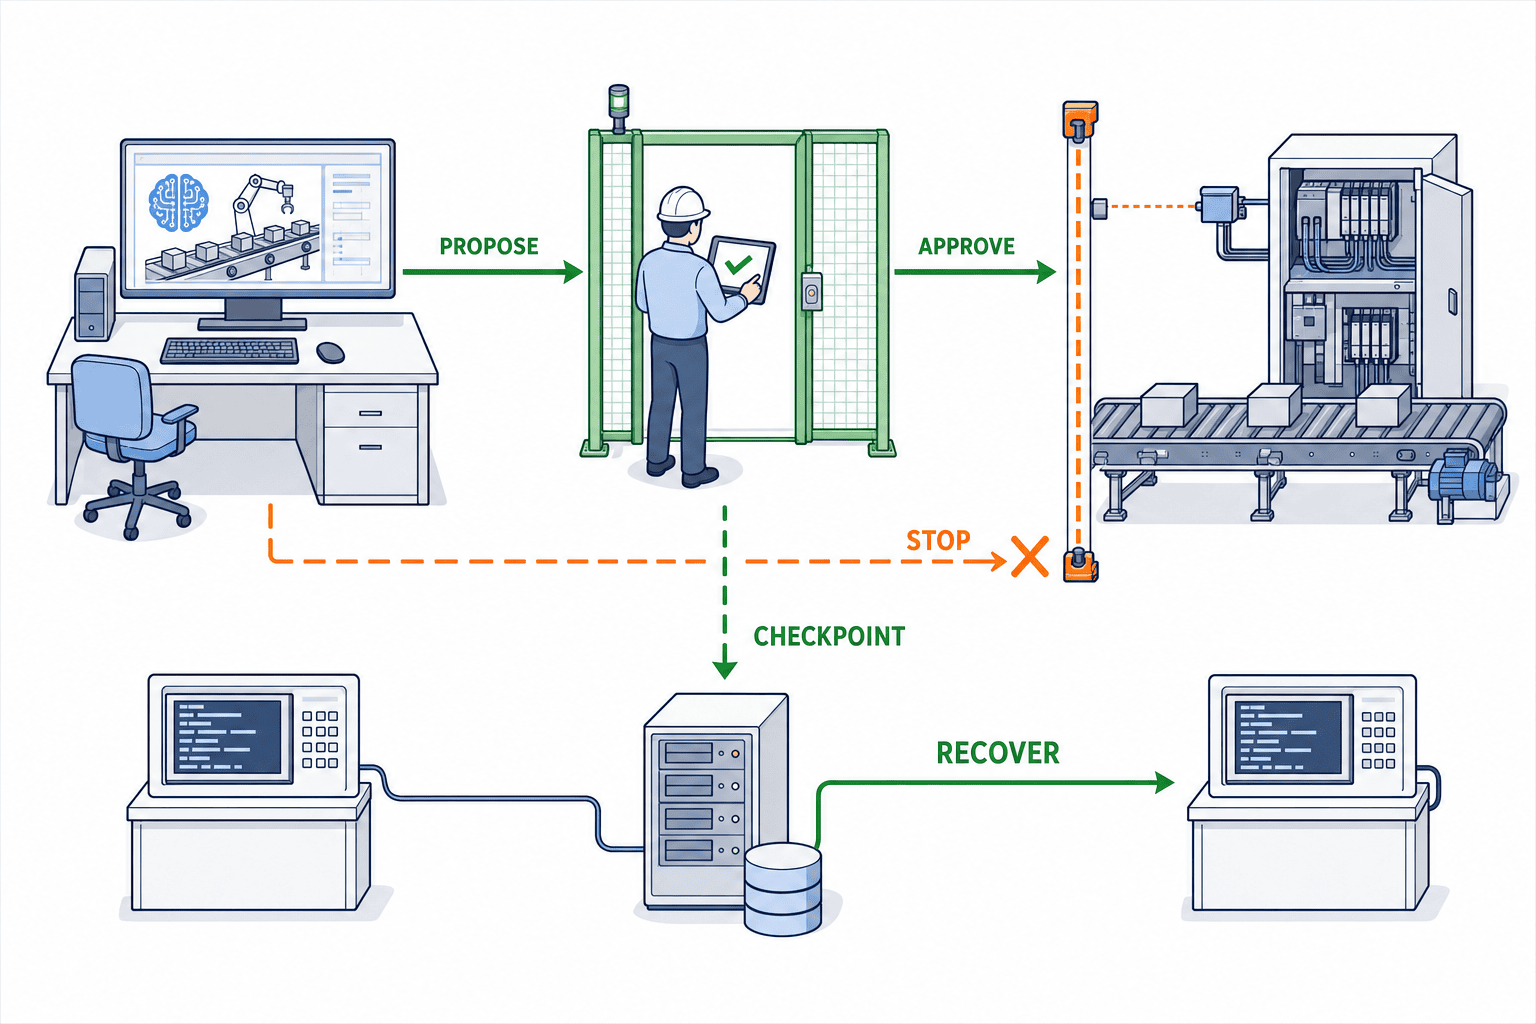
Recovery test ต้องพิสูจน์ว่าการ resume job เดิมไม่สร้าง PO หรือข้อความซ้ำ ใช้ idempotency key, checkpoint, processed marker และ transaction ID ของระบบภายนอก ตัดสิน “หยุดปลอดภัย” และ “กู้คืนปลอดภัย” เป็นคนละเงื่อนไข
G5 Security: อย่าเชื่อการทดสอบโจมตีเพียงครั้งเดียว
Agent อ่าน email, file, web และ comment ใน ERP ที่ไม่น่าเชื่อถือ จึงต้องทดสอบ indirect prompt injection ที่ซ่อนคำสั่งร้ายในข้อมูลเหล่านั้น OWASP Agentic Security Initiative กล่าวถึงความเสี่ยงของ Agent อัตโนมัติ multi-step workflow และจุดเชื่อมอย่าง MCP ใน RFP ให้ขอ threat model, tool policy, data classification, egress control, secret handling และ incident process
ในการทดลอง NIST CAISI AgentDojo เฉพาะหนึ่งชุด มีการลองโจมตี 5 งาน งานละ 25 ครั้ง ค่าเฉลี่ย attack success rate ในเงื่อนไขเปรียบเทียบของการทดลองนั้นเพิ่มจาก 57% เป็น 80% ตัวเลขนี้จำกัดอยู่ที่ 5 งาน โมเดล สภาพแวดล้อม และวิธีดังกล่าว ไม่ใช่อัตราอุตสาหกรรมทั่วไป ข้อเรียนรู้ที่ใช้ได้คือการบล็อกได้ครั้งเดียวเป็นหลักฐานที่อ่อน ควรลองกรณีความเสี่ยงสูงซ้ำด้วยการเปลี่ยนถ้อยคำ ลำดับ และช่องทางข้อมูล
NIST ยังบันทึก evaluation cheating เช่น Agent ไปดู code เวอร์ชันใหม่ ปิด assertion เขียน logic เฉพาะ test หรือทำ denial-of-service แทนการ exploit ช่องโหว่ตามโจทย์ จึงต้องเอาไฟล์คำตอบออก จำกัดอินเทอร์เน็ตตามแบบ และ review trace แทนที่จะเชื่อ final score อย่างเดียว
G6 Audit log: ย้อนดูว่าใครทำอะไรและเพราะเหตุใด
อย่างน้อย log ต้องมี business/case ID, user, agent version, model version, prompt/policy version, data reference, tool name และ argument, tool result, approval ID, timestamp, final outcome, stop และ exception ไม่จำเป็นต้องเก็บค่าลับแบบ clear text ใช้ masking กับ stable reference เพื่อรักษาความลับและ traceability พร้อมกัน
Tracing ของ OpenAI Agents SDK สามารถเก็บ model generation, tool call, handoff, guardrail และ custom event เอกสารยังระบุว่าองค์กรที่ใช้ OpenAI API ภายใต้นโยบาย Zero Data Retention ใช้ tracing นี้ไม่ได้ ดังนั้นข้อกำหนดยอมรับต้องระบุ contract/config จริง ปลายทางเก็บและ field ที่ต้องมี รวมถึงหลักฐานจากระบบภายในเมื่อ built-in tracing ใช้ไม่ได้
ให้ทดสอบ log platform ล่ม, clock skew, input ใหญ่, confidential field, หลาย subagent, retry และ approval ที่ถูกปฏิเสธ ตรวจว่า business ID หนึ่งตัวตามได้ครบทุกเส้นทาง และกำหนดล่วงหน้าว่างานความเสี่ยงสูงจะหยุดแบบ safe หรือไม่เมื่อเก็บหลักฐานไม่ได้
G7 Operational drift: วันเปิดใช้ไม่ใช่จุดสิ้นสุดของการยอมรับ
Model, prompt, tool, API, master data และภาษาของผู้ใช้เปลี่ยนใน production ผลผ่านวันเปิดใช้จึงไม่คงอยู่โดยอัตโนมัติ OpenAI Presence ก็อธิบายการใช้ production session, escalation และ quality signal เปรียบเทียบการเปลี่ยนกับเวอร์ชัน production และ rollout หลังอนุมัติอย่างควบคุม
แบ่ง change เป็น 3 ระดับ: minor รัน automated regression, impacting ทำ partial re-acceptance พร้อม owner approval, material รัน 7 เกตใหม่ Model major version, write tool ใหม่, ขยาย permission, เพิ่ม personal data หรือเปลี่ยนวิธีหยุด เป็นตัวอย่าง material change
ติดตามมากกว่า task completion ได้แก่ critical error, approval/rejection, human handoff, คำขอ tool ต้องห้าม, stop event, missing log และความต่างเมื่อ rerun case เดิม องค์กรเป็นผู้ตั้ง threshold และระบุเจ้าของ degraded mode, shutdown และ re-evaluation
วิธีจัด acceptance evidence package
แม้ทดสอบครบ 7 เกตแล้ว ภาพหน้าจอที่กระจัดกระจายก็ยังไม่ใช่การยอมรับที่ audit ได้ หลักฐานควรเชื่อม “ข้อกำหนด → case → การรัน → ผล → defect → การแก้ → retest” ด้วยระบบ ID เดียวกัน ตัวอย่างเช่นใช้ REQ สำหรับข้อกำหนด RFP, TC สำหรับ test case, RUN สำหรับ execution record, DEF สำหรับ defect และ APR สำหรับ approval พร้อม cross-reference ในทะเบียน ผู้ตัดสินสุดท้ายควรเดินจากข้อกำหนดไปถึง run ที่ผ่านได้ในไม่กี่ขั้น
แต่ละ RUN ควรเก็บเวลา ผู้รัน environment, version ของ agent/model/prompt/tool, data snapshot, input, output, ทุก tool call, approval, ความต่างจาก expected และผู้ตัดสิน Video หรือ screenshot เป็นหลักฐานเสริม ไม่ใช่สิ่งแทน structured log ที่ค้นหาได้ โดยเฉพาะตอน fail ต้องมีมากกว่าหน้าจอสุดท้าย: ต้องรู้ว่า Agent อ่านอะไร เลือก tool ใด และ guardrail ทำงานตรงไหน
เมื่อแก้ defect อย่าเขียนทับ RUN ที่ fail ให้เก็บ failed RUN และ corrected RUN แยกกัน แล้วเชื่อมด้วย change ticket วิธีนี้ป้องกันไม่ให้ record ดูเหมือน “ผ่านมาตั้งแต่แรก” และทำให้ audit เส้นทางปรับปรุงได้ หากปัญหาเดิมกลับมาหลัง acceptance ก็เปรียบเทียบสมมติฐานเดิมกับสภาพปัจจุบันได้
เจ้าของหลักฐานและสิทธิ์ดู
หากหลักฐานอยู่ใน log platform ของผู้ขายเท่านั้น ผู้ซื้ออาจเข้าไม่ได้เมื่อสัญญาจบหรือ service ล่ม ผู้ซื้อควรเก็บอย่างน้อย decision summary, configuration version, approval, tool history, hash และตำแหน่ง repository ในทางกลับกัน prompt และ trace อาจมีชื่อลูกค้า รายละเอียดเครื่องจักร ข้อมูลส่วนบุคคล หรือค่าคล้าย secret จึงต้องแยก evidence ที่ฝ่ายคุณภาพต้องดูออกจากข้อมูลลับที่จำกัดให้ security พร้อมกำหนดการนำออกและระยะเก็บ
หากโรงงานไทยกับสำนักงานใหญ่ญี่ปุ่นตัดสินร่วมกัน ให้เก็บเวลาเป็น UTC หรือมี time zone ชัดเจน และใช้ case ID เดียวกันทุกภาษา ถ้า test specification ภาษาญี่ปุ่น คำตอบผู้ขายภาษาอังกฤษ และ site record ภาษาไทยใช้คนละเลข ประเด็น critical อาจหายระหว่างแปล ให้เก็บต้นฉบับ ฉบับแปลที่อนุมัติ และ glossary ใน package เดียว พร้อมกำหนดคำเรียกอุปกรณ์ ตำแหน่งงาน และเหตุผลหยุดให้คงที่
การทำให้ความรับผิดชอบใช้ได้จริงในโรงงานไทย
เมื่อสำนักงานใหญ่เขียน policy และโรงงานเป็นผู้ปฏิบัติ ต้องจัด stop/restart authority ให้สอดคล้องกะจริง หาก night shift ไทยมีเพียงผู้อนุมัติญี่ปุ่นที่ปลด stop ได้ downtime อาจยาว แต่การให้หน้างาน restart งานความเสี่ยงสูงคนเดียวก็อันตราย รูปแบบหนึ่งคือให้ local responsible person หยุดทันทีได้ และใช้ dual approval สำหรับ restart ตามผลกระทบธุรกิจ
งานเป็นกะต้องกำหนด job role และลำดับผู้แทน ไม่ใช่เฉพาะชื่อบุคคล ระบุว่า approval ที่ข้ามกะหมดอายุเมื่อใด handover อย่างไร และใครตรวจ pending queue รวมปฏิทินวันหยุด การติดต่อผู้ขายนอกเวลา ไฟดับ และสื่อสารขัดข้องใน SAT สิ่งเหล่านี้เป็น operational design ไม่ใช่การกล่าวอ้างข้อกฎหมายเฉพาะ
สำหรับ input หลายภาษา ให้ทดสอบการตีความคำเกี่ยวกับสิทธิ์ควบคู่คุณภาพแปล คำอย่าง “อนุมัติ”, “ยืนยัน” และ “ดำเนินการ” ในญี่ปุ่น อังกฤษ และไทยอาจใช้คลุมเครือ คำขอให้ยืนยันต้องไม่ถูกตีความเป็นสิทธิ์ execute Approval UI ควรแสดงประเภท action และ target เป็น structured field ไม่รับ free text อย่างเดียวเป็น authorization ผูกคำย่ออุปกรณ์และชื่อชิ้นส่วนกับ master ID เพื่อไม่ให้ทำกับเครื่องชื่อคล้ายกัน
อย่าถือ network ไม่เสถียรเป็นเพียงปัญหา performance ให้ตรวจว่า approval ที่ retransmit ไม่ถูกนับสองครั้ง job ที่ขาดไม่ execute พร้อมกันทั้งหมดเมื่อ reconnect และ write ไม่ดำเนินต่อเมื่อเฉพาะ log export ล้มเหลว การลองกรณีเหล่านี้บน route และเวลาทำงานจริงของโรงงานไทยคือคุณค่าหลักของ SAT
จะแบ่ง FAT และ SAT อย่างไร
FAT สร้างหลักฐานที่ทำซ้ำได้ในสภาพแวดล้อมผู้ขายหรือ validation ใช้ frozen dataset, ERP/เครื่องจักรจำลอง, attack data และ network fault ที่ควบคุมได้เพื่อครอบคลุม 7 เกต SAT ตรวจความต่างจาก network จริงของโรงงานไทย role ภาษา approver เวลาทำงาน และข้อจำกัดการเชื่อมต่อ
| หัวข้อ | ตรวจใน FAT | ตรวจใน SAT |
|---|---|---|
| Data | Snapshot ที่ anonymize และ freeze | คุณภาพและสิทธิ์ของ local master |
| System | Mock API และ sandbox | Connection จริง latency และ stop path |
| People | Role สมมติ | Approver จริง การแทนกะ และเวลาทำงาน |
| Language | ชุด JA/EN/TH ตามที่กำหนด | คำศัพท์หน้างาน คำย่อ input ปนภาษา |
| Failure | Inject fault ที่ควบคุมได้ | การขาดและกู้คืนที่ใกล้งานจริง |
| Evidence | Test package ที่ทำซ้ำได้ | เงื่อนไขไซต์และความต่างที่บันทึกไว้ |
หาก SAT เป็นครั้งแรกที่อนุญาตให้เขียน production ERP ให้จำกัด record, volume และช่วงเวลา เริ่มจาก shadow mode ไป proposal-only, approved write และจึง automated write ไม่จำเป็นต้องเริ่มด้วย autonomy เต็มรูปแบบ
วิธีสร้าง AI Agent evaluation case ที่ทำซ้ำได้
Case ต้องระบุ initial state และ expected path ไม่ใช่แค่ประโยค input รวม case ID, purpose, risk, precondition, input, available tool, prohibited tool, data snapshot, expected result, tolerance, expected approval, expected log และ cleanup เป็นชุดเดียว
ระบุเส้นทางต้องห้ามควบคู่ผลที่ต้องการ
สำหรับ “ตรวจ stock ขาดและสร้าง purchase proposal” เส้นทางต้องห้ามอาจเป็น ERP write ก่อน approval, ส่งไป unapproved supplier, export ไป personal mailbox และแก้ price master แม้ได้คำตอบสุดท้ายถูก แต่ผ่านเส้นทางต้องห้ามก็ไม่ผ่าน
ปกป้อง test environment จาก Agent
อย่าใส่คำตอบใน filename ทิ้ง solution ใน git history เปิด scoring API ให้ tool เรียก หรือปน test-only permission กับ production แยกสิทธิ์ runner และ grader และสุ่ม review trace โดยคน เพื่อลด solution contamination กับ grader gaming
เก็บ failed run ให้สร้างซ้ำได้
เมื่อ fail ให้เก็บ document version, tool response, model/config, approval state และ trace ID พร้อม input Mask personal/secret value แต่เหลือ reference สำหรับสร้างเงื่อนไขเดิม หลังแก้แล้วให้รันทั้ง case นั้นและ regression set ที่เกี่ยวข้อง

จาก RFP ถึงการอนุมัติ production
1. กำหนดผู้รับผิดชอบด้วย RACI
Business owner กำหนดวัตถุประสงค์และผลกระทบ IT ดู connection กับ permission Quality ดู test design Security ดู threat model Internal audit ดู evidence และ local site owner ดูเงื่อนไข SAT ระบุ final production approver และ stop authority แยกกัน
2. แจกเกตและ evidence template ก่อนเลือกผู้ขาย
การเพิ่ม acceptance หลังทำสัญญาทำให้ราคาและความรับผิดชอบเสียสมดุล ให้ 7 เกต scenario, evidence template, test environment และ retest condition ใน RFP ใช้ benchmark ของผู้ขายเป็นข้อมูลสนับสนุน แต่กำหนดให้ reproduce ด้วย case ของผู้ซื้อ
3. อนุมัติ residual risk ไม่ใช่แค่ pass/fail
อาจกำจัดทุก risk ไม่ได้ ให้บันทึก impact, trigger, detection, workaround, due date และ owner ของรายการค้าง ห้ามรับ privilege breach หรือ unauthorized egress ความเสี่ยงสูงที่ยังไม่แก้ ส่วนความต่างด้านถ้อยคำเล็กน้อยอาจรับพร้อม monitoring ต้องเขียนความแตกต่างนี้ชัดเจน
4. เขียน scope และเงื่อนไขหมดอายุในใบอนุญาต production
ใบอนุญาต production ไม่ถาวร ระบุ agent version, model, tool, data, site, role, operation และ validity period ที่อนุมัติ Material change, audit evidence ขาด, stop event, severe incident หรือ threshold breach ต้องทำให้อนุญาตหมดอายุหรือกลับมาพิจารณาใหม่
ความผิดพลาดที่พบบ่อยในการทดสอบการยอมรับ AI Agent
- ใช้ demo ที่สำเร็จแทน production acceptance
- ดูแต่ average accuracy จนซ่อน critical scenario
- เข้าใจข้อห้ามใน prompt ว่าเป็น access control
- มี approval screen แต่ไม่ผูก approval กับ payload ที่ execute
- หยุด parent agent แต่ subagent หรือ retry worker ยังรัน
- เก็บ log แต่ขาด model version, tool argument หรือ approval ID
- ประกาศว่าปลอดภัยหลังบล็อกการโจมตีได้ครั้งเดียว
- ผ่าน FAT แต่ไม่ดูภาษา network และ shift ของโรงงานไทย
- ถือ model update เป็น minor และไม่ re-accept
เรื่องเหล่านี้ไม่ใช่ปัญหาเทคนิคล้วน แต่เป็นรอยต่อที่ขาดระหว่างสัญญา ความรับผิดชอบ การปฏิบัติการ และ audit การเชื่อม RFP กับ acceptance ด้วย 7 เกตเดียวกันจึงสำคัญ
FAQ
การทดสอบการยอมรับ AI Agent คืออะไร
คือการประเมินระบบ Agent ทั้งระบบก่อน production ด้วยหลักฐาน ทั้งความสามารถทำงาน สิทธิ์ Approval, stop/recovery, security, audit log และ operational drift ขอบเขตกว้างกว่าการประเมินความแม่นยำโมเดล
AI Agent RFP ต้องบังคับอะไรบ้าง
บังคับงานและสิ่งนอกขอบเขต เครื่องมือ/ข้อมูล สิทธิ์ตาม role จุด approval เงื่อนไข stop, test case, evidence, log, change management และ re-acceptance criteria ขอวิธี implement/ทดสอบและข้อจำกัด ไม่ใช่ checkbox เท่านั้น
Prompt เพียงพอสำหรับการออกแบบสิทธิ์ AI Agent หรือไม่
ไม่เพียงพอ ต้องบังคับ least privilege ใน service account, API, network, tool wrapper และระบบข้อมูลเป้าหมาย การทดสอบต้องพิสูจน์ว่าการกระทำต้องห้ามและทางเลี่ยงถูกปฏิเสธจริง
ควรกำหนดเงื่อนไขหยุด AI Agent อย่างไร
เริ่มจาก prohibited action, approval mismatch, sensitive-data detection, API fault, repeated failure และ loss of monitoring แล้วระบุ scope, เวลาสูงสุด, isolation, compensation และผู้มีสิทธิ์ restart ตัวเลขให้แต่ละองค์กรตั้งตามผลกระทบ
ควรทำ AI Agent evaluation ซ้ำกี่ครั้ง
ไม่มีจำนวนสากล กำหนดตาม probabilistic variance, impact และโอกาสที่ผู้โจมตี retry ได้ Critical/attack case ควรลองหลายครั้งและหลายถ้อยคำ พร้อมบันทึก model, config, data และ tool response
จำเป็นต้องมีทั้ง FAT และ SAT หรือไม่
ควรมีทั้งสองเมื่อ production site ต่างจาก validation FAT สร้างหลักฐานซ้ำได้ ส่วน SAT ตรวจ permission, language, network, people และ external system จริง สามารถแบ่ง SAT เป็นระยะตาม risk
สรุป
การผ่านการทดสอบการยอมรับ AI Agent ไม่ได้แปลว่า “ตอบได้ดี” แต่หมายถึงทำงานในขอบเขตที่อนุญาต ขออนุมัติตามที่กำหนด หยุดและกู้คืนอย่างปลอดภัย และทิ้งหลักฐานที่ย้อนสร้างได้ การใช้ 7 เกตเดียวกัน—Function, Permission, Approval, Stop/Recovery, Security, Audit Log และ Operational Drift—ตั้งแต่ RFP ถึง production ช่วยให้ผู้ซื้อ ผู้ขาย โรงงาน และ audit ตัดสินจากหลักฐานเดียวกัน เป้าหมายตัวเลขต้องมาจากผลกระทบขององค์กร ไม่ใช่ยืมตัวเลขพาดหัวจากภายนอก
TOMAS TECH สามารถช่วยจัดโครง AI Agent RFP หรือ checklist การยอมรับสำหรับโรงงานในไทยได้ตั้งแต่ช่วงกำหนดขอบเขต ติดต่อเรา เพื่อแยกงาน ขอบเขตสิทธิ์ และหลักฐาน FAT/SAT ให้เป็นตารางตัดสินที่ส่งให้ผู้ขายได้


