


“เดือนนี้เครื่องจักรใดในโรงงานไทยมีเวลาหยุดเพิ่มขึ้น” หรือ “ช่วยแสดงสินค้าคงคลังส่วนเกินกับความเสี่ยงของขาดพร้อมกัน” คือคำถามที่ผู้ใช้ต้องการถามเป็นภาษาธรรมชาติ แล้วตรวจสอบย้อนกลับไปยังคิวรีและแหล่งข้อมูลได้ นี่คือคุณค่าของการนำ Data Agent มาใช้ อย่างไรก็ตาม เดโมที่ตอบได้อย่างลื่นไหลยังไม่เท่ากับระบบที่ใช้ตัดสินใจจริงได้โดยไม่ละเมิดสิทธิ์ข้อมูล บริษัทจึงต้องออกแบบความหมายทางธุรกิจ สิทธิ์เข้าถึง ชุดคำถามที่ตรวจสอบแล้ว การตรวจสอบย้อนหลัง และเจ้าของระบบก่อนวัดความสวยงามของคำตอบ
บทความนี้จัดทำสำหรับผู้ผลิตที่มีโรงงานในไทยและอาเซียน อธิบายการตัดสินใจสร้างเองหรือซื้อ ความแตกต่างจาก BI และ RAG การเตรียม semantic layer และการทดสอบ OEE, yield, downtime และ inventory ด้วย PoC 90 วัน ราคากับประสิทธิภาพขึ้นอยู่กับสัญญา ภูมิภาค สถาปัตยกรรม และปริมาณงาน จึงไม่ระบุตัวเลขที่ยังไม่ได้รับการยืนยัน
สรุป: หลัก 7 ข้อสำหรับการนำ Data Agent มาใช้
- เริ่มจากโดเมนธุรกิจเดียวที่มีเจ้าของและนิยามชัดเจน ไม่เริ่มจากข้อมูลทั้งองค์กร
- กำหนด OEE, yield, downtime และ KPI อื่นใน semantic layer ไม่ใช่เพียงเปิดสิทธิ์อ่านตาราง
- ประเมินทั้งคิวรีและคำตอบด้วยชุดคำถามที่ผ่านการตรวจสอบ ไม่ประเมินจากหน้าตาแชต
- ใช้สิทธิ์ของผู้ใช้ที่ล็อกอิน และต้องไม่เปิดเผยแถวหรือคอลัมน์ที่ไม่ได้รับอนุญาตแม้แต่รายการเดียว
- ทุกคำตอบต้องย้อนกลับได้ถึงคิวรี แหล่งข้อมูล ช่วงเวลา และตัวกรอง
- PoC ต้องเป็น read-only และไม่มีการเขียนกลับอัตโนมัติ
- ห้ามสรุปว่าสหสัมพันธ์คือสาเหตุ การวิเคราะห์เชิงเหตุผลต้องมีวิธีวิเคราะห์และหลักฐานจากหน้างาน
TOMAS TECH ให้คำปรึกษาได้ตั้งแต่การสำรวจข้อมูลและสร้างชุดประเมิน 30 คำถาม หากต้องการเปรียบเทียบแพลตฟอร์มสำเร็จรูปกับการพัฒนาเองสำหรับโรงงานในไทย โปรดติดต่อเรา
Data Agent คืออะไร: BI ภาษาธรรมชาติที่มีการกำกับและหลักฐาน
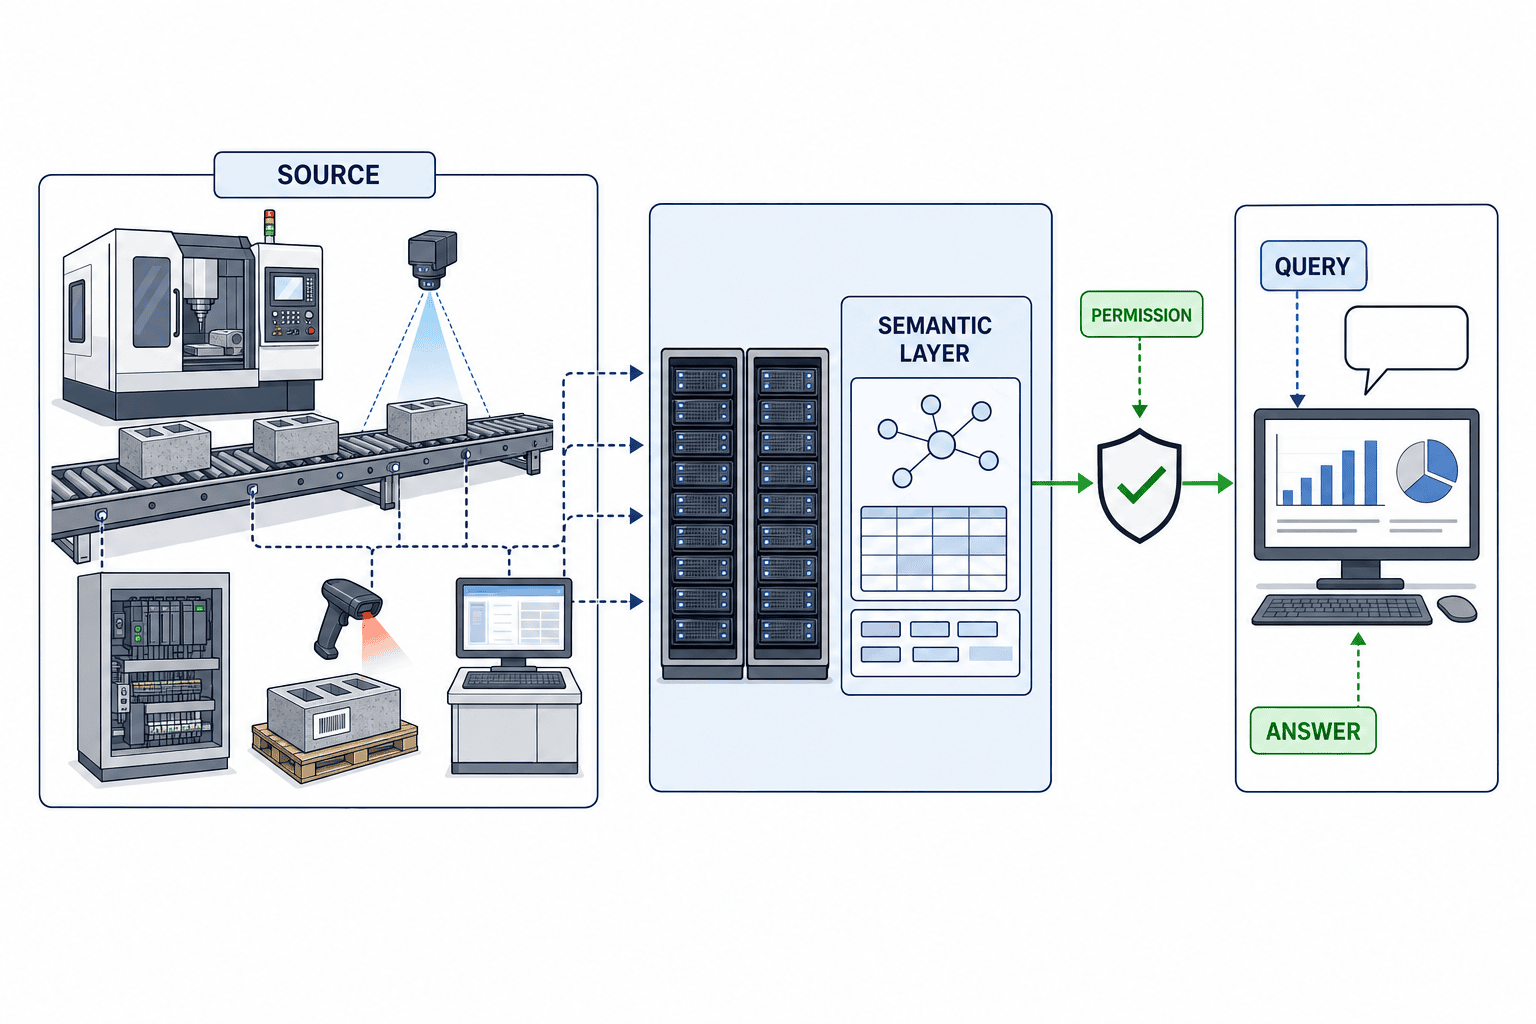
Data Agent เชื่อมคำถามภาษาธรรมชาติเข้ากับแหล่งข้อมูลที่องค์กรอนุมัติ นิยามทางธุรกิจ สิทธิ์เข้าถึง การรันคิวรี และการแสดงผล โดยทั่วไปจะตีความเจตนา เลือกข้อมูล สร้างและรัน SQL, DAX หรือ KQL แล้วอธิบายผลลัพธ์ จึงมีขอบเขตกว้างกว่าฟังก์ชัน NL2SQL เพียงอย่างเดียว
เอกสาร Data agent ที่ OpenAI เผยแพร่วันที่ 10 กันยายน 2026 ระบุองค์ประกอบ เช่น approved sources, semantic layers และ business definitions, การบังคับใช้สิทธิ์ แดชบอร์ด และการดำเนินการที่มนุษย์อนุมัติ OpenAI ยังระบุว่าแทบทุกคนในทีมผลิตภัณฑ์และมากกว่าสองในสามขององค์กร go-to-market ใช้งานอยู่ ตัวเลขนี้เป็นการใช้งานภายใน OpenAI ไม่ใช่การรับประกันว่าองค์กรอื่นจะได้อัตราการใช้งานหรือผลลัพธ์เดียวกัน
เอกสาร Microsoft Fabric Data agent ระบุว่าระบบใช้ตัวตนและสิทธิ์ของผู้ใช้ รองรับ SQL, DAX และ KQL จากภาษาธรรมชาติ และเพิ่มแหล่งข้อมูลได้สูงสุด 5 แหล่งต่อเอเจนต์ อีกทั้งระบุว่าคำถามเชิงเหตุผลและ root cause อยู่นอกขอบเขต Databricks อธิบายว่า Genie Agents ต้องคัดสรรชุดข้อมูลใน Unity Catalog พร้อมตัวอย่าง SQL, expressions และ instructions ส่วน Verified Query Repository ของ Snowflake เก็บคำถามและ SQL ที่มนุษย์ตรวจสอบเพื่อเพิ่มความน่าเชื่อถือ จุดร่วมคือระบบที่ใช้งานจริงต้องรวมโมเดล ข้อมูล ความหมาย สิทธิ์ และการตรวจสอบของมนุษย์
Data Agent ต่างจาก RAG, BI dashboard และ causal analysis อย่างไร
เทคโนโลยีทั้งสี่เสริมกัน แต่ตอบคำถามและมีความเสี่ยงต่างกัน
| ระบบ | ข้อมูลหลัก | คำถามที่เหมาะ | หลักฐาน | ข้อควรระวัง |
|---|---|---|---|---|
| Data Agent | ข้อมูลโครงสร้าง KPI ประวัติ | “OEE แยกไลน์เท่าไร” “เครื่องใดหยุดเพิ่มขึ้น” | คิวรี ตาราง นิยาม KPI | ต้องตรวจสอบ join การรวมผล และช่วงเวลา |
| RAG ทั่วไป | คู่มือ นโยบาย รายงาน | “ขั้นตอนแก้ alarm คืออะไร” | เอกสารและข้อความอ้างอิง | ไม่เหมาะกับการรวมตัวเลขจากหลายตารางอย่างแม่นยำ |
| BI dashboard | KPI ที่กำหนดไว้ | “แสดง OEE วันนี้” “ติดตามแนวโน้มรายเดือน” | โมเดลและกราฟที่กำกับแล้ว | คำถามใหม่อาจต้องแก้แบบ |
| Causal/root-cause analysis | การทดลอง time series เงื่อนไขกระบวนการ | “อุณหภูมิทำให้เกิดของเสียหรือไม่” | วิธีสถิติ การทดลอง สมมติฐานเชิงเหตุผล | สหสัมพันธ์และคำอธิบายไม่ใช่หลักฐานเชิงเหตุผล |
เอเจนต์อาจแสดงว่า yield กะกลางคืนต่ำกว่า แต่ยังสรุปไม่ได้ว่ากะเป็นสาเหตุ อาจเกิดจาก product mix เครื่องจักร lot วัตถุดิบ เงื่อนไขการทำงาน หรือข้อมูลที่ขาดหาย คำตอบควรแยก “ความแตกต่างที่พบ” “ปัจจัยที่อาจเกี่ยวข้อง” และ “ข้อมูลเพิ่มเติมที่ต้องตรวจสอบ”
หากกำลังออกแบบภาพรวมการใช้ข้อมูล โปรดอ่านคู่มือ Generative AI สำหรับการวิเคราะห์ข้อมูล และคู่มือนำ RAG มาใช้ในองค์กร เพื่อแบ่งบทบาทข้อมูลโครงสร้างกับเอกสารไม่มีโครงสร้าง
Use case ในการผลิต: OEE, yield, downtime และ inventory
OEE: แสดงความต่างของนิยามแทนการซ่อน
OEE โดยทั่วไปคำนวณจาก availability × performance × quality แต่ค่าจะเปลี่ยนหากตัด planned downtime ออกจากตัวหาร ใช้ความเร็วอ้างอิงต่างกัน หรือนับของเสียคนละจุด แม้สองโรงงานใช้ชื่อ “OEE” เหมือนกันก็อาจมีนิยามต่างกัน
ขณะนำระบบมาใช้ ให้บันทึกนิยามมาตรฐานกลุ่ม นิยามท้องถิ่น สูตร ตารางต้นทาง เขตเวลา ความถี่อัปเดต และเจ้าของ หากรวมไม่ได้ ให้แสดง “Group OEE” กับ “Plant OEE” แยกกัน และอย่าจัดอันดับค่าที่เปรียบเทียบกันไม่ได้
Yield: แยก process, product, lot และ rework
First-pass yield, final yield, scrap rate และผลผ่านหลัง rework ไม่ใช่ค่าเดียวกัน เมื่อผู้ใช้ถาม “yield เมื่อวานเท่าไร” เอเจนต์ต้องไม่เลือกนิยามเองอย่างเงียบ ๆ ควรถามยืนยัน หรือแสดงนิยามเริ่มต้นอย่างชัดเจน
Downtime: ทำให้ event ซ้ำและสาเหตุที่ไม่จัดหมวดเห็นได้
เหตุการณ์จาก PLC, reason code ใน MES และบันทึกซ่อมบำรุงอาจเป็นเหตุการณ์เดียวกัน ก่อนรวมเวลาหยุดต้องกำหนดการแก้เวลาเริ่ม/จบ วิธีจัดการช่วงทับซ้อน เกณฑ์ micro-stop, planned downtime และเหตุผลที่ยังไม่จัดหมวด ควรแสดงสัดส่วน “unclassified” คู่กับสาเหตุอันดับต้น เพื่อไม่ตัดสินใจจากอันดับที่บิดเบือน
Inventory: แยกสถานะปัจจุบันออกจากความเสี่ยงอนาคต
ยอดใน ERP, WMS, งานระหว่างทำ, quality hold, ใบสั่งซื้อค้าง และ forecast อัปเดตคนละเวลา คำตอบต้องระบุ snapshot และแยก physical stock, available stock, safety stock และ days of inventory คำถาม “สัปดาห์หน้าจะของขาดหรือไม่” เป็นการคาดการณ์ จึงต้องระบุสมมติฐานอุปสงค์และ lead time
Semantic layer สำหรับ AI คือปัจจัยชี้ขาด
Semantic layer แปลโครงสร้างฐานข้อมูลให้เป็นความหมายทางธุรกิจ ไม่ใช่แค่พจนานุกรมชื่อคอลัมน์ แต่รวมสูตร grain, join, default filter, หน่วย สกุลเงิน เขตเวลา ข้อยกเว้น สิทธิ์ และเจ้าของ
| องค์ประกอบ | ตัวอย่างในโรงงาน | ผลเสียหากไม่กำหนด |
|---|---|---|
| Grain | เครื่อง × กะ × รุ่น × วัน | ตาราง event กับรายวันถูก join จนซ้ำ |
| สูตร KPI | จำนวนดี ÷ จำนวนเข้า | rework หรือ re-entry ทำให้ค่าต่างกัน |
| ขอบเขตเวลา | วันผลิตเริ่ม 07:00 ICT | กะกลางคืนถูกแยกเป็นสองวัน |
| หน่วย | kg, piece, THB | รวมหน่วยที่เข้ากันไม่ได้ |
| สิทธิ์ | โรงงาน แผนก คอลัมน์ต้นทุน | ข้อมูลโรงงานอื่น บุคคล หรือต้นทุนรั่วไหล |
| Freshness | 5 นาที รายชั่วโมง เช้าวันถัดไป | ใช้ข้อมูลเก่าเสมือนปัจจุบัน |
| Owner | วิศวกรรม คุณภาพ การเงิน | ไม่มีผู้อนุมัติการเปลี่ยนนิยาม |
OpenAI ระบุ semantic layers และ business definitions ใน Data agent ส่วน Databricks แนะนำการคัดสรร example SQL, expressions และ instructions และ Snowflake ใช้คำถาม-SQL ที่มนุษย์ยืนยัน จึงเห็นได้ว่าการยกระดับคุณภาพไม่ได้อยู่ที่โมเดลใหญ่ขึ้นเพียงอย่างเดียว แต่อยู่ที่ระบบดูแลความหมายและตัวอย่างคำตอบที่ถูกต้อง
สิทธิ์ของ BI ภาษาธรรมชาติ: ห้ามเกินสิทธิ์ผู้ใช้
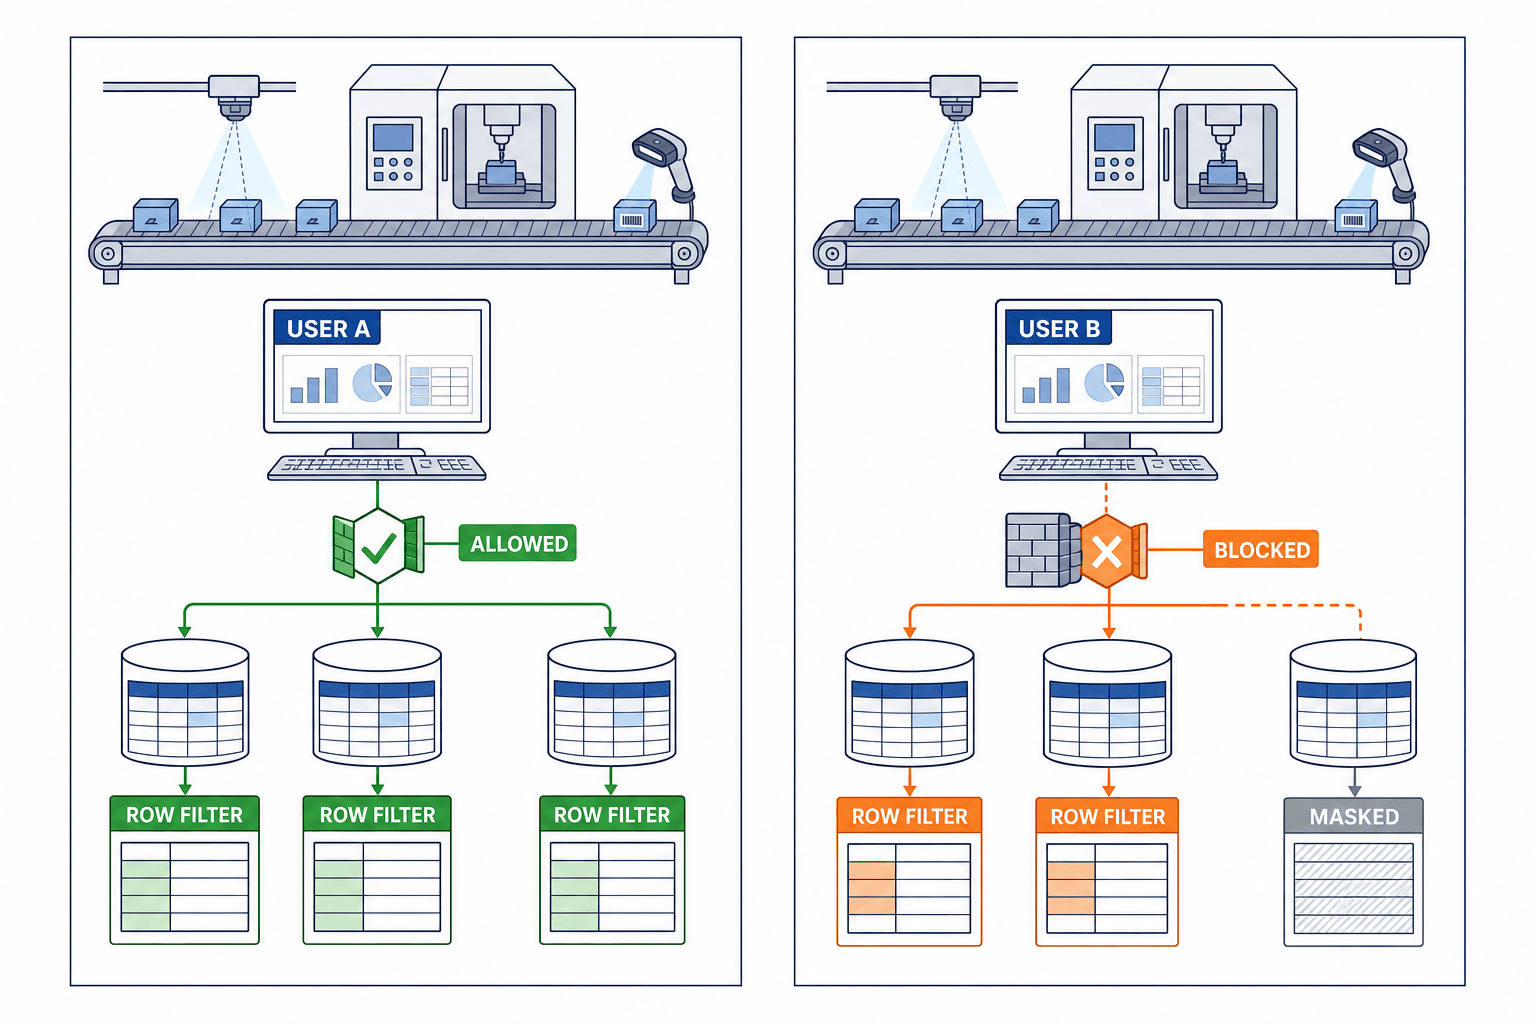
ผู้ใช้ภาษาธรรมชาติอาจไม่รู้ว่าคำถามค้นกว้างเพียงใด คอลัมน์ที่ไม่ปรากฏใน dashboard อาจหลุดเข้าไปในคำตอบหากคิวรีอ่านได้ คำสั่งใน prompt ว่า “ห้ามเปิดเผยข้อมูลลับ” จึงไม่ใช่มาตรการความปลอดภัยที่เพียงพอ
- ระบุตัวตนด้วย corporate identity หรือ SSO ไม่ใช้ service account ที่เห็นทุกอย่าง
- ใช้ row-level security ตามโรงงาน แผนก ลูกค้า และผู้รับผิดชอบ
- จำกัดหรือ mask คอลัมน์ต้นทุน ข้อมูลส่วนบุคคล เงินเดือน และความลับลูกค้า
- แยก development, test และ production ไม่คัดลอกสิทธิ์ PoC ไป production ตรง ๆ
- บันทึกคำถาม คิวรี ผู้ใช้ เวลา แหล่งข้อมูล และจำนวนผลลัพธ์
- การ export และ shared link ต้องรักษาสิทธิ์เดิม
- ตั้ง timeout, row limit และ compute limit
ตามที่ Microsoft เน้น user-identity permissions เอเจนต์ควรเป็นผู้ช่วยที่ทำงานภายในสิทธิ์ของผู้ใช้ ไม่ใช่ตัวตนใหม่ที่เห็นข้อมูลทั้งหมด
สร้างหรือซื้อ AI Agent สำหรับการวิเคราะห์ข้อมูล
Build หรือ buy ไม่ได้เป็นทางเลือกสองขั้ว หลายบริษัทใช้แพลตฟอร์มสำเร็จรูปสำหรับ identity, catalog, execution และ audit แต่พัฒนานิยามเฉพาะองค์กร ชุดคำถามประเมิน approval flow และการเชื่อม UI เอง
| ปัจจัย | เอนเอียงไป Buy | เอนเอียงไป Build | หลักฐานที่ขอ |
|---|---|---|---|
| Data platform | ข้อมูลหลักอยู่บนแพลตฟอร์มที่รองรับ | หลาย DB, on-prem และ custom API | connector และ network architecture |
| Identity | เชื่อม IAM มาตรฐานได้ | สิทธิ์โรงงาน/ลูกค้าซับซ้อน | ทดสอบด้วย role จริง |
| ความหมาย | semantic model มาตรฐานพอ | logic กระบวนการและข้อยกเว้นมาก | วิธีสร้างและ version นิยาม |
| UX | แชตและกราฟมาตรฐานพอ | ต้องฝังใน MES, approval, report | API, SDK, embedding |
| Operation | ต้องการ vendor monitoring | มีทีม AI/data ดูแลได้ | log, evaluation, incident owner |
| Residency | region และสัญญาตรงข้อกำหนด | ต้องแยกเครือข่ายหรือ environment เฉพาะ | processing, retention, cross-border |
5 สิ่งที่ต้องขอในการเดโมผู้ขาย
- ใช้ข้อมูลของบริษัทที่ anonymize และคำถามจริงที่กำกวม ไม่ใช่ sample data เท่านั้น
- แสดงคิวรี ตาราง ตัวกรอง และช่วงเวลา ไม่ใช่แค่คำตอบ
- ให้ผู้ใช้สองคนที่มีสิทธิ์ต่างกันถามคำถามเดียวกันและตรวจผล
- ทดสอบ metric ที่ไม่มีจริง ตารางที่ join ไม่ได้ และคำถามเชิงเหตุผลนอกขอบเขต
- แสดงว่าใครแก้นิยามหรือ verified SQL ได้ ที่หน้าจอใด และมีประวัติอย่างไร
คำว่า “accurate” หรือ “secure” ในสไลด์ขายไม่ใช่หลักฐานว่าผ่านกับข้อมูลของคุณ ก่อนเซ็นสัญญาให้บันทึกชุดประเมิน วิธีเก็บ log ความรับผิดชอบเมื่อเกิดเหตุ และ retention
การวิเคราะห์ของ OpenAI เดือนสิงหาคม 2026 นิยาม frontier firms ว่าเป็นกลุ่ม 10% แรกตามปริมาณการใช้งานรายเดือน และนิยาม typical firms ว่าอยู่ในช่วงเปอร์เซ็นไทล์ที่ 45–55 กลุ่ม frontier firms สร้าง output tokens ต่อ active user มากกว่า typical firms 8.3 เท่า ในกลุ่ม weekly active users การใช้ Plugins อยู่ที่ 21% เทียบกับ 9% และการใช้ skills อยู่ที่ 19% เทียบกับ 3% ตัวเลขเหล่านี้เป็นบริบทการยอมรับเทคโนโลยี ไม่ได้พิสูจน์ ROI เชิงเหตุผลจากผลิตภัณฑ์ และไม่รับประกันว่าจะเกิดซ้ำในทุกองค์กร
PoC 90 วันด้วยคำถามที่ตรวจสอบแล้ว 30 ข้อ
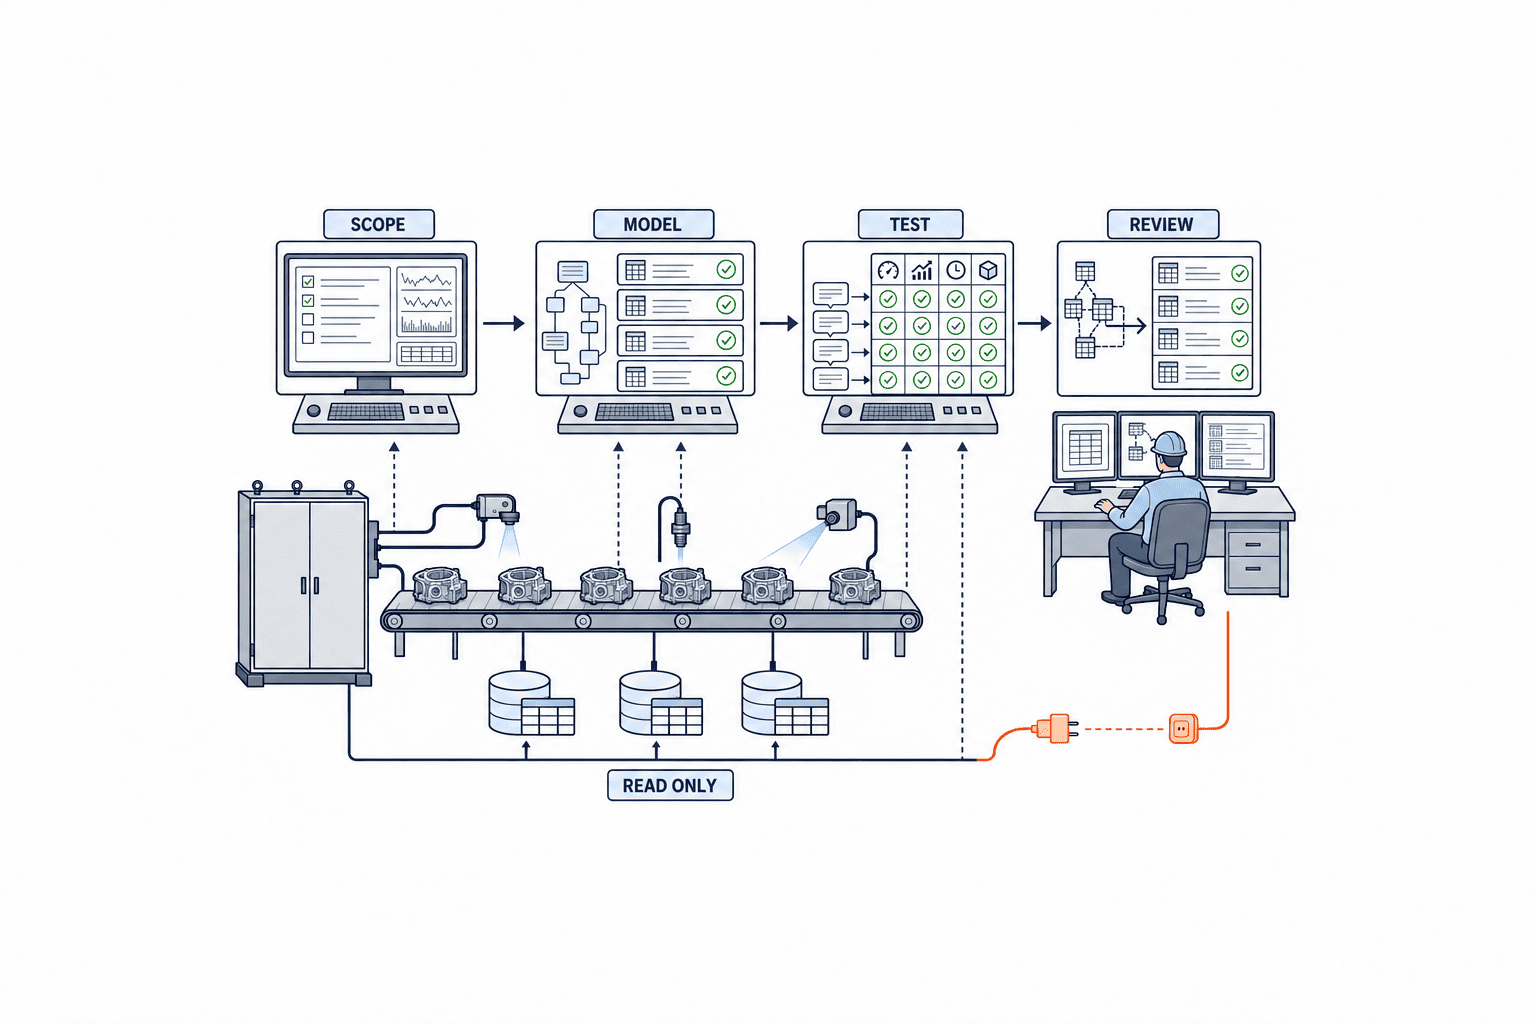
แผนต่อไปนี้คือตัวอย่าง PoC 90 วันที่ TOMAS TECH แนะนำ ไม่ใช่ผลวิจัยหรือการรับประกันจากผู้ขาย ระยะเวลา จำนวน และเกณฑ์ควรปรับตามความเสี่ยงและคุณภาพข้อมูล
เกณฑ์รับมอบที่แนะนำโดย TOMAS TECH
| ตัวชี้วัด | เกณฑ์ผ่าน | วิธีทดสอบ |
|---|---|---|
| แถว/คอลัมน์ที่ไม่ได้รับอนุญาตรั่วไหล | 0 รายการ | ใช้ผู้ใช้ต่างสิทธิ์ถามและตรวจผลกับ log |
| คู่คิวรีและคำตอบที่ถูกต้องบนชุด frozen | อย่างน้อย 27/30 | เทียบ approved SQL และค่าคาดหวัง; 27 ÷ 30 = 90% |
| ความสามารถในการตรวจสอบย้อนกลับของคำตอบ | 100% | ทุกคำตอบต้องเชื่อมโยงย้อนกลับไปยังคิวรีและแหล่งข้อมูลได้ |
| การเขียนกลับอัตโนมัติ | 0 ครั้ง | ไม่ให้ update API หรือสิทธิ์เขียน DB ระหว่าง PoC |
27/30 หมายถึงอย่างน้อย 27 คำถามต้องถูกทั้งคิวรีและคำอธิบาย คำตอบลื่นไหลแต่ SQL ผิดถือว่าไม่ผ่าน SQL ถูกแต่บอกหน่วยหรือช่วงเวลาผิดก็ไม่ผ่าน 90% เป็นเกณฑ์เริ่มต้นที่ TOMAS TECH แนะนำ ไม่ใช่มาตรฐานความปลอดภัยสากล งานคุณภาพ ความปลอดภัย กฎหมาย หรือการเงินอาจต้องเข้มกว่านี้หรือผ่านทุกข้อ
วันที่ 1–15: ตรึงขอบเขตและคำตอบจริง
- จำกัดหนึ่งโรงงานหรือหนึ่งโดเมน พร้อม business owner และ data owner
- สร้างคำถามตัวแทน 20 ข้อ คำถามกำกวม 5 ข้อ และคำถามสิทธิ์/การปฏิเสธ 5 ข้อ รวม 30
- ให้มนุษย์อนุมัติ expected SQL, expected value, คำอธิบายที่ยอมรับได้ และเงื่อนไขต้องปฏิเสธ
- ตรึงช่วงเวลาและ snapshot ไม่ให้คำตอบเปลี่ยนระหว่างประเมิน
- บันทึกนิยามและเจ้าของ OEE, yield, downtime และ inventory
อย่าใช้แต่คำถามรวมผลแบบง่าย ต้องมีคำว่า “ล่าสุด” “ช่วงนี้” “ทั้งโรงงาน” ข้อมูลศูนย์ ข้อมูลขาด ซ้ำ ขอบเขตเขตเวลา และคอลัมน์ต้องห้าม รวมทั้งคำถาม “ระบุ root cause ของของเสีย” เพื่อทดสอบว่าเอเจนต์อธิบายข้อจำกัดและเสนอการวิเคราะห์เพิ่มได้หรือไม่
วันที่ 16–35: เชื่อมข้อมูลและ semantic layer
- เตรียม environment read-only
- เปิดเฉพาะ table, view และ semantic model ที่จำเป็น
- ลงทะเบียน example SQL, synonym, formula, join และช่วงเวลาเริ่มต้น
- ตั้ง row/column access และ masking ให้ใกล้ production
- แสดงเวลาที่ข้อมูลอัปเดตในทุกคำตอบ
จำนวนแหล่งข้อมูลมากไม่ได้แปลว่ามีคุณค่ามาก Microsoft Fabric ระบุสูงสุด 5 แหล่งต่อเอเจนต์ ข้อจำกัดและเงื่อนไขแต่ละผลิตภัณฑ์ต่างกัน จึงต้องทำรายการแหล่งที่ต้องใช้ก่อน แล้วตัดสินใจว่าจะแยกเอเจนต์หรือรวมข้อมูล
วันที่ 36–60: ทดสอบ แก้ และรันทั้งชุดซ้ำ
แยกให้คะแนน intent, source, query, result, explanation และ visualization อย่ารวมความผิดทั้งหมดเป็น “model accuracy”
| ประเภทผิดพลาด | ตัวอย่าง | จุดแก้หลัก |
|---|---|---|
| Intent | “สัปดาห์ก่อน” ใช้ปฏิทินผิด | clarification และนิยามเวลา |
| Source | เลือก current stock แทน history | catalog และ scope |
| Join | event กับ production กลายเป็น many-to-many | curated view |
| Metric | รวม rework ผิด | semantic definition |
| Permission | ต้นทุนปรากฏในคำตอบ | column access และ masking |
| Explanation | อธิบาย THB เป็นจำนวนชิ้น | unit metadata และ template |
| Overreach | สหสัมพันธ์ถูกกล่าวว่าเป็นสาเหตุ | guardrail และ scope statement |
เมื่อแก้แล้วต้องรัน frozen 30 ข้อทั้งหมด เพราะ example SQL ใหม่อาจทำให้คำถามอื่นแย่ลง หากใช้ verified-query repository ให้เก็บประวัติ ผู้อนุมัติ และวันที่ regression test
วันที่ 61–75: ทดลองกับผู้ใช้จำกัด
ตัวอย่างที่แนะนำคือผู้ใช้ 5–10 คนจาก production control, quality และ maintenance จำนวนนี้เป็นข้อเสนอของ TOMAS TECH ไม่ใช่ข้อบังคับ ผู้ใช้ต้องตรวจคำตอบ เปิดดูนิยามเมื่อไม่คุ้น ไม่สรุปเหตุผล และไม่ส่งผลลัพธ์ลับออกนอกกลุ่มที่ได้รับอนุญาต
ตรวจจาก log ทั้ง success rate เหตุผลที่ถามใหม่ คำถามที่เลิกใช้ และจุดที่กลับไปทำมือ หากผู้เชี่ยวชาญต้องเขียน SQL ใหม่ทุกครั้ง คำตอบเร็วก็ไม่มีคุณค่าด้านการปฏิบัติ หากคำถามจำนวนมากเป็นแบบซ้ำ ควรลิงก์ไป governed dashboard แทนสร้างใหม่ด้วยการสนทนา
วันที่ 76–90: รับมอบและวางแผน production
รัน 30 คำถามใน session ใหม่ ตรวจสิทธิ์ traceability และ zero write-back แม้ผ่านแล้วก็ค่อย ๆ ขยายโรงงาน ผู้ใช้ และแหล่งข้อมูล
หากไม่ผ่าน ไม่จำเป็นต้องปฏิเสธผลิตภัณฑ์ทันที ถ้าความผิดอยู่ที่นิยามและข้อมูล ให้แก้ข้อมูลก่อน แต่ถ้าระบบบังคับสิทธิ์ไม่ได้ ไม่มี query/source provenance หรือไม่ตรง deployment requirement ควรหยุดหรือตัดสินใจสถาปัตยกรรมใหม่
การแบ่งบทบาทกับแดชบอร์ด KPI โรงงาน
Data Agent ไม่ได้ทำให้ dashboard หมดความจำเป็น OEE, สถานะเครื่อง, alarm ค้าง และ inventory warning ที่ต้องดูทุกเช้าควรอยู่ในหน้าจอคงที่ เอเจนต์เหมาะกับการถามต่อ เช่น “แยกไลน์ที่ต่ำตามรุ่นและกะ” หรือ “เทียบเดือนก่อนภายใต้เงื่อนไขเดียวกัน”
- Monitor: แสดง KPI ที่อนุมัติแล้วบน factory KPI dashboard
- Explore: ส่งบริบทจาก dashboard ไป Data Agent เพื่อถามเพิ่ม
- Act: มนุษย์ตรวจหลักฐาน แล้วใช้ workflow ที่อนุมัติสำหรับซ่อม วางแผน หรือจัดซื้อ
PoC ไม่ควรทำชั้นที่สามอัตโนมัติ หากเพิ่ม action ในอนาคต ให้แยกสิทธิ์อ่านกับเขียน และกำหนด action, approver, limit, rollback และการป้องกันทำซ้ำ OpenAI กล่าวถึง human-approved actions ไม่ได้หมายถึงการทำงานอัตโนมัติโดยไม่มีเงื่อนไข
Data diagnostic ก่อนเริ่ม
ถ้าตอบคำถามต่อไปนี้ไม่ได้ อาจทำ data diagnostic 2–4 สัปดาห์ก่อน ซึ่งเป็นระยะตัวอย่างของ TOMAS TECH และต้องปรับตามสภาพจริง
- KPI สำคัญมี business owner และ data owner หรือไม่
- มีรายงานหรือ SQL ที่อนุมัติเป็น ground truth หรือไม่
- key โรงงาน เครื่อง รุ่น และวัตถุดิบ map ข้ามระบบได้หรือไม่
- เขตเวลา วันผลิต และกะเป็นมาตรฐานหรือแปลงได้หรือไม่
- ตรวจข้อมูลขาด ล่าช้า ซ้ำ และแก้ด้วยมือได้หรือไม่
- ทำ row/column permission แบบ production ใน test ได้หรือไม่
- เก็บ query log เพื่อทำซ้ำคำตอบภายหลังได้หรือไม่
จัดผลเป็นพร้อมเชื่อม ต้องสร้าง view ต้องรวม master และนอกขอบเขต จะช่วยตัดสินใจลงทุนได้ดีกว่าคำตอบผ่าน/ไม่ผ่าน
Operating model: รักษาความแม่นยำหลังเปิดใช้
ข้อมูล KPI และกระบวนการเปลี่ยนตลอด ระบบอาจเสียหลังเพิ่มเครื่อง ย้าย ERP เปลี่ยนรหัสรุ่น หรือเปลี่ยนปีบัญชี
| สิ่งที่ดูแล | แนวทางแนะนำ |
|---|---|
| Evaluation set | เก็บ 30 คำถามเป็น regression test และรันหลังเปลี่ยนนิยามหรือโมเดล |
| Semantic definition | version เหตุผล ผู้อนุมัติ วันเริ่มใช้ และคำถามที่ได้รับผล |
| Access | ทบทวนพนักงานเข้าออก ย้ายงาน โรงงานใหม่ และ contractor |
| Data quality | ตรวจ delay, missing, duplicate และ anomaly ก่อนตอบ |
| Usage log | audit คำถามผิด คำถามถี่ การถามใหม่ และ export |
| Incident | กำหนด stop, notification, investigation และ prevention |
หน้าจอต้องให้หลักฐาน ไม่ใช่แค่ความมั่นใจ แสดงนิยาม ช่วงเวลา last refresh แหล่งข้อมูล คิวรี และข้อจำกัดให้ผู้ใช้ตรวจกลับได้
ความล้มเหลวที่พบบ่อยและวิธีป้องกัน
เชื่อมข้อมูลทั้งองค์กรก่อน
ยิ่งกว้างยิ่งมีศัพท์กำกวม KPI ชื่อซ้ำ และสิทธิ์ซับซ้อน เริ่มหนึ่งโรงงาน หนึ่งโดเมน และ 30 คำถามก่อน
ให้คะแนนเฉพาะข้อความ
join ที่ผิดอาจบังเอิญได้ตัวเลขถูก ต้องให้คะแนนคิวรีกับคำตอบเป็นคู่และเก็บที่มาของ source
ผ่านเฉพาะคำถามเดโมที่สวย
ผู้ใช้จริงถาม “ช่วงนี้” “ไลน์ไม่ดี” หรือ “สต็อกโอเคไหม” จึงต้องประเมิน clarification, refusal และการเปิดนิยาม
ให้แชตสรุป root cause
เอเจนต์บอกได้ว่า downtime กับ defect เพิ่มพร้อมกัน แต่ไม่ได้พิสูจน์เหตุผล ต้องระบุว่าเป็น hypothesis และตรวจ process, maintenance, material และ experiment
ให้สิทธิ์เขียนระหว่าง PoC
ความเข้าใจผิดที่ไปแก้ PO แผนผลิต หรือค่าตั้งเครื่องจะขยายผลกระทบ PoC 90 วันต้องมี automatic write-back 0 ครั้งและใช้ human approval
FAQ: คำถามเรื่องการนำ Data Agent มาใช้
การนำ Data Agent มาใช้ต่างจาก chatbot อย่างไร
Data Agent รวมข้อมูลที่อนุมัติ semantic definition สิทธิ์ผู้ใช้ การรันคิวรี และ audit ส่วน chatbot ทั่วไปอาจสร้างข้อความได้ แต่การรวม KPI และสิทธิ์ที่บังคับใช้จริงต้องมีระบบกำกับเพิ่มเติม
RAG ใช้แทน AI Agent วิเคราะห์ข้อมูลได้หรือไม่
แทนทั้งหมดไม่ได้ RAG เหมาะกับคู่มือและรายงาน Data Agent เหมาะกับตารางและ KPI สถาปัตยกรรมที่ใช้งานได้จริงให้ตัวเลขมาจากคิวรี และขั้นตอนมาจากเอกสารอ้างอิง
คนไม่รู้ SQL ใช้ BI ภาษาธรรมชาติได้หรือไม่
ใช้ได้ แต่ไม่เขียน SQL ไม่ได้แปลว่าไม่ต้องตรวจ ต้องดูช่วงเวลา หน่วย นิยาม และเวลาที่ข้อมูลอัปเดต งานเสี่ยงสูงควรมีผู้ดูแลข้อมูลตรวจ
Semantic layer สำหรับ AI ต้องใส่อะไร
ต้องมีสูตร grain, join, unit, time zone, default filter, exception, permission, owner และคู่ verified question-SQL พร้อม version history และ regression test
Data Agent แทนแดชบอร์ด KPI โรงงานได้หรือไม่
ไม่ควรแทนทั้งหมด ใช้ dashboard สำหรับ monitoring ซ้ำ ๆ และ Data Agent สำหรับ exploration การสร้าง KPI เดิมใหม่ด้วยแชตทุกครั้งช้ากว่าและไม่นิ่ง
ระบุ root cause อัตโนมัติได้หรือไม่
แสดงสหสัมพันธ์และผู้ต้องสงสัยได้ แต่ไม่ใช่ causal proof เอกสาร Microsoft Fabric ระบุ causal/root-cause questions ว่าอยู่นอกขอบเขต ควรใช้สถิติ การทดลอง ความรู้กระบวนการ และการยืนยันหน้างานร่วมกัน
PoC ถูก 27 ข้อเพียงพอหรือไม่
27/30=90% เป็นเกณฑ์ตัวอย่างของ TOMAS TECH งานเสี่ยงสูงอาจต้องมากกว่านี้ และยังต้องผ่านเงื่อนไขแยกคือข้อมูลรั่ว 0 รายการ traceability 100% และ automatic write-back 0 ครั้ง
Data Agent มีค่าใช้จ่ายเท่าไร
ขึ้นอยู่กับ license, consumption, data platform, network, การทำ semantic model และ operation บทความนี้ไม่ระบุราคาที่ไม่ได้ตรวจสอบ ควรเทียบด้วย 30 คำถาม ข้อมูล สิทธิ์ ขอบเขต PoC และสมมติฐาน production เดียวกัน
สรุป: สร้างคำตอบจริง สิทธิ์ และที่มาก่อนซื้อ
คุณค่าของ Data Agent ไม่ใช่การสนทนา แต่คือการเชื่อมคำถามหน้างานกับข้อมูลและนิยามที่อนุมัติ แล้วส่งคำตอบที่ตรวจสอบได้อย่างรวดเร็ว OEE, yield, downtime และ inventory เป็นจุดเริ่มที่ดี หากกำหนด grain, period, exception และ permission ก่อน
การตัดสินใจ build/buy ต้องทดสอบความถูกต้องของคิวรีกับข้อมูลจริง การสืบทอดสิทธิ์ audit log การดูแล semantic layer และ deployment PoC ตัวอย่าง 90 วันใช้เกณฑ์อย่างน้อย 27/30 คู่คิวรี-คำตอบถูกต้อง การรั่ว 0 รายการ traceability 100% และ automatic write-back 0 ครั้ง ทั้งหมดเป็นข้อเสนอของ TOMAS TECH และควรเพิ่มความเข้มตามความเสี่ยง
สุดท้าย ต้องแยกความแตกต่างที่สังเกตพบออกจากข้อสรุปเชิงเหตุผล Data Agent ช่วยสำรวจเร็วขึ้น แต่ไม่แทนคุณภาพข้อมูล การตรวจของมนุษย์ และความรู้การผลิต
หากยังอยู่ในขั้นตัดสินใจว่าจะสร้างคำถามตรวจสอบ 30 ข้ออย่างไร หรือควรซื้อหรือพัฒนาเอง ก็สามารถเริ่มปรึกษาได้ สำหรับการเชื่อมข้อมูล นิยาม KPI และสิทธิ์ของโรงงานในไทยและอาเซียน โปรดติดต่อ TOMAS TECH
แหล่งอ้างอิง
- OpenAI: Put data to work with a data agent (10 กันยายน 2026: approved sources, semantic layers, permissions, dashboards, human-approved actions และการใช้งานภายใน)
- OpenAI: How enterprises put AI to work (12 สิงหาคม 2026: ตัวเลขบริบทการยอมรับ AI ในองค์กร)
- Databricks: Genie Agents (Unity Catalog, example SQL, expressions และ instructions)
- Snowflake: Verified Query Repository (คำถามและ SQL ที่มนุษย์ตรวจสอบ)
- Microsoft Learn: Create a Fabric Data agent (สิทธิ์ผู้ใช้ SQL/DAX/KQL สูงสุด 5 แหล่ง และข้อจำกัด causal/root-cause)


